
Agent LLM trop cher : quatre causes visibles dans une trace
Quatre causes d'une facture élevée, reproduites et corrigées : horodatage qui casse le cache (0% à 73% de hits), contexte croissant, boucle de retry et mauvais modèle.
Nos choix
prix en direct| Modèle | Verdict | Prix |
|---|---|---|
| GPT-6 Luna Avec l’horodatage déplacé hors de la première ligne du prompt, 4,157 des 5,729 tokens d’entrée sur quatre tours ont été lus depuis le cache lors d’un démarrage à froid. Avec l’horodatage en première ligne, aucun des 5,579 tokens ne l’a été. | Agent principal de la démo | dès $0.1/M |
| DeepSeek V4.1 Flash Trois vérifications d’une phrase chacune ont coûté $0.0010 sur GPT-6.1 Sol et $0.0001 sur ce modèle. | Sous-agent de la démo | dès $0.3/M |
Sommaire
- Par où commencer quand la facture dépasse les prévisions ?
- Pourquoi le taux de hit du cache est-il nul ?
- Pourquoi chaque tour envoie-t-il plus de données que le précédent ?
- À quoi ressemble une boucle de retry ?
- Comment repérer un modèle coûteux affecté à une tâche simple ?
- FAQ
- Comment savoir quelle partie de mon agent LLM coûte le plus cher ?
- Pourquoi le taux de hit de mon cache de prompts est-il à 0% ?
- Pourquoi le premier tour d’une conversation ne touche-t-il pas le cache ?
- La mise en cache des prompts rend-elle gratuit un long historique de conversation ?
- Combien économise-t-on avec la mise en cache des prompts ?
- Une boucle de retry apparaît-elle comme une série d’erreurs ?
- Pour aller plus loin
La facture d’un agent augmente pour des raisons qu’une requête isolée ne révèle pas : un prompt qui ne touche jamais le cache, une conversation qui renvoie toujours plus de données à chaque tour, une boucle qui refait le même travail ou un modèle coûteux affecté à une tâche qu’un modèle moins cher pourrait accomplir. Ces problèmes deviennent évidents dès que les appels sont regroupés en sessions et en traces. Ce guide reproduit les quatre cas avec un petit agent de support, montre où les repérer dans la console Synthorai, les corrige et compare les coûts avant et après.
TL;DR
- Un horodatage sur la première ligne du prompt maintenait le taux de hit du cache à 0%. Le déplacer à la fin l’a porté à 73% et a réduit le coût des tokens d’entrée de 66% sur GPT-6 Luna.
- Un historique qui renvoyait tous les résultats d’outils utilisait trois fois plus de tokens d’entrée, pour un coût d’entrée supérieur de seulement 21%, car 71% étaient lus depuis le cache.
- Une boucle de retry effectuait 10 appels au modèle là où 2 suffisaient, tous avec un statut 200.
- Trois appels de sous-agent sur GPT-6.1 Sol représentaient 81% du coût d’une session.
Ce guide prolonge Tracer un agent LLM, qui présente les en-têtes de requête utilisés pour regrouper les appels en sessions et en traces. Préparez la démo comme indiqué dans ce guide (Python 3.10 ou version ultérieure, environnement virtuel activé), puis lancez les quatre cas ainsi que replay-mismatch (une autre façon de perdre le bénéfice du cache) depuis le même répertoire de github.com/synthorai-io/use-cases :
cd use-cases/agent-tracing
python incidents.py cache-miss context-growth replay-mismatch retry-loop wrong-model
Chaque cas s’exécute deux fois, d’abord avec le problème, puis avec la correction. Ses appels portent les labels case et variant. Les chiffres proviennent d’une exécution de chaque cas le 11 octobre 2026. Ils ne représentent que des fractions de centime, car la démo est minuscule. Ce sont les rapports entre ces valeurs qui restent pertinents à l’échelle d’une charge réelle.
| Cas | Où le repérer | Avant | Après |
|---|---|---|---|
cache-miss | Taux de hit du cache par tour sur la page de session | 0% en cache, $0.0015 | 73% en cache avec un cache initialement vide, $0.0011 |
context-growth | Volume d’entrée croissant à chaque tour sur la page de session | 24,546 tokens d’entrée, $0.0011 de coût d’entrée | 8,053 tokens d’entrée, $0.0009 de coût d’entrée |
replay-mismatch | Taux de hit du cache bloqué à 0% sur la page de session | 0% en cache, $0.0038 | 76% en cache, $0.0015 |
retry-loop | Une trace avec bien plus d’appels que nécessaire pour un tour | 10 appels, $0.0004 | 2 appels, $0.0001 |
wrong-model | Tableau des agents sur la page de session | $0.0012 | $0.0003 |
Par où commencer quand la facture dépasse les prévisions ?
Commencez par la liste Traces, triée par coût. Chaque ligne correspond à une session ou à une trace et affiche son nombre d’appels, sa durée et son coût. Les conversations les plus coûteuses se retrouvent donc en tête. Ouvrez-en une pour repérer les problèmes décrits ci-dessous.
Si vos requêtes portent des labels via X-Synthorai-Metadata, filtrez d’abord la liste. Le champ de recherche de Traces accepte les labels : metadata.feature = support-agent ne conserve que les sessions et traces d’une fonctionnalité, et metadata.case = cache-miss retrouve les deux exécutions du cas présenté ici. Pour les totaux, l’onglet Breakdown d’Analytics contient une carte Cost by metadata : choisissez une clé pour afficher les requêtes, les tokens d’entrée et le coût associés à chacune de ses valeurs.
Pourquoi le taux de hit du cache est-il nul ?
Le taux de hit est nul lorsqu’un élément proche du début du prompt change à chaque requête. La mise en cache des prompts permet au fournisseur de facturer la partie initiale répétée à une fraction du tarif d’entrée, mais seulement jusqu’au premier token qui diffère de la requête précédente. La version défectueuse de ce cas place l’heure courante sur la première ligne d’un prompt système d’environ 1,300 tokens :
# The clock is the first line, so the prompt differs from its first token on every turn.
system = f"Current time: {now}\n\n{SYSTEM}\n\n{MANUAL}"
Sur une conversation de quatre tours avec GPT-6 Luna, la page de session affiche Cache hit 0%, soit 0 token sur 5,579 tokens d’entrée. La correction déplace la partie variable à la fin :
# Stable text first, the part that changes last.
system, user = f"{SYSTEM}\n\n{MANUAL}", f"{text}\n\n(Current time: {now})"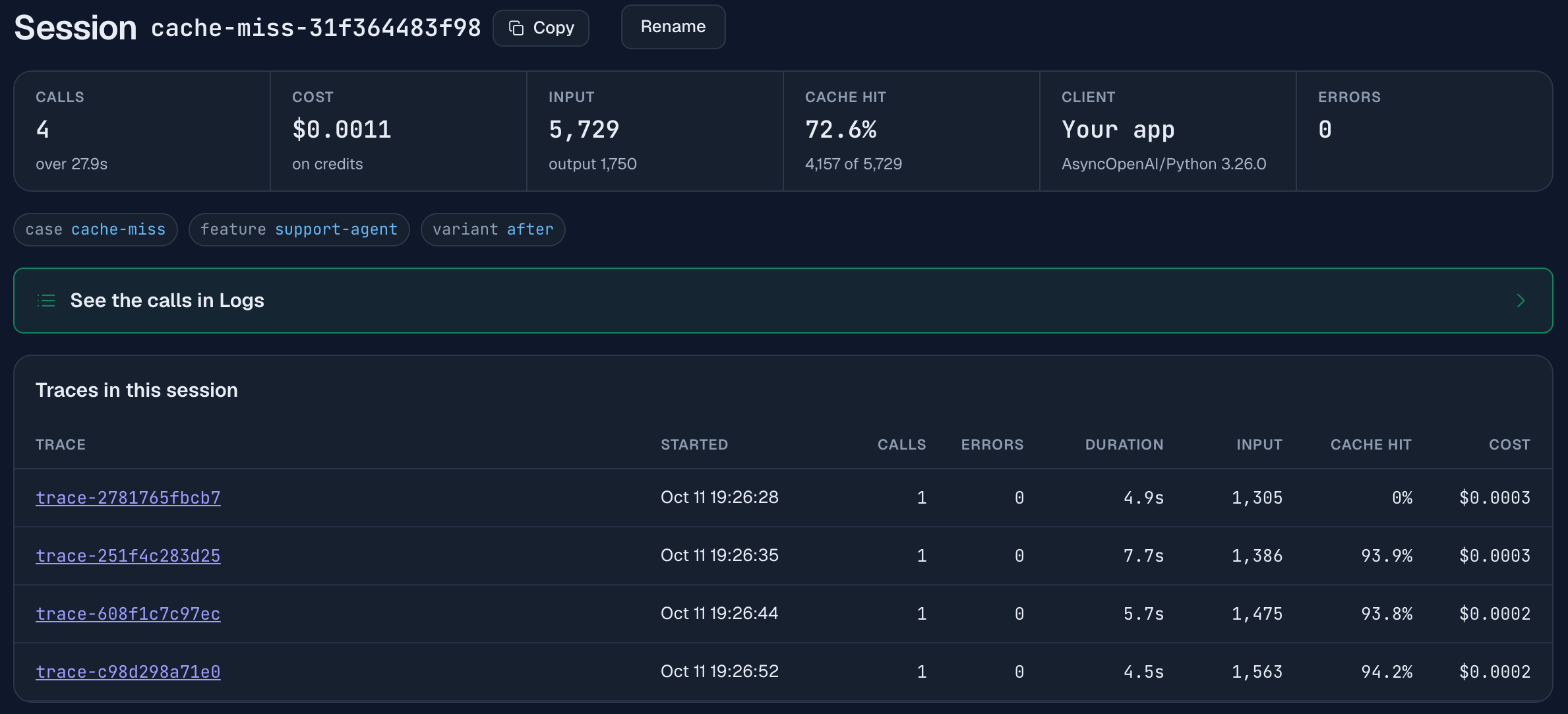
La page de session affiche les tokens d’entrée et le taux de hit du cache pour chaque tour. La première ligne indique 0%. Le premier tour ne peut pas lire une entrée qu’aucune requête n’a encore écrite : il la crée, mais ne lit rien. Les trois tours suivants lisent respectivement 1,302, 1,383 et 1,472 tokens depuis le cache, soit presque tout ce que le tour précédent avait envoyé. Chacun lit donc environ 94% de son entrée depuis le cache. Sur l’ensemble de la conversation, cela représente 4,157 tokens sur 5,729, soit 73%.
L’économie porte sur les tokens d’entrée. Ce modèle facture $0.10 par million de tokens d’entrée, $0.125 pour les tokens écrits dans le cache et $0.01 pour ceux qui y sont lus. Presque tous les tokens d’un long prompt relèvent de l’une de ces deux dernières catégories.
L’exécution défectueuse a écrit 5,567 tokens dans le cache sans en lire aucun. L’exécution corrigée en a écrit 1,560 et lu 4,157. Le coût d’entrée est donc passé de $0.00070 à $0.00024, soit une baisse de 66%. Le coût total de la session est passé de $0.0015 à $0.0011. Cette baisse est plus faible que celle du coût d’entrée, car la sortie représente la plus grande part de la facture et l’exécution corrigée en a produit davantage (1,750 tokens contre 1,599).
L’économie dépend de ce qui se trouve déjà dans le cache au début de la conversation. Cette exécution a démarré avec un cache vide : le premier tour n’y a donc rien lu. Un agent avec un trafic régulier devrait dépasser 73%, puisque toutes les conversations commencent par le même prompt système. L’entrée de la conversation précédente reste disponible tant que les requêtes arrivent avant son expiration. Un prompt utilisé par une seule conversation paie le tarif d’écriture au premier tour.
L’horodatage est le cas classique. Un identifiant de requête, une salutation aléatoire, un nom d’utilisateur inséré dans le premier paragraphe ou des définitions d’outils présentées dans un ordre différent produisent le même effet. Deux autres conditions sont nécessaires : le préfixe stable, c’est-à-dire le début inchangé du prompt, doit dépasser le minimum imposé par le fournisseur (1,024 tokens dans la plupart des cas ; voir la mise en cache des prompts). Les appels d’une conversation doivent aussi porter le même X-Session-Id, que la gateway utilise pour maintenir des hits de cache cohérents au sein de la conversation.
Pourquoi chaque tour envoie-t-il plus de données que le précédent ?
Chaque tour renvoie l’historique de la conversation. Une certaine croissance est normale, puisque cet historique s’allonge. Dans la version défectueuse de ce cas, la croissance est beaucoup plus rapide : chaque tour recherche le client, récupère environ 1,100 tokens d’historique de commandes en JSON et conserve ce résultat dans l’historique. Le sixième tour contient donc six copies de données presque identiques.
if variant == "before":
    history += [lookup_result]               # every old lookup is sent again on every later turn
history += [{"role": "user", "content": text}, {"role": "assistant", "content": reply}]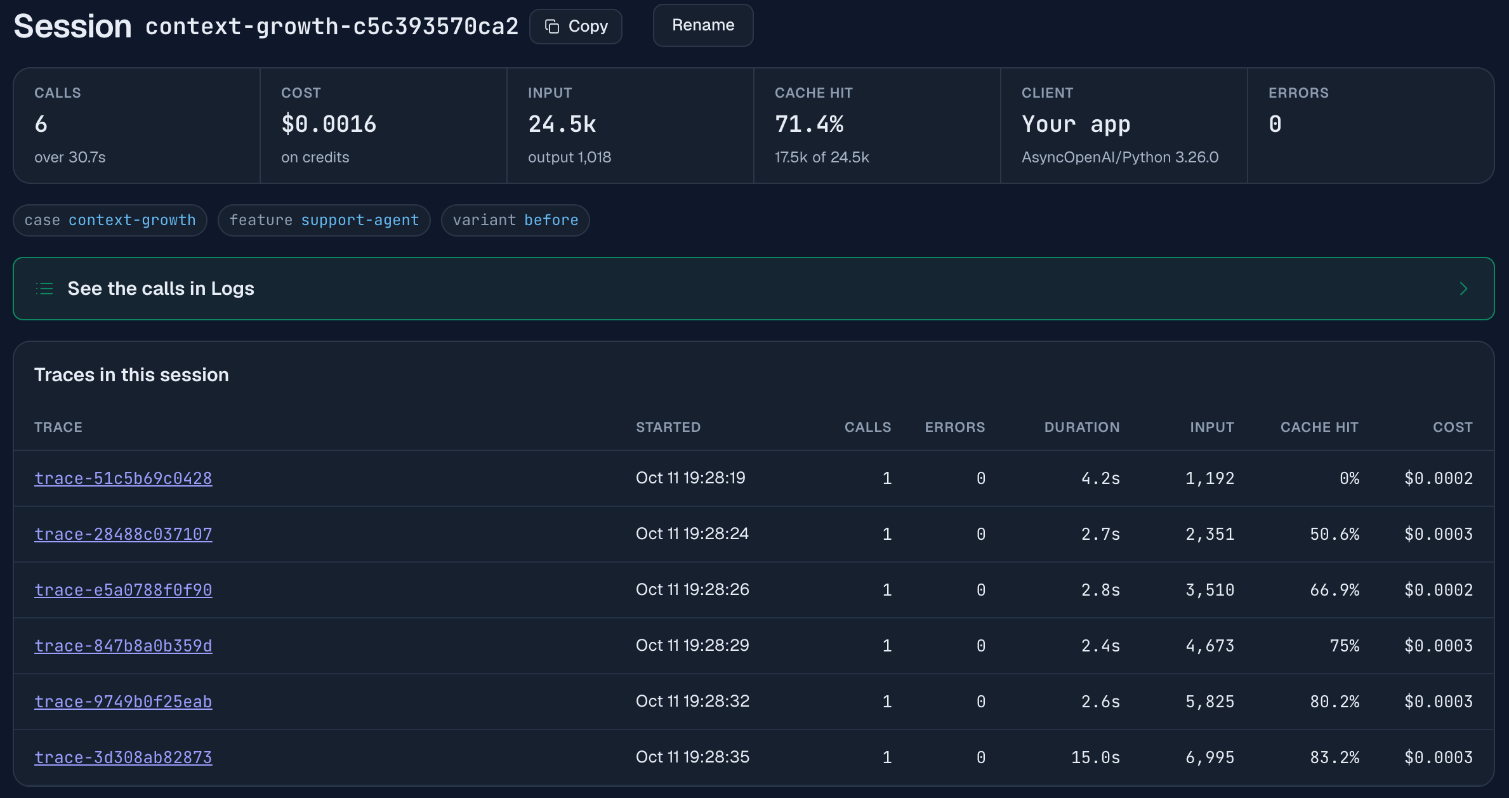
Le signal se trouve dans la colonne Input du tableau « Traces in this session » : elle augmente d’environ 1,160 tokens par tour, de 1,192 au premier à 6,995 au sixième, alors que les réponses restent longues de deux phrases. Les six tours utilisent 24,546 tokens d’entrée. Dans la version corrigée, le tour courant reçoit toujours un résultat de recherche à jour, mais les anciens résultats ne sont pas conservés : la réponse de l’assistant contient déjà les informations utiles. Les six tours n’utilisent alors que 8,053 tokens d’entrée, soit trois fois moins.
Les deux colonnes voisines d’Input expliquent pourquoi le problème passe inaperçu. Le taux de hit du cache augmente avec le volume d’entrée, tandis que le coût par tour reste entre $0.0002 et $0.0003. Chaque tour commence par l’intégralité du prompt du tour précédent, que le fournisseur lit donc depuis le cache : 17,536 tokens sur 24,546, soit 71%. L’entrée de la session défectueuse coûte $0.0011, contre $0.0009 pour la version corrigée : trois fois plus de tokens d’entrée pour un coût supérieur de 21%.
Sur ces deux exécutions, le coût total des sessions ne révèle pas du tout l’effet de la correction. La session défectueuse coûte $0.0016 et la session corrigée $0.0017, car cette dernière a produit davantage de tokens de sortie (1,756 contre 1,018). Ce surplus a ajouté environ $0.0004, plus que les $0.0002 économisés sur l’entrée. Comparez les colonnes Input et Cache hit, sur lesquelles agit la correction, plutôt que le coût total d’une seule session.
La mise en cache des prompts peut donc absorber l’essentiel du coût d’un historique croissant. Elle a toutefois trois limites :
- Elle ne réduit pas le contexte. Le sixième tour envoie toujours 6,995 tokens. Une longue session atteint malgré tout la limite de contexte du modèle, et un token en cache reste facturé, au tarif du cache.
- Elle ne fonctionne que si l’historique est renvoyé exactement tel qu’il a été envoyé. La démo illustre ce cas avec
replay-mismatch: une instruction est ajoutée à chaque message utilisateur lors de l’envoi, mais le message est enregistré sans elle. Chaque tour reconstruit alors un prompt que le tour précédent n’a jamais envoyé. Cette conversation n’a lu aucun de ses 24,557 tokens d’entrée depuis le cache et a coûté $0.0038. En enregistrant le message tel qu’il avait été envoyé, elle est passée à 18,844 tokens lus sur 24,702, soit 76%, pour $0.0015. - Elle n’est pas disponible sur tous les modèles. Au plein tarif d’entrée de GPT-6 Luna, le modèle utilisé ici, 24,546 tokens coûtent $0.0025, contre environ $0.0011 facturés avec le cache. Vérifiez la colonne Cache hit avant de compter dessus.
Pour votre agent, les résultats d’outils sont généralement les éléments les plus volumineux de l’historique et les moins utiles à renvoyer. Conservez la réponse qui les a exploités, ou un résumé d’une ligne, et supprimez les données brutes. Vous économiserez ainsi sur tous les modèles, avec ou sans cache. Notre guide des chatbots présente l’approche générale : condenser les anciens tours dans un résumé.
À quoi ressemble une boucle de retry ?
Elle apparaît sous la forme d’une trace contenant beaucoup plus d’appels que nécessaire pour un tour, avec les mêmes noms de spans qui se répètent. Dans ce cas, l’API de suivi du transporteur est indisponible. L’agent appelle son outil, reçoit un timeout et répond qu’il ne peut pas consulter la position du colis. Le code vérifie ensuite si la réponse indique où se trouve le colis. Comme ce n’est pas le cas, il relance le tour complet, jusqu’à cinq fois :
if "sorting" in reply or "out for delivery" in reply:
    break                                    # the reply names a parcel location
if variant == "after" and (tool_failed or not results):
    break                                    # a retry cannot help while the tool is down or unused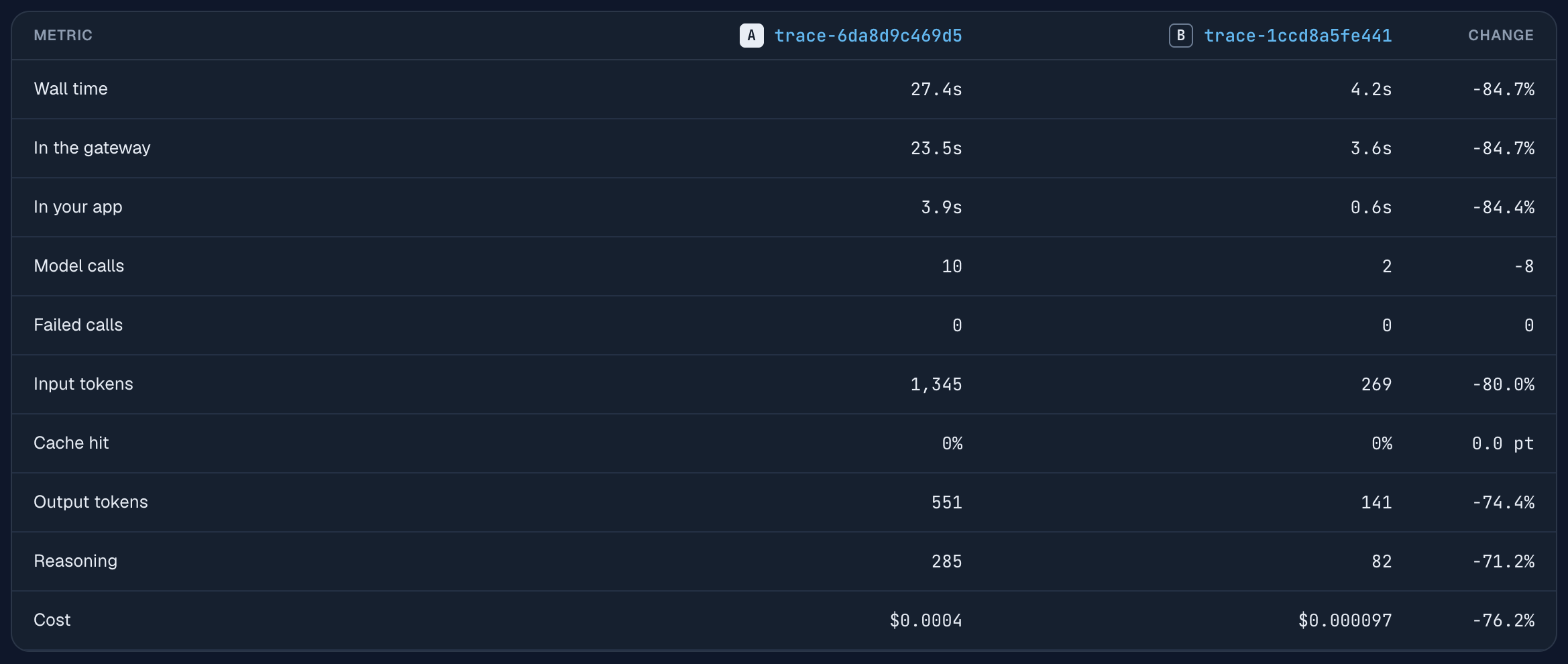
Voici la vue Compare des deux exécutions : ouvrez une trace, sélectionnez Compare, puis choisissez l’autre. L’exécution défectueuse a effectué 10 appels au modèle en 27.4 s pour $0.0004, et le client a finalement reçu la même réponse. « Failed calls » vaut 0 des deux côtés. Chaque appel de la boucle a réussi avec un statut 200 : rien n’apparaît donc comme une erreur. La version corrigée distingue une défaillance de l’outil d’une mauvaise réponse et ne réessaie pas lorsque le problème vient de l’outil : 2 appels, 4.2 s, $0.0001.
Dans la vue en cascade de l’exécution défectueuse, les appels s’appellent plan-1, answer-1, plan-2, answer-2, etc. Nommez les spans d’après l’étape et la tentative, comme ici : une boucle se repère alors immédiatement. Pour trouver des boucles dont vous ignorez l’existence, triez la liste Traces par nombre d’appels.
Comment repérer un modèle coûteux affecté à une tâche simple ?
Consultez le tableau « Agents in this session », qui répartit les appels et le coût de la session par agent. La version défectueuse de ce cas exécute les trois vérifications d’une phrase du sous-agent sur GPT-6.1 Sol, facturé $2 par million de tokens d’entrée et $10 par million de tokens de sortie. L’agent principal répond, lui, sur GPT-6 Luna :
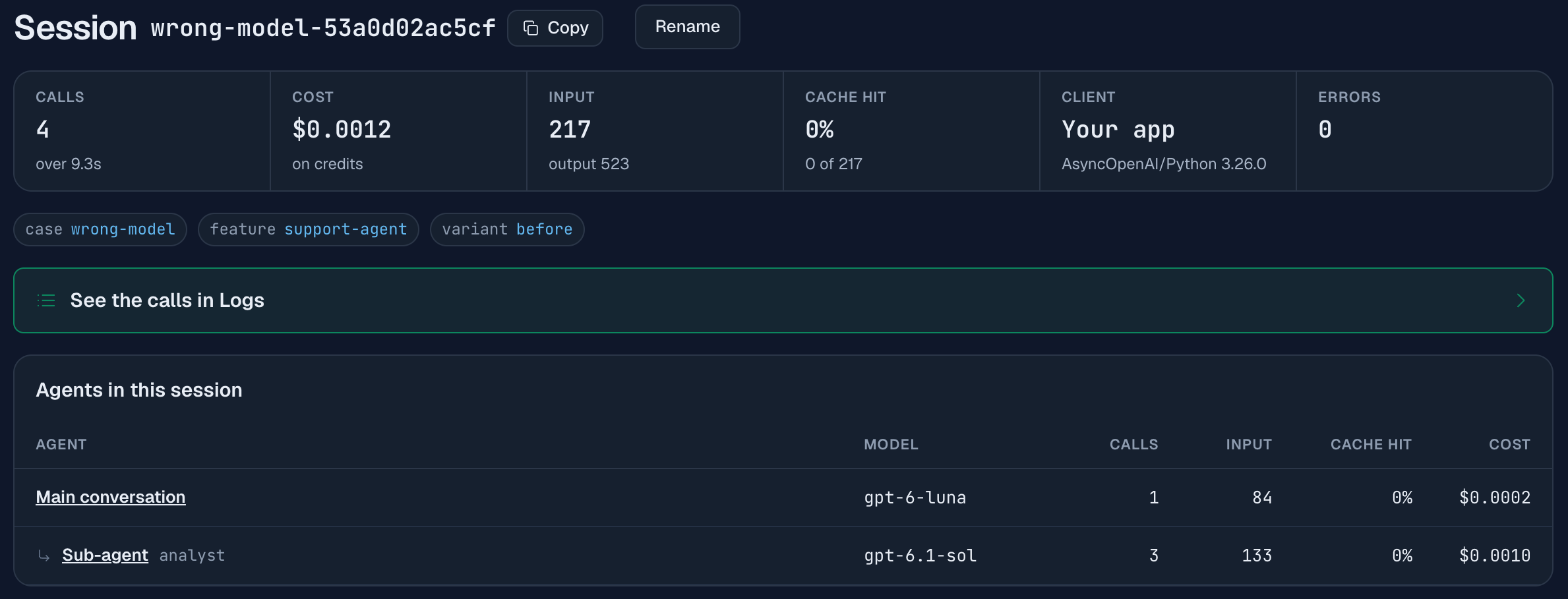
Les trois appels du sous-agent coûtent $0.0010 sur les $0.0012 de la session, soit 81% de la facture pour le travail le moins exigeant de cette exécution. Les trois mêmes vérifications sur DeepSeek V4.1 Flash coûtent $0.0001, et la session complète $0.0003. Les deux versions exécutent ces vérifications sans raisonnement : la différence vient donc du tarif du modèle.
Ce cas ne mesure que le coût. Nous n’avons pas évalué la qualité des vérifications, et un modèle moins cher n’est un bon choix que si ses réponses conviennent à l’étape concernée. Le tableau montre où part l’argent et indique donc quelle étape mérite d’être testée sur un modèle moins cher.
Cette répartition apparaît lorsque les appels des sous-agents portent X-Agent-Id. Sans cet en-tête, le tableau « Models in this session » fournit une répartition par modèle. Elle ne correspond à la répartition par agent que si chaque agent utilise son propre modèle. Pour suivre un agent sur l’ensemble des sessions, l’onglet Breakdown d’Analytics propose une carte Cost by agent.
FAQ
Comment savoir quelle partie de mon agent LLM coûte le plus cher ?
Regroupez ses appels en sessions et en traces à l’aide des en-têtes de requête, puis triez la liste Traces par coût et ouvrez la première entrée. La page de session répartit le coût par agent, par modèle et par tour. Cela suffit pour distinguer un problème de cache, de contexte ou de choix du modèle.
Pourquoi le taux de hit de mon cache de prompts est-il à 0% ?
La cause la plus fréquente est une valeur qui change près du début du prompt, par exemple un horodatage. Le cache ne couvre le prompt que jusqu’au premier token différent. Dans la démo, déplacer l’horodatage de la première ligne du prompt système à la fin du message utilisateur a fait passer le taux de hit de 0% à 73% avec un cache initialement vide.
Pourquoi le premier tour d’une conversation ne touche-t-il pas le cache ?
Une entrée de cache est créée par une requête, et le premier tour est précisément cette requête. Dans la démo, les quatre tours d’une conversation lisent respectivement 0%, 93.9%, 93.8% et 94.2% de leurs tokens d’entrée depuis le cache. Le premier tour ne peut lire le cache que si une conversation précédente a envoyé le même préfixe assez récemment pour que l’entrée existe encore.
La mise en cache des prompts rend-elle gratuit un long historique de conversation ?
Non, mais elle peut masquer l’essentiel du coût. Dans la démo, la conversation qui renvoyait tous les anciens résultats d’outils utilisait trois fois plus de tokens d’entrée que la version allégée (24,546 contre 8,053), pour un coût d’entrée supérieur de seulement 21%, car 71% de ces tokens étaient lus depuis le cache. Les tokens occupent toujours la fenêtre de contexte. La réduction disparaît dès que l’historique renvoyé diffère de ce qui avait été envoyé : dans le cas replay-mismatch de la démo, un message enregistré sous une forme différente de celle envoyée a fait tomber la part mise en cache à 0% et a plus que doublé le coût.
Combien économise-t-on avec la mise en cache des prompts ?
Cela dépend du tarif des tokens d’entrée lus depuis le cache et de la part de l’entrée dans la facture. Dans la démo sur GPT-6 Luna, lire 73% des tokens d’entrée d’une conversation depuis le cache a réduit le coût d’entrée de 66%. La session a coûté $0.0011, contre $0.0015 sans cache. Les tokens de sortie représentaient l’essentiel de cette facture, et le cache n’y change rien.
Une boucle de retry apparaît-elle comme une série d’erreurs ?
Pas nécessairement. Dans la démo, chaque appel de la boucle a renvoyé un statut 200. La boucle était visible dans une trace contenant 10 appels là où 2 suffisaient. Regardez donc le nombre d’appels par trace, pas seulement le taux d’erreur.
Pour aller plus loin
- Tracer un agent LLM : les en-têtes, sessions et labels utilisés dans ce guide.
- Pourquoi mon agent LLM est-il lent ? : la même méthode appliquée à la latence.
- Déboguer un agent LLM : remonter d’une plainte utilisateur à l’appel qui a posé problème.
- Coût de Claude Code par sous-agent : la même vue de session pour un agent de développement, où les écritures dans le cache représentent 77% d’une exécution.
- Interroger Claude sur vos logs LLM : trouver les sessions les plus coûteuses via MCP.
- Donner à votre agent des outils de lecture des logs : lire les mêmes logs avec votre propre programme et connaître le coût des tokens du modèle.
- Mise en cache des prompts : longueurs minimales des préfixes et tarifs par fournisseur.
- Meilleur LLM par cas d’usage : comparer les coûts selon le profil de charge pour choisir le modèle de chaque étape.