
Tokens por página de PDF: 4 proveedores, de 15 a 2,100
Contenido
- ¿Cómo se envía un documento a un modelo?
- ¿Cómo comprobar que el modelo ha leído el archivo?
- ¿Cómo cuenta cada proveedor un PDF enviado como archivo?
- ¿Cuándo falla el texto extraído?
- ¿Cómo pagar menos por los documentos?
- ¿Qué hacer con un archivo de Word?
- Cómo hicimos las mediciones
- Preguntas frecuentes
- ¿Cuántos tokens ocupa una página de PDF?
- ¿Sale más barato enviar un PDF o su texto extraído?
- ¿Puede un LLM leer un PDF escaneado?
- ¿Qué modelos aceptan archivos PDF directamente?
- ¿Cómo reducir el coste de un PDF largo?
- Lecturas relacionadas
Cada proveedor aplica una regla distinta para facturar un PDF enviado al modelo como archivo. GPT-6 cuenta los tokens del texto y suma unos 15 por página. Claude cuenta el texto y añade 1,558 tokens por página. Gemini cuenta 515 tokens por página y no cobra el texto. Qwen 3.8 suma 2,098 por página al texto. Para medir estas reglas, enviamos las mismas páginas con cantidades crecientes de texto. Después enviamos diez documentos a quince modelos para encontrar la forma más barata de enviar cada tipo sin perder respuestas correctas.
TL;DR
- Por cada página de PDF enviada como archivo, GPT-6 añade 15 tokens al texto; Claude, 1,558; y Qwen 3.8, 2,098. Gemini cobra 515 fijos, sin cobrar el texto.
- Con el texto extraído, los modelos acertaron 0 de 150 preguntas sobre gráficos y 0 de 105 sobre un documento escaneado.
- Elegir el formato de envío página por página redujo un documento mixto de 17,228 tokens a 6,543 en Claude Sonnet 5.5, con las 12 respuestas correctas.
- Enviar 4 páginas seleccionadas de un PDF de 120 páginas redujo la entrada de Claude Sonnet 5.5 de 253,822 tokens a 8,758.
¿Cómo se envía un documento a un modelo?
Hay tres opciones: como archivo, como imágenes de sus páginas o como texto extraído previamente.
import base64
import pymupdf  # pip install pymupdf

doc = pymupdf.open("report.pdf")
b64 = lambda data: base64.b64encode(data).decode()   # binary written as text, so it fits in JSON

# 1. As a file. The vendor decides how to read it.
as_file = [{"type": "file", "file": {"filename": "report.pdf",                # OpenAI-compatible chat
            "file_data": "data:application/pdf;base64," + b64(open("report.pdf", "rb").read())}}]
as_document = [{"type": "document", "source": {"type": "base64",              # Anthropic Messages API
                "media_type": "application/pdf", "data": b64(open("report.pdf", "rb").read())}}]

# 2. As page images. You render each page; any model that accepts images takes these.
as_images = [{"type": "image_url", "image_url": {"url": "data:image/jpeg;base64," +
              b64(page.get_pixmap(dpi=72).tobytes("jpeg"))}} for page in doc]

# 3. As text. The text layer is the selectable text stored in a PDF. A scan has none.
as_text = "\n\n".join(page.get_text() for page in doc)
Esto es lo que aceptó cada uno de los quince modelos en el endpoint de chat:
| Modelo | PDF como archivo | Imágenes de páginas | Texto |
|---|---|---|---|
| GPT-6.1 Sol, GPT-6 Luna | sí | sí, hasta 50 por solicitud | sí |
| Claude Opus 5.5, Sonnet 5.5, Haiku 5.5 | sí | sí | sí |
| Gemini 3.1 Pro, Gemini 3.8 Flash | sí | sí | sí |
| Qwen 3.8 Max, Qwen 3.8 Flash | sí | sí | sí |
| Qwen 3.6 35B (pesos abiertos), DeepSeek V4.1 Flash, GLM 5.3 Flash, Kimi K3 | no | sí | sí |
| GLM 5.3, DeepSeek V4 Pro | no | no | sí |
Todos los modelos con visión aceptan imágenes de páginas, incluidos los cuatro modelos de pesos abiertos, que publican sus pesos pero rechazan el archivo. En el endpoint que usamos, los modelos Gemini aceptaron el PDF como una URL de datos dentro de una parte de imagen; la API de Google lo acepta como datos inline.
¿Cómo comprobar que el modelo ha leído el archivo?
Pregunta algo que solo aparezca en el archivo y revisa el recuento de tokens de entrada. Una entrada no admitida puede devolver un error 400, pero también puede descartarse sin impedir que el modelo responda. En nuestra prueba, los dos modelos sin visión ignoraron una parte de imagen y respondieron con 27 y 98 tokens de entrada para un documento de dos páginas. Otro modelo, al que enviamos una URL en lugar del archivo, respondió con contenido inventado.
r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": as_file + [question]}])
read_it = "MF-OPS-2291" in r.choices[0].message.content   # a string found only in the document
plausible = r.usage.prompt_tokens > 200 * len(doc)        # a dropped file leaves a few dozen tokens
No hace falta un modelo para identificar el tipo de página. La selección del formato de envío que veremos más abajo depende de esta clasificación:
def kind(page) -> str:
    if len(page.get_text().strip()) < 40:
        return "scan"        # no text layer: needs OCR or an image
    if page.get_images() or len(page.get_drawings()) > 60:
        return "visual"      # a picture or a chart drawn on the page
    return "text"
¿Cómo cuenta cada proveedor un PDF enviado como archivo?
Cada uno aplica una de cuatro reglas distintas. Creamos un PDF de seis páginas con 0, 80, 250, 500 y unas 670 palabras por página. Repetimos la prueba añadiendo un gráfico a cada página y enviamos cada versión como archivo y como texto extraído.
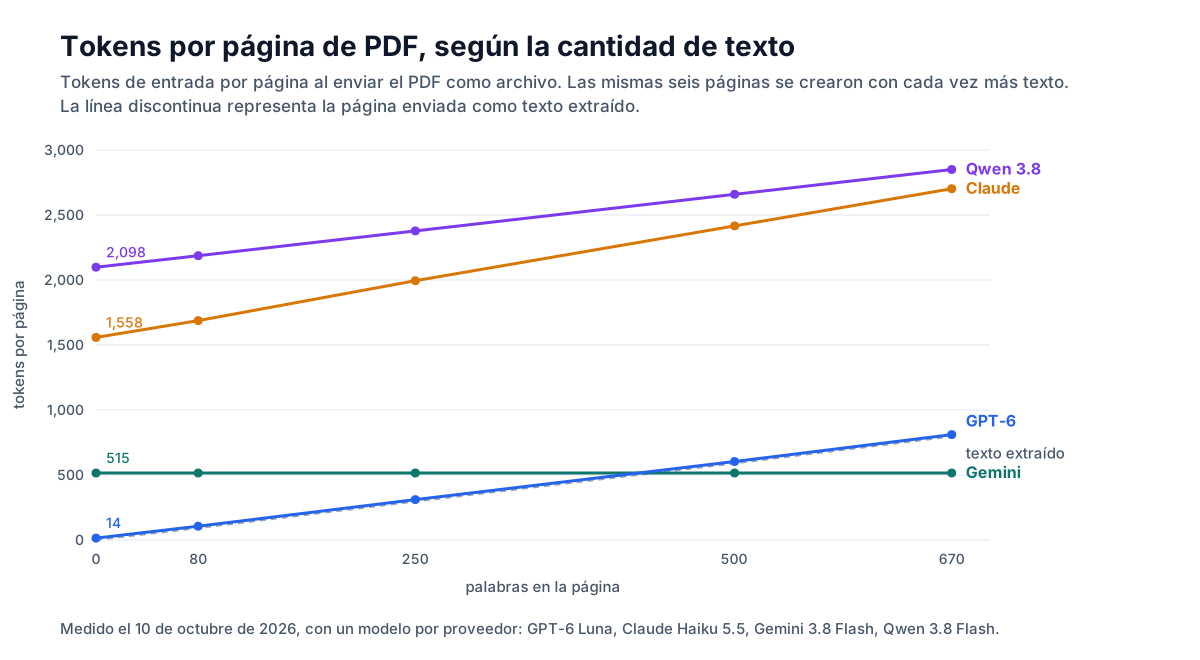
| Proveedor | Tokens de un PDF enviado como archivo |
|---|---|
| GPT-6 | Los tokens del texto más 14.5 por página. Una página con una imagen añade entre 650 y 1,700 aproximadamente |
| Claude | Los tokens del texto más 1,558 por página, exactamente. Un gráfico en la página no añade nada |
| Gemini | 515 por página, independientemente del contenido. El texto no se cuenta |
| Qwen 3.8 | Aproximadamente 0.94 veces los tokens del texto más 2,098 por página. Un gráfico añade unos 770 |
El token es la unidad de facturación del modelo y equivale aproximadamente a tres cuartas partes de una palabra en inglés. Los modelos de una misma familia dieron recuentos iguales, con diferencias de unos pocos tokens.
Dos de las reglas difieren de lo que publican los proveedores, al menos en la vía de acceso que medimos. La documentación de Google indica 258 tokens por página y que no se cobra el texto del PDF; medimos 515 por página, sin cargo por el texto, como indica la documentación. OpenAI dice que el PDF llega al modelo como texto extraído e imágenes de las páginas; aquí, las páginas de texto sin imágenes no tuvieron coste de imagen. Anthropic indica que cada página se procesa como texto y como imagen, normalmente con 1,500 a 3,000 tokens, lo que coincide con la medición.
Estas reglas tienen las siguientes consecuencias:
- Las páginas con poco contenido salen caras en Claude y Qwen. Una página con una sola línea cuesta 1,558 o 2,098 tokens como archivo y una docena como texto.
- Las páginas densas salen baratas en Gemini. Una página de unas 670 palabras cuesta los mismos 515 tokens que una en blanco, mientras que su texto por separado ocupa unos 800 tokens.
- En GPT-6, el archivo cuesta lo mismo que el texto hasta que una página contiene una imagen. Una página escaneada, que es toda una imagen, consumió 2,868 tokens.
Un informe de 12 páginas de texto, con unas 250 palabras por página, consumió 6,028 tokens como archivo en GPT-6.1 Sol, 6,441 en Gemini 3.8 Flash, 27,297 en Claude Sonnet 5.5 y 30,934 en Qwen 3.8 Flash. El texto extraído ocupó entre 5,924 y 8,716 tokens en los quince modelos.
¿Cuándo falla el texto extraído?
Cuando la respuesta depende de algo que no está en la capa de texto. Clasificamos cada pregunta según el contenido necesario para responderla y agrupamos los resultados de los quince modelos:
| Formato de envío | Texto corrido | Celda de tabla | Gráfico | Página escaneada |
|---|---|---|---|---|
| Texto extraído | 297 de 300 | 168 de 170 | 0 de 150 | 0 de 105 |
| OCR y después texto | 104 de 105 | |||
| PDF como archivo | 186 de 186 | 103 de 103 | 90 de 90 | 62 de 63 |
| Imágenes de páginas, 110 dpi | 258 de 260 | 148 de 148 | 130 de 130 | 89 de 91 |
| Imágenes de páginas, 72 dpi | 257 de 260 | 142 de 148 | 130 de 130 | 88 de 91 |
Los puntos por pulgada (dpi) indican la resolución con la que se renderiza una página; a 72 dpi, una página de tamaño carta estadounidense mide 612 por 792 píxeles. OCR significa reconocimiento óptico de caracteres: es el software que extrae texto de una imagen. Ejecutamos Tesseract, de código abierto, en local.
El texto extraído no obtuvo ningún acierto en los gráficos ni en el documento escaneado, en ningún modelo, porque los números no estaban en el texto. El OCR recuperó el informe escaneado al coste del texto, pero no los gráficos: al aplicar OCR a una presentación de 15 diapositivas con gráficos, los dos modelos que probamos acertaron 0 de 7 preguntas. Las tablas se conservaron en la extracción porque usamos cuadrículas sencillas. Las celdas combinadas y las columnas con texto en varias líneas son más difíciles; prueba con tus propias tablas.
¿Cómo pagar menos por los documentos?
Hay siete formas; medimos seis.
1. Elige el formato según la regla de recuento. Usa texto para las páginas que solo contienen texto. Para las demás, envía el archivo en Gemini e imágenes de páginas a 72 dpi en los otros proveedores: una imagen de página cuesta lo mismo independientemente de cuánto contenido tenga. Un formulario del IRS de 6 páginas densas ocupa 13,635 tokens como texto en Claude Sonnet 5.5, 22,871 como archivo y 4,015 como imágenes a 72 dpi. Las tres opciones dieron las tres respuestas correctas.
2. Elige el formato página por página. Un documento real mezcla distintos tipos de páginas, que la función kind anterior permite clasificar: las páginas de texto se envían como texto; las que tienen imágenes, como imágenes a 72 dpi; y las escaneadas pasan por OCR. Estos fueron los resultados con un documento de nueve páginas (cuatro de texto, tres de gráficos y dos escaneadas) y 12 preguntas:
| Modelo | Como archivo | Formato elegido por página | Todas las páginas como imágenes a 72 dpi |
|---|---|---|---|
| GPT-6 Luna | 15,106, 12 aciertos | 5,140, 12 aciertos | 5,750, 9 aciertos |
| Claude Sonnet 5.5 | 17,228, 12 aciertos | 6,543, 12 aciertos | 6,257, 12 aciertos |
| Qwen 3.8 Flash | 25,036, 12 aciertos | 5,313, 12 aciertos | 4,710, 12 aciertos |
| Gemini 3.8 Flash | 5,043, 12 aciertos | 7,110, 12 aciertos | 10,278, 12 aciertos |
Elegir el formato por página redujo la entrada entre un 62% y un 79% frente al archivo en tres proveedores, sin perder ningún acierto. En Gemini, el archivo ya es la opción más barata.
3. Baja la resolución de las imágenes, pero no la del texto. Los tokens de una imagen de página disminuyen con el número de píxeles, salvo en Gemini, que cobró lo mismo en todos los tamaños. Las diapositivas de gráficos con etiquetas grandes siguieron siendo legibles a 36 dpi: los seis modelos probados acertaron al menos 6 de 7 preguntas. Las 15 diapositivas costaron 2,874 tokens en Claude Haiku 5.5, frente a 23,949 como archivo. El texto del cuerpo necesitó 72 dpi: a 50 dpi, Claude Haiku 5.5 y Gemini aún acertaron 7 de 7, pero GLM 5.3 Flash bajó a 2 de 7. GPT-6 Luna perdió aciertos con imágenes de páginas en todos los tamaños por debajo de 96 dpi; envíale el archivo o el texto.
4. En OpenAI, usa detail con el valor low para las páginas con imágenes. La Responses API admite un campo detail en los archivos PDF. Con low, GPT-6 Luna leyó la presentación de 15 diapositivas con 9,985 tokens, frente a los 22,155 de la configuración predeterminada. El informe escaneado pasó de 34,396 a 11,387 tokens, con todas las respuestas correctas. Las páginas que solo contenían texto no cambiaron.
5. Envía solo las páginas necesarias. Para un manual de 120 páginas, GPT-6 Luna leyó el texto extraído (46,420 tokens) e identificó la página necesaria para cada una de las cuatro preguntas. Después, Claude Sonnet 5.5 respondió correctamente a las cuatro con un PDF de 4 páginas y 8,758 tokens. El archivo completo ocupa 253,822 tokens en Claude, así que el coste de entrada bajó de $0.508 a $0.022, incluida la primera pasada.
6. Usa un modelo barato para transcribir y uno grande para razonar. Un modelo de visión barato convirtió las 15 diapositivas de gráficos en tablas Markdown por entre $0.002 y $0.011. Después, Claude Opus 5.5 respondió correctamente a las siete preguntas a partir de una transcripción de unos 2,000 tokens por $0.010. El archivo ocupa 23,949 tokens y cuesta $0.096 de entrada. La transcripción se puede guardar y reutilizar para otras preguntas.
7. Guarda el documento en caché y procesa por lotes lo que pueda esperar. Con un punto de caché en el PDF (el marcador cache_control de la API de Anthropic), seis preguntas a Claude Sonnet 5.5 costaron $0.117 en lugar de $0.461: la primera escribió 38,364 tokens en la caché y las cinco siguientes los leyeron por unos $0.004 cada una. El procesamiento por lotes es la opción que no medimos. OpenAI, Anthropic y Google publican una tarifa del 50% para sus API por lotes, con resultados en un plazo de 24 horas. Anthropic indica que ese descuento se acumula con el de la caché.
Hay un umbral de precio que conviene vigilar: un PDF de 120 páginas supera los 250,000 tokens en Claude, y Claude Haiku 5.5 cobra los prompts de más de 100,000 tokens a cinco veces el precio. El texto extraído del mismo manual ocupa 68,382 tokens.
¿Qué hacer con un archivo de Word?
Conviértelo. De los seis modelos que probamos, solo GPT-6.1 Sol y GPT-6 Luna aceptaron un .docx como archivo. Solo leyeron su texto, tal como documenta OpenAI para los archivos que no son PDF. Para texto y tablas, basta con convertir a Markdown con pandoc: un contrato de nueve páginas ocupó 3,144 tokens y todos los modelos acertaron 7 de 7 preguntas. Con ese método, un memorando con un gráfico incrustado obtuvo 2 de 5 aciertos. Al convertirlo a PDF con LibreOffice, obtuvo 5 de 5, con 1,217 tokens en Gemini 3.8 Flash y 3,827 en Claude Sonnet 5.5.
Cómo hicimos las mediciones
Usamos diez documentos: siete generados (un informe de 12 páginas, 8 páginas de tablas financieras, una presentación de 15 diapositivas con gráficos, el informe escaneado, un manual de 120 páginas, un contrato de Word y un memorando de Word) y tres públicos (el artículo “Attention Is All You Need”, el formulario W-9 del IRS y el marco de gestión de riesgos de IA del NIST). Cada uno tenía entre tres y siete preguntas con una única respuesta verificable.
En la ejecución principal enviamos cada documento, en cada formato, a cada modelo mediante una sola solicitud: 568 solicitudes el 10 de octubre de 2026, de las que 566 se completaron correctamente (GPT-6 Luna rechazó dos veces las 120 imágenes de páginas). Las pruebas de recuento y coste sumaron otras 176 solicitudes ese mismo día, con un modelo de bajo precio por proveedor. Todo pasó por el endpoint de chat compatible con OpenAI del gateway de Synthorai, salvo la prueba de caché (Messages API) y la de detail (Responses API). Los importes en dólares usan los precios de tarifa.
Los recuentos de tokens son los que comunicó el endpoint por esta vía de acceso. Otro proveedor del mismo modelo puede preprocesar los archivos de forma distinta, así que ejecuta la prueba de seis páginas en tu propia vía antes de dar por válida una regla. Con tres a siete preguntas por documento, acertarlas todas demuestra que el formato permite leerlo, no que preserve toda la información.
Preguntas frecuentes
¿Cuántos tokens ocupa una página de PDF?
Depende del proveedor. Enviada como archivo, una página cuesta los tokens de su texto más unos 15 en GPT-6, el texto más 1,558 en Claude, 515 fijos en Gemini sin cobrar el texto, y unos 2,098 más el texto en Qwen 3.8. Una página escaneada consumió 2,868 tokens en GPT-6.1 Sol y 1,579 en Claude Sonnet 5.5.
¿Sale más barato enviar un PDF o su texto extraído?
Para las páginas que solo contienen texto, el texto extraído cuesta menos o lo mismo en todos los proveedores salvo Gemini. Allí, una página densa consume menos tokens como archivo porque el texto no se cuenta. En GPT-6.1 Sol, el archivo cuesta casi lo mismo que el texto. El texto extraído no permite responder preguntas sobre gráficos ni páginas escaneadas.
¿Puede un LLM leer un PDF escaneado?
Sí, si recibe las páginas como archivo o como imágenes. En un documento escaneado, el texto extraído está vacío y obtuvo 0 de 105 aciertos en nuestra prueba. Ejecutar OCR en local y enviar el resultado obtuvo 104 de 105 al coste del texto: es la opción más barata para un escaneo de texto impreso.
¿Qué modelos aceptan archivos PDF directamente?
En nuestra prueba, GPT-6.1 Sol, GPT-6 Luna, los tres modelos Claude 5.5, Gemini 3.1 Pro, Gemini 3.8 Flash, Qwen 3.8 Max y Qwen 3.8 Flash. DeepSeek V4.1 Flash, GLM 5.3 Flash, Kimi K3 y Qwen 3.6 35B aceptaron imágenes de páginas, pero no el archivo.
¿Cómo reducir el coste de un PDF largo?
Envía menos páginas, elige el formato más barato para cada una y reutiliza lo enviado. Usar un modelo barato para seleccionar las páginas pertinentes redujo una solicitud de 120 páginas en Claude Sonnet 5.5 de 253,822 tokens de entrada a 8,758. Elegir el formato según el tipo de página redujo un documento mixto entre un 62% y un 79%. La caché redujo el coste de seis preguntas sobre un documento de $0.461 a $0.117.
Lecturas relacionadas
- ¿Cuántos tokens ocupa una imagen?: las reglas de facturación de imágenes que se aplican al enviar imágenes de páginas.
- Precios de Claude Haiku 5.5: el umbral de 100,000 tokens que supera un PDF largo.
- Coste de escritura en la caché de prompts: lo que paga la primera solicitud al guardar un documento en caché.