
Teste A/B de prompt: rollout de 10% revelou custo 1.9x maior
Envie 10% do tráfego de produção a um novo prompt, por sessão. No teste, ele recebeu 8.0% de 200 sessões, sem troca de versão, e custou 1.94x por chamada.
Nossas escolhas
preços em tempo real| Modelo | Veredito | Preço |
|---|---|---|
| GPT-6 Luna A v1 de support-answer custou $0.000110 por chamada nas 1,272 chamadas da implantação, com latência mediana de 4.9 s. Com reasoning_effort none, custou $0.000034. | Versão de produção na demonstração | desde $0.1/M |
| DeepSeek V4.1 Flash A v3, com o mesmo prompt neste modelo, respondeu mais rápido (mediana de 3.1 s), mas custou $0.000213 por chamada, 1.94 vezes o custo da v1, porque gerou 1.6 vezes mais tokens de saída a um preço maior por token. | Versão candidata na demonstração | desde $0.3/M |
Conteúdo
- Como enviar 10% do tráfego de produção para uma nova versão?
- Quais chamadas vão para a candidata?
- Como comparar as duas versões?
- Desativar o raciocínio muda o resultado?
- As execuções de teste distorcem a comparação?
- O que ficou de fora?
- Perguntas frequentes
- Como fazer um teste A/B de prompt em produção?
- O rollout mantém cada conversa em uma única versão?
- Uma mudança de prompt pode aumentar o custo sem alterar o texto?
- Leituras relacionadas
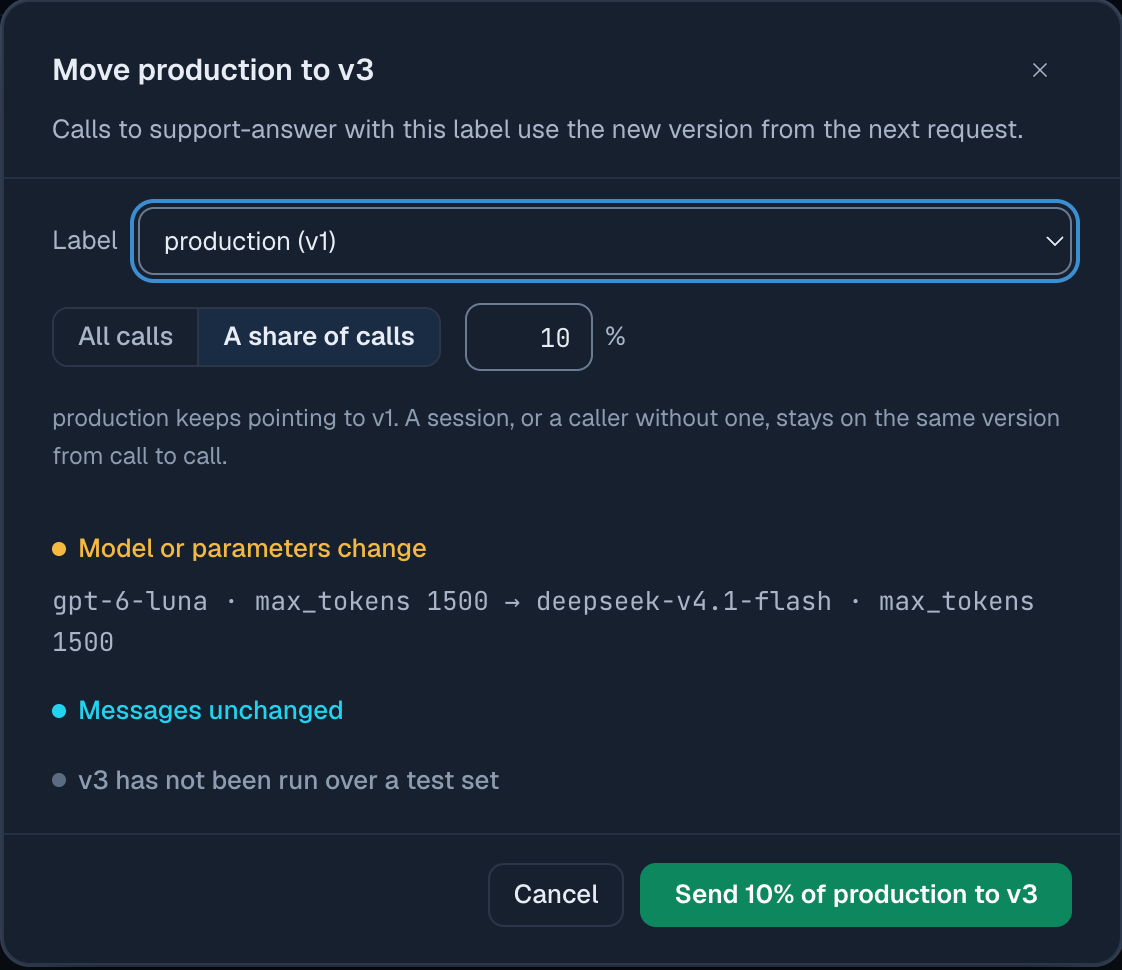
O rollout de um prompt direciona parte das chamadas de um mesmo ID de prompt para uma versão candidata, enquanto o restante continua na versão de produção. Assim, você compara as duas com tráfego real antes de migrar todos os usuários. Na biblioteca de prompts da Synthorai, isso é configurado no label production (“v1, com v3 a 10%”). O gateway escolhe a versão de cada chamada pelo ID da sessão, para que a conversa não mude de versão no meio. No nosso teste, com a configuração em 10%, 16 de 200 sessões (8.0%) foram para a candidata, e nenhuma sessão mudou de versão. A candidata usava outro modelo para o mesmo prompt, uma mudança cujo custo ninguém havia medido. Só com a parcela de 10%, os totais por versão já mostravam um custo por chamada de 1.92 vezes o da versão de produção.
TL;DR
- No rollout de 10%, 16 de 200 sessões (8.0%, intervalo de 95% de 5.0 a 12.6%) receberam a candidata; com 50%, foram 111 de 200 (55.5%).
- Todas as 400 sessões de três turnos permaneceram em uma única versão do prompt, assim como cada usuário final identificado por
_user, pelo campouserdo corpo ou porsafety_identifier. - A candidata, com o mesmo prompt no DeepSeek V4.1 Flash em vez do GPT-6 Luna, custou $0.000213 por chamada contra $0.000110, com latência mediana de 3.1 s contra 4.9 s.
- Nenhuma chamada fixada em
prompt_version=1foi para a candidata: 0 de 40.
Este guia dá continuidade a Versionamento de prompts, que configura os dois prompts e suas versões. No mesmo diretório de github.com/synthorai-io/use-cases:
cd use-cases/prompt-library
python rollout.py       # 10%, then 50%, then stops the rollout
python effort.py        # each version with and without a caller-sent reasoning_effort
O rollout foi executado em 19 de outubro de 2026 e fez 1,840 chamadas; as verificações da distribuição dos usuários finais foram feitas em 20 de outubro. A versão de produção é a v1 de support-answer no GPT-6 Luna. A candidata é a v3: o mesmo texto de sistema e as mesmas mensagens no DeepSeek V4.1 Flash. Só o modelo muda.
Como enviar 10% do tráfego de produção para uma nova versão?
Você atribui ao label production uma segunda versão e um percentual. Com uma chave de administrador, basta uma chamada para iniciar e outra para encerrar:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})

admin.put("/prompts/support-answer/labels/production/rollout", json={"version": 3, "percent": 10})
# ... compare the two versions ...
admin.delete("/prompts/support-answer/labels/production/rollout")   # production is v1 only again
Nada muda para quem faz as chamadas: continua chamando support-answer sem informar uma versão. O header de resposta X-Synthorai-Prompt-Version informa qual versão respondeu a cada chamada. Para colocar a candidata em produção, você move production para ela, encerrando o rollout. No console, a mesma configuração aparece como “Liberar gradualmente” na página da candidata. A lista de prompts passa a mostrar o label como “production v1 · v3 10%”.
Quais chamadas vão para a candidata?
O gateway escolhe a versão a partir de uma chave estável em cada chamada. Enquanto o percentual não mudar, a mesma chave sempre recebe a mesma versão. A chave usada é a primeira disponível nesta ordem:
- o ID da sessão (
X-Session-Id, o header descrito em Rastreie um agente de LLM); - o usuário final: o label
_useremX-Synthorai-Metadata; na ausência dele,userousafety_identifierno corpo, oumetadata.user_idda Anthropic; - nenhum desses: a própria requisição, de modo que a escolha é feita de forma independente para cada chamada.
O rollout.py verificou cada caso com percentuais de 10% e 50%. Cada sessão tinha 3 turnos, e cada usuário final fez 2 chamadas:
| Chamadas | Com 10%: na v3 | Com 50%: na v3 | Permaneceu em uma versão |
|---|---|---|---|
200 sessões, X-Session-Id | 16 = 8.0% (5.0 a 12.6%) | 111 = 55.5% (48.6 a 62.2%) | 400 de 400 sessões |
50 usuários finais, label _user | 6 | 27 | 100 de 100 usuários |
| 100 chamadas sem nenhum dos dois | 11 = 11.0% (6.3 a 18.6%) | 49 = 49.0% (39.4 a 58.7%) | não se aplica |
20 chamadas fixadas em prompt_version=1 | 0 | 0 |
As faixas entre parênteses são intervalos de confiança de 95%: a faixa em que a proporção real provavelmente se encontra, dado esse número de tentativas. Todos incluem o percentual configurado. Uma execução separada, com 50%, verificou os dois campos do corpo: 50 usuários identificados apenas por user e 20 apenas por safety_identifier, com 2 chamadas cada. Todos os 70 permaneceram em uma versão, com 25 dos 50 e 8 dos 20 na v3.
Isso tem duas consequências para o seu rollout. O ID da sessão mantém a consistência de uma conversa com vários turnos, então envie esse ID em todas as chamadas da conversa. Sem nenhuma chave, o mesmo usuário pode receber a v1 em uma chamada e a v3 na seguinte. Já uma chamada fixada, que informa uma versão em prompt_version, fica fora do rollout: um teste ou job em lote que fixa uma versão continua recebendo exatamente aquela versão.
Como comparar as duas versões?
A página de prompts agrega chamadas, erros, gastos, tokens e latência por versão. A API de requisições retorna os mesmos números com os filtros prompt_id e prompt_version. A demonstração consultou esses dados após o rollout:
| Versão | Requisições | Gasto | Gasto por chamada | Latência mediana | Tokens de saída por chamada, média | Tokens de raciocínio por chamada, média |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | 1,272 | $0.1405 | $0.000110 | 4.9 s | 198 | 149 |
| v3, DeepSeek V4.1 Flash | 568 | $0.1208 | $0.000213 | 3.1 s | 321 | 256 |
Tokens de raciocínio são os tokens que o modelo gera para pensar antes de responder. Eles são cobrados como saída e não aparecem na resposta.
A aba de chamadas do prompt mostra o mesmo tipo de totais. No período de 7 dias, ela contabiliza todas as chamadas de demonstração de cada versão, não apenas as do rollout. Por isso, os números são maiores que os da tabela.
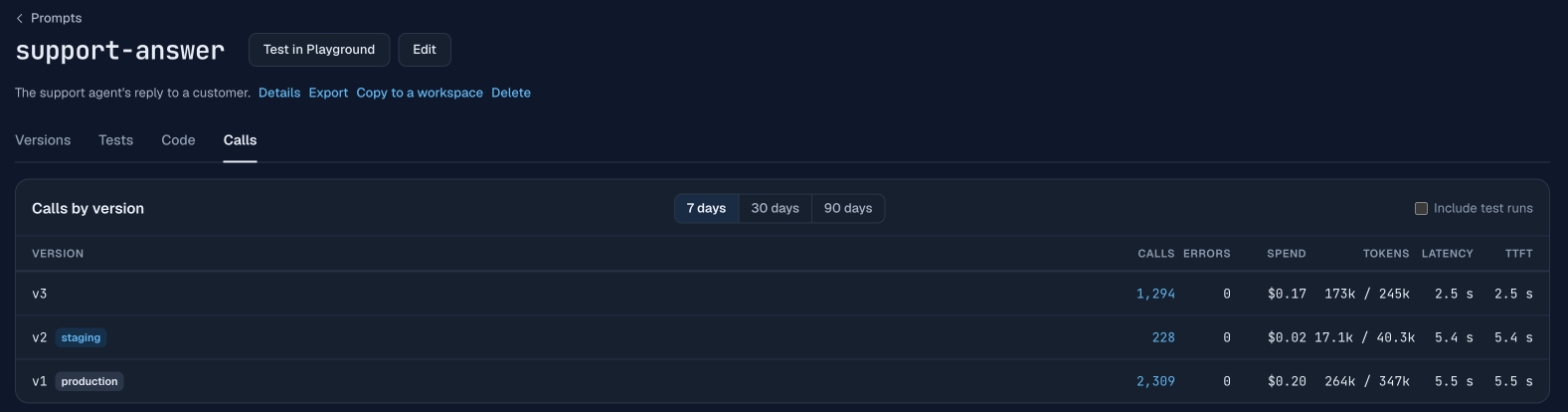
A v3 é mais rápida e, na execução completa, custa 1.94 vezes o valor por chamada da v1. Dois fatores se somam. Neste gateway, o DeepSeek V4.1 Flash custa mais por token que o GPT-6 Luna: $0.15 de entrada e $0.60 de saída por milhão de tokens no horário de menor demanda, contra $0.10 e $0.50. Além disso, a v3 gerou 1.6 vezes o número de tokens de saída. Quase toda a diferença veio do raciocínio: 256 tokens por chamada contra 149, enquanto as respostas em si tinham 65 e 48 tokens (medianas). Nenhum desses números aparece no texto do prompt. A diferença já existia só na etapa de 10%: as 71 chamadas respondidas pela v3 custaram $0.000212 cada, contra $0.000111 nas 749 chamadas da v1, um custo 1.92 vezes maior.
O preço também depende do horário. Todas as chamadas ao DeepSeek durante o rollout ocorreram na faixa de menor demanda que o gateway aplica a esse modelo (das 22:00 às 08:00, no horário de Pequim), com cobrança de metade da tarifa de pico de $0.30 e $1.20. A execução de 140 chamadas em 20 de outubro ocorreu no horário de pico. Nela, a v3 custou $0.000394 por chamada contra $0.000107 da v1, 3.7 vezes mais, em 66 e 74 chamadas.
Das 1,840 chamadas, 1,839 retornaram 200. Uma atingiu o timeout no cliente após 300 s e foi contabilizada como erro; os demais turnos da sessão à qual ela pertencia foram atendidos.
Desativar o raciocínio muda o resultado?
Isso reduz o custo das duas versões em dois terços ou mais, mas não torna a v3 mais barata. O effort.py chamou cada versão 50 vezes sem reasoning_effort e 50 vezes com reasoning_effort: "none" enviado pelo cliente. Usou as mensagens de clientes do conjunto de testes de Teste um prompt antes de colocá-lo em produção, todas com um número de pedido (40 mensagens, 10 delas usadas duas vezes):
| Versão | reasoning_effort | Custo por chamada | Tokens de saída, média | Latência mediana | Resposta contém o número do pedido | Avaliada como resposta à pergunta |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | padrão | $0.000107 | 192 | 4.8 s | 50/50 | 37/50 |
| v1, GPT-6 Luna | none | $0.000034 | 45 | 1.8 s | 50/50 | 35/50 |
| v3, DeepSeek V4.1 Flash | padrão | $0.000200 | 300 | 3.2 s | 50/50 | 43/50 |
| v3, DeepSeek V4.1 Flash | none | $0.000049 | 55 | 1.7 s | 50/50 | 39/50 |
“none” eliminou completamente o raciocínio nos dois modelos e reduziu o custo por chamada em 68% na v1 e 75% na v3. As respostas mantiveram a qualidade, dentro do que 50 chamadas permitem observar: todas continuaram incluindo o número do pedido. A avaliação por modelo (uma chamada ao Claude Sonnet 5.5 que verifica se a resposta atende à pergunta do cliente) variou em 2 e 4 de 50, com p = 0.82 e 0.44 no teste exato de Fisher. Esse teste calcula a probabilidade de uma diferença pelo menos tão grande se “none” não tivesse efeito; valores tão altos indicam que a variação é compatível com o acaso. Com “none” nas duas versões, a v3 ainda custou 1.44 vezes o valor da v1 por chamada ($0.000049 contra $0.000034). Essas chamadas também ocorreram no horário de menor demanda do gateway para o DeepSeek.
Durante um rollout, o cliente não sabe qual versão vai responder. Por isso, o reasoning_effort enviado por ele se aplica às duas. Essa configuração também pode ficar na própria versão: uma versão pode armazenar reasoning_effort, que o gateway insere nas requisições Chat Completions e Responses quando a chamada não define o raciocínio. Uma candidata salva dessa forma leva sua própria configuração para o rollout. Os totais por versão passam a comparar as versões com a configuração que teriam em produção.
As execuções de teste distorcem a comparação?
Por padrão, não. Os totais de cada versão na página de prompts excluem o tráfego de teste: chamadas do Playground, incluindo os testes do console, e chamadas com os labels source: prompt-test ou source: eval em X-Synthorai-Metadata. A opção “Incluir execuções de teste” passa a contabilizá-las. Em support-answer, ativá-la acrescentou 150 chamadas tanto à v1 quanto à v2: 110 de cada versão em uma execução de avaliação identificada por label e 40 de cada em um teste pelo console. A v3 não mudou. Os logs e a API de requisições continuam listando todas as chamadas. Se uma avaliação tiver sido executada durante o rollout, filtre pelo label nessas consultas:
X-Synthorai-Metadata: {"source":"eval"}O que ficou de fora?
- Testes estatísticos de custo e latência. A tabela por versão acima compara totais e médias; não testamos as diferenças. Antes de tomar uma decisão com base em uma diferença, teste-a, principalmente se for pequena.
- Qualidade das respostas no tráfego real. Um rollout mostra quanto uma versão custa e qual é sua velocidade. É mais fácil verificar se as respostas estão corretas com um conjunto fixo de entradas antes do rollout; Teste um prompt antes de colocá-lo em produção faz isso para a v2.
- Interrupção automática. Nada na demonstração encerra o rollout quando a taxa de erro ou o custo da candidata ultrapassa um limite. Um administrador altera o percentual, move o label para a candidata ou interrompe o rollout.
Perguntas frequentes
Como fazer um teste A/B de prompt em produção?
Atribua uma versão candidata e um percentual ao label de produção, continue chamando o ID do prompt como antes e compare os totais de cada versão. Na demonstração, o percentual de 10% direcionou 16 de 200 sessões para a candidata. Após algumas centenas de chamadas, os totais já mostravam seu custo.
O rollout mantém cada conversa em uma única versão?
Sim, quando as chamadas da conversa incluem um ID de sessão. Todas as 400 sessões da demonstração permaneceram na mesma versão ao longo dos três turnos. Sem ID de sessão, usa-se o identificador do usuário final. Sem nenhum dos dois, a escolha é feita de forma independente para cada chamada.
Uma mudança de prompt pode aumentar o custo sem alterar o texto?
Trocar o modelo mantendo o mesmo texto pode aumentar o custo, como ocorreu na demonstração. A candidata no DeepSeek V4.1 Flash custou 1.94 vezes o valor por chamada da versão no GPT-6 Luna, porque o preço por token neste gateway era maior e ela consumiu mais tokens de raciocínio. Compare o custo por chamada da versão completa, não o preço do modelo.
Leituras relacionadas
- Versionamento de prompts: como chamar um prompt pelo ID e mover um label.
- Teste um prompt antes de colocá-lo em produção: conjuntos de testes e verificações, comparando a v2 com a v1.
- Por que meu agente de LLM custa tanto?: outras quatro causas de uma conta alta, encontradas nos traces.
- Guia da biblioteca de prompts: rollout, estatísticas por versão e todos os campos.