
Por que meu agente LLM custa tanto? Quatro causas no trace
Quatro causas de uma conta alta, reproduzidas e corrigidas: timestamp que invalida o cache (0% para 73% de acerto), contexto crescente, loop de retries e modelo errado.
Nossas escolhas
preços em tempo real| Modelo | Veredito | Preço |
|---|---|---|
| GPT-6 Luna Com o timestamp fora da primeira linha do prompt, 4,157 de 5,729 tokens de entrada ao longo de quatro turnos foram lidos do cache em uma inicialização a frio. Com o timestamp na primeira linha, nenhum dos 5,579 tokens foi lido do cache. | Agente principal na demonstração | desde $0.1/M |
| DeepSeek V4.1 Flash Três verificações de uma frase cada custaram $0.0010 no GPT-6.1 Sol e $0.0001 neste modelo. | Subagente na demonstração | desde $0.3/M |
Conteúdo
- Por onde começar quando a conta vem acima do esperado?
- Por que a taxa de acerto do cache está em zero?
- Por que cada turno envia mais dados que o anterior?
- Como um loop de retries aparece?
- Como identificar um modelo caro fazendo uma tarefa simples?
- Perguntas frequentes
- Como descobrir qual parte do meu agente LLM custa mais?
- Por que a taxa de acerto do meu cache de prompts está em 0%?
- Por que o primeiro turno de uma conversa não encontra nada no cache?
- O cache de prompts torna gratuito um histórico longo?
- Quanto o cache de prompts economiza?
- Um loop de retries aparece como erro?
- Leituras relacionadas
A conta de um agente aumenta por motivos que não aparecem em uma requisição isolada: um prompt que nunca aproveita o cache, uma conversa que reenvia mais dados a cada turno, um loop que repete o mesmo trabalho ou um modelo caro fazendo algo que um modelo barato resolveria. Todos ficam claros quando as chamadas são agrupadas em sessões e traces. Este guia reproduz os quatro problemas em um pequeno agente de suporte, mostra onde cada um aparece no console da Synthorai, aplica a correção e compara os custos antes e depois.
TL;DR
- Um timestamp na primeira linha do prompt mantinha a taxa de acerto do cache em 0%. Movê-lo para o final elevou a taxa para 73% e reduziu o custo de entrada em 66% no GPT-6 Luna.
- Um histórico que reenviava todos os resultados de ferramentas consumiu três vezes mais tokens de entrada, mas custou apenas 21% mais na entrada, porque 71% veio do cache.
- Um loop de retries fez 10 chamadas ao modelo quando bastavam 2, todas com status 200.
- Três chamadas de um subagente no GPT-6.1 Sol representaram 81% do custo de uma sessão.
Este guia dá continuidade a Como rastrear um agente LLM, que explica os headers usados para agrupar chamadas em sessões e traces. Configure a demonstração conforme esse guia (Python 3.10 ou superior, com o virtualenv ativo). Depois, execute os quatro casos e também replay-mismatch (outra forma de perder o cache) no mesmo diretório de github.com/synthorai-io/use-cases:
cd use-cases/agent-tracing
python incidents.py cache-miss context-growth replay-mismatch retry-loop wrong-model
Cada caso roda duas vezes, primeiro com o problema e depois com a correção, e identifica suas chamadas com case e variant. Os números vêm de uma execução de cada caso em 11 de outubro de 2026. São frações de centavo porque a demonstração é pequena. As proporções são o que se mantém em uma carga real.
| Caso | Onde aparece | Antes | Depois |
|---|---|---|---|
cache-miss | Acerto do cache por turno na página da sessão | 0% em cache, $0.0015 | 73% em cache partindo de um cache vazio, $0.0011 |
context-growth | Entrada por turno aumentando ao longo da página da sessão | 24,546 tokens de entrada, $0.0011 de custo de entrada | 8,053 tokens de entrada, $0.0009 de custo de entrada |
replay-mismatch | Acerto do cache parado em 0% na página da sessão | 0% em cache, $0.0038 | 76% em cache, $0.0015 |
retry-loop | Um trace com muito mais chamadas do que um turno precisa | 10 chamadas, $0.0004 | 2 chamadas, $0.0001 |
wrong-model | Tabela de agentes na página da sessão | $0.0012 | $0.0003 |
Por onde começar quando a conta vem acima do esperado?
Comece pela lista de traces, ordenada por custo. Cada linha é uma sessão ou um trace, com número de chamadas, duração e custo. Assim, as conversas mais caras ficam no topo. Abra uma delas para identificar quais dos padrões abaixo estão presentes.
Se você identifica requisições com X-Synthorai-Metadata, filtre a lista primeiro. A busca da lista de traces aceita labels: metadata.feature = support-agent mostra apenas as sessões e os traces de uma funcionalidade, e metadata.case = cache-miss encontra as duas execuções desse caso. Para ver os totais, a aba de detalhamento em Analytics tem um cartão de custo por metadado: escolha uma chave para listar requisições, tokens de entrada e custo de cada valor.
Por que a taxa de acerto do cache está em zero?
A taxa fica em zero quando algo perto do início do prompt muda a cada requisição. O cache de prompts permite que o provedor cobre apenas uma fração do preço de entrada pelo início repetido de um prompt, mas só até o primeiro token diferente da requisição anterior. A versão com problema coloca a hora atual na primeira linha de um system prompt com cerca de 1,300 tokens:
# The clock is the first line, so the prompt differs from its first token on every turn.
system = f"Current time: {now}\n\n{SYSTEM}\n\n{MANUAL}"
Em uma conversa de quatro turnos no GPT-6 Luna, a página da sessão mostra 0% de acerto do cache: 0 dos 5,579 tokens de entrada. A correção move a parte variável para o final:
# Stable text first, the part that changes last.
system, user = f"{SYSTEM}\n\n{MANUAL}", f"{text}\n\n(Current time: {now})"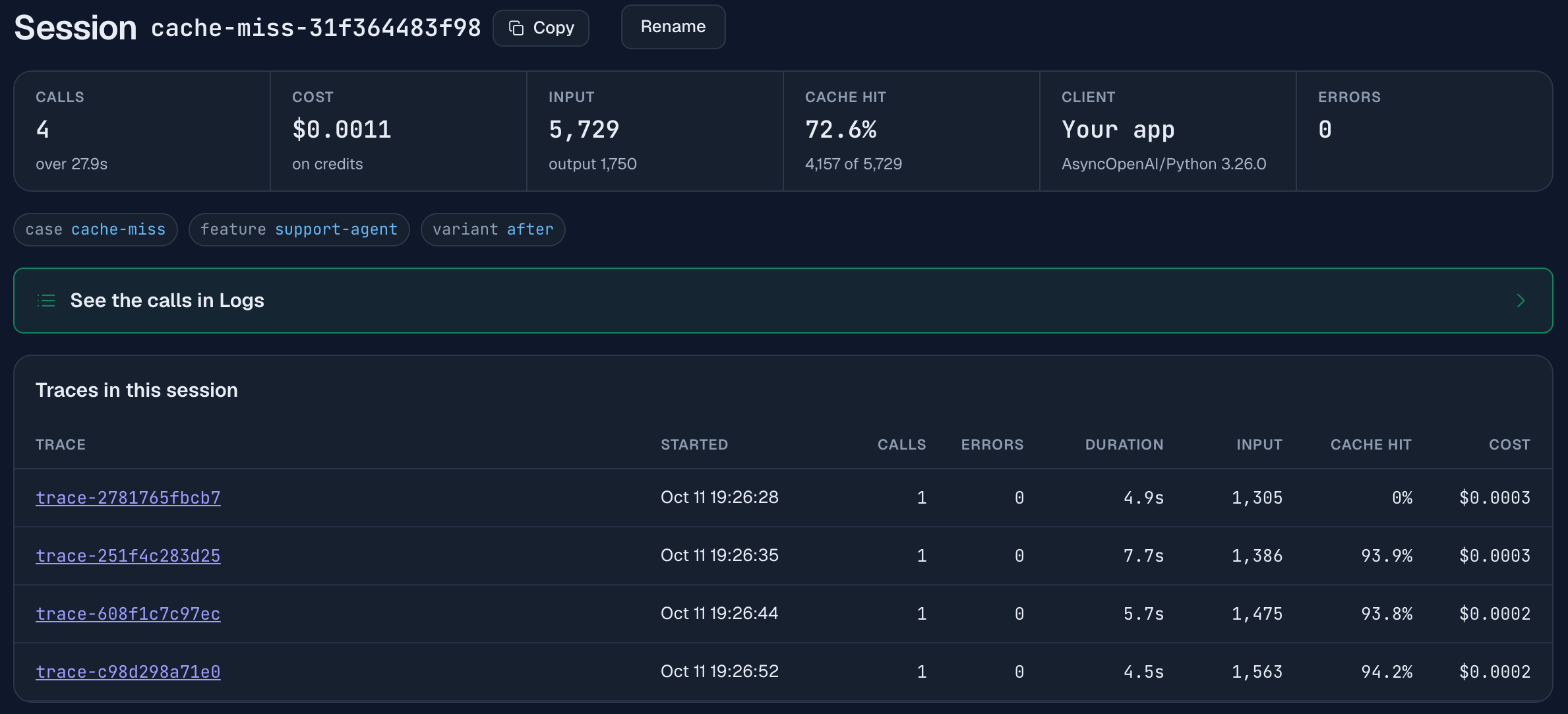
A página da sessão lista a entrada e o acerto do cache de cada turno, e a primeira linha mostra 0%. O primeiro turno não pode ler uma entrada que nenhuma requisição gravou ainda: ele grava a entrada, mas não lê nada. Os três turnos seguintes leem 1,302, 1,383 e 1,472 tokens do cache, quase tudo que o turno anterior enviou. Por isso, cada um lê cerca de 94% da entrada do cache. No total da conversa, são 4,157 dos 5,729 tokens de entrada, ou 73%.
A economia está na entrada. Esse modelo cobra $0.10 por milhão de tokens de entrada, $0.125 pelos tokens gravados no cache e $0.01 pelos tokens lidos do cache. Quase todo o conteúdo de um prompt longo entra em uma dessas duas últimas categorias.
A execução com problema gravou 5,567 tokens no cache e não leu nenhum. A corrigida gravou 1,560 e leu 4,157. Com isso, o custo de entrada caiu de $0.00070 para $0.00024, uma redução de 66%. O custo da sessão passou de $0.0015 para $0.0011. A queda foi menor no total porque a saída representa a maior parte dessa conta, e a execução corrigida acabou gerando mais tokens de saída (1,750 contra 1,599).
A economia depende do que já está no cache quando a conversa começa. Esta execução começou com o cache vazio, então o primeiro turno não leu nada. Um agente com tráfego constante deve superar os 73%: todas as conversas começam com o mesmo system prompt, e a entrada da conversa anterior continua disponível enquanto novas requisições chegam antes de ela expirar. Um prompt usado por uma única conversa paga o preço de gravação no primeiro turno.
O timestamp é a causa clássica. Um ID de requisição, uma saudação aleatória, um nome de usuário inserido no primeiro parágrafo ou definições de ferramentas em outra ordem causam o mesmo problema. Há mais duas condições para um acerto: o prefixo estável (o início do prompt que não muda) precisa superar o mínimo do provedor (1,024 tokens na maioria deles; veja cache de prompts), e as chamadas de uma conversa devem usar o mesmo X-Session-Id, que o gateway utiliza para manter a consistência dos acertos de cache da conversa.
Por que cada turno envia mais dados que o anterior?
Cada turno envia mais dados porque a conversa reenvia o histórico inteiro. Algum crescimento é normal, já que o histórico aumenta. A versão com problema cresce muito mais rápido: a cada turno, consulta o cliente, recebe cerca de 1,100 tokens de histórico de pedidos em JSON e mantém esse resultado no histórico. Assim, o sexto turno carrega seis cópias de dados quase idênticos.
if variant == "before":
    history += [lookup_result]               # every old lookup is sent again on every later turn
history += [{"role": "user", "content": text}, {"role": "assistant", "content": reply}]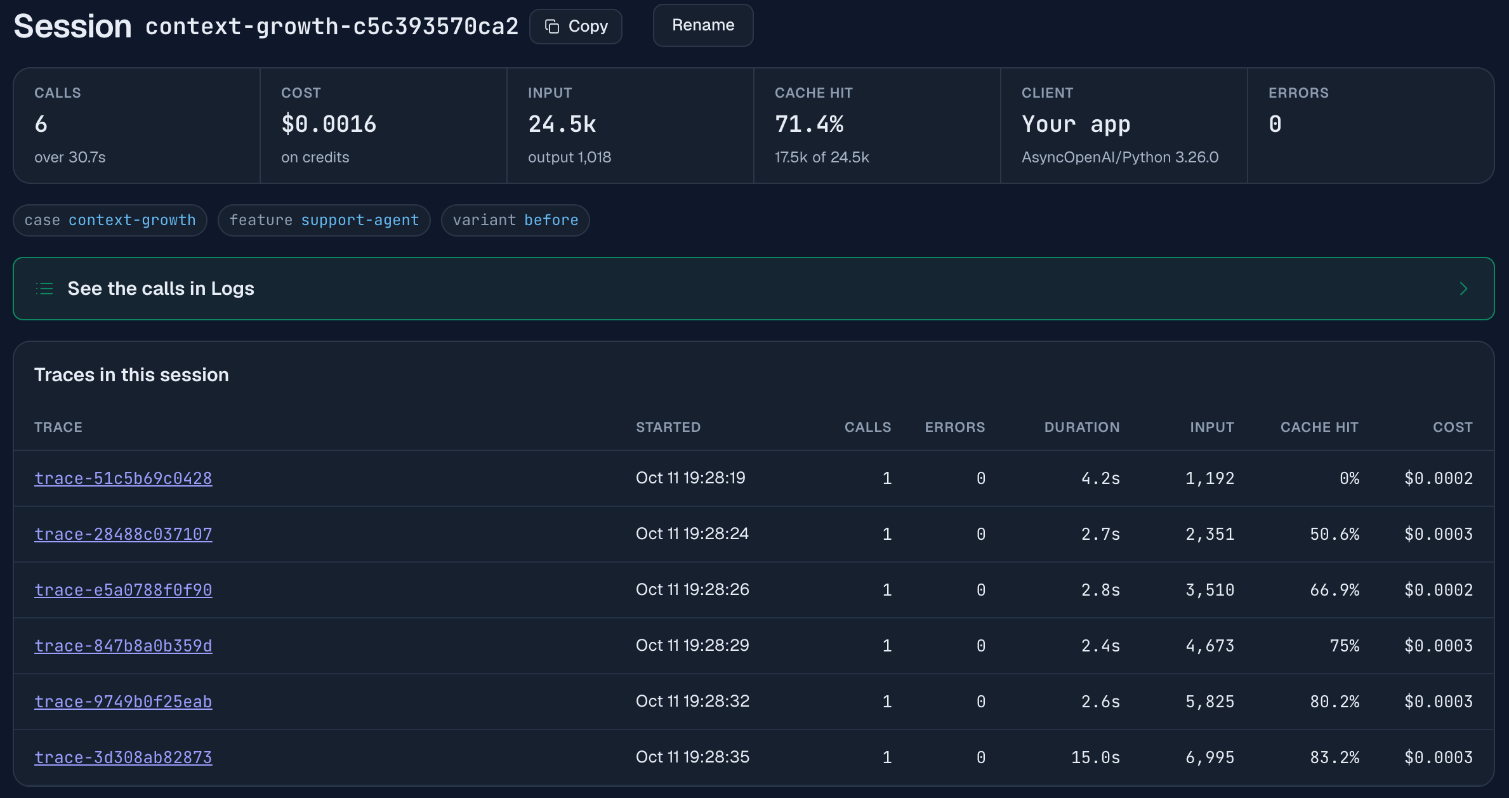
O sinal está na coluna de entrada da tabela de traces da sessão: ela cresce cerca de 1,160 tokens por turno, de 1,192 no primeiro para 6,995 no sexto, enquanto as respostas continuam com duas frases. Os seis turnos consumiram 24,546 tokens de entrada. Na versão corrigida, o turno atual ainda recebe uma consulta atualizada, mas as consultas antigas não são mantidas, porque a resposta do assistente já registrou o que importava. Os seis turnos passam a usar 8,053 tokens de entrada, um terço do total anterior.
As duas colunas ao lado da entrada explicam por que o problema passa despercebido. O acerto do cache aumenta junto com a entrada, e o custo por turno permanece entre $0.0002 e $0.0003. Cada turno começa com todo o prompt do turno anterior, então o provedor lê essa parte do cache: 17,536 dos 24,546 tokens de entrada, ou 71%. A entrada da sessão com problema custou $0.0011, contra $0.0009 na corrigida: três vezes mais tokens de entrada por um custo de entrada apenas 21% maior.
Neste par de execuções, os totais das sessões não revelam a correção. A sessão com problema custou $0.0016, e a corrigida, $0.0017, porque a execução corrigida acabou gerando mais saída (1,756 tokens contra 1,018). A saída adicional custou cerca de $0.0004, mais que os $0.0002 economizados na entrada. Compare as colunas de entrada e acerto do cache, que a correção altera, e não o total de uma sessão.
O cache de prompts pode absorver a maior parte do custo de um histórico crescente. Mas há três coisas que ele não faz:
- Não reduz o contexto. O sexto turno ainda envia 6,995 tokens. Uma sessão longa continua chegando ao limite de contexto do modelo, e um token em cache ainda é cobrado, pela tarifa de cache.
- Só funciona se o histórico for reenviado exatamente como foi enviado antes. A demonstração inclui o caso
replay-mismatch: uma instrução é acrescentada a cada mensagem do usuário no envio, mas a mensagem é salva sem ela. Cada turno reconstrói um prompt que o turno anterior nunca enviou. Essa conversa leu 0 dos 24,557 tokens de entrada do cache e custou $0.0038. Salvar a mensagem exatamente como foi enviada elevou a leitura para 18,844 dos 24,702 tokens, ou 76%, e reduziu o custo para $0.0015. - Não está disponível em todos os modelos. Pelo preço integral de entrada do GPT-6 Luna, usado neste caso, 24,546 tokens custam $0.0025, contra cerca de $0.0011 cobrados com cache. Confira a coluna de acerto do cache antes de contar com ele.
No seu agente, os resultados de ferramentas costumam ser a maior parte do histórico e a menos útil de reenviar. Mantenha a resposta que usou esses dados, ou um resumo de uma linha, e descarte o payload bruto. Assim, você economiza em qualquer modelo, com ou sem cache. Nosso guia de chatbots aborda a versão geral dessa técnica: resumir os turnos antigos.
Como um loop de retries aparece?
Ele aparece como um trace com muito mais chamadas do que um turno deveria precisar, repetindo os mesmos nomes de spans. Neste caso, a API de rastreamento da transportadora está fora do ar. O agente chama a ferramenta, recebe um timeout e responde que não consegue consultar a encomenda. O código verifica se a resposta informa a localização da encomenda. Como não informa, executa o turno inteiro de novo, até cinco vezes:
if "sorting" in reply or "out for delivery" in reply:
    break                                    # the reply names a parcel location
if variant == "after" and (tool_failed or not results):
    break                                    # a retry cannot help while the tool is down or unused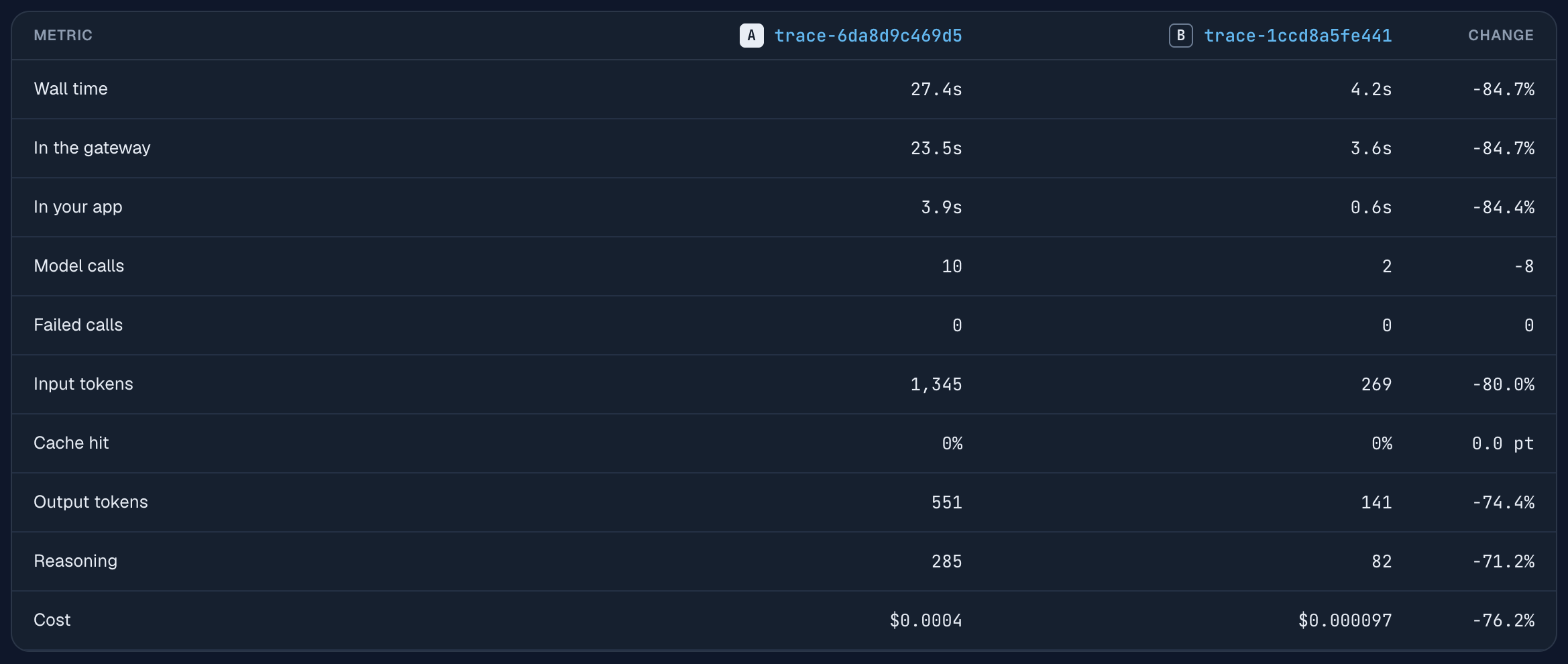
Esta é a visualização de comparação das duas execuções: abra um trace, selecione a opção de comparação e escolha o outro. A execução com problema fez 10 chamadas ao modelo em 27.4 s, por $0.0004, e o cliente recebeu a mesma resposta no final. O número de chamadas com falha é 0 nos dois lados. Todas as chamadas do loop tiveram sucesso com status 200, então nada aparece como erro. A versão corrigida distingue uma falha da ferramenta de uma resposta inadequada e não tenta de novo quando o problema está na ferramenta: 2 chamadas, 4.2 s, $0.0001.
No waterfall da execução com problema, as chamadas se chamam plan-1, answer-1, plan-2, answer-2 e assim por diante. Nomeie os spans com a etapa e a tentativa, como neste exemplo, para reconhecer um loop de imediato. Para encontrar loops que você ainda não conhece, ordene a lista de traces pelo número de chamadas.
Como identificar um modelo caro fazendo uma tarefa simples?
Veja a tabela de agentes da sessão, que separa as chamadas e o custo por agente. A versão com problema executa as três verificações de uma frase do subagente no GPT-6.1 Sol, que custa $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída. Enquanto isso, o agente principal responde no GPT-6 Luna:
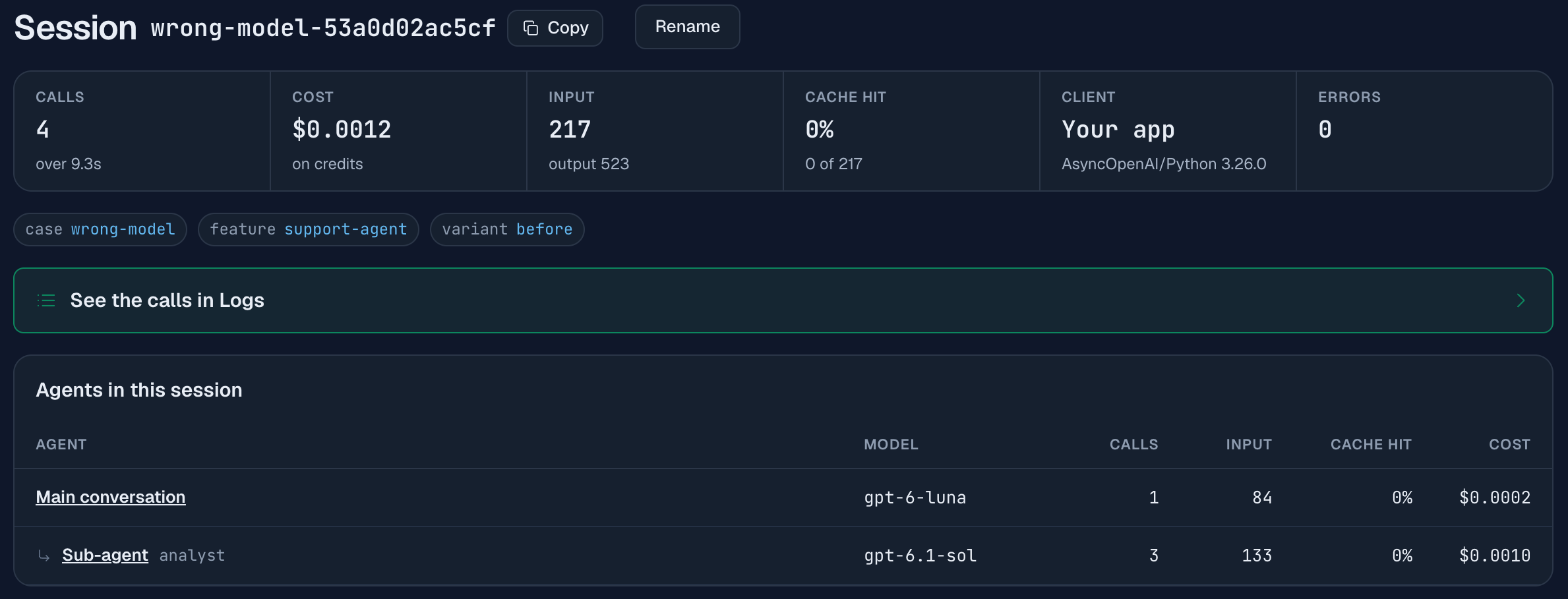
As três chamadas do subagente custaram $0.0010 dos $0.0012 da sessão: 81% da conta para o trabalho menos exigente da execução. As mesmas três verificações no DeepSeek V4.1 Flash custaram $0.0001, e a sessão totalizou $0.0003. As duas versões executam as verificações com reasoning desativado, então a diferença está no preço do modelo.
Este caso mede apenas o custo. Não avaliamos a qualidade das verificações, e um modelo mais barato só é a escolha certa se suas respostas forem boas o suficiente para essa etapa. A tabela mostra para onde vai o dinheiro, permitindo identificar qual etapa vale testar com um modelo mais barato.
A separação aparece quando as chamadas do subagente usam X-Agent-Id. Sem esse header, a tabela de modelos da sessão mostra os custos por modelo. Essa divisão só corresponde à divisão por agente quando cada agente usa seu próprio modelo. Para consultar um agente em todas as sessões, a aba de detalhamento em Analytics tem um cartão de custo por agente.
Perguntas frequentes
Como descobrir qual parte do meu agente LLM custa mais?
Agrupe as chamadas em sessões e traces usando headers de requisição. Depois, ordene a lista de traces por custo e abra o primeiro item. A página da sessão separa os custos por agente, modelo e turno. Isso basta para distinguir um problema de cache de um problema de contexto ou de escolha do modelo.
Por que a taxa de acerto do meu cache de prompts está em 0%?
A causa mais comum é um valor que muda perto do início do prompt, como um timestamp. O cache cobre apenas o trecho até o primeiro token diferente. Na demonstração, mover o timestamp da primeira linha do system prompt para o final da mensagem do usuário elevou a taxa de acerto de 0% para 73%, partindo de um cache vazio.
Por que o primeiro turno de uma conversa não encontra nada no cache?
Porque uma requisição precisa gravar a entrada no cache, e o primeiro turno é essa requisição. Na demonstração, os quatro turnos leram 0%, 93.9%, 93.8% e 94.2% da entrada do cache. O primeiro turno só lê do cache quando uma conversa anterior enviou o mesmo prefixo recentemente o suficiente para que a entrada ainda exista.
O cache de prompts torna gratuito um histórico longo?
Não, mas pode esconder a maior parte do custo. Na demonstração, uma conversa que reenviava todos os resultados antigos de ferramentas usou três vezes mais tokens de entrada que a versão enxuta (24,546 contra 8,053), mas o custo de entrada foi apenas 21% maior, porque 71% da entrada veio do cache. Os tokens continuam ocupando a janela de contexto, e o desconto desaparece assim que o histórico reenviado difere do que foi enviado antes. No caso replay-mismatch, salvar uma mensagem diferente da versão enviada levou a conversa a 0% de acerto do cache e a mais que o dobro do custo.
Quanto o cache de prompts economiza?
Depende do preço de entrada em cache do modelo e de quanto a entrada representa na conta. Na demonstração com o GPT-6 Luna, ler 73% da entrada da conversa do cache reduziu o custo de entrada em 66%. A sessão custou $0.0011, contra $0.0015 sem cache. Os tokens de saída representaram a maior parte da conta, e o cache não os altera.
Um loop de retries aparece como erro?
Não necessariamente. Na demonstração, todas as chamadas do loop retornaram status 200. O loop apareceu como um trace com 10 chamadas quando bastavam 2. Por isso, observe o número de chamadas por trace, não apenas a taxa de erro.
Leituras relacionadas
- Como rastrear um agente LLM: os headers, as sessões e os labels usados nesta página.
- Por que meu agente LLM está lento?: o mesmo método aplicado à latência.
- Como depurar um agente LLM: da reclamação do usuário à chamada que deu errado.
- Custo do Claude Code por subagente: a mesma visualização de sessão para um agente de programação, em que as gravações no cache representam 77% de uma execução.
- Pergunte ao Claude sobre seus logs de LLM: como encontrar a mais cara dessas sessões via MCP.
- Dê ao seu agente ferramentas para consultar logs: a leitura do mesmo log por um programa seu e o custo dos tokens do modelo.
- Cache de prompts: tamanho mínimo do prefixo e preços por provedor.
- Melhor LLM por caso de uso: custo conforme o perfil da carga, para escolher o modelo de cada etapa.