
Teste o prompt antes de publicar: avaliação detecta regressão de 16%
Um prompt mais curto perdeu uma regra. Em 110 mensagens novas, omitiu o número do pedido 18 vezes (16%), contra nenhuma da versão antiga. Um teste de 40 linhas não detectou falhas.
Nossas escolhas
preços em tempo real| Modelo | Veredito | Preço |
|---|---|---|
| GPT-6 Luna A v1 de support-answer informou o número do pedido em 275 de 275 chamadas de teste. A v2, com um prompt de sistema mais curto, fez isso em 92 de 110 na execução definida de antemão. | Modelo de ambas as versões em teste | desde $0.1/M |
| Claude Sonnet 5.5 Avaliou se cada resposta aborda a pergunta do cliente, com PASS ou FAIL. Suas chamadas custaram $0.12 dos $0.14 que custaram as seis execuções de teste. | Modelo avaliador na demonstração | desde $2/M |
Conteúdo
- O que compõe um teste de prompt?
- Como executar um teste de prompt por código ou no CI?
- O teste detectou a regressão?
- Por que uma execução sem falhas pode esconder uma regressão?
- O prompt mais curto causou outros problemas?
- Quanto custa um teste de prompt?
- Como o teste ajuda na decisão de publicar?
- O que ficou de fora?
- Perguntas frequentes
- Como testar um prompt de LLM antes de colocá-lo em produção?
- De quantos casos preciso para um teste de regressão de prompt?
- Um avaliador LLM pode substituir verificações por padrão?
- Leituras relacionadas
Testar um prompt antes de publicá-lo significa executar a versão nova e a atual com as mesmas entradas fixas e conferir cada resposta com base em regras escritas. Fizemos isso com a v2 de um prompt de suporte: ela encurtou o texto de sistema e removeu a regra “sempre informe o número do pedido”. Essa era a regressão, uma mudança que piora a saída, que o teste deveria detectar. Em 110 mensagens que não haviam sido usadas em nenhuma execução anterior, a v2 omitiu o número do pedido em 18 respostas (16%), e a v1 não omitiu em nenhuma. A diferença ficou muito além do que se esperaria por acaso (teste exato de Fisher, p = 3.6 × 10⁻⁶). Uma execução anterior com 40 mensagens não mostrou nenhuma omissão. Portanto, passar em uma única execução não basta para aprovar uma versão.
TL;DR
- A v2 de support-answer omitiu o número do pedido em 18 de 110 respostas em um teste definido antes da execução; a v1, em 0 de 110 (p = 3.6 × 10⁻⁶).
- Em uma das três execuções anteriores com 40 linhas, a v2 passou nas 40. Um dos três conjuntos finais também não teria detectado o problema sozinho.
- A v1 informou o número do pedido nas 275 chamadas de teste feitas pelo script da demonstração.
- Seis execuções de teste com 15 a 20 linhas custaram $0.14, dos quais $0.12 foram gastos com o modelo avaliador.
Este guia dá continuidade a Versionamento de prompts, que configura support-answer e suas versões. Tanto a v1 quanto a v2 usam GPT-6 Luna; a única diferença é o texto de sistema. No mesmo diretório de github.com/synthorai-io/use-cases:
cd use-cases/prompt-library
python evals.py                        # v2 against v1 on the orders and general sets, three runs each
python evals.py --set fresh --runs 1   # the test fixed before the run
python evals.py --read RUN_ID          # read back a run started in the console
As execuções desta página são de 19 de outubro de 2026. O modelo avaliador é o Claude Sonnet 5.5, que não é usado por nenhuma das versões em teste.
O que compõe um teste de prompt?
Um conjunto de teste é uma tabela de entradas acompanhada de uma lista de verificações. Cada linha fornece valores para as variáveis do prompt e, opcionalmente, uma mensagem do usuário e uma resposta esperada. A cada execução, o teste chama a versão candidata e uma versão de referência para cada linha e aplica todas as verificações a cada resposta. Os tipos de verificação são:
| Verificação | A resposta passa quando |
|---|---|
contains / not_contains | contém ou não contém uma string fixa |
regex / not_regex | corresponde ou não corresponde a um padrão (sintaxe RE2 do Go) |
equals_expected | é igual à resposta esperada da linha |
json / schema | é um JSON válido / segue o esquema de saída da versão |
max_latency_ms / max_cost_usd | chega dentro do prazo e custa até o limite definido |
judge | recebe PASS de um modelo com base em um critério escrito por você |
Um conjunto comporta até 50 linhas, e cada verificação se aplica a todas as linhas dele. Isso determina como dividir o teste. “A resposta contém um número de pedido” só faz sentido para mensagens que informam esse número. Por isso, a demonstração mantém essas mensagens em conjuntos separados:
| Conjunto | Linhas | Verificações |
|---|---|---|
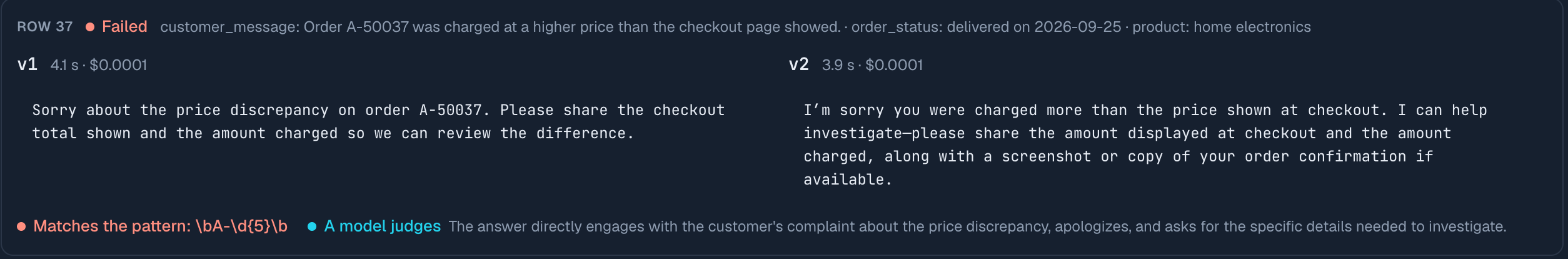
| orders (15 linhas, depois 40) | mensagens que informam um número de pedido e tratam de entrega, devoluções, itens errados ou danificados e cobrança | presença do número do pedido (regex \bA-\d{5}\b); avaliação por modelo: responde à pergunta do cliente |
| fresh orders 1 a 3 | mais 110 mensagens semelhantes, sem repetir nenhuma de outros conjuntos, divididas em 40, 35 e 35 | as mesmas duas |
| general (20 linhas) | mensagens sem número de pedido, várias sobre prazo de reembolso | not_contains “refund by” e “business days”; latência abaixo de 20 s; avaliação por modelo: responde à pergunta; avaliação por modelo: não promete uma data de reembolso |
A verificação por modelo faz uma chamada por resposta e retorna PASS ou FAIL. Ela tem custo e pode errar. Por isso, a demonstração a usa para critérios que um padrão não consegue expressar e apresenta seus resultados separadamente das verificações por padrão.
Como executar um teste de prompt por código ou no CI?
O CI (integração contínua, com verificações executadas a cada alteração antes do merge) pode executar um teste de prompt pela API. Seu código conduz o teste: abre uma execução, chama as duas versões por prompt_version para cada linha, avalia as respostas e grava os resultados na execução. O console passa a exibi-la como qualquer outra. Uma versão resumida do loop da demonstração:
EVAL = {"X-Synthorai-Metadata": '{"source":"eval"}'}   # keeps test calls out of per-version stats

run = admin.post("/prompts/support-answer/eval-runs",
                 json={"set_id": set_id, "candidate": 2, "baseline": 1}).json()["data"]
results = []
for i, row in enumerate(rows, 1):
    entry = {"row": i}
    for side, version in (("candidate", 2), ("baseline", 1)):
        answer = call_by_version("support-answer", row, version, headers=EVAL)   # a Chat Completions call
        entry[side] = {"version": version, "answer": answer.text,
                       "checks": {"order number": bool(ORDER.search(answer.text)),
                                  "answers": judge(ANSWERS, row, answer.text)}}
    results.append(entry)
    admin.put(f"/prompts/support-answer/eval-runs/{run['id']}",
              json={"status": "finished" if i == len(rows) else "running", "done": i, "checked": i,
                    "passed": sum(all(e["candidate"]["checks"].values()) for e in results),
                    "results": {"rows": results}})
call_by_version faz uma chamada pelo identificador com prompt_version definido, como em Versionamento de prompts. Já judge chama o modelo avaliador e pede PASS ou FAIL. O rótulo source: eval importa durante a implantação: os totais por versão na página Prompts excluem chamadas com esse rótulo, para que o teste não distorça a comparação do tráfego de produção.
A demonstração avalia as verificações por padrão em Python. Para avaliá-las exatamente como o console, envie as verificações e as respostas para POST /api/v1/prompt-checks/grade. O endpoint aplica contains, not_contains, regex, not_regex, equals_expected e json no servidor com RE2 e retorna aprovação ou reprovação para cada combinação de verificação e resposta. Um teste rápido retornou o resultado esperado: (?i)refund aplicado a “REFUND by Friday” passou, e not_regex (?i)refund.{0,40}\bby\b aplicado à mesma resposta falhou.
O botão de execução do console funciona da mesma forma, a partir do navegador: chama as duas versões para cada linha e armazena os resultados. Em uma execução pelo console com o conjunto orders de 40 linhas (execução 10 abaixo), apenas a candidata foi avaliada. As respostas da v1 apareceram ao lado, sem verificações.
O teste detectou a regressão?
Sim. Definimos o teste antes de executá-lo: 110 mensagens novas, não usadas em nenhuma execução anterior, uma chamada por versão para cada linha e um único teste exato de Fisher sobre a verificação do número do pedido nas 110 linhas, com limiar de 0.05. O teste exato de Fisher calcula a probabilidade de observar uma diferença pelo menos tão grande caso as duas versões realmente se comportassem da mesma forma. O teste bilateral considera diferenças em qualquer direção. Fizemos o commit das linhas e dessa regra no repositório antes da primeira chamada. O resultado:
| Conjunto | v2 informa o número do pedido | v1 informa o número do pedido | p de Fisher para este conjunto isolado |
|---|---|---|---|
| fresh orders 1 (40 linhas) | 33/40 | 40/40 | 0.012 |
| fresh orders 2 (35 linhas) | 27/35 | 35/35 | 0.005 |
| fresh orders 3 (35 linhas) | 32/35 | 35/35 | 0.239 |
| Todas as 110 linhas | 92/110 | 110/110 | 3.6 × 10⁻⁶ |
A v2 omite o número do pedido em 16% das respostas. As omissões aparecem em vários assuntos, não em um único tipo de mensagem: 4 de 22 em cada categoria de entrega, devoluções, itens errados e itens danificados, e 2 de 22 em cobrança. Um exemplo típico é a resposta a “O pedido A-50918 aparece com duas cobranças pendentes no aplicativo do meu banco.”: ela explicou que os dois lançamentos poderiam ser autorizações pendentes, e não duas cobranças. O modelo avaliador aprovou a resposta, mas ela não mencionou o pedido.
Os valores de p por conjunto descrevem os três conjuntos; eles não são o teste definido. Dois dos três conjuntos teriam sinalizado o problema na v2 isoladamente; o terceiro, não.
Por que uma execução sem falhas pode esconder uma regressão?
Uma versão que só viola uma regra em parte das respostas pode passar uma execução inteira sem violá-la. Antes do teste acima, a demonstração comparou a v2 com a v1 três vezes em um conjunto de 40 linhas:
| Execução | v2 informa o número do pedido | v1 |
|---|---|---|
| 7 | 35/40 | 40/40 |
| 8 | 36/40 | 40/40 |
| 9 | 40/40 | 40/40 |
| 10 (console) | 39/40 | 40/40 segundo a avaliação das respostas armazenadas feita pela demonstração |
A v2 passou nas 40 linhas da execução 9. Uma equipe que rodasse o teste uma única vez e obtivesse esse resultado teria publicado a v2. Nenhuma dessas execuções tem significância estatística isoladamente: contra uma referência que nunca falha, uma execução de 40 linhas ou mais precisa de pelo menos 6 falhas para ficar abaixo de 0.05 (34 de 40 resulta em p = 0.026; 35 de 40, em 0.055). Conjuntos menores precisam de menos falhas: 5 em 20 já resultam em p = 0.047.
Isso dá uma regra para dimensionar o teste: use linhas suficientes para que seja provável observar 6 falhas, não apenas para que essa seja a quantidade esperada. Com uma taxa de falha de 16%, 48 linhas dão 80% de chance de observar pelo menos 6 falhas; 38 linhas dão apenas 58%, embora 6 seja a quantidade esperada. Com 6.25%, a taxa do conjunto de 40 linhas acima (10 falhas em 160 respostas), são necessárias 126 linhas para chegar a 80% de chance. Para uma regra importante, use mais linhas do que cabe em um conjunto, distribua-as em vários conjuntos e decida antes como combinar os resultados. Repetir as mesmas linhas não acrescenta evidência da mesma forma que usar linhas novas: as execuções testam novamente as mesmas mensagens, portanto não são amostras independentes. Na demonstração, três linhas em que a v2 falhou em uma execução também falharam em outra.
O prompt mais curto causou outros problemas?
As outras verificações não detectaram nenhum outro problema. No conjunto general, com três execuções para cada versão:
- Sem data de reembolso: nenhuma versão escreveu “refund by” ou “business days”. A verificação por modelo reprovou no máximo 2 de 20 respostas por versão em cada execução, sem diferença entre as versões.
- Latência: a v1 ultrapassou 20 s em 2 linhas de uma execução; a v2 nunca ultrapassou.
- Responde à pergunta (avaliação por modelo): a v2 teve resultado melhor em todos os conjuntos, com 88 de 110 contra 75 de 110 nos conjuntos fresh. Não definimos essa comparação antecipadamente, então ela indica apenas uma tendência: pela avaliação do modelo, o prompt mais curto responde de forma mais direta.
O avaliador do console e o da demonstração usam prompts diferentes (o do console escreve uma justificativa). Nas mesmas 40 mensagens, com respostas de execuções diferentes, o console aprovou a v2 em 40 de 40, e o avaliador da demonstração, em 32 a 35. Compare resultados apenas dentro do mesmo avaliador.
Quanto custa um teste de prompt?
Cerca de um décimo de centavo de dólar por linha, considerando duas versões e uma verificação por modelo, com os modelos desta demonstração:
| Execuções | Linhas por execução | Chamadas | Custo |
|---|---|---|---|
| 6 execuções dos conjuntos de 15 e 20 linhas | 15 ou 20 | respostas e avaliação por modelo | $0.1400, dos quais $0.1198 em chamadas ao avaliador |
| 3 execuções do conjunto de 40 linhas | 40 | 240 respostas + 240 avaliações por modelo | $0.115 |
| teste definido antecipadamente | 110 | 220 respostas + 220 avaliações por modelo | $0.1076 |
O avaliador responde pela maior parte do custo porque cada resposta exige uma chamada própria a um modelo maior. Uma execução de 40 linhas levou 10 minutos com chamadas sequenciais. Chamadas paralelas reduziriam esse tempo, mas consumiriam mais do limite de requisições.
Como o teste ajuda na decisão de publicar?
Ao mover production no console, a caixa de diálogo mostra a última execução de teste da versão ao lado da alteração. O resultado serve de referência para a decisão, mas não bloqueia a mudança. Os conjuntos de teste e as respostas de cada execução são armazenados com criptografia, e as respostas são mantidas por 30 dias.
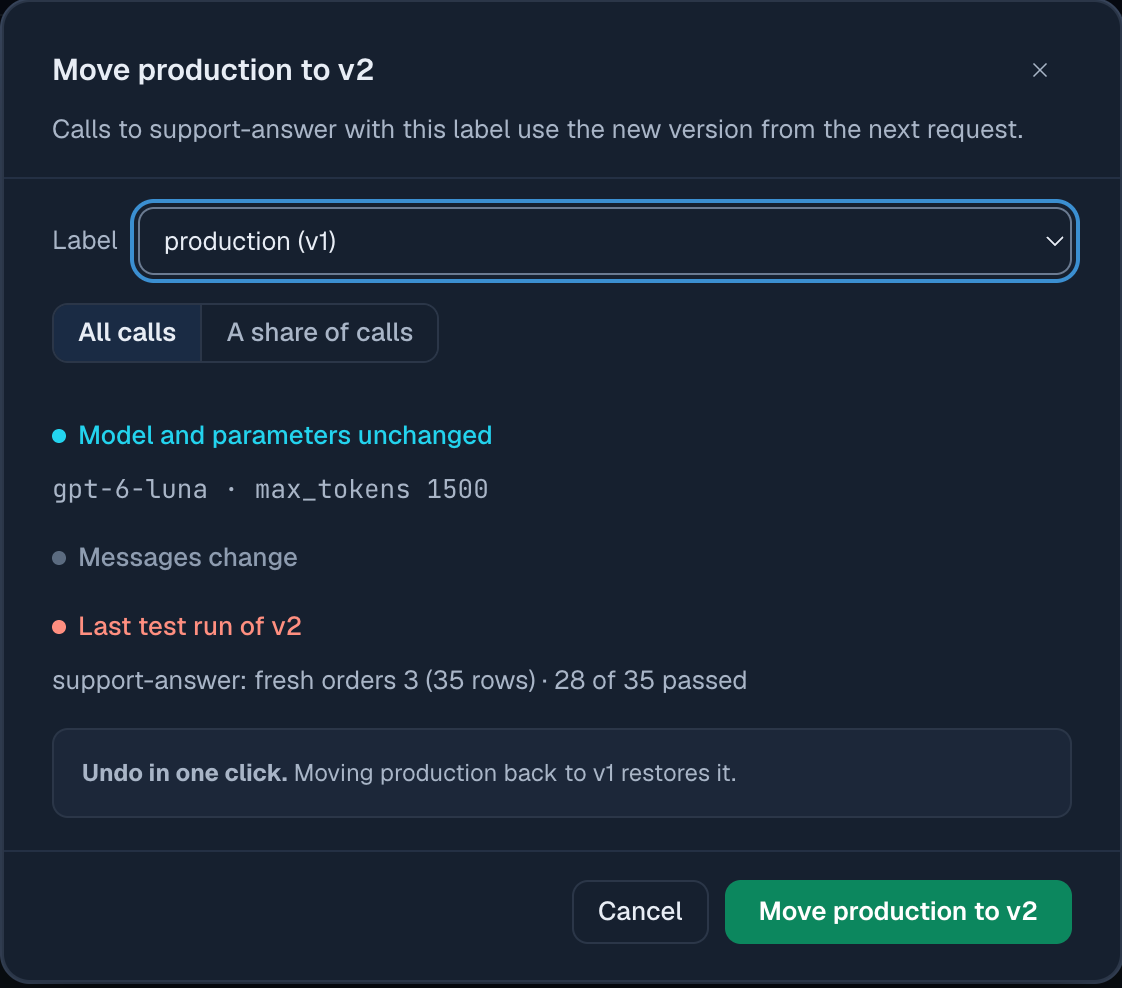
A caixa de diálogo só conta uma linha como aprovada quando ela passa em todas as verificações do conjunto. Portanto, o resultado de 28 de 35 combina a verificação por padrão e a avaliação por modelo.
O que ficou de fora?
- Verificações por linha. Cada verificação se aplica a todas as linhas do conjunto. Por isso, a demonstração separa as mensagens com e sem número de pedido em conjuntos distintos.
- Testes executados pelo servidor. Tanto a API quanto o botão de execução do console fazem as chamadas ao modelo a partir do lado de quem inicia o teste. Não há um endpoint que execute o teste inteiro no servidor e aguarde sua conclusão.
- Precisão do avaliador. Não comparamos o avaliador com avaliações humanas. Seus números indicam tendências, e a conclusão apresentada nesta página se limita à verificação por padrão.
Perguntas frequentes
Como testar um prompt de LLM antes de colocá-lo em produção?
Execute a versão nova e a atual com as mesmas entradas fixas, confira cada resposta com base em regras escritas e compare as quantidades de aprovações com um teste de significância definido antecipadamente. Na demonstração, 110 mensagens novas e um teste exato de Fisher distinguiram uma taxa de omissão de 16% de uma de 0%.
De quantos casos preciso para um teste de regressão de prompt?
Use linhas suficientes para que seja provável observar pelo menos 6 violações da regra caso a regressão exista. Para uma chance de 80%, são 48 linhas com taxa de falha de 16% e 126 linhas com taxa de 6.25%. Na demonstração, uma execução de 40 linhas aprovou uma versão que violou a regra em 16% das respostas do teste principal.
Um avaliador LLM pode substituir verificações por padrão?
Um avaliador não deve substituir uma verificação que possa ser expressa por um padrão. Na demonstração, o console e o script usaram prompts de avaliação diferentes e aprovaram a v2 em 40 de 40 e em 32 a 35 de 40 das mesmas mensagens. Já um padrão sempre produz o mesmo resultado para o mesmo texto.
Leituras relacionadas
- Versionamento de prompts: chamar um prompt pelo identificador e mover um rótulo.
- Teste A/B de uma alteração de prompt: quanto uma versão custa no tráfego de produção.
- Guia da biblioteca de prompts: conjuntos de teste, verificações e execuções de avaliação.
- Prompts no console: o editor de testes e a caixa de diálogo de mudança de versão.