
Rastreie um agente LLM com 3 headers HTTP, sem SDK
Adicione três headers às chamadas de modelo de um agente e veja cada execução em cascata: chamadas paralelas, tempo no seu código, falhas e custo.
Nossas escolhas
preços em tempo real| Modelo | Veredito | Preço |
|---|---|---|
| GPT-6 Luna Executa o ciclo de chamadas de funções da demonstração. Suas duas chamadas por turno (planejamento e resposta) custam $0.0002 juntas na execução mostrada nesta página. | Agente principal da demonstração | desde $0.1/M |
| DeepSeek V4.1 Flash Executa as três verificações paralelas de uma frase com o raciocínio desativado. Suas seis chamadas na sessão mostrada nesta página custam $0.0004, e uma sétima chamada do subagente falhou com custo de $0. | Subagente da demonstração | desde $0.3/M |
Conteúdo
- O que enviar para gerar um trace?
- O que o agente da demonstração faz?
- Como ler o gráfico em cascata?
- O que uma sessão acrescenta ao trace?
- Como separar custos por funcionalidade ou usuário?
- O que acontece quando uma chamada falha?
- Como obter o custo de cada chamada no código?
- E se o agente já envia headers de rastreamento?
- O que fazer depois de obter um trace?
- O que ficou de fora?
- Perguntas frequentes
- Preciso de OpenTelemetry para rastrear um agente LLM?
- Qual é a diferença entre um trace e uma sessão?
- Os headers de rastreamento alteram o roteamento, a cobrança ou o que o modelo vê?
- Por quanto tempo os traces são mantidos?
- Uma chamada que falha tem algum custo?
- Leituras relacionadas
É difícil depurar um agente que faz cinco chamadas de modelo para responder a uma mensagem olhando apenas um log de requisições: não dá para saber quais chamadas pertencem à mesma execução, quais rodaram em paralelo ou quanto da espera veio do seu próprio código. Neste guia, adicionamos três headers de requisição a um pequeno agente de suporte e examinamos o resultado no console do Synthorai como um trace (uma execução desenhada numa linha do tempo) e uma sessão (uma conversa com seu custo). Não há SDK de rastreamento para instalar nem coletor (um serviço separado que recebe traces) para manter. O código está em github.com/synthorai-io/use-cases, no diretório agent-tracing/. Você precisa de Python 3.10 ou posterior e de uma chave de API do console.
TL;DR
- Três headers de requisição (
X-Trace-Id,X-Span-Id,X-Session-Id) em cada chamada de modelo transformam o log de requisições em traces e sessões no console do Synthorai, sem SDK de rastreamento. - No trace da demonstração, os 8.5 s de tempo total se dividem em cerca de 7.0 s nas chamadas de modelo e 1.6 s fora delas, no código do agente e na rede.
- Uma chamada que falhou com 404 permaneceu no trace e custou $0.
- A execução de demonstração, com 21 chamadas de modelo, custou $0.0017.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put your API key in it
cd agent-tracing
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python run.py --fail
Quando rodamos a demonstração em 11 de outubro de 2026, ela fez 21 chamadas de modelo em menos de um minuto e custou $0.0017. O programa imprime dois IDs de sessão e quatro IDs de trace. Abra Traces no console e você encontrará os mesmos IDs. O console usa o fuso horário do navegador, por isso as capturas destas páginas mostram 19:24 para 11:24 UTC.
O que enviar para gerar um trace?
Envie três headers em cada chamada de modelo, usando strings que você mesmo define. O gateway já registra todas as requisições. Os headers apenas indicam quais delas pertencem ao mesmo grupo.
| Header | Use o mesmo valor em | Resultado |
|---|---|---|
X-Trace-Id | todas as chamadas de uma execução (o processamento completo de uma mensagem do usuário) | as chamadas aparecem em um único gráfico em cascata |
X-Span-Id | uma única chamada | o nome da linha dessa chamada no gráfico |
X-Session-Id | todas as chamadas de uma conversa | as execuções ficam agrupadas, com os totais da conversa |
Um span é uma etapa de um trace. Neste guia, cada span corresponde a uma chamada de modelo. Cada ID pode ter até 128 caracteres ASCII imprimíveis. O gateway devolve os IDs na resposta e não os encaminha ao provedor do modelo.
Há mais três headers opcionais. X-Agent-Id identifica o subagente que fez a chamada, X-Parent-Agent-Id identifica o agente que iniciou esse subagente, e X-Synthorai-Metadata carrega rótulos como a funcionalidade ou o usuário final. Todos estão na referência de headers de requisição. A demonstração envia X-Agent-Id e rótulos, mas não envia X-Parent-Agent-Id: seu único subagente é iniciado pelo agente principal, sem outros níveis de aninhamento para descrever.
Na demonstração, uma função monta os headers de cada chamada. Essa função é toda a camada de rastreamento:
@dataclass
class Run:
    """One agent run, which the gateway shows as one trace."""
    session_id: str
    labels: dict = field(default_factory=dict)
    trace_id: str = field(default_factory=lambda: new_id("trace"))

    def headers(self, span: str, agent: str | None = None, parent: str | None = None) -> dict:
        h = {
            "X-Session-Id": self.session_id,
            "X-Trace-Id": self.trace_id,
            "X-Span-Id": span,
        }
        if agent:
            # Only sub-agents need an id. Calls without one belong to the main agent.
            h["X-Agent-Id"] = agent
        if parent:
            h["X-Parent-Agent-Id"] = parent
        if self.labels:
            h["X-Synthorai-Metadata"] = json.dumps(self.labels, separators=(",", ":"))
        return h
Todas as chamadas de modelo do agente passam por um wrapper que adiciona esses headers. No SDK Python da OpenAI, os headers por requisição vão em extra_headers:
raw = await client.chat.completions.with_raw_response.create(
    model=model, messages=messages,
    extra_headers=run.headers(span, agent, parent), **kwargs)
resp = raw.parse()
request_id = raw.headers.get("x-request-id")   # the gateway's id for this call
with_raw_response serve apenas para ler os headers da resposta. Se você não precisa do ID da requisição, basta usar create(..., extra_headers=...).
O que o agente da demonstração faz?
Ele responde à mensagem de um cliente em quatro etapas e cinco chamadas de modelo, escolhidas para tornar o trace útil. O agente principal usa GPT-6 Luna e o subagente usa DeepSeek V4.1 Flash; ambos são configurados por variáveis de ambiente. As chamadas do subagente usam reasoning_effort="none", porque uma verificação de uma frase não exige que o modelo raciocine antes. Se você configurar o subagente com um modelo que rejeita esse valor, altere ou remova ANALYST_REASONING.
| Span | Responsável | O que acontece |
|---|---|---|
plan | agente principal | lê a mensagem e solicita ferramentas (function calling: o modelo retorna um nome de função e argumentos para seu código executar) |
| nenhum | seu código | executa duas ferramentas locais em paralelo: uma consulta de pedido (1.2 s) e uma busca de políticas (0.6 s) |
sentiment, policy-check, risk | subagente analyst | três verificações de uma frase, enviadas ao mesmo tempo |
answer | agente principal | escreve a resposta com base nos resultados das ferramentas e nas três verificações |
As ferramentas são funções Python simples com um sleep, simulando um banco de dados e um índice de busca. Com --fail, uma chamada policy-check primeiro solicita um modelo inexistente, recebe um 404 e é repetida com o nome de span policy-check.retry.
run.py simula duas conversas com dois turnos cada. Cada conversa recebe um ID de sessão, e cada turno recebe um novo ID de trace:
session_id, history = new_id("support"), []
for text in turns:
    run = Run(session_id, labels={"feature": "support-agent", "release": "v2", "_user": user})
    reply = await handle(run, history, text)
Como ler o gráfico em cascata?
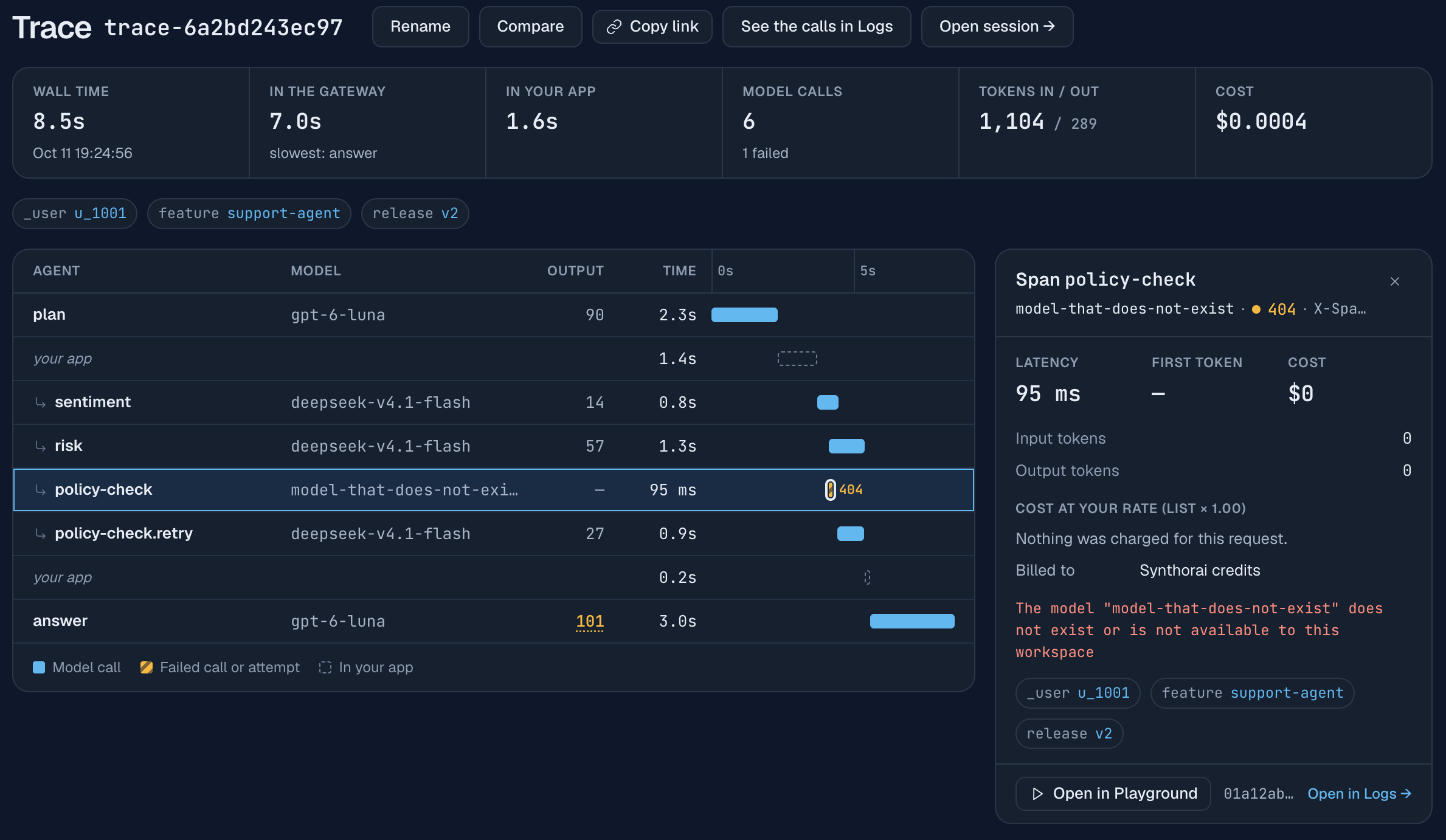
Cada linha representa uma chamada de modelo ou um intervalo no seu próprio código. Elas ficam numa linha do tempo que começa quando a primeira chamada da execução chega ao gateway. A captura acima mostra o segundo turno da primeira conversa. De cima para baixo:
planlevou 2.3 s. A barra mostra o tempo que o gateway gastou nessa requisição, do recebimento até o fim da resposta.your applevou 1.4 s. Não havia requisições em andamento nesse intervalo, então o tempo foi gasto fora do gateway: no seu código e na rede entre ele e o gateway. Aqui são as duas ferramentas locais, e a mais lenta espera 1.2 s. Num agente real, é nessa linha que uma consulta lenta ao banco ou uma busca vetorial fica visível.sentiment,riskepolicy-check.retryse sobrepõem. O agente enviou as três verificações comasyncio.gather; chamadas paralelas aparecem como barras sobrepostas. A seta antes dos nomes identifica chamadas feitas por um subagente.policy-checkaparece como uma marca hachurada de 95 ms com404. Uma chamada que falha permanece no trace com o código de status recebido pelo seu código.answerlevou 3.0 s e foi a chamada mais lenta, como também indica o resumo acima do gráfico.- A coluna Output mostra os tokens de saída de cada chamada. A geração da saída ocupa o tempo da chamada, então essa coluna costuma explicar o comprimento da barra ao lado:
answergerou 101 tokens, e cada uma das três verificações gerou de 14 a 57. O console sublinha a contagem quando a maior parte de uma saída mais longa foi usada para raciocínio, como ocorre com os 101 tokens aqui.
O resumo divide os 8.5 s de tempo total em 7.0 s no gateway e 1.6 s no aplicativo. Essa divisão responde à primeira dúvida na maioria das investigações de latência: olhar as chamadas de modelo ou o próprio código. Nesta execução, 82% da espera veio dos modelos, e as duas chamadas do agente principal, plan e answer, respondem por 5.3 s desse tempo. Portanto, usar um modelo mais rápido no agente principal ajudaria mais do que acelerar as três verificações.
O gateway não enxerga o que acontece dentro do seu código. Ele deduz as linhas your app pelos intervalos entre requisições, então um intervalo informa quanto tempo seu código rodou, mas não o que ele fez. Se você precisa de spans para suas próprias funções, use um SDK de OpenTelemetry, o padrão aberto de rastreamento. Os dois podem compartilhar IDs: quando você não envia X-Trace-Id, o gateway lê traceparent, o header padrão que carrega um ID de trace.
O que uma sessão acrescenta ao trace?
Uma sessão agrupa as execuções de uma conversa e soma seus dados. Abra uma pela lista de traces ou use a opção de abrir sessão em qualquer trace.
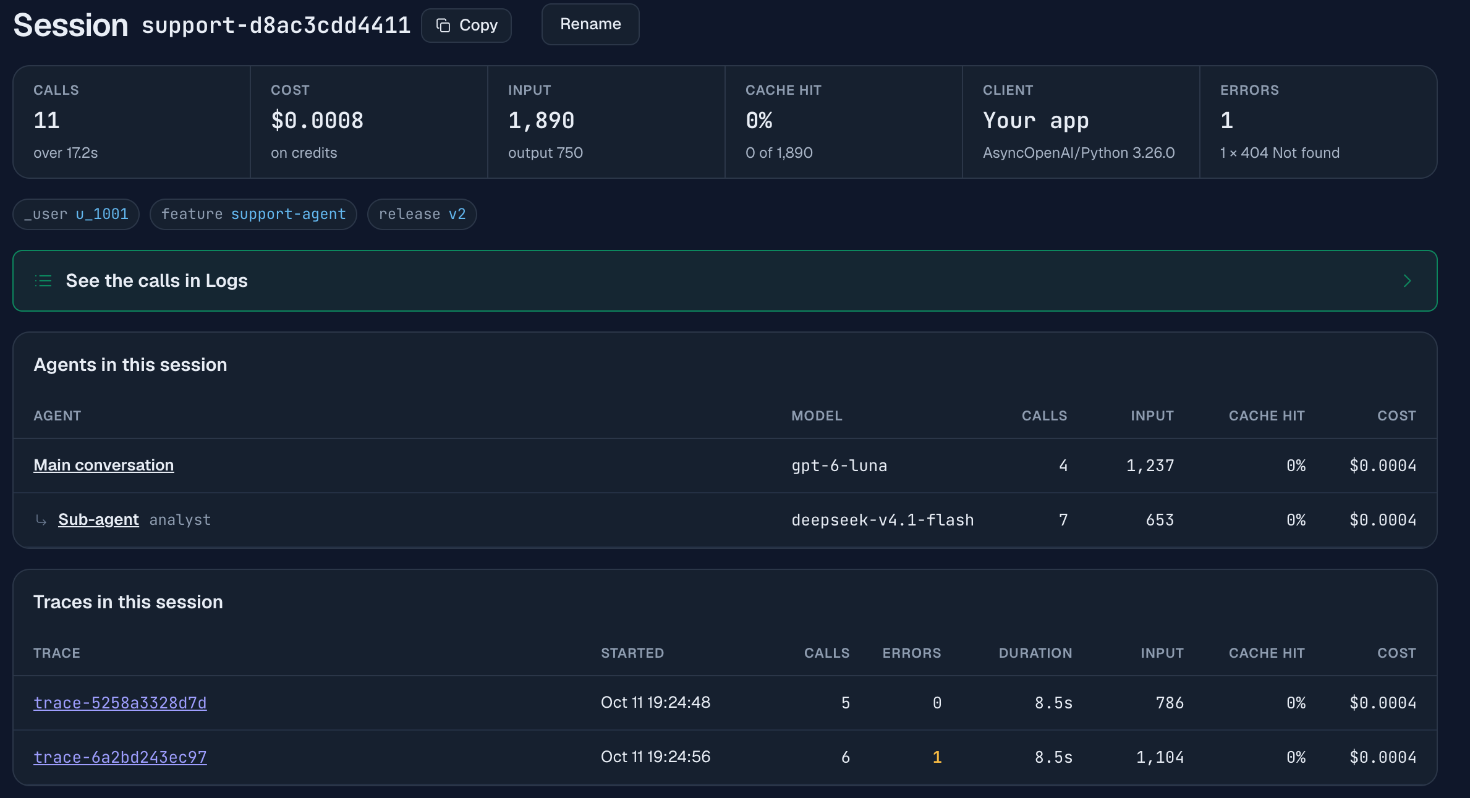
A sessão acima é uma conversa de dois turnos com um cliente: 11 chamadas, 1,890 tokens de entrada e 750 de saída, $0.0008 e um erro. A página tem três partes:
- Agentes nesta sessão separa chamadas e custos por agente. O agente principal fez 4 chamadas ao GPT-6 Luna por $0.0004, e o subagente
analystfez 7 chamadas por $0.0004: seis ao DeepSeek V4.1 Flash e uma que falhou. Essa tabela aparece porque as chamadas do subagente enviaramX-Agent-Id: analyst. Chamadas sem esse header são contabilizadas na conversa principal. - Traces nesta sessão lista cada turno com seus erros, duração, tokens de entrada, acertos de cache e custo. Assim você encontra o turno lento, com falha ou caro de uma conversa longa sem percorrer um log.
- Acertos de cache é a proporção de tokens de entrada lidos do cache de prompts do provedor. Aqui ela é 0%, porque os prompts têm poucas centenas de tokens, e os provedores só armazenam prefixos acima de um tamanho mínimo (1,024 tokens na maioria deles; veja cache de prompts).
O ID de sessão tem outra função quando seus prompts ficam longos o suficiente para usar cache. Envie o mesmo X-Session-Id em todas as chamadas de uma conversa: o gateway o usa para manter a consistência dos acertos de cache de prompts, de modo que o segundo turno leia o cache gravado pelo primeiro. Em /v1/chat/completions e /v1/responses, você pode enviar o valor no corpo da requisição como session_id se for difícil configurar headers no seu framework.
Como separar custos por funcionalidade ou usuário?
Envie X-Synthorai-Metadata com um objeto JSON de strings, sem aninhamento, e depois agrupe ou filtre por ele. A demonstração rotula todas as chamadas com uma funcionalidade, uma versão e o usuário final:
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}Os rótulos aparecem como pequenas tags no trace e na sessão. Para ver os totais, abra a área de análise, selecione a aba de detalhamento e encontre o cartão de custo por metadados. Escolha uma chave para listar todos os seus valores com requisições, erros, tokens de entrada e custo:
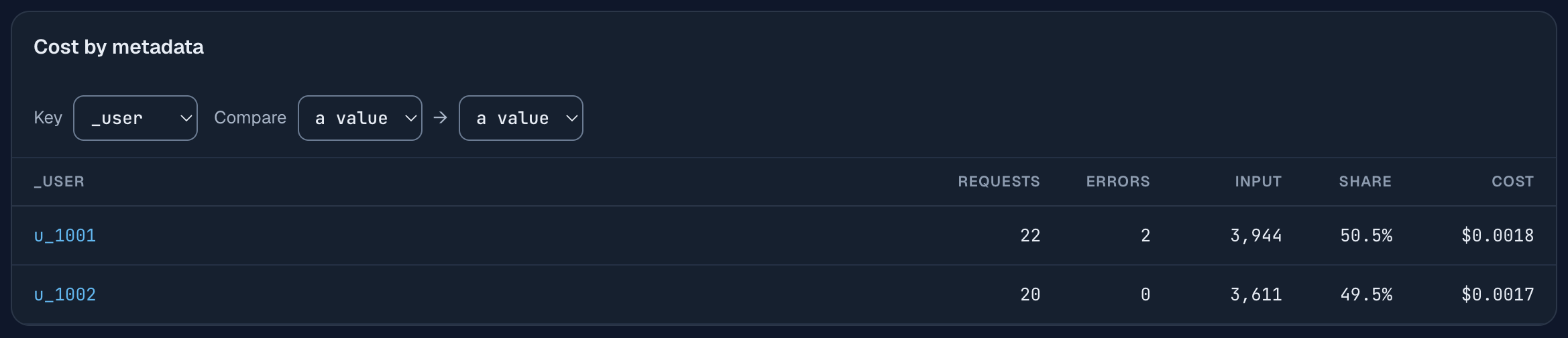
O cartão acima cobre uma hora em que a demonstração rodou duas vezes: 22 requisições e $0.0018 para u_1001, cujas execuções incluem as duas chamadas que falharam, e 20 requisições e $0.0017 para u_1002. Após uma execução, você verá 11 e 10. Escolha feature como chave para ver o custo de cada funcionalidade, ou release para ver o efeito de uma mudança de prompt no custo. O cartão também permite comparar dois valores de uma chave lado a lado. Na mesma aba, o cartão de custo por agente soma cada X-Agent-Id entre sessões.
Para encontrar as execuções por trás de um número, use os rótulos na busca. Digite metadata._user = u_1002 na caixa de busca da lista de traces e pressione Enter para mostrar apenas as sessões e os traces desse usuário. A caixa de filtros dos logs aceita a mesma expressão para requisições individuais.
As regras dos rótulos são simples:
- No máximo 10 rótulos por requisição. Uma chave tem de 1 a 32 caracteres entre
a-z,0-9,_,.e-. Um valor é uma string de até 128 bytes. _useridentifica o usuário final para quem a requisição foi feita. Outras chaves que começam com sublinhado são reservadas.- Um rótulo que viola uma regra é descartado, mas a requisição continua. O header de resposta
X-Synthorai-Metadata-Droppedlista as chaves descartadas, então registre esse header durante a configuração. Para testar, enviamos uma chave chamadaBad?Key, e o header retornou comBad?Key. - Não coloque texto de prompts, dados pessoais ou segredos nos rótulos. Use seu ID interno de usuário em
_user, não um endereço de e-mail.
O que acontece quando uma chamada falha?
Ela permanece no trace como uma marca hachurada com seu código de status e não custa nada. Na demonstração, a chamada policy-check que falhou solicitou um ID de modelo inexistente. Selecioná-la no gráfico abre o painel à direita da captura acima, com o erro recebido pelo código: The model "model-that-does-not-exist" does not exist or is not available to this workspace, latência de 95 ms, custo de $0 e a indicação de que nada foi cobrado.
A demonstração dá à nova tentativa um nome de span próprio:
try:
    await call(run, span, model=BROKEN_MODEL, messages=messages, agent="analyst")
except APIStatusError:
    span = f"{span}.retry"      # the retry is its own span, so both show in the waterfall
resp = await call(run, span, model=ANALYST_MODEL, messages=messages, agent="analyst", max_tokens=400,
                  **analyst_options())   # reasoning_effort="none" unless ANALYST_REASONING says otherwise
Manter o ID de trace e mudar o nome do span coloca a falha e a nova tentativa lado a lado na mesma visualização. Se a lógica de retry estiver numa biblioteca que reutiliza os mesmos headers, as duas tentativas ainda aparecem, como duas linhas com o mesmo nome.
Os erros também são agregados. O resumo do trace mostra “6 chamadas de modelo, 1 falha”, a sessão lista seus erros por código de status (1 × 404 Not found), e a lista de traces tem uma coluna de erros que você pode ordenar para encontrar as execuções que precisam de atenção.
Como obter o custo de cada chamada no código?
Consulte o registro de cobrança da requisição no gateway usando o ID retornado na resposta. GET /v1/generation?id=<request id> retorna o custo, as contagens de tokens, a latência e o status de uma requisição.
async def cost_of(http: httpx.AsyncClient, request_id: str) -> float | None:
    """The billing record of one request. It is written a moment after the call returns."""
    if not request_id:
        return None                                  # a call that got no response has no record
    for _ in range(6):
        try:
            r = await http.get(f"{BASE_URL}/generation", params={"id": request_id})
            if r.status_code == 200:
                return r.json()["data"]["total_cost"]
        except (httpx.HTTPError, KeyError, TypeError, ValueError):
            pass                                     # a dropped connection or a half-written record: try again
        await asyncio.sleep(2)
    return None
O registro é gravado pouco depois do fim da resposta, então a função faz novas tentativas até receber um 200. Ela recebe um httpx.AsyncClient que o chamador cria uma única vez, com o header Authorization configurado, e passa a cada consulta. Consultar vinte chamadas pelo mesmo cliente reutiliza algumas conexões. Criar um cliente para cada consulta abre vinte conexões de uma vez; nas nossas execuções, uma ou duas delas caíram. A demonstração imprime uma linha por chamada com seus próprios tempos e esses registros. Este é o primeiro turno da sessão nas capturas:
trace trace-5258a3328d7d  session support-d8ac3cdd4411
  plan                 main     gpt-6-luna                 200   1878 ms    153 in   22 out  $0.000026
  sentiment            analyst  deepseek-v4.1-flash        200   1431 ms     91 in   28 out  $0.000061
  risk                 analyst  deepseek-v4.1-flash        200   1877 ms     96 in   33 out  $0.000068
  policy-check         analyst  deepseek-v4.1-flash        200   1885 ms     96 in   39 out  $0.000076
  answer               main     gpt-6-luna                 200   4142 ms    350 in  339 out  $0.000205
Os tempos aqui são medidos no cliente e incluem a rede, por isso são maiores que as barras do console, que medem a requisição dentro do gateway. No segundo turno, mostrado no gráfico acima, plan levou 2,499 ms no cliente e 2.3 s no gateway, enquanto answer levou 3,161 ms e 3.0 s. A diferença pode ser maior nas chamadas paralelas: a chamada que falhou levou 694 ms no cliente e 95 ms no gateway.
Copie essa função se quiser registrar o custo cobrado de cada chamada nos seus próprios logs. Ela não serve para interromper uma execução que está gastando demais: cada registro chega um pouco depois da chamada, e a função pode esperar vários segundos por ele. Para controlar o orçamento durante a execução, calcule o preço do usage de cada resposta conforme ela chega e use esses registros depois para conferir as contas.
E se o agente já envia headers de rastreamento?
Nesse caso, talvez você não precise adicionar nada. Para cada um dos três IDs ausente na requisição, o gateway lê o header equivalente que ferramentas comuns já enviam:
| Ferramenta usada | Header enviado | Interpretado como |
|---|---|---|
| Instrumentação HTTP do OpenTelemetry | traceparent | trace, com o ID de pai usado como span |
| SDK LiteLLM | X-Litellm-Trace-Id, X-Litellm-Session-Id | trace, sessão |
| SDK Langfuse | baggage: langfuse_trace_id=…, langfuse_session_id=… | trace, sessão |
| Open WebUI | X-OpenWebUI-Chat-Id | sessão |
| Claude Code | X-Claude-Code-Session-Id | sessão |
| OpenAI Codex CLI | Session-Id | sessão |
Se ambos estiverem presentes, seus próprios X-Trace-Id, X-Span-Id e X-Session-Id têm prioridade. A lista completa está na referência de headers de requisição. Frameworks de agentes que não enviam nenhum desses headers precisam recebê-los pela configuração de headers personalizados que oferecem.
O que fazer depois de obter um trace?
O uso mais comum é compará-lo com outro. Toda página de trace tem um botão de comparação: escolha um segundo trace, e o console mostra os dois numa página, com cada métrica como A, B e a diferença, cada chamada pareada com a chamada de mesmo nome e os dois gráficos na mesma linha do tempo. Assim você verifica o efeito de uma mudança no prompt, no modelo ou no seu código sobre a execução.
Três guias seguintes usam o mesmo agente e os mesmos headers, com problemas reproduzidos, corrigidos e comparados dessa forma:
- Por que meu agente LLM está lento? Chamadas sequenciais, uma ferramenta lenta no seu código e raciocínio para respostas de uma linha.
- Por que meu agente LLM está caro? Um timestamp que invalida o cache, contexto crescente, um loop de retries e o modelo errado.
- Depure um agente LLM Da reclamação de um usuário à chamada que deu errado.
Outros três examinam o mesmo log por outros ângulos:
- Custo do Claude Code por subagente Um agente de programação que você não escreveu, analisado nas mesmas visualizações de sessão e agente.
- Pergunte ao Claude sobre seus logs de LLM Perguntas sobre essas sessões, respondidas numa janela de chat por uma conexão MCP somente de leitura.
- Dê ferramentas de log ao seu agente As mesmas ferramentas num programa seu e o custo dos tokens do modelo.
O que ficou de fora?
A demonstração cobre chamadas de modelo. Uma configuração de produção costuma acrescentar quatro pontos:
- Spans para seu próprio código. O gateway mostra os intervalos entre chamadas de modelo, mas não o que aconteceu neles. Instrumente ferramentas, recuperação de dados e filas com OpenTelemetry e propague
traceparent, para que um único ID de trace conecte as duas visualizações. - Corpos dos prompts e das respostas. Este guia usa os registros de tempo, tokens e custo de cada chamada. Ele não cobre a inspeção do conteúdo enviado ao modelo.
- Orçamentos.
cost_offornece o valor cobrado depois da chamada. Interromper uma execução ao atingir um limite exige calcular o preço dousagede cada resposta assim que ela chega, com algumas linhas no loop do agente que a demonstração não inclui. - Amostragem. Todas as chamadas são registradas, porque o trace é montado a partir do log de requisições que o gateway já mantém. Não há nada para amostrar, e a única sobrecarga no agente são alguns headers.
Perguntas frequentes
Preciso de OpenTelemetry para rastrear um agente LLM?
Não. Três headers de requisição (X-Trace-Id, X-Span-Id, X-Session-Id) em cada chamada de modelo bastam para gerar um gráfico em cascata das chamadas, com os intervalos entre elas atribuídos ao aplicativo. OpenTelemetry passa a ser útil quando você também quer spans para suas próprias funções.
Qual é a diferença entre um trace e uma sessão?
Um trace é uma execução do agente: tudo o que ele faz para processar uma mensagem do usuário ou uma tarefa. Uma sessão é uma conversa composta de várias execuções. Na demonstração, cada conversa com um cliente é uma sessão com dois traces, e cada trace tem cinco ou seis chamadas de modelo.
Os headers de rastreamento alteram o roteamento, a cobrança ou o que o modelo vê?
X-Trace-Id e X-Span-Id não alteram nada. X-Session-Id mantém a consistência dos acertos de cache de prompts de uma conversa. Nenhum desses headers é encaminhado ao provedor do modelo, e a cobrança usa o ID de requisição do próprio gateway.
Por quanto tempo os traces são mantidos?
Traces e sessões são montados a partir do log de requisições e cobrem os mesmos 90 dias. A lista de traces abre mostrando os últimos 7 dias.
Uma chamada que falha tem algum custo?
A chamada que falhou na demonstração, um 404 por ID de modelo desconhecido, foi registrada com custo de $0 e a indicação de que nada foi cobrado.
Leituras relacionadas
- Crie um chatbot com LLM: o caso de um único agente, com gerenciamento de contexto, memória e cache de prompts.
- Referência de headers de requisição: todos os headers desta página, com os aliases lidos de outras ferramentas.
- Traces e sessões no console: a lista, o gráfico em cascata e a página de sessão.
- Anatomia do uso de tokens em LLMs: o significado das contagens de tokens de cada registro, por provedor.