
Versões de prompts: mudanças em menos de 10 s, sem redeploy
Guarde prompts de LLM numa biblioteca, chame por prompt_id e publique movendo um rótulo. Medimos 8 a 9 s até as chamadas reais, com os mesmos 114.5 tokens de prompt do envio inline.
Nossas escolhas
preços em tempo real| Modelo | Veredito | Preço |
|---|---|---|
| GPT-6 Luna Serviu v1 e v2 de support-answer. Uma chamada por id do prompt enviou os mesmos 114.5 tokens de prompt (mediana de 20 pares) que a requisição renderizada enviada inline. | Modelo do prompt de resposta da demonstração | desde $0.1/M |
| DeepSeek V4.1 Flash Executou policy-check v1 com um esquema de saída armazenado na versão: uma resposta JSON em 18 tokens de saída por $0.000033, com reasoning_effort definido como none. | Modelo da verificação de JSON da demonstração | desde $0.3/M |
Conteúdo
- Como chamar um prompt por id?
- Chamar por id custa mais do que escrever o prompt no código?
- Quanto tempo uma mudança de rótulo leva para chegar às chamadas?
- O que acontece quando uma chamada não pode ser atendida?
- O que uma versão pode guardar além do texto?
- Onde consultar qual versão respondeu a uma chamada?
- O que ficou de fora?
- Perguntas frequentes
- O que é versionamento de prompts?
- Chamar um prompt por id acrescenta latência ou tokens?
- Quanto tempo uma mudança de prompt leva para chegar à produção?
- Posso continuar usando o SDK da OpenAI ou da Anthropic?
- Leituras relacionadas
Versionar prompts significa manter cada prompt fora do código, em versões numeradas e imutáveis, chamá-lo por um id e escolher a versão usada em produção apontando um rótulo para ela. Um rótulo é um ponteiro com nome, como production ou staging, que aponta para uma versão por vez. Na biblioteca de prompts da Synthorai, a requisição identifica o prompt com prompt_id, e o gateway preenche as mensagens, o modelo e os parâmetros da versão. Mover o rótulo production muda o que as próximas chamadas recebem. Nos nossos testes, a mudança chegou às chamadas reais em 8 a 9 segundos com tráfego contínuo e já na primeira chamada após um período sem tráfego. A chamada por id enviou exatamente a mesma quantidade de tokens de prompt que a mesma requisição escrita no código.
TL;DR
- Uma chamada por
prompt_idao gateway da Synthorai enviou uma mediana de 114.5 tokens de prompt em 20 pares, igual à requisição enviada inline. - A mudança do rótulo
productionchegou às chamadas em 8.0 a 8.5 s (mediana) com tráfego contínuo, e imediatamente após 15 s sem chamadas. - Em 20 mudanças de rótulo, nenhuma chamada recebeu a versão antiga depois que a primeira recebeu a nova.
- As chamadas que não puderam ser atendidas falharam com 400 ou 404 antes de executar qualquer modelo, sem cobrança.
Este guia move os prompts do agente de suporte de Rastreamento de um agente LLM para a biblioteca e faz chamadas de todas as formas aceitas pelo gateway. O código está em github.com/synthorai-io/use-cases, na pasta prompt-library/. Você precisa de Python 3.10 ou posterior, uma chave de inferência e uma chave de administrador com prompts.write, obtidas no console.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put both keys in it
cd prompt-library
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python setup.py         # saves the prompts and their versions; safe to run again
python call.py          # every way to call a prompt
python ship.py          # moves production and times it
python errors.py        # what a call that cannot be served answers
Os testes desta página foram feitos em 19 de outubro de 2026. O setup.py salva dois prompts. O support-answer é a etapa de resposta do agente, com quatro versões que introduzem, cada uma, uma mudança realista. O policy-check é uma verificação feita por um subagente que responde em JSON:
| Prompt | Versão | O que muda | Modelo |
|---|---|---|---|
support-answer | v1 | versão base: informar o número do pedido, nunca prometer uma data de reembolso | GPT-6 Luna |
support-answer | v2 | texto de sistema mais curto, sem a regra do número do pedido | GPT-6 Luna |
support-answer | v3 | texto da v1 em outro modelo | DeepSeek V4.1 Flash |
support-answer | v4 | v1 com uma variável {{tone}} sem valor padrão | GPT-6 Luna |
policy-check | v1 | tópicos e nível de risco em JSON que segue um schema | DeepSeek V4.1 Flash |
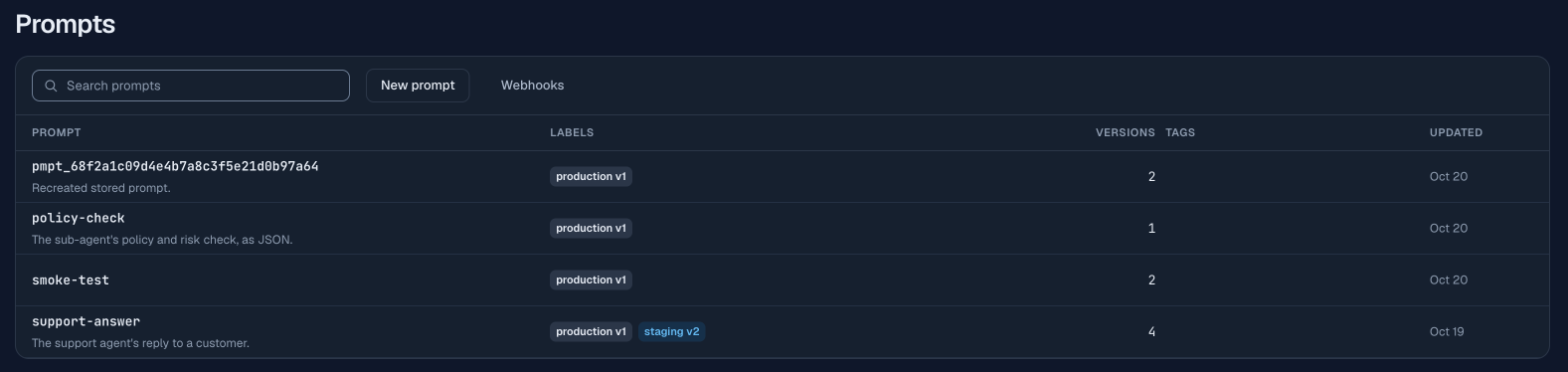
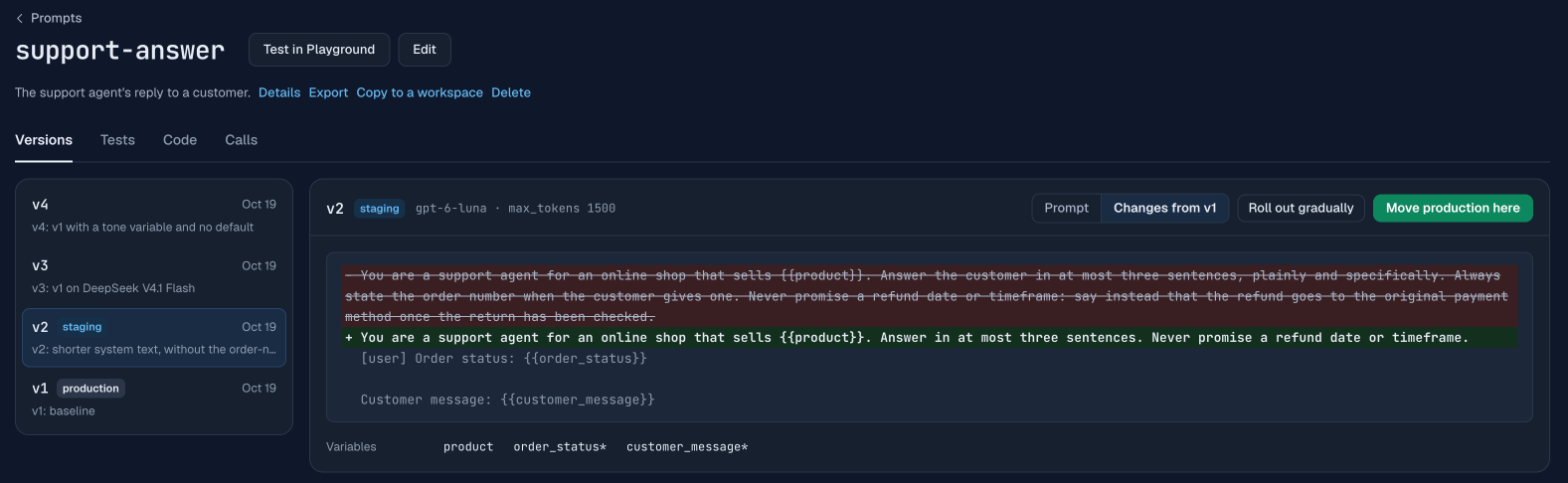
O production aponta para a v1, e o staging, para a v2. As versões v2 e v3 são o tema dos próximos dois guias: testar uma versão antes de publicá-la e liberar uma versão para parte do tráfego de produção. O console compara cada versão com a anterior:
Como chamar um prompt por id?
Envie uma requisição comum para /v1/chat/completions, /v1/responses ou /v1/messages e acrescente prompt_id e prompt_variables ao corpo. Uma variável é um marcador {{name}} no texto da versão, e prompt_variables define o valor de cada marcador nessa chamada. Os SDKs exigem um modelo e uma mensagem, então envie qualquer nome de modelo e uma mensagem de usuário vazia: o gateway usa o modelo da versão e descarta a mensagem vazia. No SDK Python da OpenAI, os campos extras vão em extra_body:
import os
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key=os.environ["SYNTHORAI_API_KEY"])

raw = client.chat.completions.with_raw_response.create(
    model="any",                                   # the version's model is used
    messages=[{"role": "user", "content": ""}],    # required by the SDK; dropped
    extra_body={
        "prompt_id": "support-answer",
        "prompt_variables": {
            "customer_message": "Where is order A-50977? It has been a week.",
            "order_status": "in transit, shipped on 2026-10-01",
        },
    },
)
print(raw.headers["x-synthorai-prompt-version"])   # which version answered
print(raw.parse().choices[0].message.content)
O product não aparece na chamada porque a versão define um valor padrão (“eletrônicos para casa”). O cabeçalho de resposta X-Synthorai-Prompt-Version informa qual versão respondeu. Essa é a única forma de o cliente saber a versão quando faz uma chamada por rótulo.
Sem uma versão explícita, a chamada usa a versão para a qual production aponta. Há dois campos para escolher outra versão; a chamada deve enviar um ou outro, nunca os dois:
| Campo | Exemplo | Versão usada na demonstração |
|---|---|---|
| nenhum | v1 (production) | |
prompt_label | "staging" | v2 |
prompt_version | 1 | v1 |
A mesma chamada por id funcionou nos três endpoints: Chat Completions e Responses pelo SDK da OpenAI, e Messages pelo SDK da Anthropic, com o mesmo extra_body. Os três usaram a v1 no GPT-6 Luna. No Responses, as mensagens da versão vão para input; o guia da biblioteca de prompts detalha o mapeamento de cada campo por endpoint.
Chamar por id custa mais do que escrever o prompt no código?
Chamar por id custa o mesmo que enviar a requisição escrita no código, porque o gateway envia uma requisição comum ao provedor. Verificamos isso com 20 pares. Em cada par, renderizamos o prompt, enviamos a requisição renderizada inline e enviamos os mesmos valores por id. Alternamos a ordem e usamos o mesmo salt em cada par, uma pequena marca aleatória adicionada à mensagem para que nenhum par repetisse a mesma requisição:
| Tokens de prompt, mediana | Latência no cliente, mediana | |
|---|---|---|
Por prompt_id | 114.5 | 4.1 s |
| Inline | 114.5 | 4.6 s |
As contagens de tokens são idênticas. A chamada por id foi a mais rápida das duas, algo que um custo adicional de processamento não explicaria. Por isso, atribuímos a diferença à variação entre chamadas do GPT-6 Luna e concluímos que chamar por id não acrescentou tempo mensurável. Não fizemos um teste estatístico da diferença de latência.
Para ver o que uma chamada enviaria sem executar um modelo, renderize o prompt. O POST /v1/prompts/{id}/render recebe as mesmas variáveis e retorna a requisição e a versão resolvida:
curl https://synthorai.io/v1/prompts/support-answer/render \
  -H "Authorization: Bearer $SYNTHORAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"format": "chat", "prompt_variables": {"customer_message": "Where is order A-50977?", "order_status": "in transit"}}'
A renderização não é cobrada e não aparece em Logs: após a renderização da demonstração, não havia em Logs nenhuma requisição com o id de sessão usado. Ela conta para o limite de requisições da chave.
Quanto tempo uma mudança de rótulo leva para chegar às chamadas?
Menos de 10 segundos: nos nossos testes, 8 a 9 s com chamadas contínuas e nenhum tempo de espera após um período sem tráfego. Publicar uma versão exige uma única chamada com uma chave de administrador, apontando um rótulo para um número de versão:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})
admin.put("/prompts/support-answer/labels/production", json={"version": 3}).raise_for_status()
Para reverter, faça a mesma chamada com o número da versão anterior. Seu código continua chamando o mesmo id, sem redeploy. Só um administrador ou o proprietário do workspace pode mover um rótulo, e cada mudança fica registrada no log de auditoria do workspace.
O ship.py mediu esse tempo. Ele enviou uma chamada a cada 0.5 s, moveu production pela API e continuou chamando até o cabeçalho indicar a nova versão, mantendo as chamadas por mais 10 s. Fez isso 5 vezes da v1 para a v3 e 5 vezes no sentido inverso. Depois repetiu as 10 mudanças após 15 s sem chamadas:
| Cenário | Última chamada respondida pela versão antiga, enviada em | Primeira chamada respondida pela versão nova, enviada em |
|---|---|---|
| Chamadas a cada 0.5 s, v1 para v3 | mediana de 8.02 s após a mudança (7.53 a 8.53) | mediana de 8.52 s (8.03 a 9.03) |
| Chamadas a cada 0.5 s, v3 para v1 | mediana de 7.52 s (7.52 a 8.52) | mediana de 8.02 s (8.02 a 9.02) |
| Após 15 s sem chamadas, nos dois sentidos | nenhuma | 0.0 s, nas 10 mudanças |
Os tempos são contados a partir do retorno da chamada à API que move o rótulo. A documentação diz que a mudança chega às chamadas em “cerca de 10 segundos”. Os dois cenários são compatíveis com um gateway que mantém o valor lido de um rótulo por alguns segundos desde a última leitura: com tráfego contínuo, a mudança aparece quando essa cópia expira; após uma pausa, a primeira chamada lê o rótulo novamente. Em nenhuma das 20 mudanças houve uma chamada que recebeu a versão antiga depois da primeira que recebeu a nova. Portanto, a propagação da mudança não ficou alternando entre versões.
O que acontece quando uma chamada não pode ser atendida?
Ela falha antes de chamar qualquer modelo, com 400 ou 404 no formato de erro do endpoint usado, sem cobrança. O errors.py enviou cinco chamadas desse tipo:
| Chamada | Status | Código | Mensagem |
|---|---|---|---|
v4 sem tone | 400 | prompt_variable_missing | ”prompt_variables: falta tone (sem valor e sem padrão)“ |
| uma versão e um rótulo | 400 | prompt_invalid | ”envie prompt_version ou prompt_label, não ambos” |
| um id que não existe | 404 | prompt_not_found | ”prompt_id: não existe prompt “support-answer-missing” neste workspace” |
| versão 99 | 404 | prompt_not_found | ”o prompt “support-answer” não tem versão 99” |
| um rótulo que não aponta para versão alguma | 404 | prompt_not_found | ”o rótulo “development” do prompt “support-answer” ainda não aponta para nenhuma versão” |
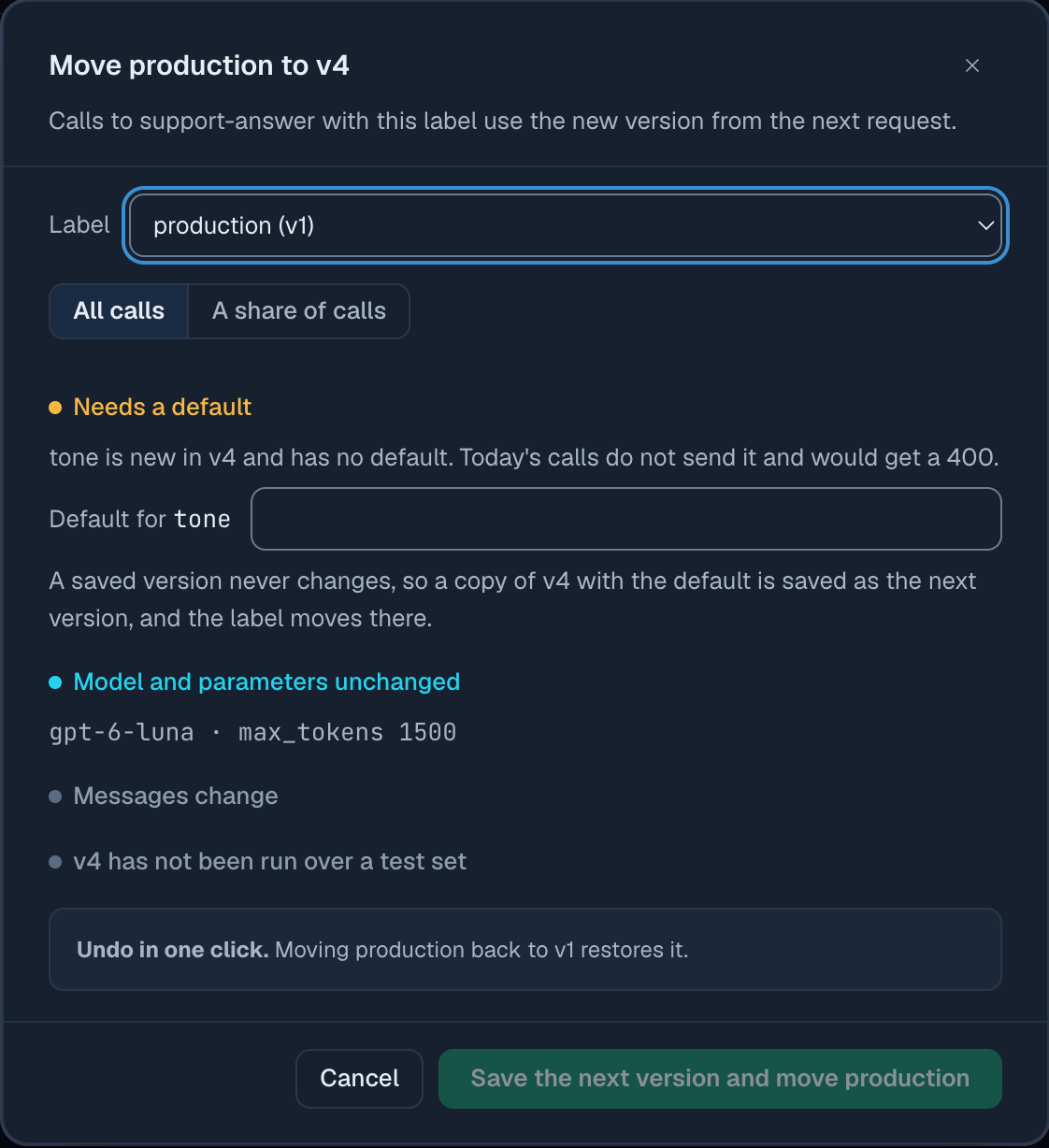
Nenhuma das cinco tem registro de cobrança. A primeira linha mostra uma mudança que quebraria os clientes: a v4 adiciona uma variável sem valor padrão, então toda chamada que não enviar tone falha. O console detecta isso antes da publicação. Ao mover production para a v4, ele abre um diálogo que verifica o impacto sobre as chamadas atuais e pede um valor padrão, que é salvo na próxima versão.
Se a biblioteca ficar temporariamente indisponível para leitura, o gateway usa a última cópia lida por até 24 horas e acrescenta X-Synthorai-Prompt-Stale: 1 à resposta. Um prompt sem cópia recente retorna 503 prompt_unavailable; tente novamente. Não observamos nenhum desses casos na demonstração.
O que uma versão pode guardar além do texto?
Uma versão guarda o texto de sistema, as mensagens, o modelo, cinco parâmetros, um schema de saída e ferramentas de função. Para os parâmetros, os valores da requisição têm prioridade: temperature, max_tokens, top_p, response_format e reasoning_effort da versão só se aplicam quando a requisição não define o mesmo campo.
O policy-check mantém seu schema JSON na versão. Assim, os clientes recebem JSON que segue o schema sem precisar enviar um formato. Ao salvar pela API, a versão define o formato em params e guarda o schema em schema:
version = {
    "model": "deepseek-v4.1-flash",
    "system": "You review messages to an online electronics shop's support desk. ...",
    "messages": [{"role": "user", "content": "{{customer_message}}"}],
    "params": {"max_tokens": 300, "response_format": "json_schema"},
    "schema": {"name": "policy_check", "strict": True, "schema": {
        "type": "object",
        "properties": {"topics": {"type": "array", "items": {"type": "string"}},
                       "risk": {"type": "string", "enum": ["low", "medium", "high"]}},
        "required": ["topics", "risk"], "additionalProperties": False}},
}
admin.post("/prompts/policy-check/versions", json={"body": version, "note": "v1: JSON check"}).raise_for_status()
Salvar um schema sem response_format: "json_schema" é rejeitado com um 400 que informa esse requisito. Uma chamada de policy-check no DeepSeek V4.1 Flash retornou {"topics": ["shipping", "refunds"], "risk": "medium"} com 151 tokens de entrada e 18 de saída, por $0.000033. Essa chamada enviou reasoning_effort: "none" pelo cliente, porque as versões da demonstração foram salvas antes de ser possível guardar esse parâmetro na versão. Agora uma versão pode armazená-lo em params: salvamos uma versão de teste com reasoning_effort: "none" e a renderizamos. A requisição incluiu reasoning_effort no Chat Completions e reasoning.effort no Responses. No Messages, o valor da versão é omitido porque os modelos Claude recebem as configurações de thinking em outro formato; nesse endpoint, envie essas configurações pelo cliente.
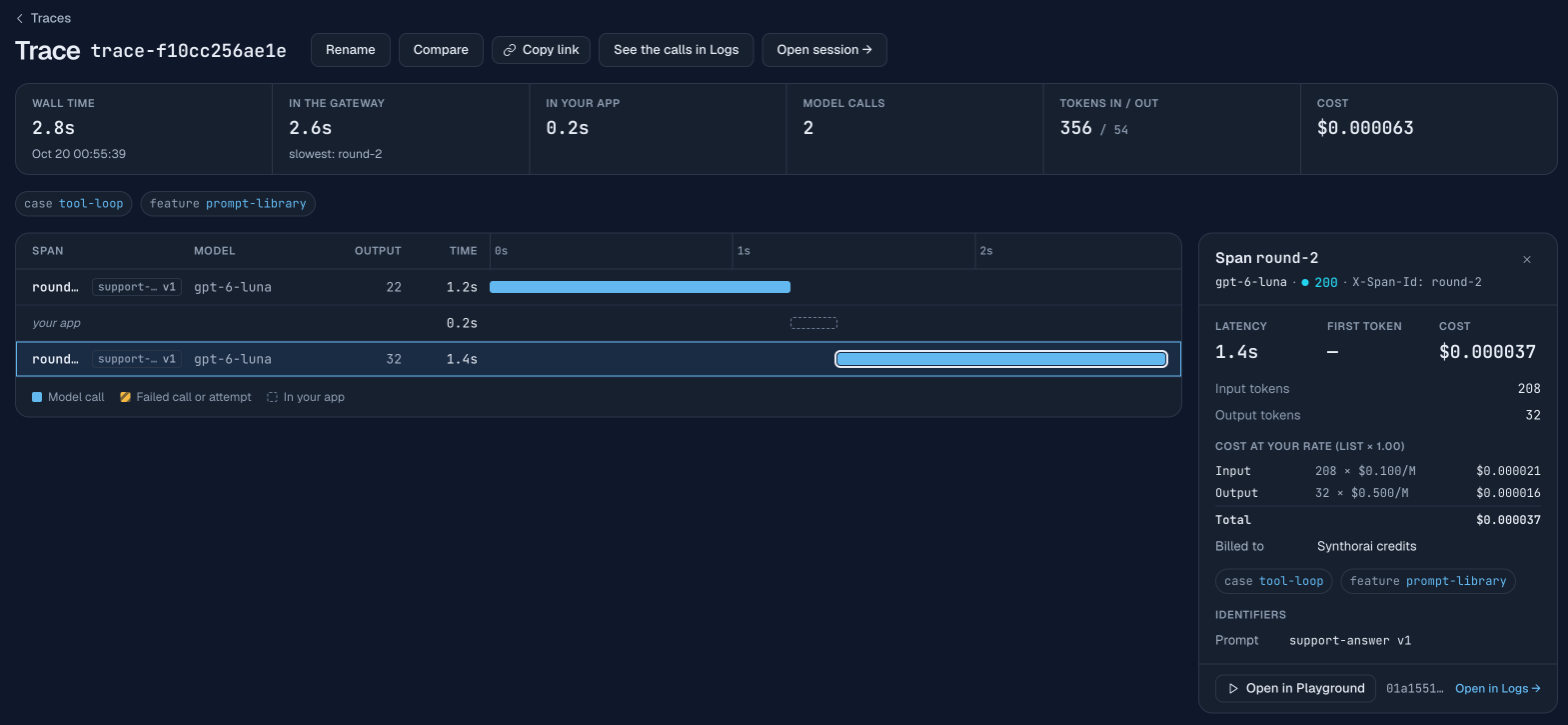
Chamadas de ferramentas e conversas com vários turnos funcionam como funcionariam sem um prompt da biblioteca. As mensagens da versão vêm primeiro, seguidas da conversa enviada pelo cliente. Na rodada 1 do ciclo de ferramentas da demonstração, o modelo pediu lookup_order({"order_id": "A-50977"}); a rodada 2 enviou a chamada de ferramenta do modelo e o resultado da ferramenta como mensagens comuns, usando o mesmo id, e a v1 respondeu com base no resultado.
Onde consultar qual versão respondeu a uma chamada?
Toda chamada é registrada com seu prompt e sua versão. Há três formas de consultar esses dados:
- Na resposta: o cabeçalho
X-Synthorai-Prompt-Version, que a demonstração grava junto de cada chamada nos resultados. - Em Logs: o filtro
prompt = support-answercomprompt_version = 3lista as chamadas dessa versão, e os detalhes de cada requisição mostram seu prompt e sua versão. OGET /api/v1/requestsaceita os mesmos filtrosprompt_ideprompt_version. - Em um trace: cada linha de chamada de modelo na visualização em cascata tem um selo “prompt vN”, e o painel da chamada lista o prompt e a versão. Os cabeçalhos de rastreamento de Rastreamento de um agente LLM funcionam sem alterações nas chamadas por id.
A página de prompts agrega chamadas, erros, gastos, tokens e latência por versão em períodos de 7, 30 ou 90 dias. É essa visualização que o guia de rollout usa para comparar duas versões com tráfego real.
O que ficou de fora?
- Rollouts e testes. O envio de uma parcela do tráfego de produção para uma versão candidata está em Teste A/B de uma mudança de prompt. Os testes de uma versão com um conjunto fixo de entradas estão em Teste um prompt antes de publicá-lo.
- Trechos reutilizáveis. Um bloco de texto armazenado uma única vez e incluído em vários prompts com
{{>id}}; cada versão salva fixa a versão do trecho que foi incluído. - Webhooks de mudança. Um POST assinado quando um prompt ganha uma versão ou um rótulo é movido, para sincronizar prompts com o git ou um canal de chat. O
webhook.pyda demonstração verifica a assinatura, mas não recebemos uma entrega real. - Idempotência na criação. O cabeçalho
Idempotency-Keypermite repetir uma requisição com segurança: por 24 horas, a API responde a uma chave repetida com a resposta original, em vez de criar o prompt duas vezes. Isso vale mesmo depois de excluir o prompt. Para recriar um prompt excluído, envie uma nova chave.
Perguntas frequentes
O que é versionamento de prompts?
Versionamento de prompts é manter cada prompt em versões numeradas que não mudam depois de salvas e escolher a versão usada em produção por meio de um rótulo, sem alterar o código. Para reverter, basta apontar o rótulo para a versão anterior.
Chamar um prompt por id acrescenta latência ou tokens?
Nos nossos 20 pares, não acrescentou nenhum dos dois: a mediana foi de 114.5 tokens de prompt nas duas formas, e a chamada por id não foi mais lenta. O gateway resolve a versão e envia uma requisição comum ao provedor.
Quanto tempo uma mudança de prompt leva para chegar à produção?
Cerca de 10 segundos. Nos nossos testes com chamadas contínuas, a primeira chamada respondida pela nova versão foi enviada 8.0 a 8.5 s (mediana) após a mudança do rótulo. Após uma pausa de 15 s no tráfego, a mudança foi imediata.
Posso continuar usando o SDK da OpenAI ou da Anthropic?
Os dois SDKs funcionam sem alterações: enviam os campos do prompt por extra_body, com qualquer nome de modelo e uma mensagem de usuário vazia para preencher os argumentos obrigatórios.
Leituras relacionadas
- Guia da biblioteca de prompts: todos os campos, erros e cabeçalhos de resposta desta página.
- Prompts no console: o editor, a comparação entre versões e o diálogo para mover rótulos.
- Teste A/B de uma mudança de prompt: um rollout de 10% e a comparação por versão.
- Teste um prompt antes de publicá-lo: conjuntos de teste, verificações e o que uma execução pode ou não mostrar.
- Rastreamento de um agente LLM: os cabeçalhos de sessão e trace que a demonstração continua enviando.