
Agente LLM lento? 3 causas identificadas em traces
Três causas de lentidão em um agente, reproduzidas e corrigidas: chamadas em série (3.7 s para 1.8 s), uma ferramenta lenta no seu código e raciocínio para respostas de uma frase.
Nossas escolhas
preços em tempo real| Modelo | Veredito | Preço |
|---|---|---|
| GPT-6 Luna Cinco respostas de uma frase levaram uma mediana de 25.6 s com o esforço de raciocínio padrão e 10.2 s com reasoning_effort definido como none, com os tokens de saída reduzidos de 1,150 para 190. | Agente principal na demonstração | desde $0.1/M |
| DeepSeek V4.1 Flash Três verificações de uma frase levaram uma mediana de 3.7 s quando enviadas uma após a outra e 1.8 s quando enviadas juntas, para os mesmos 127 tokens de entrada. | Subagente na demonstração | desde $0.3/M |
Conteúdo
- Por onde começar quando uma execução do agente está lenta?
- Como aparecem chamadas que poderiam rodar em paralelo, mas rodam em série?
- Como identificar que a lentidão está no próprio código?
- E se uma chamada ao modelo for a parte lenta?
- O que esta página não aborda?
- Perguntas frequentes
- Como encontro a etapa mais lenta de um agente LLM?
- Chamadas LLM em paralelo custam mais que chamadas em série?
- Por que uma chamada ao modelo é lenta se a resposta é curta?
- Como medir se uma correção deixou meu agente mais rápido?
- O gateway consegue mostrar o que meu código fez entre duas chamadas ao modelo?
- Leituras relacionadas
Um agente lento costuma ter um de três problemas: chamadas ao modelo que esperam umas pelas outras sem necessidade, lentidão no próprio código entre as chamadas ou uma chamada que faz mais trabalho do que a etapa exige. Um trace permite identificar a causa em poucos segundos: ele coloca cada chamada em uma linha do tempo e mostra os intervalos entre elas. Neste guia, reproduzimos cada problema em um pequeno agente de suporte, aplicamos a correção e comparamos as execuções antes e depois no console da Synthorai.
TL;DR
- Enviar três chamadas independentes ao modelo em paralelo com
asyncio.gatherreduziu a mediana de 3.7 s para 1.8 s, com o mesmo custo. - Executar em paralelo quatro consultas simuladas ao banco de dados, de 1.1 s cada, reduziu o tempo no código do agente de 4.6 s para 1.3 s. Trocar o modelo não afeta essa parte.
- Desativar o raciocínio (
reasoning_effort="none") em cinco respostas de uma frase no GPT-6 Luna reduziu o tempo de 25.6 s para 10.2 s e os tokens de saída de 1,150 para 190.
Este guia dá continuidade a Como rastrear um agente LLM, que apresenta os três headers de requisição usados para reunir as chamadas ao modelo em um trace. Prepare a demonstração conforme aquele guia (Python 3.10 ou posterior, com o virtualenv ativo) e execute os três casos no mesmo diretório de github.com/synthorai-io/use-cases:
cd use-cases/agent-tracing
python incidents.py serial-checks slow-tool reasoning
Cada caso roda duas vezes, primeiro com o problema e depois com a correção. O script imprime uma linha por execução, com o ID do trace:
serial-checks
  before   3.5 s   3 calls     127 in (     0 cached)     60 out  $0.000110   trace-d2bb96ebcf04
  after    1.5 s   3 calls     127 in (     0 cached)     62 out  $0.000112   trace-5f1e76a2de87
A latência do modelo varia entre chamadas, por isso executamos cada caso cinco vezes em 11 de outubro de 2026. A tabela mostra a mediana, com a execução mais rápida e a mais lenta entre parênteses. Uma execução corrigida do terceiro caso falhou, então essa mediana considera quatro execuções. A saída de exemplo acima e os pares nas capturas de tela vêm de uma execução adicional de cada caso, fora das cinco medições. Os tempos são o tempo total decorrido do início ao fim, medido pelo script.
| Caso | O que o trace mostra | Correção | Antes | Depois |
|---|---|---|---|---|
serial-checks | barras em escada, sem sobreposição | enviar chamadas independentes em paralelo | 3.7 s (3.5 a 4.5) | 1.8 s (1.7 a 2.0) |
slow-tool | uma linha your app longa | corrigir o próprio código | 11.0 s (9.5 a 12.2) | 9.2 s (6.7 a 11.0) |
reasoning | contagem de saída muito maior que a resposta | reduzir o esforço de raciocínio | 25.6 s para cinco respostas (19.0 a 31.8) | 10.2 s (7.9 a 12.1) |
Por onde começar quando uma execução do agente está lenta?
Comece pelo resumo no topo do trace. Ele divide o tempo total entre o gateway e a aplicação. O tempo total é quanto o usuário esperou. “No gateway” é o período em que pelo menos uma requisição ao modelo estava aberta. “Na aplicação” é o restante: os intervalos entre requisições, quando só o seu código estava rodando. Essa parcela também inclui o tempo de rede entre o código e o gateway, alguns décimos de segundo por chamada nas execuções desta página.
Essa divisão indica onde investigar:
- Maior parte no gateway, barras em escada: as chamadas estão esperando umas pelas outras. Veja o primeiro caso.
- Parcela grande na aplicação: o problema não está no modelo. Veja o segundo caso.
- Maior parte no gateway, uma barra longa: uma chamada domina o tempo. O resumo a identifica como “mais lenta”. Veja o terceiro caso.
Para ver o efeito de uma mudança, abra o trace anterior, selecione Comparar e escolha o trace posterior. O console mostra as duas execuções na mesma página: cada métrica com A, B e a diferença, cada chamada pareada com a de mesmo nome e os dois diagramas de cascata na mesma linha do tempo. Todas as imagens desta página usam essa visualização.
Como aparecem chamadas que poderiam rodar em paralelo, mas rodam em série?
O diagrama de cascata forma uma escada: cada barra começa onde a anterior termina. O agente da demonstração faz três verificações de uma frase sobre uma mensagem do cliente (sentimento, política e risco) no DeepSeek V4.1 Flash. Nenhuma depende do resultado das outras, mas a versão com o problema espera cada uma dentro de um loop:
for span, question in CHECKS.items():        # each call waits for the one before it
    await check(run, span, question)
A correção cabe em uma linha:
await asyncio.gather(*(check(run, span, q) for span, q in CHECKS.items()))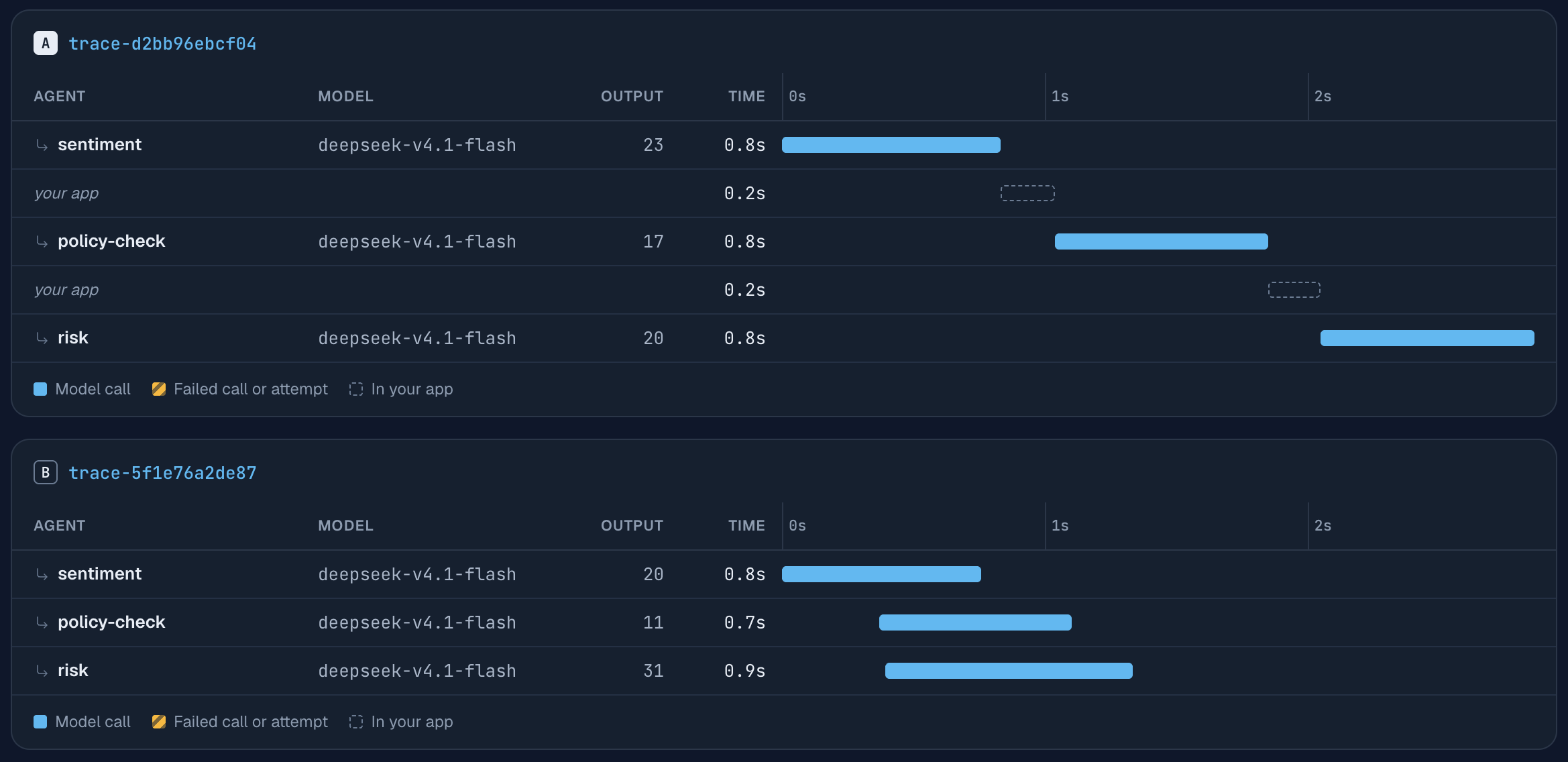
No trace A, o tempo total é 2.9 s: as três chamadas levam 0.8 s cada, uma após a outra, com intervalos de 0.2 s entre elas. No trace B, as barras se sobrepõem e o tempo total é 1.3 s. A tabela de comparação na mesma página do console, acima do trecho exibido aqui, mostra a redução de 2.9 s para 1.3 s, ou 53.4% (calculada com os tempos sem arredondamento). O script mediu 3.5 s e 1.5 s para esse mesmo par, pois também contabiliza a abertura de conexões e o tempo de rede de cada chamada.
A entrada é a mesma nas duas execuções: 127 tokens. O custo acompanha a saída, cujo tamanho varia um pouco entre execuções. Esse par custou $0.000110 e $0.000112; nas cinco execuções, a mediana foi $0.000105 para a versão em série e $0.000109 para a versão em paralelo. Chamadas em paralelo enviam e recebem os mesmos tokens, portanto não custam mais.
No seu agente, examine cada par de barras consecutivas e verifique se a segunda chamada usou a saída da primeira. Se não usou, elas podem se sobrepor. Chamadas que dependem umas das outras (um plano seguido da etapa planejada, por exemplo) precisam continuar em sequência.
Como identificar que a lentidão está no próprio código?
A linha your app fica longa. A versão com o problema responde a uma pergunta depois de buscar o cliente em quatro tabelas, uma consulta por vez. Cada consulta usa um sleep de 1.1 s para simular uma chamada ao banco de dados:
rows = [await lookup(t) for t in tables] # four queries, one at a timeExecutar as quatro consultas em paralelo também exige apenas uma linha:
rows = await asyncio.gather(*(lookup(t) for t in tables))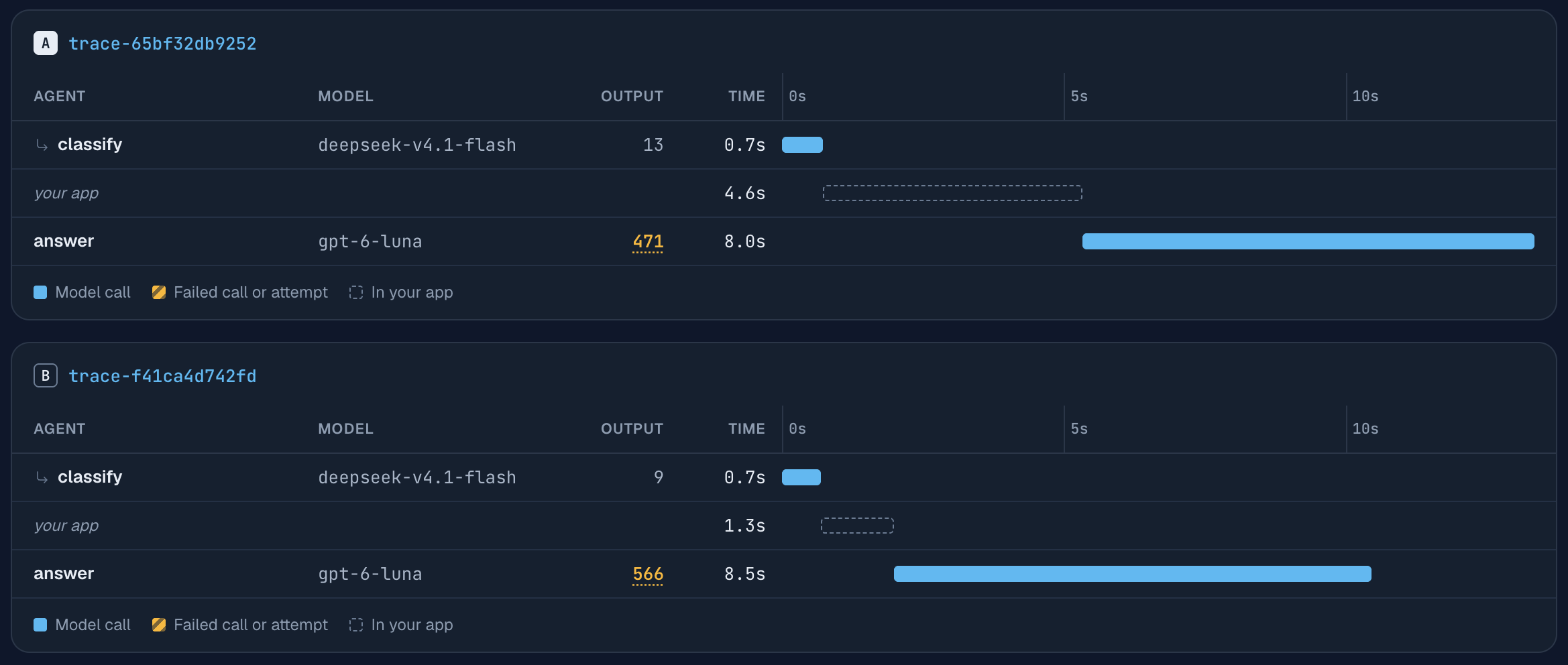
A linha corrigida caiu de 4.6 s para 1.3 s. A tabela de comparação mostra uma redução de 71.8% em “Na aplicação”, também calculada com os tempos sem arredondamento. Nenhuma mudança de modelo ou prompt afetaria essa parte: não havia requisição ao modelo aberta, e o agente esperava suas próprias consultas.
Os totais não mostram uma redução tão direta. Nesse par, o tempo total caiu de 13.3 s para 10.5 s, uma economia de 2.8 s com uma correção que poupou 3.3 s. O meio segundo restante está na chamada answer ao GPT-6 Luna: ela gerou 471 tokens de saída na primeira execução e 566 na segunda, levando 8.0 s e 8.5 s. Nas cinco execuções da tabela, as faixas das duas versões se sobrepuseram: as corrigidas levaram de 6.7 a 11.0 s, e as versões com o problema, de 9.5 a 12.2 s. Assim, uma execução corrigida pode ser mais lenta que uma execução sem a correção.
Por isso, compare a linha que você alterou, não o total de uma única execução. A tabela por chamada na visualização de comparação faz isso: alinha cada chamada com sua correspondente e mostra tempo, saída e custo como A e B. Para afirmar que houve uma melhora de ponta a ponta, compare a duração de vários traces de cada versão. A latência p95 em Logs (o tempo em que 95% das requisições terminam) não mostra essa correção. Ela mede requisições individuais, e o tempo economizado aqui estava entre as requisições.
O gateway não vê o que seu código fez durante o intervalo, apenas quanto ele durou. Se o intervalo for grande e você não souber a causa, adicione spans às suas funções com OpenTelemetry.
E se uma chamada ao modelo for a parte lenta?
Veja quantos tokens essa chamada gerou, porque a geração da saída consome tempo. Um modelo de raciocínio pensa antes de responder. Esse raciocínio entra na cobrança e no tempo como tokens de saída, mesmo quando a resposta visível tem uma só frase. A versão com o problema faz cinco perguntas curtas sobre políticas ao GPT-6 Luna, com a instrução “Responda em uma frase”, e mantém o esforço de raciocínio padrão. A versão corrigida acrescenta um parâmetro:
await call(run, "answer", model=PLANNER_MODEL, messages=messages, reasoning_effort="none")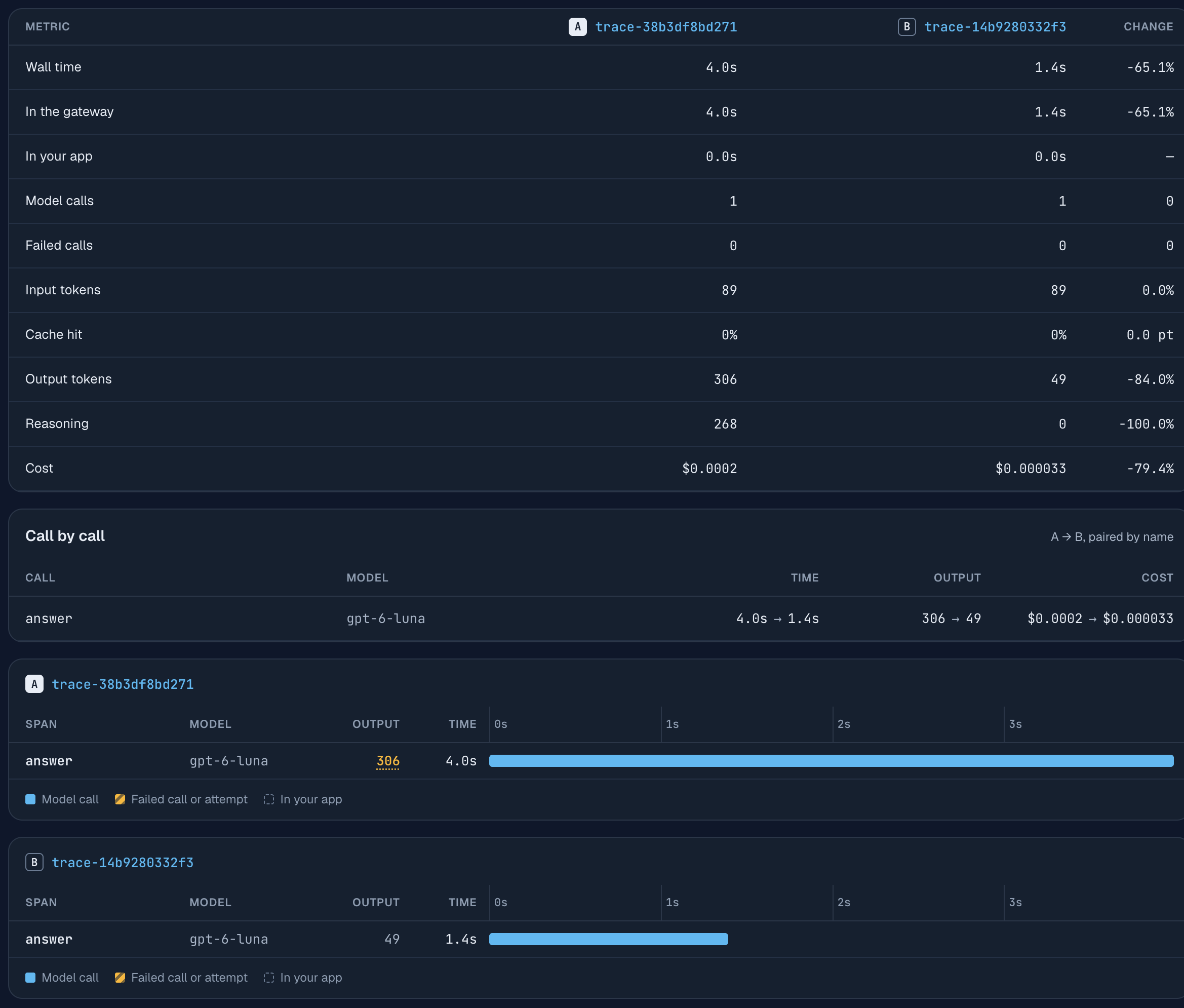
Essa é a primeira das cinco perguntas, antes e depois da correção. A resposta tem uma frase nos dois casos. Com o esforço padrão, o modelo gerou 306 tokens de saída, dos quais 268 eram de raciocínio, e levou 4.0 s. Com o raciocínio desativado, gerou 49 e levou 1.4 s. O custo da chamada caiu de $0.00016, arredondado no console para $0.0002, para $0.000033.
| Cinco respostas de uma frase (mediana de cinco execuções, quatro na segunda linha) | Tempo | Tokens de saída | Custo |
|---|---|---|---|
| esforço de raciocínio padrão | 25.6 s | 1,150 | $0.000614 |
reasoning_effort="none" | 10.2 s | 190 | $0.000134 |
Você não precisa da comparação para identificar isso. O diagrama de cascata tem uma coluna de Saída e sublinha a contagem quando uma saída grande é composta principalmente de raciocínio, como nos 306 tokens acima. Ao selecionar a chamada, o painel mostra os tokens de raciocínio em uma linha separada, abaixo dos tokens de saída.
Desativar o raciocínio faz sentido em etapas como essas: consultas, classificação e reformulação do resultado de uma ferramenta. Não faz sentido em etapas que exigem vários passos de raciocínio, algo que esta demonstração não testa. Nossas medições do GPT-6 Luna mostram os tokens de raciocínio e o custo por resposta em cada configuração, e o guia de esforço de raciocínio lista os valores aceitos por cada modelo. Ajuste por etapa e confira as respostas antes e depois.
O que esta página não aborda?
Ficam de fora dois pontos. O primeiro é a percepção de rapidez da resposta. Streaming não reduz a duração da chamada, mas permite que o usuário veja o texto mais cedo. Em uma resposta de chat, isso muitas vezes é o que importa. O painel da chamada tem um campo Primeiro token para medir isso. Ele está vazio nestes traces porque a demonstração não usa streaming.
O segundo são causas externas ao agente: um provedor lento naquele horário ou um limite de requisições que faz o cliente esperar e tentar novamente. Elas aparecem como uma barra longa ou uma chamada que falha seguida de uma nova tentativa. Nenhuma mudança na estrutura do seu código resolve essas causas.
Perguntas frequentes
Como encontro a etapa mais lenta de um agente LLM?
Abra o trace da execução e leia o resumo: ele identifica a chamada mais lenta e divide o tempo total entre o gateway e a aplicação. O diagrama de cascata abaixo mostra cada chamada como uma barra. Investigue a barra mais longa ou a linha your app mais longa.
Chamadas LLM em paralelo custam mais que chamadas em série?
Não. Na demonstração, as três verificações custaram uma mediana de $0.000105 em série e $0.000109 em paralelo, com os mesmos 127 tokens de entrada. A diferença vem da variação no tamanho da saída entre execuções. O custo depende dos tokens, e chamadas em paralelo enviam e recebem os mesmos tokens. Fique atento ao limite de requisições, já que as chamadas paralelas chegam ao mesmo tempo.
Por que uma chamada ao modelo é lenta se a resposta é curta?
A causa mais comum é o modelo ter raciocinado antes de responder. O raciocínio é gerado como tokens de saída que não aparecem na resposta. Cinco respostas de uma frase no GPT-6 Luna usaram uma mediana de 1,150 tokens de saída com o esforço de raciocínio padrão e 190 com reasoning_effort="none".
Como medir se uma correção deixou meu agente mais rápido?
Compare a parte que você alterou, não um único tempo total. Na demonstração, executar quatro consultas em paralelo reduziu o tempo no próprio código de 4.6 s para 1.3 s. Mesmo assim, o tempo total das execuções após a correção variou de 6.7 s a 11.0 s por causa da variação de uma chamada ao modelo. Compare várias execuções de cada versão pela duração dos traces.
O gateway consegue mostrar o que meu código fez entre duas chamadas ao modelo?
Ele mostra a duração do intervalo como uma linha your app, mas não o que aconteceu ali. Para criar spans dentro do seu código, use um SDK do OpenTelemetry e encaminhe o header traceparent, para que as duas visualizações compartilhem o mesmo ID de trace.
Leituras relacionadas
- Como rastrear um agente LLM: os headers e o diagrama de cascata analisados nesta página.
- Por que meu agente LLM custa tanto?: o mesmo método aplicado à conta.
- Como depurar um agente LLM: da reclamação do usuário à chamada que deu errado.
- Custo do Claude Code por subagente: as mesmas visualizações para um agente de programação que você não escreveu.
- Pergunte ao Claude sobre seus logs de LLM: perguntas sobre o log de requisições, respondidas via MCP.
- Dê ao seu agente ferramentas de consulta aos logs: o mesmo log lido por um programa seu e o custo dos tokens do modelo.
- GPT-6 Luna vs GPT-5.6 Luna: tokens de raciocínio e custo por resposta em cada nível de esforço.