
Depure um agente LLM: 3 falhas no trace, uma com status 200
Localize a execução de um agente por rótulo de usuário e analise três falhas no trace: 404 com retry, respostas truncadas com status 200 e 400 no segundo turno.
Nossas escolhas
preços em tempo real| Modelo | Veredito | Preço |
|---|---|---|
| GPT-6 Luna Rejeitou o segundo turno de uma conversa com um 400 em 0.5 s, sem cobrança, quando o histórico salvo havia perdido uma chamada de ferramenta. | Agente principal na demonstração | desde $0.1/M |
| DeepSeek V4.1 Flash Com max_tokens em 40, três chamadas seguidas retornaram status 200 e exatamente 40 tokens de saída, sem nenhuma resposta utilizável. Com o limite aumentado e o raciocínio desativado, uma chamada respondeu em 49 tokens. | Subagente na demonstração | desde $0.3/M |
Conteúdo
- Como encontrar a execução de um usuário?
- Como aparece uma chamada que falhou e teve retry?
- Por que o agente não retornou nada se todas as chamadas tiveram sucesso?
- Por que o segundo turno falha se o primeiro funcionou?
- O que todo agente deve registrar para permitir essa análise?
- Perguntas frequentes
- Como depurar um agente LLM em produção?
- Por que meu LLM retorna uma resposta vazia com status 200?
- O que causa “No tool call found for function call output”?
- Devo repetir uma chamada LLM que falhou?
- Leituras relacionadas
“O assistente me deu uma resposta inútil ontem à tarde.” É assim que a maioria dos bugs de agentes chega: um usuário, um horário aproximado, nenhum ID de requisição. Para localizar a execução, você precisa de um rótulo nas requisições. Para entender o que aconteceu, precisa de um trace: a falha costuma estar em uma chamada entre várias e muitas vezes nem parece um erro. Este guia parte da reclamação até chegar à chamada que deu errado. Depois, reproduz três falhas em um pequeno agente de suporte e mostra como cada uma aparece no console da Synthorai.
TL;DR
- Com um rótulo
_userem cada requisição, uma única busca na lista Traces encontra as execuções do agente daquele usuário. - Uma chamada que falhou e seu retry aparecem lado a lado quando o retry mantém o ID do trace. O 404 da demonstração custou 95 ms e $0.
- Com
max_tokens=40em um modelo de raciocínio, três chamadas retornaram status 200 com 40 tokens de saída e nenhuma resposta. - Um histórico salvo sem uma chamada de ferramenta fez o segundo turno falhar com um 400, sem cobrança.
Este guia dá continuidade a Rastreie um agente LLM, que explica os cabeçalhos de requisição usados aqui. Configure a demonstração conforme esse guia (Python 3.10 ou posterior, com o virtualenv ativo) e execute os comandos abaixo no mesmo diretório de github.com/synthorai-io/use-cases:
cd use-cases/agent-tracing
python run.py --fail                    # a failed call with a retry
python incidents.py cut-off bad-history
Os números desta página vêm de uma execução de cada caso em 11 de outubro de 2026.
| O que aparece no trace | O que significa | Caso |
|---|---|---|
| uma marca hachurada com um código de status, seguida de uma chamada semelhante | uma chamada falhou e foi repetida | run.py --fail |
| o mesmo span várias vezes, todos com 200, e a coluna Output igual ao limite configurado | as respostas são truncadas antes de ficarem utilizáveis | cut-off |
| um 400 no segundo turno de uma sessão, 0 tokens, $0 | a requisição montada pelo seu código é inválida | bad-history |
Como encontrar a execução de um usuário?
Use o rótulo enviado junto com ela. Se todas as requisições incluírem X-Synthorai-Metadata com a chave _user, basta um filtro para encontrar as requisições do usuário:
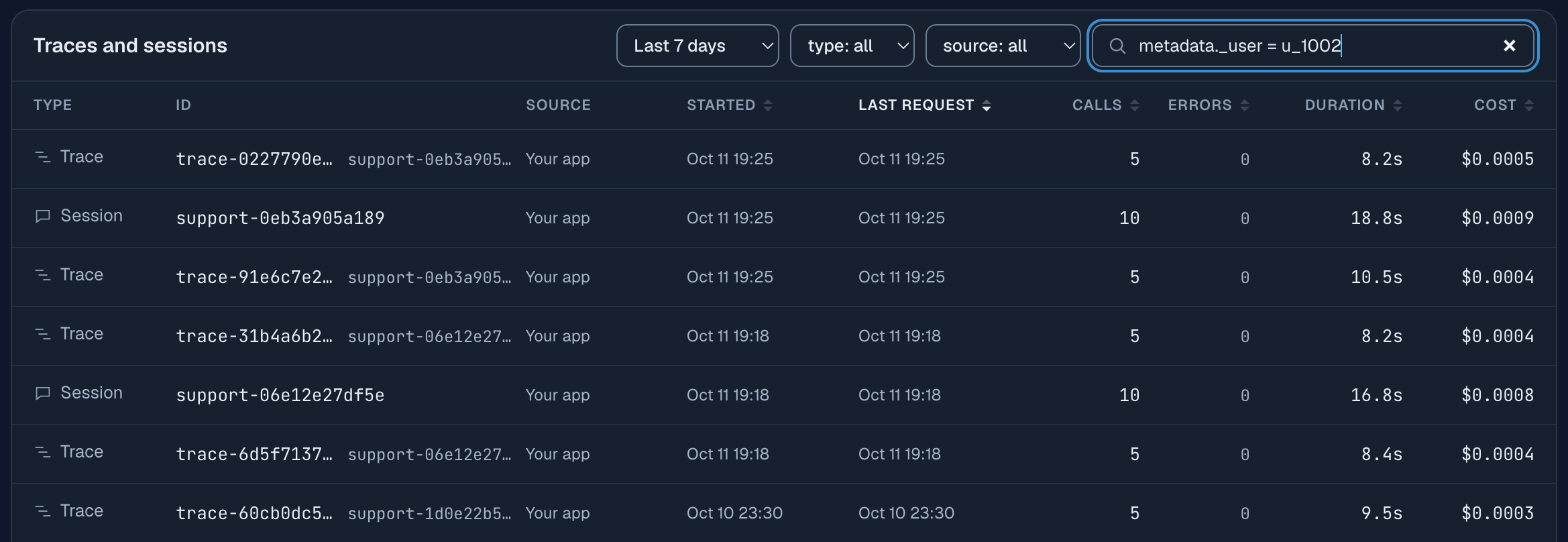
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}- Abra Traces, digite
metadata._user = u_1002na caixa de busca e pressione Enter. Ajuste o intervalo de tempo para incluir o horário da reclamação. - Examine a lista. Ela agora contém apenas as sessões desse usuário e seus traces, com chamadas, erros, duração e custo. As colunas Calls, Errors, Duration e Cost permitem ordenação. Comece pelos traces com erro ou com muito mais chamadas que os demais.
- Abra o trace. Ele mostra a execução inteira. “Open session” mostra a conversa em torno dela, e “See the calls in Logs” lista as requisições individuais.
Para buscar requisições individuais em vez de execuções, a caixa de filtro em Logs aceita o mesmo rótulo, além de status (error, success, 4xx, 5xx ou um código), latency, cost, model, session e trace.
Sem rótulos, a busca começa pelo que você tiver: um ID de trace dos seus próprios logs vai na caixa de busca de Traces; um ID de requisição obtido de um cabeçalho de resposta vai no filtro de Logs como request_id. Por isso, registre o cabeçalho de resposta x-request-id junto com seus IDs de usuário e de conversa.
Use um ID interno de usuário em _user, não um endereço de e-mail nem um nome. Os rótulos ficam armazenados junto com a requisição.
Como aparece uma chamada que falhou e teve retry?
Ela aparece como uma marca hachurada com o código de status, ao lado da chamada que a substituiu. No guia de rastreamento, uma das três verificações paralelas solicita um ID de modelo que não existe. O trace mostra policy-check como uma marca de 95 ms com o rótulo 404 e policy-check.retry como uma barra normal ao lado. O resumo do trace informa “6 model calls, 1 failed”, e a página da sessão lista “1 × 404 Not found”. A chamada que falhou custou $0.
Duas escolhas no seu código tornam isso fácil de interpretar. O retry mantém o ID do trace, então a falha e a nova tentativa aparecem na mesma visualização. Além disso, o retry tem seu próprio nome de span, permitindo distinguir as tentativas. Um retry que inicia outro trace parece duas execuções sem relação, uma delas com uma falha sem explicação visível.
Uma falha no trace nem sempre é um problema. Esta execução se recuperou, e o cliente recebeu uma resposta. O trace mostra quanto a falha custou: neste caso, 95 ms e nada na fatura. Essa informação permite decidir se o retry resolve ou se a causa precisa ser corrigida.
Por que o agente não retornou nada se todas as chamadas tiveram sucesso?
O agente não retornou nada porque o status 200 só indica que a requisição foi concluída. Neste caso, o subagente que usa DeepSeek V4.1 Flash recebe a tarefa de identificar quais tópicos de políticas uma mensagem aborda, com max_tokens=40 ainda configurado desde um prompt anterior, mais simples. Ao contrário das outras chamadas de subagentes da demonstração, a versão com o problema mantém o raciocínio no padrão do modelo (think no trecho de código). O modelo raciocina antes de responder, consome os 40 tokens nessa etapa e retorna uma resposta vazia com finish_reason definido como length. O código detecta a resposta vazia e tenta novamente, até completar três tentativas:
for attempt in range(1, 4):
    resp = await check(run, f"policy-check-{attempt}", prompt, think=variant == "before", max_tokens=limit)
    choice = resp.choices[0]
    if choice.finish_reason != "length" and (choice.message.content or "").strip():
        break                                    # a usable reply; otherwise try again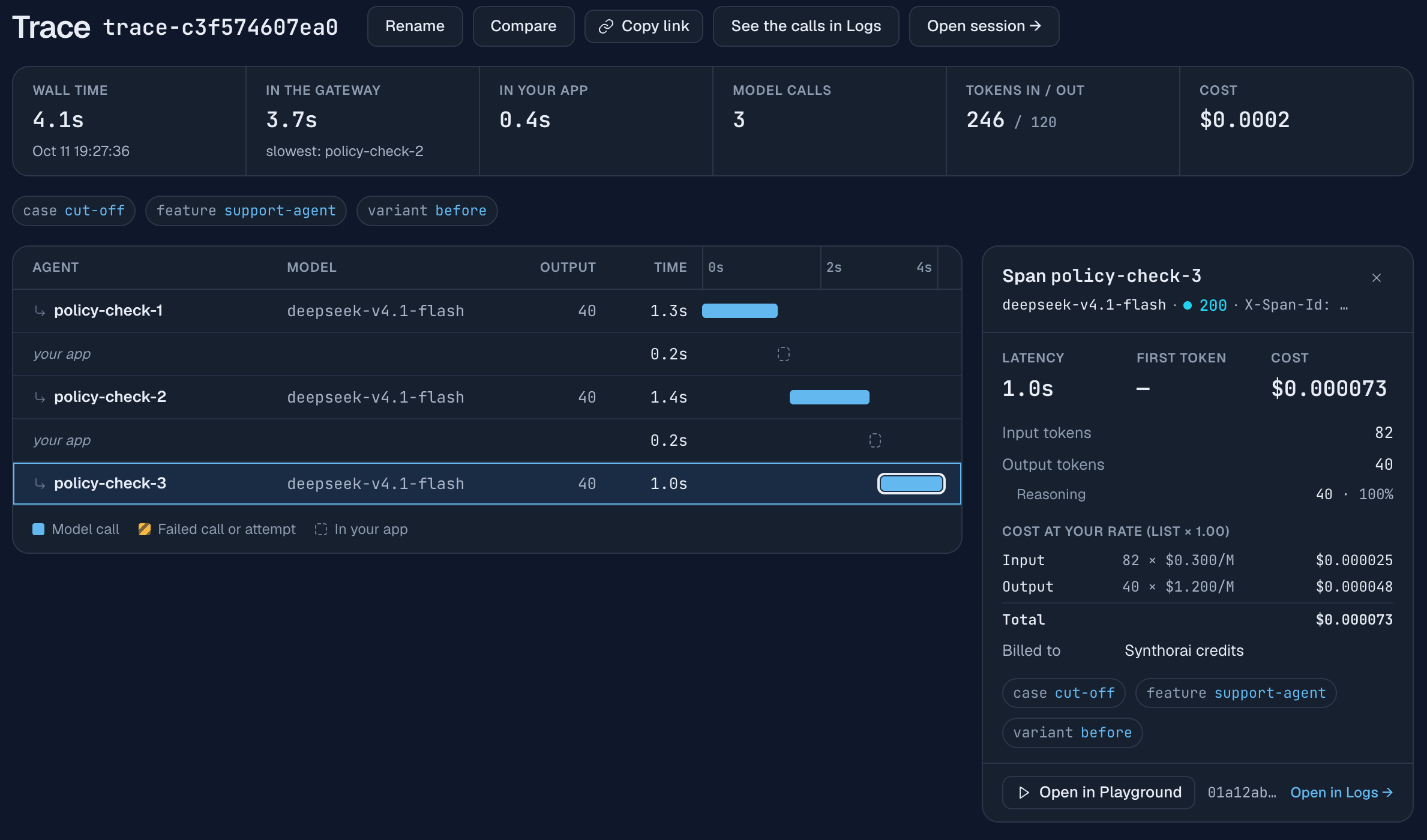
Nada no gráfico de cascata está marcado como falha. Os indícios são o span repetido e a coluna Output: 40, 40 e 40, exatamente o limite. Selecionar uma chamada abre o painel à direita, que confirma: status 200, 40 tokens de saída e, na linha abaixo, “Reasoning 40 · 100%”.
Uma contagem de saída igual ao limite configurado é o sinal de uma resposta truncada. A versão corrigida aumenta o limite para 2,000 e desativa o raciocínio nessa verificação, que não precisa dele. Uma única chamada passa a responder com 49 tokens de saída, e o trace fica com uma barra onde antes havia três. Aumentar apenas o limite também eliminou os retries, mas essa chamada consumiu 1,876 tokens de saída em raciocínio e levou 22 s.
No seu agente:
- Verifique
finish_reasonem todas as chamadas.lengthindica que a resposta foi truncada. Registre isso como falha nos seus logs, mesmo com status 200. - Dimensione
max_tokenspara o raciocínio mais a resposta. Em um modelo de raciocínio, o limite cobre ambos. Um limite calculado apenas para a resposta visível pode não deixar espaço para ela. - Não repita uma chamada truncada com o mesmo limite. A segunda tentativa esbarra no mesmo teto. Aumente o limite, reduza o esforço de raciocínio ou faça ambos.
Por que o segundo turno falha se o primeiro funcionou?
A causa mais comum está no que seu código salvou entre os turnos. Uma requisição ao modelo leva a conversa inteira, então um bug ao armazenar ou reconstruir o histórico só aparece a partir do segundo turno. Neste caso, o primeiro turno usa mensagens mantidas em memória: GPT-6 Luna faz uma chamada de ferramenta, recebe o resultado e responde sem problemas. Depois, o código salva o turno. Ele armazena apenas o texto da mensagem do assistente, perdendo a chamada de ferramenta, e salva o resultado da ferramenta junto dela:
# What the app stores for the next turn.
saved = msg.model_dump(exclude_none=True)
if variant == "before":
    saved.pop("tool_calls", None)                # the bug: the assistant message is saved as text only
    saved["content"] = saved.get("content") or ""
history = [saved, *results, {"role": "assistant", "content": answer.choices[0].message.content or ""}]
Quando o cliente escreve novamente, o segundo turno é montado a partir desse histórico salvo. A requisição contém um resultado de ferramenta que responde a uma chamada ausente do histórico, e é rejeitada com este erro (“function call output” é o nome que o provedor usa para um resultado de ferramenta):
400 No tool call found for function call output with call_id call_Nqc1zUFvwLLuF5oGMEE9WheQ.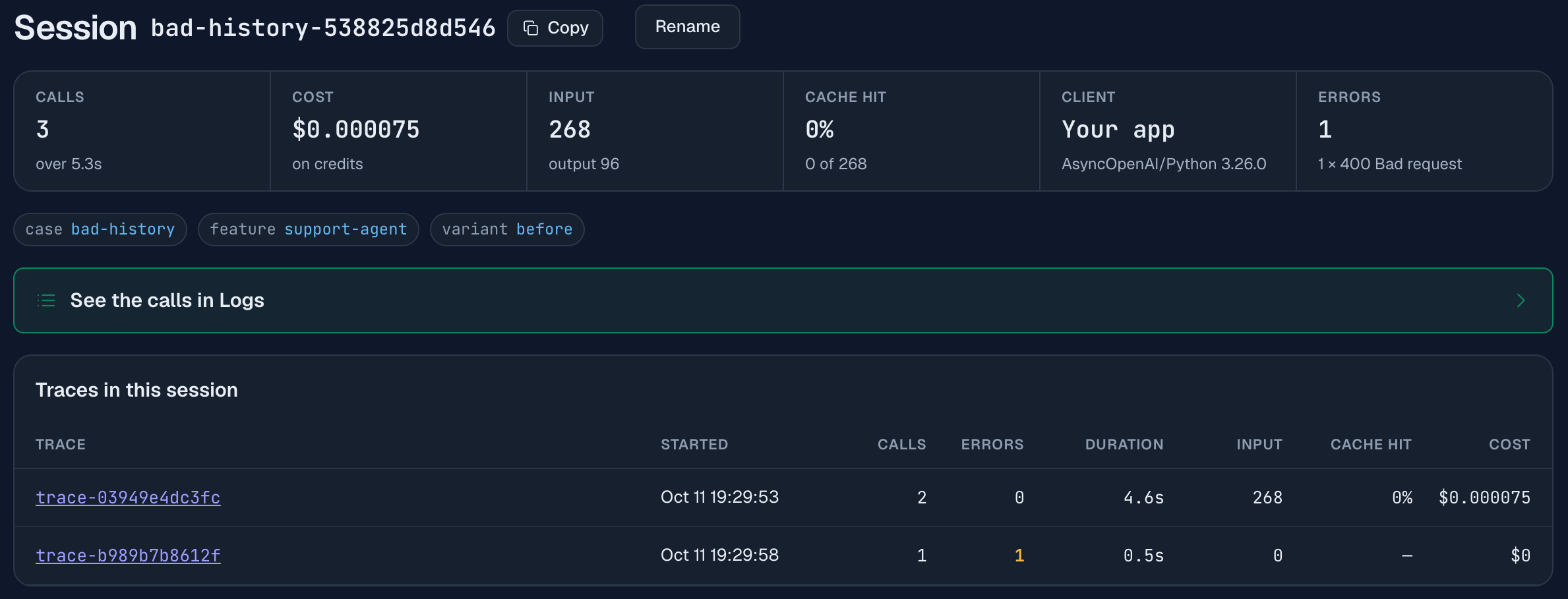
A página da sessão revela o padrão: dois traces, o primeiro com 2 chamadas e nenhum erro, o segundo com 1 chamada e 1 erro, e “1 × 400 Bad request” no cartão de erros. O trace que falhou mostra 0 tokens de entrada, duração de 0.5 s e custo de $0. Esses três valores juntos indicam que nenhum modelo chegou a executar: a requisição foi recusada por ser inválida. Isso distingue essa falha de um problema no modelo ou no provedor, em que você veria tokens, uma duração maior ou um status 5xx.
Um 400 é um bug na requisição, então repeti-la não resolve, e o texto do erro aponta o que corrigir. Com a mensagem do assistente salva por inteiro, o segundo turno funciona.
O mesmo padrão (primeiro turno funciona, um turno posterior é rejeitado) aparece em outros bugs de histórico: um resultado de ferramenta salvo sem o ID da chamada, mensagens armazenadas na ordem errada ou um corte no histórico entre uma chamada de ferramenta e seu resultado, preservando o resultado e removendo a chamada. Se você reduz o histórico para controlar custos, faça o corte entre turnos, nunca dentro de um turno.
O que todo agente deve registrar para permitir essa análise?
Registre cinco coisas:
- Um ID de trace por execução e um ID de sessão por conversa, enviados como
X-Trace-IdeX-Session-Ide registrados também nos seus próprios logs. - Um nome de span por chamada que identifique a etapa e a tentativa, como
plan-2oupolicy-check.retry. - Rótulos para o usuário, a funcionalidade e a versão, enviados como
X-Synthorai-Metadata. - O cabeçalho de resposta
x-request-idde cada chamada, junto dos seus próprios IDs. finish_reasone a contagem de tokens de saída de cada chamada, tratandolengthcomo falha.
Configure também um timeout no cliente e um valor de max_tokens em cada chamada, ambos com folga. Sem os dois, a chamada pode continuar enquanto o modelo estiver gerando texto, e seu código fica esperando. Mas um limite calculado apenas para a resposta visível causa o bug do segundo caso, e um timeout menor que uma geração longa interrompe chamadas que estavam funcionando: em um modelo de raciocínio, uma chamada pode levar minutos. A demonstração espera 300 s e limita cada chamada a 2,000 tokens de saída, salvo quando a chamada define seu próprio limite.
Perguntas frequentes
Como depurar um agente LLM em produção?
Primeiro, encontre a execução: filtre seu log de requisições por um rótulo de usuário ou conversa e abra o trace de uma requisição correspondente. O trace mostra, em ordem, todas as chamadas ao modelo daquela execução, com as falhas marcadas. Assim, você identifica a etapa que deu errado antes de ler qualquer código.
Por que meu LLM retorna uma resposta vazia com status 200?
A causa mais comum é atingir o limite de saída antes de o modelo escrever a resposta. Em um modelo de raciocínio, max_tokens cobre o raciocínio e a resposta. Verifique finish_reason: se for length e a contagem de tokens de saída for igual ao limite, a resposta foi truncada. Na demonstração, três chamadas seguidas retornaram 200 com exatamente 40 tokens de saída e nenhuma resposta utilizável.
O que causa “No tool call found for function call output”?
O histórico da conversa contém um resultado de ferramenta sem a chamada correspondente. Isso acontece quando a mensagem do assistente que fez a chamada é salva sem seus tool_calls, ou quando o histórico é cortado entre a chamada e o resultado. Salve a mensagem do assistente por inteiro e corte o histórico apenas entre turnos.
Devo repetir uma chamada LLM que falhou?
Depende do status. Um 429 (limite de requisições) ou um 5xx (erro de servidor) pode funcionar em uma nova tentativa. Um 400 indica um problema na requisição e falhará do mesmo jeito. Uma resposta truncada por max_tokens será truncada novamente se o limite não mudar. Ao fazer um retry, mantenha o ID do trace para que as duas tentativas apareçam no mesmo trace.
Leituras relacionadas
- Rastreie um agente LLM: os cabeçalhos, o gráfico de cascata e o exemplo de chamada com falha.
- Por que meu agente LLM está lento?: como analisar a latência no mesmo trace.
- Por que meu agente LLM custa tanto?: como analisar custos nas sessões.
- Custo do Claude Code por subagente: as mesmas visualizações para um agente de programação que você não escreveu.
- Pergunte ao Claude sobre seus logs de LLM: “alguma requisição deste usuário falhou?”, respondida via MCP.
- Dê ao seu agente ferramentas para consultar logs: os mesmos logs lidos por um programa seu e o custo dos tokens do modelo.
- Referência de cabeçalhos de requisição: IDs, rótulos e seus limites.