
GPT-4 e GPT-3.5 Turbo saem em 23/10: substituir 3.5 custa quase 5x
Conteúdo
A OpenAI desativa GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, GPT-4.1 nano, o1, o3-mini e o4-mini em 2026-10-23. Todos os modelos de texto indicados como substitutos são da linha GPT-5.6: a lista foi publicada cinco meses antes da chegada do GPT-6. Seguir essa lista aumenta a conta de quem usa GPT-3.5 Turbo em cerca de cinco vezes. Nos nossos testes, GPT-5.6 Terra, o substituto indicado, custou $0.75 por 1.000 chamadas curtas, contra cerca de $0.15 pelos preços do GPT-3.5 Turbo. GPT-6 Luna fez as mesmas chamadas por $0.037 e acertou todas.
TL;DR
- A desativação em 2026-10-23 inclui GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, GPT-4.1 nano, gpt-4o-2024-05-13, o1, o1-pro, o3-mini e o4-mini.
- GPT-5.6 Terra, indicado pela OpenAI para substituir GPT-3.5 Turbo, custa $2 / $12 por milhão de tokens, contra $0.50 / $1.50.
- Os cinco candidatos a substituto acertaram as 96 tarefas curtas.
- Custo por 1.000 chamadas: GPT-5.6 Sol $1.41, GPT-6.1 Sol $0.72, GPT-5.6 Terra $0.75, GPT-5.6 Luna $0.075, GPT-6 Luna $0.037.
Quais modelos da OpenAI saem em 23 de outubro e quais os substituem?
Nove famílias de modelos de texto deixam de responder em 2026-10-23. A página de descontinuações da OpenAI indica um modelo GPT-5.6 para cada uma. Cada linha inclui as versões datadas do modelo (como gpt-4-0613) e as versões com fine-tuning (cópias com treinamento personalizado). Os valores são preços de tabela por milhão de tokens, entrada / saída, publicados na página de preços e nas páginas dos modelos da OpenAI.
| Modelo desativado | Preço de tabela | Substituto indicado pela OpenAI | Preço de tabela |
|---|---|---|---|
| GPT-4 | $30 / $60 | GPT-5.6 Sol | $4 / $20 |
| GPT-4 Turbo | $10 / $30 | GPT-5.6 Sol | $4 / $20 |
| gpt-4o-2024-05-13 | $5 / $15 | GPT-5.6 Sol | $4 / $20 |
| o1 | $15 / $60 | GPT-5.6 Sol | $4 / $20 |
| o1-pro | $150 / $600 | GPT-5.6 Sol | $4 / $20 |
| o3-mini | $1.10 / $4.40 | GPT-5.6 Sol | $4 / $20 |
| GPT-4.1 nano | $0.10 / $0.40 | GPT-5.6 Luna | $0.20 / $1.20 |
| GPT-3.5 Turbo | $0.50 / $1.50 | GPT-5.6 Terra | $2 / $12 |
| o4-mini | $1.10 / $4.40 | GPT-5.6 Terra | $2 / $12 |
Na mesma data, saem gpt-image-1 (substituído por gpt-image-2.5-sunburst ou gpt-image-2.5-flare) e os modelos babbage-002 e davinci-002 com fine-tuning. GPT-4o e suas versões datadas mais recentes não estão nessa lista. Outras duas desativações já têm data: tts-1 e tts-1-hd em 2027-01-06; gpt-5.1, gpt-5.3-codex e gpt-5.4-nano em 2027-04-01.
A OpenAI anunciou esse grupo em 2026-04-22. O GPT-6 chegou em 2026-09-22, por isso não poderia constar da coluna de substitutos. Em quatro dos nove casos, o preço de tabela sobe: o3-mini, GPT-4.1 nano, GPT-3.5 Turbo e o4-mini.
O substituto indicado pela OpenAI é a opção mais barata?
Não. Em nenhuma linha o substituto indicado pela OpenAI é a opção mais barata: os modelos da geração GPT-6 custam cerca de metade dos GPT-5.6 e não aparecem na tabela. Sol, Terra e Luna são, respectivamente, as versões grande, intermediária e pequena. O preço de entrada em cache se aplica à parte do prompt que a OpenAI atende a partir do prompt cache.
| Entrada | Entrada em cache | Saída | |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $12.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $1.20 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
O preço de $4 / $20 do GPT-5.6 Sol é promocional e, segundo a OpenAI, vale pelo menos até 2026-11-21. A linha GPT-6 não tem Terra, e o GPT-5.6 Terra perde em preço para modelos dos dois lados: o GPT-6.1 Sol, de uma categoria acima, tem o mesmo preço de entrada e saída mais barata; o GPT-6 Luna custa um vigésimo do preço.
Como fizemos os testes?
A tabela de preços mostra quanto custa um token. Para planejar uma migração, faltam duas respostas: se o modelo mais barato resolve a mesma tarefa e se um modelo de raciocínio consome tokens adicionais para resolvê-la. Os cinco candidatos são modelos de raciocínio. reasoning.effort é o parâmetro da Responses API que controla quanto raciocínio oculto o modelo faz antes de responder. Esses tokens são cobrados como saída. Sem definir o parâmetro, a chamada usa o padrão do modelo (medium no GPT-6.1 Sol e no GPT-6 Luna); none desativa o raciocínio.
Rodamos 96 tarefas curtas, típicas de uso do GPT-3.5 Turbo e do GPT-4.1 nano. Cada tarefa tinha uma resposta correta, verificada por código:
- Classificação: 40 mensagens de suporte, 8 categorias e regras para mensagens que se encaixavam em duas categorias.
- Extração: 30 e-mails de pedidos convertidos em um objeto JSON com 6 campos, incluindo elementos para confundir a extração, como o ID de um pedido anterior e um subtotal.
- Chamadas de ferramentas: 26 solicitações de suporte que precisavam virar uma chamada de função com os argumentos corretos, entre 5 ferramentas.
Outros quatro pedidos de ferramenta não são pontuados. Fazem uma pergunta antes de indicar a alteração (“O pedido A-88643 ainda não foi enviado, certo? O novo endereço de entrega fica em Graz”), e 18 das 56 respostas consultaram o pedido antes de alterar o endereço: 9 de 12 no GPT-6 Luna, 4 de 12 no GPT-5.6 Luna, 3 de 12 no GPT-5.6 Terra e 1 em cada um dos dois modelos Sol. As duas leituras são defensáveis, por isso estes quatro testam mais a formulação do que o modelo.
Rodamos as tarefas em cada modelo com o raciocínio desativado, em low e no nível padrão (GPT-6.1 Sol apenas em low e no padrão, pois não aceita none): 1.344 chamadas. Cada uma recebeu uma string aleatória exclusiva para impedir o uso do cache. Calculamos o custo pelos preços de tabela da OpenAI. Não conseguimos chamar os modelos em desativação, então o custo deles é uma estimativa: aplicamos os preços de tabela de cada modelo à quantidade de tokens que medimos (234 de entrada e 24 de saída por chamada). Os tokenizadores, que dividem o texto em tokens, variam entre gerações. Portanto, esses valores são aproximados.
Quanto custa cada substituto por 1.000 chamadas?
Nas tarefas curtas, a escolha depende do preço: a precisão não diferenciou os modelos. Os cinco acertaram 96 de 96 tarefas em todas as configurações. A tabela mostra o custo por 1.000 chamadas com o raciocínio desativado (low no GPT-6.1 Sol).
| Modelo em uso | Custo estimado hoje | Substituto indicado pela OpenAI | Opção GPT-6 |
|---|---|---|---|
| GPT-4 | $8.48 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| GPT-4 Turbo | $3.07 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| gpt-4o-2024-05-13 | $1.53 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| GPT-3.5 Turbo | $0.15 | GPT-5.6 Terra, $0.75 | GPT-6 Luna, $0.037 |
| GPT-4.1 nano | $0.033 | GPT-5.6 Luna, $0.075 | GPT-6 Luna, $0.037 |
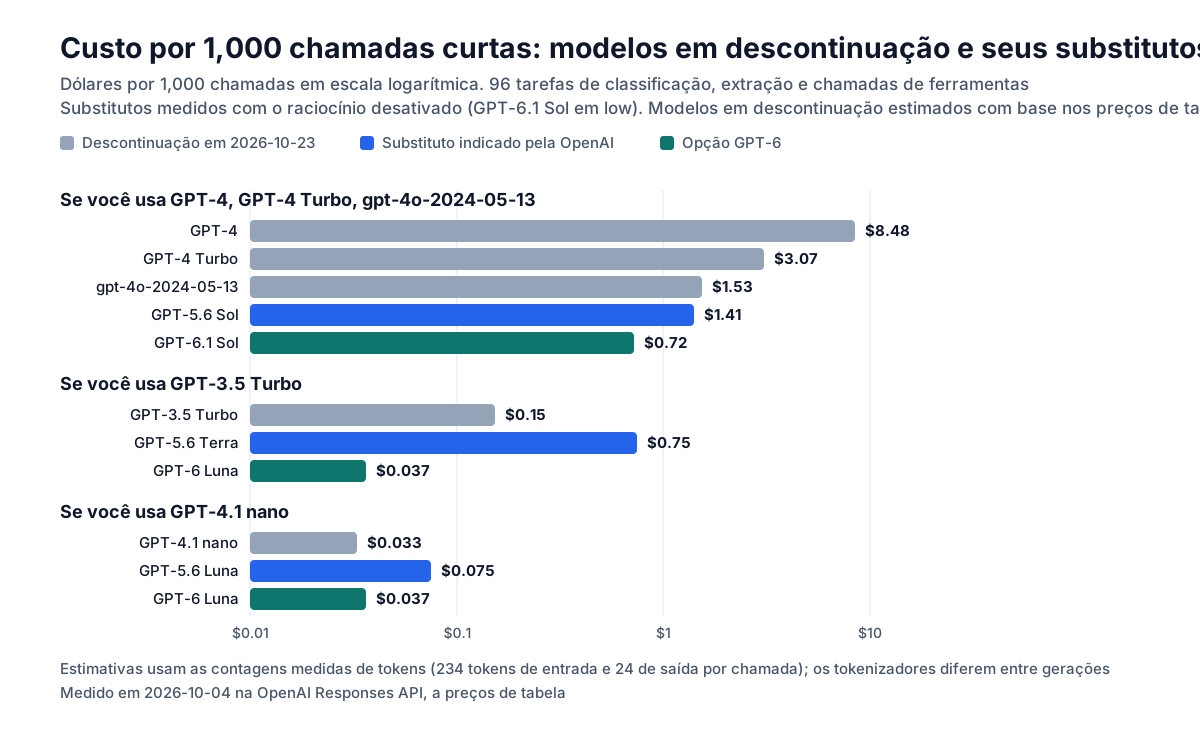
Para GPT-4 e GPT-4 Turbo, qualquer troca reduz o custo. Para gpt-4o-2024-05-13, GPT-5.6 Sol custa praticamente o mesmo e GPT-6.1 Sol, metade. Para GPT-3.5 Turbo, o substituto indicado custa 4,9 vezes mais; GPT-6 Luna custa um quarto. Para GPT-4.1 nano, o substituto indicado custa 2,3 vezes mais; GPT-6 Luna custa aproximadamente o mesmo.
Os modelos da série o não entram nessa tabela. o1, o3-mini e o4-mini consomem tokens de raciocínio que não conseguimos medir, então, para eles, só valem os preços de tabela da primeira tabela. Para cargas de trabalho que exigem raciocínio, nossas medições do GPT-6.1 Sol cobrem 13 tarefas em cada nível de esforço.
O nível padrão de raciocínio aumenta a conta?
O nível padrão aumenta um pouco a conta nos modelos Sol e mais nos modelos baratos. Deixar reasoning.effort no padrão elevou o custo dessas chamadas em 5% no GPT-5.6 Sol e no GPT-6.1 Sol, 22% no GPT-5.6 Terra, 34% no GPT-6 Luna e 42% no GPT-5.6 Luna, sem mudar a precisão. O raciocínio consumiu pouco, no máximo 25 tokens por chamada. Mas, quando a resposta tem apenas 24 tokens, isso dobra a quantidade de tokens de saída.
from openai import OpenAI

client = OpenAI()
resp = client.responses.create(
    model="gpt-6-luna",
    reasoning={"effort": "none"},  # no hidden reasoning; use "low" on gpt-6.1-sol
    max_output_tokens=64,
    input="Classify the customer message into exactly one label: ...",
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
Um limite baixo de tokens de saída, comum em código de classificação feito para GPT-3.5 Turbo, não causou problemas aqui: com max_output_tokens em 64, as 200 chamadas retornaram a categoria, inclusive no nível padrão de raciocínio. Uma tarefa que exija mais raciocínio ainda pode esgotar esse limite antes de produzir a resposta. Por isso, confira output_tokens_details.reasoning_tokens nas suas chamadas.
A latência foi parecida em quatro dos cinco modelos: mediana de 2,2 a 2,4 segundos por chamada. O GPT-6.1 Sol levou de 2,9 a 3,2 segundos.
O guia de migração da OpenAI lista as mudanças nas requisições: é preciso remover temperature, top_p e top_logprobs, a menos que o nível de esforço seja none; GPT-6.1 Sol não aceita none; e chamadas de ferramentas com raciocínio exigem a Responses API.
Qual substituto escolher?
Escolha conforme o uso do modelo que será desativado. A indicação da OpenAI é uma das opções, não a única.
| Modelo em uso | Escolha | Motivo |
|---|---|---|
| GPT-3.5 Turbo para classificação, extração e roteamento | GPT-6 Luna com reasoning.effort: "none" | $0.037 por 1.000 chamadas, contra $0.75 no GPT-5.6 Terra; ambos acertaram 96 de 96 |
| GPT-4.1 nano | GPT-6 Luna com esforço none | $0.037, contra $0.033 hoje; GPT-5.6 Luna custa $0.075 |
| GPT-4, GPT-4 Turbo ou gpt-4o-2024-05-13 para tarefas curtas | GPT-6.1 Sol em low, ou GPT-6 Luna se passar nos testes com seus dados | $0.72, contra $1.41 no GPT-5.6 Sol, cujo preço é promocional |
| GPT-4 para documentos longos | GPT-6.1 Sol | produz textos do mesmo tamanho que o GPT-5.6 Sol por 59% menos por documento no nosso teste com documentos; GPT-6 Luna escreve cerca de metade se o prompt não especificar as partes |
| Qualquer uso em que cada chamada precise ser rápida | GPT-6 Luna ou GPT-5.6 Sol | GPT-6.1 Sol foi o mais lento no teste: 2,9 a 3,2 segundos, contra 2,2 a 2,4 |
| o1, o3-mini, o4-mini | GPT-6.1 Sol em medium ou acima | O preço de tabela de $2 / $10 fica abaixo dos dois substitutos indicados ($4 / $20 e $2 / $12), mas acima dos $1.10 / $4.40 de o3-mini e o4-mini; meça nas suas tarefas, pois o custo de raciocínio depende da tarefa |
Não basta trocar o nome do modelo para migrar versões com fine-tuning. A OpenAI indica um modelo base para cada uma, mas é preciso refazer o fine-tuning ou substituí-lo por um prompt. Não testamos essa migração.
Nossas tarefas são curtas e têm uma única resposta correta. Antes de trocar de modelo, rode seus próprios prompts no candidato e compare as saídas. Uma versão mais barata que acertou as nossas 96 tarefas pode ter resultados diferentes nas suas.
Perguntas frequentes
Quando GPT-4 deixa de funcionar na API?
GPT-4, GPT-4 Turbo e a versão gpt-4o-2024-05-13 deixam de funcionar na API da OpenAI em 2026-10-23, junto com GPT-3.5 Turbo, GPT-4.1 nano, o1, o1-pro, o3-mini e o4-mini. A OpenAI anunciou a data em 2026-04-22.
Qual modelo substitui GPT-3.5 Turbo? A OpenAI indica GPT-5.6 Terra para substituir GPT-3.5 Turbo, por $2 / $12 por milhão de tokens, contra $0.50 / $1.50. No nosso teste, GPT-6 Luna, por $0.10 / $0.50, acertou as mesmas 96 tarefas curtas por um vigésimo do custo do GPT-5.6 Terra.
GPT-6 Luna é mais barato que GPT-3.5 Turbo? GPT-6 Luna custa $0.10 por milhão de tokens de entrada e $0.50 por milhão de tokens de saída, respectivamente um quinto e um terço dos $0.50 e $1.50 do GPT-3.5 Turbo. Com o raciocínio desativado, 1.000 chamadas curtas custaram $0.037 no nosso teste, contra cerca de $0.15 pelos preços do GPT-3.5 Turbo.
Outras medições: GPT-6.1 Sol vs Claude Sonnet 5.5, GPT-6 Luna vs GPT-5.6 Luna e como reduzir o custo do GPT-5.6.