
Compactação de contexto: quantos turnos até compensar?
Conteúdo
- Que problema você quer resolver com a compactação?
- Cenário 1: e se o modelo estiver ficando sem contexto?
- Cenário 2: vale compactar antes de entrar em uma faixa mais cara?
- Cenário 3: quantos turnos adicionais compensam uma compactação?
- A compactação desperdiça o adicional pago pela gravação no cache?
- Como a fórmula de retorno se compara aos resultados medidos?
- O que muda com o cache implícito do DeepSeek?
- Como o crescimento afeta o momento de compactar?
- Que intervalo o modelo sugere para um trabalho contínuo?
- Como medir o custo completo?
- Que política colocar em produção?
- Perguntas frequentes
- A compactação de contexto sempre reduz o custo da API?
- Devo compactar exatamente no limite de uma faixa de preço?
- Posso esperar até a janela de contexto ficar cheia?
- Um crescimento mais rápido do contexto sempre faz um resumo se pagar antes?
- Com cache implícito, devo esperar até o limite de contexto?
A compactação de contexto no Claude Sonnet 5.5 compensou seu custo após 4-6 requisições adicionais em seis execuções com cache aquecido, iniciadas perto de 14k tokens. Esse intervalo medido vale para a carga de trabalho testada. Uma política precisa considerar a geração do resumo, o modelo real de cobrança do cache e se ainda há trabalho suficiente para compensar a intervenção.
TL;DR
- A pressão sobre a janela de contexto torna a redução do contexto ativo uma necessidade de capacidade; nossos testes não mediram a janela máxima de um modelo.
- Uma consulta ficou aproximadamente no ponto de equilíbrio após um resumo cobrado na faixa mais cara ($0.0560882 contra $0.0560655 mantendo o histórico); duas consultas já compensaram claramente o resumo nesse exemplo.
- Uma verificação retrospectiva da fórmula estimou 4-5 turnos para compensar o custo, contra 4-6 turnos medidos; não foi um teste de previsão prospectiva.
- Uma tarefa de consulta a um arquivo com seis perguntas custou $0.0156941 com compactação e $0.0059911 sem ela, com acerto de 6/6.
Que problema você quer resolver com a compactação?
Defina o motivo para reduzir o contexto antes de escolher um limite de tokens. Um limite rígido de contexto, uma faixa de preço mais alta e uma conversa longa comum exigem decisões diferentes.
A compactação de contexto substitui o conteúdo anterior da conversa por uma representação menor, usada nas requisições seguintes. Nossos experimentos usaram resumos em texto gerados no cliente: uma chamada comum ao modelo produzia o resumo, e a aplicação substituía o histórico anterior por esse texto. Recursos nativos de compactação com assinatura ou criptografia têm contratos diferentes de requisição e contabilização de uso.
| Situação | Objetivo principal | O que deve acionar a intervenção? | Evidência neste artigo |
|---|---|---|---|
| Próximo da janela de contexto do modelo | Manter a tarefa executável | Folga suficiente para a próxima entrada, o resultado de ferramenta e a saída | Limites documentados do modelo e uma política de engenharia; nenhum experimento com a janela máxima |
| Próximo de uma faixa de preço mais alta | Reduzir o custo da carga de trabalho completa | A economia esperada com a tarifa supera os custos do resumo e da continuação | Um pequeno experimento de faixas de preço sem cache |
| Com folga na janela e na faixa de preço | Melhorar uma carga de trabalho específica | Resta trabalho útil suficiente para compensar o resumo sem perder o estado necessário | Comparações pareadas de retenção de estado com cache e uma tarefa curta de consulta a arquivo |
Cenário 1: e se o modelo estiver ficando sem contexto?
Reduza ou reorganize o contexto ativo antes que a próxima requisição possa ultrapassar a janela suportada. Nesse ponto, continuar com a transcrição completa pode deixar de ser uma estratégia viável.
O Claude Haiku 5.5 documenta uma janela de 1M tokens e uma saída máxima de 128K nas especificações do modelo. Esses são os valores publicados. Não testamos o contexto máximo aceito na nossa rota do gateway, e o experimento de faixas de preço abaixo não estabelece esse limite.
Reserve espaço para a próxima entrada, o resultado de ferramenta e a saída exigida pelo serviço. Acione a compactação enquanto a requisição de resumo ainda couber. Preserve o estado essencial em um resumo ou em um registro de origem recuperável e avalie se a continuação foi bem-sucedida; uma rejeição por exceder a janela não é uma alternativa bem-sucedida mais barata.
Cenário 2: vale compactar antes de entrar em uma faixa mais cara?
Compacte quando o trabalho restante esperado compensar o resumo aos preços efetivamente cobrados. Cruzar um limite de preço pode tornar a compactação interessante, mas o próprio resumo pode ser cobrado na faixa mais cara.
O Claude Haiku 5.5 muda de preço acima de 100,000 tokens de entrada. As tarifas padrão de entrada e saída, consultadas em 4 de novembro de 2026, são $0.10/$0.50 por milhão de tokens até esse limite e $0.50/$2.50 acima dele.
Enviamos registros fictícios variados de uma biblioteca pelo gateway da Synthorai. Uma requisição com 94,350 tokens de entrada custou $0.009437; outra com 111,999 custou $0.0560095. Ambas geraram quatro tokens de saída. A diferença em dólares inclui tanto o tamanho da entrada quanto a faixa de preço.
Em seguida, resumimos o histórico maior. Essa chamada processou 112,028 tokens de entrada, sem acertos de cache reportados, e custou $0.0560715 na faixa mais cara. As duas alternativas responderam corretamente às consultas de quantidade e fonte.
| Consultas restantes | Manter histórico | Resumo mais consultas com contexto reduzido | Manter, recalculado pela tarifa baixa | Compactar, recalculado pela tarifa baixa |
|---|---|---|---|---|
| 1 | $0.0560655 | $0.0560882 | $0.0112131 | $0.0112310 |
| 2 | $0.1120760 | $0.0560944 | $0.0224152 | $0.0112372 |
Uma consulta ficou aproximadamente no ponto de equilíbrio: a diferença entre as alternativas foi de $0.0000227. Duas consultas já compensaram claramente o resumo nesse exemplo. Recalcular todos os tokens pela tarifa baixa separa o efeito do volume do efeito da tarifa.
Essas requisições sem cache descrevem uma única tarefa sintética. Um histórico com cache aquecido se comporta de outra forma. Verifique quanto o resumo fica abaixo do limite e quando as novas entradas voltarão a ultrapassá-lo; veja faixas de preço para contexto longo.
Cenário 3: quantos turnos adicionais compensam uma compactação?
Medimos 4-6 turnos adicionais para o Claude Sonnet 5.5 em seis execuções com cache, iniciadas com cerca de 13.5k-14.2k tokens de entrada. Aqui, um turno significa uma requisição subsequente ao modelo. O experimento incluiu a geração do resumo e as gravações posteriores no cache, e identificou o primeiro ponto de equilíbrio dentro de doze requisições de continuação após o aquecimento compartilhado. Nas seis execuções, depois desse ponto a compactação permaneceu com custo menor ou igual até a requisição 12. Essa observação não cobre uma expiração posterior do cache, outro resumo ou uma mudança de tarefa.
A compactação desperdiça o adicional pago pela gravação no cache?
Gravações já pagas são custos irrecuperáveis no momento da decisão. A questão incremental é se a redução nas leituras futuras cobre a requisição de resumo e as novas gravações. Esses experimentos usaram cache explícito de cinco minutos; caches implícitos têm preços específicos de cada provedor e podem não cobrar o mesmo adicional de gravação.
Uma execução com crescimento médio mostra a diferença entre a primeira intervenção e outro resumo mais adiante na sessão:
| Intervenção | Custos de leituras futuras evitados | Gravações extras na continuação | Custo de geração do resumo | Resultado líquido no turno 12 |
|---|---|---|---|---|
| Primeiro resumo versus manter o histórico | $0.0159875 | $0.0010175 | $0.0049761 | $0.0099939 mais barato |
| Segundo resumo versus parar após o primeiro | $0.0037283 | $0.0013925 | $0.0065302 | $0.0041844 mais caro |
A segunda linha inclui $0.0000100 a menos em outros tokens. A cobrança dos resumos inclui suas próprias categorias de cache; não as conte duas vezes. As categorias de tokens não permitem identificar quais entradas individuais nunca foram reutilizadas.
Como a fórmula de retorno se compara aos resultados medidos?
Um modelo simples de cache aquecido estima quantos turnos restantes são necessários. Considere H como os tokens de histórico substituídos, S como os tokens de entrada do resumo substituto, A como o custo completo da requisição de resumo, r como o preço por token de leitura do cache e w como o preço por token de gravação no cache. Preserve as instruções inalteradas antes do histórico substituído.
Em n requisições futuras, manter o histórico custa n*r*H. A substituição custa A + w*S + (n-1)*r*S. A diferença incremental é:
compact cost minus retain cost
= A + (w-r)*S - n*r*(H-S)

payback turns
= ceil((A + (w-r)*S) / (r*(H-S)))
A fórmula pressupõe H > S, elegibilidade imediata para cache, preços inalterados e as mesmas adições posteriores, saídas e operações com ferramentas. Ela não cobre expiração do cache, regravações extras do prefixo preservado nem custos para recuperar a qualidade. Use um cálculo de custo por trechos quando essas condições mudarem.
Aplicamos a fórmula retrospectivamente, após os experimentos. O cálculo usa os registros de uso do aquecimento e do resumo como entradas, e não os custos subsequentes, mas os resultados já eram conhecidos. É uma verificação retrospectiva, não uma validação com dados separados ou prospectiva. A análise aproxima H pela entrada total do aquecimento e S pelos tokens de saída do resumo; esses valores diferem do histórico exatamente substituível e da entrada substituta por causa das instruções fixas, da estrutura da mensagem e da elegibilidade para cache.
| Crescimento da entrada | Execução | Estimativa retrospectiva | Retorno medido |
|---|---|---|---|
| Cerca de 96 tokens/turno | 1 | 5 turnos | 6 turnos |
| Cerca de 96 tokens/turno | 2 | 5 turnos | 6 turnos |
| Cerca de 1.4k tokens/turno | 1 | 5 turnos | 5 turnos |
| Cerca de 1.4k tokens/turno | 2 | 4 turnos | 4 turnos |
| Cerca de 5.2k-5.5k tokens/turno | 1 | 5 turnos | 5 turnos |
| Cerca de 5.2k-5.5k tokens/turno | 2 | 4 turnos | 5 turnos |
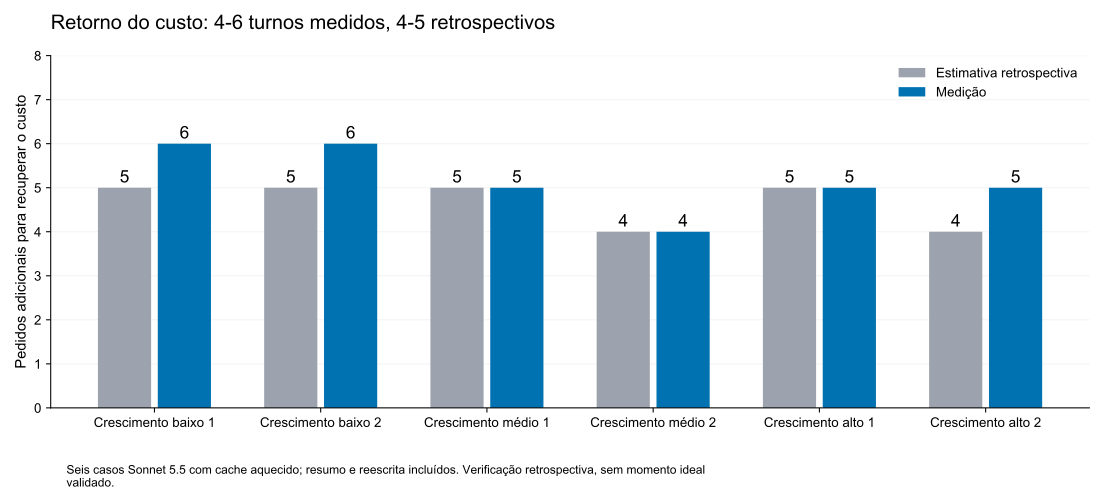
O erro da verificação retrospectiva foi de no máximo um turno nessas seis execuções. Uma decisão futura precisa de estimativas de A e S obtidas de resumos anteriores e de validação em novas tarefas; essa comparação não fornece uma garantia geral de erro.
O que muda com o cache implícito do DeepSeek?
Não cobrar uma taxa separada de gravação no cache não significa que a entrada após a compactação seja gratuita. O DeepSeek V4.1 Flash 1017 usa cache automático e preços distintos para entradas com e sem acerto no cache. Sua página de preços não lista uma cobrança separada de gravação. Um novo prefixo de resumo ainda paga a tarifa de entrada sem acerto quando não está em cache.
A documentação do cache exige correspondência com as unidades de prefixo persistidas. A construção leva segundos e os acertos não são garantidos, portanto a substituição pode ficar sem acerto em mais de uma requisição. Acompanhe prompt_cache_hit_tokens e prompt_cache_miss_tokens; não suponha que haverá exatamente uma chamada fria nem que um prefixo de sistema inalterado sempre terá acerto.
Considere p como o preço por token de entrada sem acerto e m como o número de requisições com prefixo substituto frio entre n requisições futuras. Se a referência que mantém o histórico continuar em cache e os custos comuns posteriores se cancelarem:
compact cost minus retain cost
= A + m*(p-r)*S - n*r*(H-S)
Para uma requisição fria, substitua w por p, não por zero. Se m for desconhecido, calcule vários cenários ou use os custos reais das categorias com e sem acerto, incluindo as falhas de cache do prefixo fixo e da chamada de resumo.
O que segue é um cálculo pela fórmula, não um experimento com o DeepSeek. Use os preços oficiais do Flash fora do horário de pico: $0.003/M para entrada com acerto, $0.15/M para entrada sem acerto e $0.60/M para saída. Suponha um resumo de 1k tokens, um histórico original com cache aquecido, uma requisição fria após a substituição e custo de resumo A = r*H + output_price*S. Ignore a estrutura da mensagem, o raciocínio e as ferramentas.
| Histórico original | Custo presumido da chamada de resumo | Retorno calculado |
|---|---|---|
| 10k tokens | $0.000630 | 29 requisições |
| 100k tokens | $0.000900 | 4 requisições |
Leituras baratas podem favorecer a manutenção de um histórico curto em cache, enquanto trabalhos mais longos podem compensar a compactação. Não medimos a qualidade nem o retorno no DeepSeek. Refaça o cálculo para tarifas de pico ou sessões com tarifas mistas.
Como o crescimento afeta o momento de compactar?
O crescimento altera o histórico no momento da decisão. Se passarem j turnos antes da intervenção e cada um adicionar g tokens, substitua H_j = H_0 + g*j na fórmula de retorno, junto com o tamanho e o custo atuais do resumo.
O mesmo crescimento posterior acrescenta custos comuns às duas alternativas. Com preços e comportamento do cache inalterados, esses termos se cancelam. Um crescimento mais rápido atinge antes as restrições de capacidade ou preço, mas não determina, por si só, os turnos necessários para compensar o custo.
Nos nossos testes de crescimento, o estado essencial permaneceu pequeno enquanto o conteúdo de arquivo aumentava. Nas duas execuções de doze turnos, repetir a compactação custou mais que um único resumo com crescimento médio e menos com crescimento alto. Todas as políticas responderam corretamente a 96/96 consultas de estado, incluindo a extensão; isso não testa um crescimento ilimitado do estado essencial.
Que intervalo o modelo sugere para um trabalho contínuo?
Para uma tarefa longa com crescimento, tamanho de resumo, preços e comportamento do cache aproximadamente constantes, considere F como a cobrança fixa por ciclo de compactação, incluindo a saída do resumo e a regravação do conteúdo substituto. Exclua os custos lineares em relação ao intervalo: sua contribuição amortizada por turno é constante. Quando o modelo que gera o resumo lê o histórico do cache, estime F como A - r*H + w*S; outros modelos de preço exigem sua própria decomposição. Se g é o crescimento por turno e k é o intervalo entre resumos, o custo médio dependente do intervalo é:
average interval-dependent cost = F/k + r*g*(k-1)/2
candidate interval k = sqrt(2*F/(r*g))
candidate history threshold = S + g*k
Isso exige F, r e g positivos, resumos preservados pequenos e qualidade comparável na tarefa. Com crescimento zero, não há acionamento periódico motivado por crescimento; com leituras gratuitas, esse modelo não oferece retorno pela economia de leituras. Com nossos preços de cache explícito e tamanhos de resumo, ele produz intervalos candidatos próximos de 30, 7-8 e 4 turnos para crescimento baixo, médio e alto. Teste os inteiros vizinhos, com no mínimo uma requisição, respeitando a folga de capacidade; nenhuma varredura de intervalos estabeleceu esses valores como ótimos. Um cache cobrado por entradas sem acerto exige sua própria decomposição de custo fixo.
Um exemplo de cálculo deixa as unidades concretas. Uma execução registrada com crescimento médio teve A = $0.0049761, H = 13,712, S ≈ 341 e g ≈ 1,396 tokens/turn. Com r = $0.10/M e w = $2.50/M, temos:
F ≈ 0.0049761 - (0.10/1,000,000)*13,712
    + (2.50/1,000,000)*341
  = $0.0044574 per cycle

k ≈ sqrt(2*0.0044574 / ((0.10/1,000,000)*1,396))
  ≈ 8 requests
Esse cálculo produz um candidato a partir dos valores registrados; não estabelece uma política ótima de oito requisições. A verificação do horizonte finito é separada: se uma intervenção deve compensar o custo após cinco requisições e só restam três, pule essa intervenção opcional mesmo que o temporizador periódico indique que chegou a hora.
Para uma tarefa perto do fim, pule outro resumo opcional se ele não puder compensar seu custo nas requisições restantes. Capacidade, faixas de preço e retenção das informações necessárias têm prioridade sobre esse modelo monetário simplificado.
Uma tarefa curta de consulta a arquivo ilustra esse critério. As duas estratégias responderam corretamente a seis perguntas sobre quantidades, mas manter o histórico custou $0.0059911, contra $0.0156941 incluindo um resumo. Seis consultas não compensaram essa intervenção. O resumo preservou detalhes suficientes; nenhuma busca adicional foi necessária. O horizonte de retorno depende do resumo e da carga de trabalho reais, não de uma regra universal de quatro a seis turnos.
Como medir o custo completo?
Inclua o resumo, a primeira requisição reescrita e todas as continuações. A redução de tokens do prompt e o percentual de acertos no cache, isoladamente, não comprovam economia.
Para o Claude Sonnet 5.5, nossa contabilização usou $2/M para entrada nova, $2.50/M para gravações no cache de cinco minutos, $0.10/M para leituras do cache e $10/M para saída. Leituras do cache são baratas, mas ainda custam dinheiro. Substituir um histórico com cache aquecido pode gerar uma nova gravação, enquanto um resumo muito curto pode nem ser elegível para cache. Nossos pontos explícitos de controle de cache nos blocos de conteúdo produziram gravações e leituras mensuráveis; alguns prefixos compactados curtos inicialmente não reportaram nenhuma das duas.
Esta função pressupõe uma quantidade especificada de requisições com prefixo frio. Passe o preço de gravação explícita ou o preço de entrada sem acerto do cache implícito em cold_input_per_million:
import math


def payback_turns(summary_cost, history_tokens, summary_tokens,
                  read_per_million=0.10, cold_input_per_million=2.50,
                  cold_requests=1):
    if cold_requests < 0 or int(cold_requests) != cold_requests:
        raise ValueError("cold_requests must be a nonnegative integer")
    r = read_per_million / 1_000_000
    p = cold_input_per_million / 1_000_000
    if summary_cost < 0 or p < r:
        raise ValueError("Unsupported cost assumptions")
    if history_tokens <= summary_tokens or r <= 0:
        return None
    upfront = summary_cost + cold_requests * (p - r) * summary_tokens
    saving_per_turn = r * (history_tokens - summary_tokens)
    return max(1, cold_requests, math.ceil(upfront / saving_per_turn))
Estime o custo do resumo a partir de chamadas anteriores para decidir antes da compactação. Valide com os registros completos de uso, incluindo falhas e trabalho de recuperação; a ausência de um registro não significa uma requisição gratuita.
As medições foram feitas em 4 de novembro de 2026 pela interface Messages do gateway, com thinking desativado e sem ferramentas hospedadas. As respostas comuns tinham limite de 128 tokens de saída e os resumos, de 2,048. Os custos foram reconstruídos a partir do uso retornado, com preços padrão, e conferidos com os custos reportados pelo gateway. Não houve conciliação com a fatura do fornecedor. As cargas de trabalho comuns usaram resumos gerados no cliente, não uma implementação nativa de compactação.
Que política colocar em produção?
Aplique primeiro as restrições de capacidade e tarifa, com folga para entrada, ferramentas e saída. Para cargas de trabalho do Claude Sonnet 5.5 com cache explícito, inclua os adicionais de gravação e os custos de resumo, e pule intervenções opcionais com pouca chance de se pagar antes do fim. Valide intervalos inteiros próximos do candidato analítico com as mesmas chegadas de tarefas e os mesmos turnos finais.
Para o cache implícito do DeepSeek V4.1 Flash 1017, preserve um prefixo útil quando os acertos forem estáveis e restar pouco trabalho. Um acionamento preventivo de capacidade mais tardio pode fazer sentido; a ausência de taxas separadas de gravação não implica esperar pelo limite rígido. Para trabalhos mais longos, estime os custos reais com e sem acerto e acompanhe as requisições após uma reescrita até que apareçam acertos.
Refaça os cálculos quando mudarem os preços, o estado do cache, o modelo ou o tamanho do estado essencial. Mantenha fontes recuperáveis e valide os valores alterados em tarefas sensíveis a detalhes. Registre o resumo e o uso posterior em uma única sessão de agente, usando as categorias de tokens corretas.
Perguntas frequentes
A compactação de contexto sempre reduz o custo da API?
A economia precisa superar os custos de resumo, reconstrução do cache e recuperação. Nossa tarefa de arquivo com seis consultas custou $0.0156941 com resumo e $0.0059911 mantendo o histórico, ambas com acerto de 6/6.
Devo compactar exatamente no limite de uma faixa de preço?
Um limite de preço é um ponto para avaliar toda a carga de trabalho restante, não uma ordem automática para resumir. No nosso exemplo com o Claude Haiku 5.5, o próprio resumo foi cobrado acima de 100,000 tokens; uma consulta posterior ficou aproximadamente no ponto de equilíbrio, enquanto duas já compensaram claramente o custo.
Posso esperar até a janela de contexto ficar cheia?
Deixe espaço para a requisição de resumo, a próxima entrada ou resultado de ferramenta e a saída. Um histórico que já passou do limite pode não caber em uma requisição de resumo. Não medimos o ponto de falha na janela máxima.
Um crescimento mais rápido do contexto sempre faz um resumo se pagar antes?
Um crescimento compartilhado mais rápido aumenta os custos das duas estratégias e não amplia automaticamente a economia de um resumo. Compactações repetidas podem limitar o acúmulo posterior, mas acrescentam custos de resumo e regravação. Nas nossas execuções com crescimento médio, repetir a compactação custou mais que um único resumo ao longo de doze turnos; as execuções com crescimento alto favoreceram a repetição. Escolha a política com base no crescimento, no horizonte restante e no estado que precisa ser preservado.
Com cache implícito, devo esperar até o limite de contexto?
O cache implícito pode favorecer a manutenção de um histórico barato com cache aquecido em uma tarefa curta. O DeepSeek V4.1 Flash 1017 ainda cobra entrada sem acerto para um prefixo de resumo fora do cache, e a persistência não é garantida. Estime o benefício restante e deixe folga para ferramentas, entrada e saída antes de atingir a janela suportada. Os valores do DeepSeek acima são cálculos, não limites medidos.