
Falhas no cache de prompts: 5 checagens antes de culpar as rotas
Conteúdo
- O que verificar primeiro quando os acertos de cache desaparecem?
- Quais configurações da aplicação e intervalos verificar?
- O que um gateway pode alterar entre o cliente e o provedor?
- Como investigar uma regressão de cache no Synthorai?
- Uma sessão medida: encontre a regressão e inspecione os spans
- Como os diagnósticos nativos ajudam a identificar mudanças na requisição?
- Quando investigar o próprio serviço de inferência?
- Como comprovar que a correção funcionou?
- Perguntas frequentes
- Adicionar cache_control garante um acerto?
- O roteamento pode causar uma falha de cache mesmo sem mudar o nome do modelo?
- Por que o diagnóstico indica mudança na requisição se alguns tokens vieram do cache?
Para diagnosticar falhas no cache de prompts, comece pelo uso reportado. Depois, compare o prefixo reutilizável, a elegibilidade, os intervalos e o destino real no upstream com uma requisição de referência cujo cache já estava aquecido.
TL;DR
- A ausência de dados de cache deixa o resultado indeterminado; zero tokens lidos do cache não identifica a causa.
- A taxa de acerto por requisição conta requisições com qualquer reutilização; a proporção de tokens reutilizados mede quanto da entrada foi reaproveitado.
- Cada estado do diagnóstico nativo exige uma ação diferente: corrigir uma divergência, substituir uma referência ausente ou investigar uma comparação inconclusiva.
- O DeepSeek exige correspondência com unidades de prefixo persistidas; compartilhar um prefixo de texto pode não bastar.
O que verificar primeiro quando os acertos de cache desaparecem?
Comece verificando se a resposta bruta realmente contém dados de uso do cache. Se o provedor reporta leituras, mas o cliente ou o painel não, investigue primeiro a apresentação desses dados. Caso contrário, preserve a última requisição com cache aquecido confirmado e compare com ela a requisição que apresentou a falha.
| Primeira checagem | Evidências a coletar | Próxima ação mínima útil |
|---|---|---|
| A falha de cache é real? | Uso bruto do provedor, resposta ao cliente e registro no painel | Verifique campos ausentes e a agregação do streaming antes de alterar os prompts |
| O prefixo mudou? | Ferramentas na ordem enviada, texto de sistema e mensagens anteriores | Compare os componentes; mova timestamps ou IDs de requisição variáveis para depois do conteúdo reutilizável |
| O prefixo era elegível e foi gravado? | Mínimo do modelo, controles e uso de leitura/gravação | Confira o modelo e a API exatos; inspecione o ponto de quebra pretendido |
| A requisição chegou cedo ou tarde demais? | Horário de início da resposta, intervalo entre requisições e tempo de vida do cache | Faça uma chamada sequencial de acompanhamento antes de testar tráfego paralelo |
| O destino mudou? | Modelo efetivo, serviço, escopo da conta e tentativas de fallback | Peça ao operador do gateway para comparar as tentativas reais no upstream |
Use duas métricas com nomes explícitos, calculadas sobre requisições com dados completos de entrada e cache:
- Taxa de acerto por requisição = requisições com mais de zero tokens lidos do cache / requisições com dados completos de uso.
- Proporção de tokens reutilizados = soma dos tokens lidos do cache / soma de todos os tokens de entrada, incluindo entrada em cache e gravações no cache.
Reporte separadamente as requisições sem dados de uso e inclua as tentativas que falharam no custo do incidente. O crescimento da entrada pode reduzir a proporção de tokens reutilizados sem alterar a taxa de acerto por requisição.
| API nativa | Campo de leitura do cache | Entrada total usada no denominador da proporção de tokens |
|---|---|---|
| OpenAI Responses | usage.input_tokens_details.cached_tokens | usage.input_tokens, que já inclui a entrada em cache |
| Anthropic Messages | usage.cache_read_input_tokens | input_tokens + cache_read_input_tokens + cache_creation_input_tokens dentro de usage |
| DeepSeek | usage.prompt_cache_hit_tokens | prompt_cache_hit_tokens + prompt_cache_miss_tokens dentro de usage |
Use o schema normalizado do gateway quando os campos nativos tiverem sido convertidos; a fórmula do Synthorai aparece abaixo.
Quais configurações da aplicação e intervalos verificar?
Verifique se houve mudança no conteúdo antes do fim do prefixo que deveria ser reutilizado: timestamps no sistema, ordem das ferramentas e histórico reescrito são bons pontos de partida.
Alteração do prefixo. Capture fingerprints separados (hashes usados para detectar mudanças) das definições de ferramentas na ordem enviada, do texto de sistema estável e dos blocos de mensagens anteriores. Mantenha no final um marcador específico da requisição. O hash da requisição inteira muda durante o crescimento normal de uma conversa que apenas acrescenta mensagens e não permite localizar a primeira diferença. Espaços em branco no JSON fora do texto também são diferentes de espaços dentro de uma string visível ao modelo.
Inspecione onde o conteúdo recuperado é inserido, as mudanças de modo, a compactação e a requisição final gerada pelo framework. Para entradas multimodais, compare o pré-processamento e as referências a arquivos.
Elegibilidade e controles. Um ponto de quebra marca o fim do prefixo que se deseja armazenar em cache. O tempo de vida (TTL) é a duração configurada para a entrada no cache.
Uma requisição longa no total não garante que o prefixo reutilizável selecionado atenda ao mínimo do modelo. Para pontos de quebra explícitos, verifique o conteúdo anterior ao ponto de quebra. Adicionar cache_control não torna reutilizável um prefixo que não atende aos requisitos. Na Anthropic, inspecione os controles automáticos e os definidos por bloco, os conflitos de TTL e os limites de pontos de quebra; uma combinação inválida pode gerar HTTP 400, ou seja, rejeição da requisição, em vez de uma resposta bem-sucedida com zero leituras do cache. Cache de prompts da Anthropic.
Disponibilidade e expiração. Enviar uma rajada de requisições idênticas antes de a primeira gravação ficar disponível pode gerar várias requisições com cache frio. A Anthropic documenta que o cache fica disponível após o início da primeira resposta. Envie uma requisição de acompanhamento depois que a primeira resposta começar para estabelecer uma referência com cache aquecido. Depois, compare as requisições paralelas pelos horários de início das respostas. Em conversas ociosas, compare o intervalo com o tempo de vida configurado e com o comportamento de renovação documentado. Disponibilidade do cache da Anthropic.
Unidades persistidas do DeepSeek. O DeepSeek compara unidades completas de prefixo persistidas, que são trechos salvos do contexto anterior. O exemplo documentado começa com A+B, seguido de A+C: a segunda requisição não consegue reutilizar a unidade completa A+B. Depois que o serviço detecta e persiste o prefixo comum A, uma terceira requisição A+D pode reutilizar essa unidade. Aqui, A é o contexto estável, e B, C e D são sufixos diferentes. Esse mecanismo está documentado pelo fornecedor; não é uma medição nossa.
Nesse padrão, preserve A exatamente, conclua as duas primeiras requisições em sequência, considere que a persistência pode levar segundos e então inspecione os campos de tokens com e sem acerto de cache da terceira requisição. Apenas esperar não garante que a unidade de prefixo comum desejada tenha sido criada, e o cache continua sem garantia de acerto. Regras de persistência do DeepSeek.
O que um gateway pode alterar entre o cliente e o provedor?
Um gateway pode alterar tanto a requisição efetiva quanto as evidências devolvidas ao cliente. Verifique essas duas coisas separadamente antes de atribuir uma regressão ao roteamento.
Verifique aliases de modelo, escopo das credenciais, sobrescritas por políticas e tentativas de fallback. Na conversão de protocolo, inspecione os controles enviados e os campos nativos retornados; no streaming, compare os eventos de uso do upstream com o uso final entregue ao cliente.
Mudança de fornecedor no roteamento. O balanceamento ou o failover pode encaminhar o mesmo modelo público para fornecedores de inferência com caches separados. Um prefixo aquecido no fornecedor A fica indisponível no fornecedor B. Nosso estudo sobre mudanças de provedor observou nove upstreams e 4/20 acertos por requisição, contra 19/20 na comparação com um único backend. Esses resultados descrevem aquela configuração histórica.
Agrupe as tentativas por fornecedor, modelo e escopo da conta. Compare as leituras do cache dentro de cada grupo com prefixos e intervalos estáveis, incluindo falhas e destinos de fallback. Peça ao operador para verificar a afinidade (encaminhamento consistente de requisições relacionadas) e o failover. Repita após um ajuste aprovado. A troca de fornecedor confirma a mudança de destino; falhas individuais ainda exigem checagens de intervalo e elegibilidade.
As requisições do Synthorai não têm seletor de provedor/canal.
Como investigar uma regressão de cache no Synthorai?
Use Analytics para tendências da carga e Logs para requisições. Os rótulos foram conferidos no ambiente em execução em 6 de novembro de 2026.
- Delimite a carga. Em Analytics, selecione
Time rangeeAll keys · all models. Em Logs, useAdd filtercommodeloukey. Mantenha as mesmas seleções nos intervalos normal e afetado.CACHE HITé uma proporção de tokens reutilizados, não uma taxa de acerto por requisição. - Inspecione a requisição. Em
Overview, compare Input, Cache read, Output e as gravações aplicáveis emCost at your rate. Leituras estáveis com aumento da entrada sugerem crescimento do contexto; queda nas leituras e aumento nas gravações sugerem verificar o prefixo e os intervalos.Rawcontém os campos armazenados, não a resposta original do provedor. - Acompanhe o trace e a sessão. Na requisição afetada em Logs, selecione
Open tracee depoisOpen session. EmTraces in this session, compare as tarefas e abra o trace sem reutilização. Clique em cada span (operação individual) para inspecionar leituras/gravações do cache e cobranças; o waterfall sozinho não mostra a reutilização do cache. Use os filtrossessionoutracede Logs para acessar os registros correspondentes. Preserve links, timestamps e IDs de resposta nativos para escalar a investigação.
Envie X-Session-Id por conversa, X-Trace-Id por tarefa e X-Span-Id por operação. Agrupe por modelo e pelo prefixo que deveria ser compartilhado antes de interpretar as tendências do cache.
Correlação e roteamento são coisas distintas: X-Session-Id também tem precedência sobre a chave de cache no corpo para a afinidade do gateway; X-Trace-Id apenas agrupa observações. Mantenha a identidade da sessão estável nas comparações. Nenhum deles garante cache compartilhado ou destino fixo; não agrupe conversas sem relação para tentar aumentar os acertos.
Para registros completos armazenados pelo Synthorai, calcule a reutilização de tokens assim:
cache reads = cached_tokens + explicit_cached_tokens
input total = prompt_tokens + explicit_cached_tokens + cache_write_tokens
reuse ratio = sum(cache reads) / sum(input total)
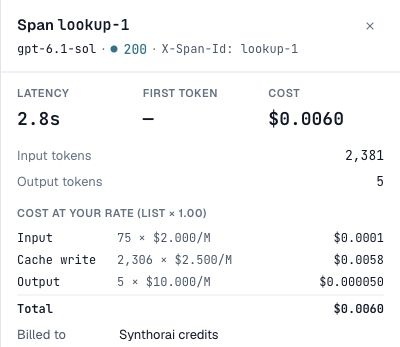
Aqui, cached_tokens já está incluído em prompt_tokens; somá-lo novamente contaria a entrada duas vezes. As gravações no cache entram no denominador, não no numerador. Exclua os registros sem dados de uso e reporte a quantidade separadamente; um zero armazenado, por si só, não prova que o upstream informou um zero medido.
Uma sessão medida: encontre a regressão e inspecione os spans
Seguindo nossa investigação de custos de agentes, enviamos seis requisições sequenciais à API Responses pelo Synthorai em 6 de novembro de 2026, usando GPT-6.1 Sol. Uma sessão continha três traces, cada um com duas chamadas rotuladas lookup-1 e lookup-2. Esses rótulos identificam chamadas sintéticas ao modelo; nenhuma ferramenta de consulta foi executada. Modelo, ferramentas e ID de sessão permaneceram fixos. A regressão inseria um novo valor semelhante a um timestamp no início de cada requisição; a correção restaurou o prefixo original. Os marcadores de requisição permaneceram no final.
| Trace | Tokens de entrada | Leituras do cache | Reutilização | Custo reportado |
|---|---|---|---|---|
| referência | 4,729 | 2,273 | 48.1% | $0.0063923 |
| regressão | 4,764 | 0 | 0% | $0.0119350 |
| correção | 4,732 | 4,546 | 96.1% | $0.0009446 |
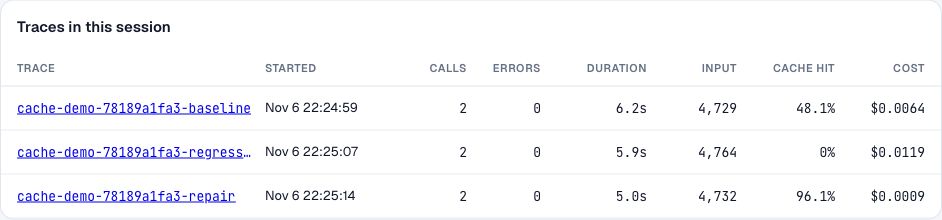
Em Traces in this session, abra a linha da regressão sem reutilização. A referência inclui uma primeira chamada com cache frio; a correção reutiliza um prefixo já aquecido. Essa demonstração com seis chamadas mostra a falha introduzida e a recuperação, não uma taxa de economia esperada em produção. A reutilização na sessão inteira é 6,819 / 14,225 = 47.9%; essa média esconde a regressão.
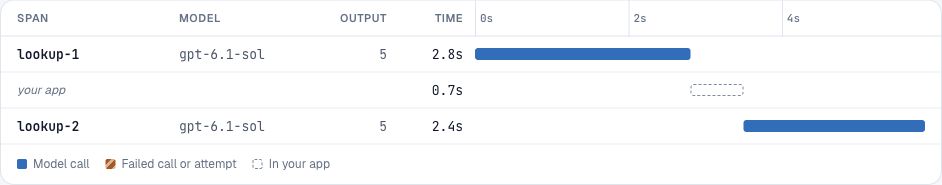
Selecione lookup-1 no waterfall. Os detalhes mostram 2,306 tokens gravados no cache de um total de 2,381 tokens de entrada, compatível com a reconstrução do prefixo alterado. As requisições sintéticas armazenadas comprovam a diferença introduzida; a linha do tempo sozinha não consegue identificá-la. Use Open in Logs para acessar o registro da requisição e compare os fingerprints do prefixo capturados na aplicação.
Essa demonstração não solicitou comparações de diagnóstico nativas. A mudança de prefixo introduzida e o uso reportado comprovam a regressão e a recuperação observadas; a continuidade do fornecedor real não foi verificada de forma independente. A identidade da sessão permaneceu fixa, portanto o experimento não mede um benefício de afinidade.
Para BYOK, diferencie o custo reportado pelo provedor do custo estimado antes de conciliar a fatura. Obtenha evidências do operador para detalhes de destino/fallback que não estejam disponíveis.
Como os diagnósticos nativos ajudam a identificar mudanças na requisição?
Os diagnósticos nativos identificam diferenças entre requisições; os dados de uso medem a reutilização reportada. Leia os dois em conjunto. O caminho selecionado no gateway precisa oferecer suporte aos campos nativos e preservá-los. Nosso teste anterior de comparação no Synthorai não retornou diagnósticos, portanto a documentação do fornecedor, sozinha, não comprova a disponibilidade no gateway.
A API OpenAI Responses aceita prompt_cache_options.comparison_response_id nos modelos compatíveis. Guarde o ID da resposta de referência concluída e envie o conteúdo real da requisição seguinte; a referência de comparação não carrega o histórico da conversa. Os resultados aparecem em prompt_cache_diagnostics, inclusive no evento response.completed durante o streaming. Use os estados abaixo para escolher a próxima ação. As estimativas de tokens do diagnóstico são separadas do uso faturado. Diagnósticos de cache da OpenAI.
A API Anthropic Messages usa diagnostics: {"previous_message_id": null} para a ativação inicial, seguido do ID nativo da mensagem anterior nas requisições seguintes com diagnóstico ativado. No streaming, o resultado aparece em message_start. Só interprete um resultado nulo depois de verificar que ambas as requisições ativaram o diagnóstico e que a seguinte forneceu uma referência real. A Anthropic documenta os diagnósticos para a Claude API, excluindo Amazon Bedrock e Claude gerenciado pelo Google. Diagnósticos de cache da Anthropic.
| API e estado retornado | Significado | Próxima ação |
|---|---|---|
OpenAI cache_hit | A comparação não detectou falha de cache | Leia os dados de uso para quantificar a reutilização; novos tokens de sufixo ainda podem exigir processamento |
OpenAI cache_miss | Uma diferença classificada afetou a reutilização esperada | Inspecione reason, corrija o componente indicado e compare novamente |
OpenAI comparison_response_not_found | Registro de referência ausente ou expirado | Escolha uma resposta recente e concluída da mesma organização |
OpenAI unavailable | Comparação não suportada ou inconclusiva | Verifique o suporte do modelo; tente uma referência recente e, se persistir, faça checagens manuais |
Anthropic diagnostics: null | Ausência de divergência apenas quando houve uma comparação válida com diagnóstico ativado; também é retornado sem ativação ou no primeiro turno | Verifique primeiro a ativação e a referência; com correspondência válida e poucas leituras, verifique a disponibilidade do cache |
Anthropic cache_miss_reason: null dentro de um objeto de diagnóstico | Comparação pendente | Verifique o próximo turno com diagnóstico ativado; não classifique o resultado pendente como falha de cache |
Anthropic motivo do tipo *_changed | Primeiro componente divergente identificado | Corrija esse componente e compare novamente; diferenças posteriores podem continuar existindo |
Anthropic previous_message_not_found | Nenhum fingerprint de referência retido | Verifique a ativação na requisição anterior, a organização/workspace e o tempo decorrido; estabeleça uma nova referência |
Anthropic unavailable | Comparação inconclusiva, inclusive por algumas mudanças em outros parâmetros ou limites de comparação | Compare o tool_choice efetivo, as configurações de raciocínio/saída e os headers beta; se persistir, faça checagens manuais |
| Campo de diagnóstico ausente em qualquer uma das APIs | Evidência ausente | Verifique o suporte da API/modelo, as opções da requisição, a conversão e a captura de eventos do streaming |
O prompt_cache_key_changed da OpenAI exige atenção especial: o uso pode reportar uma falha sem que tenha ocorrido uma falha física no cache. Antes de atribuir o resultado à disponibilidade do cache, verifique se a chave foi alterada intencionalmente para separar a contabilização. Mantenha a chave estável dentro do grupo de contabilização pretendido e verifique também seu papel na afinidade do gateway. Motivos de diagnóstico da OpenAI.
Quando investigar o próprio serviço de inferência?
Investigue a disponibilidade do cache depois de confirmar conteúdo elegível, intervalos válidos, escopos de destino comparáveis e dados de uso confiáveis. Mesmo assim, uma entrada idêntica não garante que exista uma entrada reutilizável no cache.
As possíveis explicações incluem expiração, persistência incompleta, pressão de capacidade e agendamento no serviço. A OpenAI documenta restrições de roteamento e disponibilidade do cache; um rótulo de sessão não garante acesso a um worker específico. Um acerto parcial também pode significar que um prefixo anterior continua reutilizável, mas o conteúdo posterior precisa ser processado. Cache de prompts da OpenAI.
Demora no primeiro token ou zero leituras não comprovam uma troca de cluster. Ao escalar o caso, envie IDs de resposta nativos, timestamps, intervalos e rótulos de destino; sem evidências do provedor, mantenha o mecanismo como indeterminado.
Recursos explícitos de cache exigem outra checagem: inspecione a existência, a expiração e o escopo do objeto referenciado. Não diagnostique um ID de recurso explícito obsoleto com as mesmas premissas usadas para cache automático de prefixos.
Como comprovar que a correção funcionou?
Compare o tráfego normal, afetado e corrigido usando dados de uso, diagnósticos e destinos.
Inclua novas tentativas no custo. Uma correção nos relatórios deve reconciliar o uso nativo com o uso apresentado ao cliente. Uma correção no prefixo deve eliminar a diferença e restaurar uma reutilização comparável. Uma correção de roteamento deve confirmar o destino pretendido e a recuperação dentro desse escopo. Se a condição relevante não for atendida, mantenha a classificação como não resolvida e continue a partir das evidências restantes.
Perguntas frequentes
Adicionar cache_control garante um acerto?
Os controles de cache continuam sujeitos ao tamanho e à posição do prefixo, à disponibilidade e ao tempo de vida. Verifique os requisitos do modelo e os dados brutos de uso.
O roteamento pode causar uma falha de cache mesmo sem mudar o nome do modelo?
Um nome de modelo estável no cliente pode ser resolvido para diferentes fornecedores, modelos ou escopos de conta. Compare as tentativas reais com o operador do gateway usando o roteiro para investigar mudanças de provedor.
Por que o diagnóstico indica mudança na requisição se alguns tokens vieram do cache?
Uma mudança perto do final da requisição pode manter um prefixo anterior reutilizável. Analise o componente alterado junto com a quantidade absoluta de tokens lidos do cache. A comparação de diagnóstico e a contabilização do cache descrevem aspectos diferentes da requisição.
Para investigações relacionadas, consulte a auditoria de cache do gateway, a análise de custos de gravação no cache e os intervalos de compactação.