
プロンプトキャッシュのミス:ルーティングを疑う前の 5 つの確認
目次
- キャッシュヒットがなくなったら、最初に何を確認するか
- アプリケーションの設定とタイミングは何を確認するか
- クライアントとプロバイダーの間でゲートウェイが変えるもの
- Synthorai でキャッシュの悪化を調べる手順
- セッションの実測例:悪化を見つけて span を調べる
- ネイティブ診断でリクエストの変更をどう特定するか
- 推論サービス自体を調べるのはいつか
- 修正が効いたことをどう確認するか
- よくある質問
- cache_control を追加すれば必ずヒットするか
- モデル名が変わらなくても、ルーティングでキャッシュミスが起きるか
- 一部の token はキャッシュされているのに、診断ではリクエストが変わったと出るのはなぜか
プロンプトキャッシュのミスを調べるときは、まず usage を確認します。そのうえで、再利用できるプレフィックス、キャッシュの適用条件、タイミング、実際の上流接続先を、キャッシュが温まっていると確認できたリクエストと比較します。
TL;DR
- キャッシュの usage が欠けている場合、状態は不明です。読み取りがゼロと報告されていても、それだけでは原因は分かりません。
- リクエストヒット率は、一部でも再利用できたリクエストの割合です。token 再利用率は、入力のうちどれだけを再利用したかを表します。
- ネイティブ診断の状態によって対応は異なります。差分を修正する、失われた比較基準を取り直す、判定不能な比較を調査する、といった切り分けが必要です。
- DeepSeek では、永続化済みのプレフィックス単位が一致する必要があります。テキストの先頭部分が共通しているだけでは不十分な場合があります。
キャッシュヒットがなくなったら、最初に何を確認するか
まず、プロバイダーの生レスポンスにキャッシュの usage が含まれているかを確認します。プロバイダーが読み取りを報告しているのにクライアントやダッシュボードに表示されないなら、先に集計や表示を調べます。それ以外の場合は、最後にキャッシュが温まっていると確認できたリクエストを保存し、ミスが起きたリクエストと比較します。
| 最初の確認 | 集める証拠 | まず行う最小限の対応 |
|---|---|---|
| 本当にミスしているか | プロバイダーの生の usage、クライアントのレスポンス、ダッシュボードの記録 | prompt を変える前に、フィールドの欠落と streaming の集計を確認する |
| プレフィックスが変わったか | 順序を含むツール定義、system テキスト、過去のメッセージ | 構成要素ごとに比較し、毎回変わるタイムスタンプやリクエスト ID を再利用対象の後ろへ移す |
| プレフィックスは条件を満たし、書き込まれたか | モデルの最低要件、制御設定、読み取りと書き込みの usage | 正確なモデルと API を確認し、意図したブレークポイントを調べる |
| リクエストが早すぎたか、遅すぎたか | レスポンス開始時刻、リクエスト間隔、キャッシュの有効期間 | 並列トラフィックを試す前に、後続リクエストを 1 回直列で送る |
| 接続先が変わったか | 実際のモデル、サービス、アカウントのスコープ、フォールバックの試行 | ゲートウェイの運用者に、実際の上流への試行を比較してもらう |
入力とキャッシュの usage がそろっているリクエストについて、次の 2 つの指標を明確に区別して使います。
- リクエストヒット率 = キャッシュ読み取り token がゼロより多いリクエスト数 / usage がそろっているリクエスト数。
- token 再利用率 = キャッシュ読み取り token の合計 / キャッシュ済み入力とキャッシュ書き込みを含む全入力 token の合計。
usage が欠けたリクエストは別に報告し、障害時のコストには失敗した試行も含めます。入力が増えると、リクエストヒット率が変わらなくても token 再利用率は下がることがあります。
| ネイティブ API | キャッシュ読み取りのフィールド | token 再利用率の分母に使う総入力 |
|---|---|---|
| OpenAI Responses | usage.input_tokens_details.cached_tokens | usage.input_tokens。キャッシュ済み入力をすでに含む |
| Anthropic Messages | usage.cache_read_input_tokens | usage 内の input_tokens + cache_read_input_tokens + cache_creation_input_tokens |
| DeepSeek | usage.prompt_cache_hit_tokens | usage 内の prompt_cache_hit_tokens + prompt_cache_miss_tokens |
ネイティブのフィールドが変換されている場合は、ゲートウェイの正規化済みスキーマを使います。Synthorai の計算式は後述します。
アプリケーションの設定とタイミングは何を確認するか
再利用を想定したプレフィックスより前で、内容が変わっていないかを確認します。まず system 内のタイムスタンプ、ツールの順序、履歴の書き換えを調べるとよいでしょう。
プレフィックスの変更。順序を含むツール定義、固定の system テキスト、過去のメッセージブロックについて、それぞれ別のフィンガープリント(変更検出用のハッシュ)を記録します。リクエスト固有のマーカーは末尾に置きます。会話が通常どおり追記されるだけでもリクエスト全体のハッシュは変わるため、それでは最初の差分を特定できません。また、JSON のテキスト外にある空白と、モデルに渡される文字列内の空白は別物です。
検索結果を挿入する位置、モード切り替え、コンパクション、フレームワークが最終的に送信するリクエストを確認します。マルチモーダル入力では、前処理とファイル参照も比較します。
適用条件と制御設定。ブレークポイントは、キャッシュを要求するプレフィックスの末尾を示します。TTL は、キャッシュエントリに設定された有効期間です。
リクエスト全体が長くても、選択した再利用対象のプレフィックスがモデルの最低要件を満たすとは限りません。明示的なブレークポイントを使う場合は、その手前の内容を確認します。cache_control を追加しても、条件を満たさないプレフィックスが再利用可能になるわけではありません。Anthropic では、自動制御とブロック単位の制御、TTL の競合、ブレークポイント数の上限を確認します。無効な組み合わせでは、キャッシュ読み取りゼロの正常レスポンスではなく、リクエストの拒否を示す HTTP 400 が返る場合があります。Anthropic のプロンプトキャッシュ。
利用可能になる時点と失効。最初の書き込みが利用可能になる前に同じリクエストをまとめて送ると、複数のリクエストがコールド状態になることがあります。Anthropic のドキュメントでは、最初のレスポンスが始まった後に利用可能になるとされています。最初のレスポンスが始まってから後続リクエストを 1 回送り、キャッシュが温まった比較基準を作ります。その後、並列リクエストをレスポンス開始時刻で比較します。しばらく使われていなかった会話では、リクエスト間隔を、設定された有効期間とドキュメントに記載された更新動作に照らして確認します。Anthropic のキャッシュ利用可能時点。
DeepSeek の永続化単位。DeepSeek は、過去のコンテキストの一部を保存した、永続化済みプレフィックス単位全体で照合します。ドキュメントの例では、最初のリクエストが A+B、次が A+C です。2 回目のリクエストは、A+B 全体を再利用できません。サービスが共通プレフィックス A を検出して永続化した後なら、3 回目の A+D はその単位を再利用できます。ここで A は固定のコンテキスト、B、C、D はそれぞれ異なるサフィックスです。これはベンダーのドキュメントに記載された仕組みであり、当社の測定結果ではありません。
このパターンでは、A を完全に同一に保ち、最初の 2 リクエストを直列で完了させます。永続化に数秒かかることを見込んでから、3 回目のヒット/ミス token フィールドを確認します。待つだけで目的の共通プレフィックス単位が作成されるとは限らず、キャッシュは引き続きベストエフォートです。DeepSeek の永続化ルール。
クライアントとプロバイダーの間でゲートウェイが変えるもの
ゲートウェイは、実際に送られるリクエストと、クライアントに返される証拠の両方を変えることがあります。キャッシュの悪化をルーティングのせいにする前に、この 2 つを分けて確認します。
モデルのエイリアス、認証情報のスコープ、ポリシーによる上書き、フォールバックの試行を確認します。プロトコル変換がある場合は、送信される制御設定と返されるネイティブのフィールドを調べます。streaming では、上流の usage イベントとクライアント側の最終的な usage を比較します。
ベンダーをまたぐルーティングの変動。負荷分散やフェイルオーバーによって、同じ公開モデルの接続先が、別々のキャッシュを持つ推論ベンダー間で変わることがあります。ベンダー A で温まったプレフィックスは、ベンダー B では使えません。当社のプロバイダー変動の調査では、上流接続先が 9 つあり、リクエストヒットは 4/20 でした。一方、単一バックエンドとの比較では 19/20 でした。これは当時の構成についての結果です。
試行をベンダー、モデル、アカウントのスコープごとに分けます。プレフィックスと間隔を一定にして、各グループ内のキャッシュ読み取りを比較します。失敗やフォールバック先も含めます。運用者には、アフィニティ(関連するリクエストを一貫して同じ接続先へ送ること)とフェイルオーバーを確認してもらいます。承認済みの調整後に、もう一度比較します。ベンダーの変更が確認できれば接続先の変動は立証できますが、個々のミスについてはタイミングと適用条件の確認が引き続き必要です。
Synthorai のリクエストには、プロバイダーやチャネルを選択する指定はありません。
Synthorai でキャッシュの悪化を調べる手順
ワークロード全体の傾向には Analytics、個別リクエストには Logs を使います。画面のラベルは 2026 年 11 月 6 日に実環境で確認しました。
- 対象のワークロードを絞る。Analytics で
Time rangeとAll keys · all modelsを選びます。Logs ではAdd filterからmodelまたはkeyを指定します。正常時と問題発生時で選択条件をそろえます。CACHE HITは token 再利用率であり、リクエストヒット率ではありません。 - リクエストを調べる。
OverviewのCost at your rateで、Input、Cache read、Output、該当する書き込みを比較します。読み取りが一定で入力が増えているなら、コンテキストの増加が考えられます。読み取りが減って書き込みが増えているなら、プレフィックスとタイミングを確認します。Rawにあるのは保存されたフィールドであり、プロバイダーの元のレスポンスではありません。 - トレースとセッションをたどる。Logs で問題のリクエストから
Open trace、続いてOpen sessionを選びます。Traces in this sessionでタスクを比較し、再利用がゼロのトレースを開きます。各 span(個別の処理)をクリックして、キャッシュの読み取り、書き込み、料金を確認します。ウォーターフォールだけではキャッシュの再利用は分かりません。元のレコードは Logs のsessionまたはtraceフィルターで確認します。エスカレーションに備えて、リンク、タイムスタンプ、ネイティブのレスポンス ID を保存します。
会話ごとに X-Session-Id、タスクごとに X-Trace-Id、処理ごとに X-Span-Id を送ります。キャッシュの傾向を解釈する前に、モデルと、共有を意図したプレフィックスでグループ分けします。
観測データの関連付けとルーティングは別です。X-Session-Id は、ゲートウェイのアフィニティでは body 内のキャッシュキーよりも優先されます。X-Trace-Id は観測データをまとめるだけです。比較中はセッション ID を変えないでください。どちらも共有キャッシュや固定の接続先を保証しません。ヒットを増やすために、無関係な会話をまとめてはいけません。
必要な値がそろった Synthorai の保存レコードでは、token 再利用率を次のように計算します。
cache reads = cached_tokens + explicit_cached_tokens
input total = prompt_tokens + explicit_cached_tokens + cache_write_tokens
reuse ratio = sum(cache reads) / sum(input total)
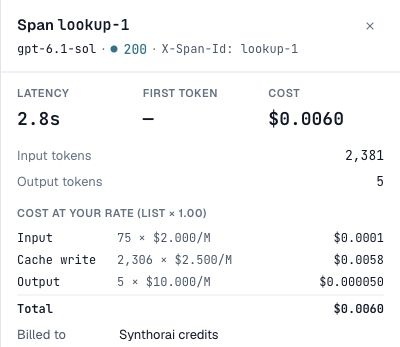
cached_tokens はすでに prompt_tokens に含まれています。もう一度加えると入力を二重計上します。キャッシュ書き込みは分子ではなく分母に含めます。usage が欠けたレコードは除外し、その件数を別に報告します。保存値がゼロというだけでは、上流が測定結果としてゼロを返したとは証明できません。
セッションの実測例:悪化を見つけて span を調べる
エージェントのコスト調査に続き、2026 年 11 月 6 日に GPT-6.1 Sol を使い、Synthorai 経由で Responses リクエストを 6 回直列に送りました。1 つのセッションに 3 つのトレースを作り、それぞれに lookup-1 と lookup-2 というラベルの 2 回の呼び出しを含めました。これは検証用のモデル呼び出しのラベルであり、検索ツールは実行していません。モデル、ツール、セッション ID は固定しました。悪化を再現するため、リクエストごとに新しいタイムスタンプのような値を先頭へ追加しました。修正時は元のプレフィックスに戻しました。リクエストのマーカーは末尾に置いたままです。
| トレース | 入力 token | キャッシュ読み取り | 再利用率 | 報告されたコスト |
|---|---|---|---|---|
| 基準 | 4,729 | 2,273 | 48.1% | $0.0063923 |
| 悪化 | 4,764 | 0 | 0% | $0.0119350 |
| 修正 | 4,732 | 4,546 | 96.1% | $0.0009446 |
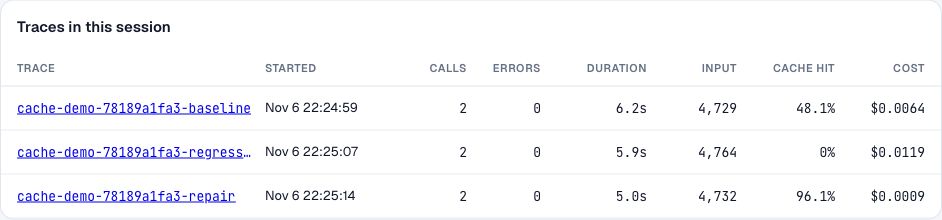
Traces in this session で、再利用がゼロになった悪化時の行を開きます。基準には、コールド状態での最初の呼び出しが含まれています。修正時には、すでに温まったプレフィックスを再利用しています。この 6 回の呼び出しは、意図的に起こした障害とその復旧を示すもので、本番で期待できる節約率を示すものではありません。セッション全体の再利用率は 6,819 / 14,225 = 47.9% です。この平均だけを見ると、途中の悪化を見落とします。
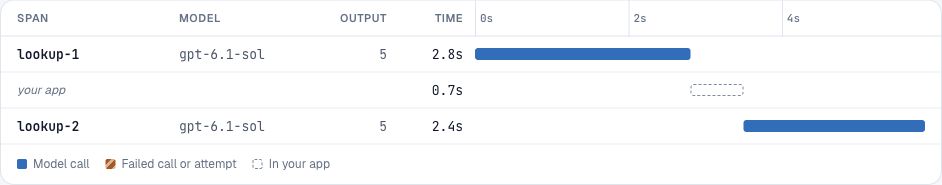
ウォーターフォールで lookup-1 を選びます。詳細では、入力 2,381 token のうち 2,306 token がキャッシュ書き込みになっており、変更されたプレフィックスを作り直したという説明と整合します。意図的に加えた差分は、保存した検証用リクエストから確認できます。タイムラインだけでは特定できません。Open in Logs でリクエストのレコードを開き、アプリケーション側のプレフィックスのフィンガープリントを比較します。
この検証では、ネイティブ診断による比較は要求していません。意図的なプレフィックスの変更と報告された usage から、悪化と復旧は確認できます。ただし、実際に同じベンダーが使われ続けたかは独立に検証していません。セッション ID は固定していたため、この実験はアフィニティの効果を測るものでもありません。
BYOK では、請求書と照合する前に、プロバイダーが報告したコストと推定コストを区別します。接続先やフォールバックの詳細を取得できない場合は、運用者から証拠を入手します。
ネイティブ診断でリクエストの変更をどう特定するか
ネイティブ診断はリクエストの差分を特定し、usage は報告された再利用量を示します。両方を合わせて確認します。利用するゲートウェイ経路が、ネイティブのフィールドに対応し、そのまま保持する必要があります。以前に行った Synthorai の比較テストでは診断結果が返りませんでした。したがって、提供元のドキュメントだけではゲートウェイ経由で利用できるとは判断できません。
OpenAI Responses は、対応モデルで prompt_cache_options.comparison_response_id を受け付けます。完了済みの基準レスポンス ID を保存し、後続リクエストには実際の内容を送信します。比較先の指定で会話履歴が読み込まれるわけではありません。結果は prompt_cache_diagnostics に入り、streaming では response.completed イベントにも含まれます。次の状態に応じて対応を選びます。診断の token 推定値と課金対象の usage は別です。OpenAI のキャッシュ診断。
Anthropic Messages では、最初に diagnostics: {"previous_message_id": null} を指定して診断を有効にし、以降の診断を有効にするリクエストでは、直前のネイティブメッセージ ID を渡します。streaming では message_start に結果が含まれます。null の結果を解釈する前に、両方のリクエストで診断が有効になっており、後続リクエストに実在する参照 ID を渡したことを確認します。Anthropic のドキュメントでは Claude API が対象で、Amazon Bedrock と Google 管理の Claude は対象外です。Anthropic のキャッシュ診断。
| API と返された状態 | 意味 | 次の対応 |
|---|---|---|
OpenAI cache_hit | 比較でミスが検出されなかった | usage で再利用量を確認する。新しいサフィックスの token は処理が必要な場合がある |
OpenAI cache_miss | 分類された差分が、想定した再利用に影響した | reason を確認して対象の構成要素を修正し、再度比較する |
OpenAI comparison_response_not_found | 基準レコードが存在しないか、期限切れ | 同じ組織内の最近完了したレスポンスを選ぶ |
OpenAI unavailable | 比較が未対応、または判定不能 | モデルの対応状況を確認し、最近の参照を試す。続く場合は手動で確認する |
Anthropic diagnostics: null | 有効な診断付き比較が実行された場合に限り、差分なしを意味する。診断が無効な場合や初回ターンでも返る | まず診断の有効化と参照を確認する。有効な比較で一致しているのに読み取りが少ない場合は、キャッシュの利用可能性を確認する |
Anthropic の診断オブジェクト内の cache_miss_reason: null | 比較が保留中 | 次の診断付きターンで確認する。保留中の結果をミスに分類しない |
Anthropic の理由タイプ *_changed | 最初に特定された差分のある構成要素 | その構成要素を修正して再比較する。後続の差分が残っている可能性がある |
Anthropic previous_message_not_found | 基準のフィンガープリントが保持されていない | 前のリクエストでの診断の有効化、組織/ワークスペース、経過時間を確認し、新しい基準を作る |
Anthropic unavailable | 他の一部のパラメーター変更や比較の制限などにより、確定的な比較結果が得られない | 実際の tool_choice、thinking/出力設定、beta ヘッダーを比較する。続く場合は手動で確認する |
| いずれかの API で診断フィールドが存在しない | 証拠がない | API/モデルの対応状況、リクエストのオプション、変換、streaming イベントの取得を確認する |
OpenAI の prompt_cache_key_changed には注意が必要です。実際のキャッシュミスがなくても、usage がミスを報告することがあります。キャッシュの利用可能性が原因だと判断する前に、集計を分ける目的でキーを意図的に変えていないか確認します。同じ集計グループ内ではキーを固定しつつ、ゲートウェイのアフィニティでそのキーが果たす役割も確認します。OpenAI の診断理由。
推論サービス自体を調べるのはいつか
内容が適用条件を満たし、タイミングが妥当で、接続先のスコープが比較可能であり、usage が信頼できると確認してから、キャッシュの利用可能性を調べます。それでも、入力が同じだからといって再利用可能なエントリが存在するとは限りません。
失効、永続化の未完了、容量の逼迫、サービス側のスケジューリングなどが考えられます。OpenAI は、キャッシュのルーティングと利用可能性に関する制約を公開しています。セッションのラベルがあっても、特定のワーカーへ接続できる保証はありません。また、部分ヒットは、前半のプレフィックスは再利用できる一方で、後半の内容には処理が必要な状態を表すこともあります。OpenAI のプロンプトキャッシュ。
最初の token が遅いことや読み取りがゼロであることだけでは、クラスターの切り替えは証明できません。ネイティブのレスポンス ID、タイムスタンプ、間隔、接続先ラベルを添えてエスカレーションします。プロバイダーの証拠がなければ、具体的な仕組みは未確定のままにします。
明示的なキャッシュリソースを使う場合は、別の確認が加わります。参照先オブジェクトの存在、有効期限、スコープを調べます。古くなった明示的リソース ID を、自動プレフィックスキャッシュと同じ前提で診断してはいけません。
修正が効いたことをどう確認するか
usage、診断、接続先を使い、正常時、問題発生時、修正後のトラフィックを比較します。
コストにはリトライを含めます。報告の修正なら、ネイティブとクライアントの usage が一致することを確認します。プレフィックスの修正なら、差分がなくなり、同等の再利用が回復することを確認します。ルーティングの修正なら、意図した接続先になっており、そのスコープ内で回復していることを確認します。該当する条件を満たさなければ、未解決の分類を維持し、残る証拠から調査を続けます。
よくある質問
cache_control を追加すれば必ずヒットするか
キャッシュの制御設定を使っても、プレフィックスの長さ、配置、利用可能になる時点、有効期間という条件は残ります。モデルの要件と生の usage を確認してください。
モデル名が変わらなくても、ルーティングでキャッシュミスが起きるか
クライアント側のモデル名が同じでも、異なるベンダー、モデル、アカウントのスコープへ解決されることがあります。プロバイダー変動の調査手順に沿って、ゲートウェイの運用者と実際の試行を比較してください。
一部の token はキャッシュされているのに、診断ではリクエストが変わったと出るのはなぜか
リクエストの後半が変わっても、前半のプレフィックスは再利用できる場合があります。変更された構成要素と、キャッシュ読み取り token の絶対数を合わせて確認します。診断による比較とキャッシュの集計は、リクエストの異なる側面を表しています。
関連する調査については、ゲートウェイのキャッシュ監査、キャッシュ書き込みのコスト、コンパクションのタイミングを参照してください。