
Agente LLM lento? 3 cause individuate nelle trace
Tre cause di lentezza riprodotte e risolte: chiamate seriali (da 3.7 s a 1.8 s), un tool lento nel codice e reasoning per risposte di una frase.
Le nostre scelte
prezzi live| Modello | Verdetto | Prezzo |
|---|---|---|
| GPT-6 Luna Cinque risposte di una frase hanno richiesto un tempo mediano di 25.6 s con il livello di ragionamento predefinito e di 10.2 s con reasoning_effort impostato su none, con i token di output scesi da 1,150 a 190. | Agente principale nella demo | da $0.1/M |
| DeepSeek V4.1 Flash Tre verifiche di una frase hanno richiesto un tempo mediano di 3.7 s se inviate una dopo l'altra e di 1.8 s se inviate insieme, a parità di 127 token di input. | Sottoagente nella demo | da $0.3/M |
Indice
- Da dove partire quando un agente è lento?
- Come riconoscere le chiamate eseguite in serie che potrebbero partire insieme?
- Come capire se la parte lenta è nel tuo codice?
- E se la parte lenta fosse una sola chiamata al modello?
- Cosa non copre questa pagina?
- FAQ
- Come trovo il passaggio più lento di un agente LLM?
- Le chiamate LLM parallele costano più di quelle seriali?
- Perché una chiamata al modello è lenta anche se la risposta è breve?
- Come misuro se una correzione ha reso l’agente più veloce?
- Il gateway può mostrare cosa ha fatto il mio codice tra due chiamate al modello?
- Letture correlate
Un agente lento di solito ha uno di tre problemi: le chiamate al modello si aspettano a vicenda senza motivo, il codice dell’agente è lento tra una chiamata e l’altra, oppure una chiamata fa più lavoro di quanto serva per quel passaggio. Una trace permette di capire quale sia in pochi secondi: mostra ogni chiamata su un asse temporale e rende visibili gli intervalli tra le chiamate. In questa guida riproduciamo ogni problema in un piccolo agente di assistenza, lo correggiamo e confrontiamo l’esecuzione prima e dopo la correzione nella console Synthorai.
TL;DR
- Inviare insieme tre chiamate indipendenti al modello con
asyncio.gatherha ridotto la mediana da 3.7 s a 1.8 s, a parità di costo. - Eseguire insieme quattro query simulate da 1.1 s ha ridotto il tempo nel codice dell’agente da 4.6 s a 1.3 s. Cambiare modello non avrebbe avuto alcun effetto su questa parte.
- Disattivare il reasoning (
reasoning_effort="none") per cinque risposte di una frase su GPT-6 Luna ha ridotto il tempo da 25.6 s a 10.2 s e i token di output da 1,150 a 190.
Questa guida riprende Tracciare un agente LLM, che descrive i tre header di richiesta necessari per raggruppare le chiamate al modello in una trace. Prepara la demo seguendo quella guida (Python 3.10 o successivo, virtualenv attivo), poi esegui i tre casi dalla stessa directory di github.com/synthorai-io/use-cases:
cd use-cases/agent-tracing
python incidents.py serial-checks slow-tool reasoning
Ogni caso viene eseguito due volte, prima con il problema e poi con la correzione. Per ogni esecuzione viene stampata una riga con l’ID della trace:
serial-checks
  before   3.5 s   3 calls     127 in (     0 cached)     60 out  $0.000110   trace-d2bb96ebcf04
  after    1.5 s   3 calls     127 in (     0 cached)     62 out  $0.000112   trace-5f1e76a2de87
La latenza del modello varia da una chiamata all’altra, quindi abbiamo eseguito ogni caso cinque volte l’11 ottobre 2026. La tabella riporta la mediana, con l’esecuzione più veloce e quella più lenta tra parentesi. Una delle esecuzioni corrette del terzo caso è fallita, quindi quella mediana è calcolata su quattro esecuzioni. L’output di esempio qui sopra e le coppie negli screenshot provengono da un’ulteriore esecuzione di ciascun caso, non inclusa nelle cinque. I tempi sono misurati dallo script e indicano il tempo totale trascorso dall’inizio alla fine (wall time).
| Caso | Cosa mostra la trace | Correzione | Prima | Dopo |
|---|---|---|---|---|
serial-checks | barre a gradini, senza sovrapposizioni | inviare insieme le chiamate indipendenti | 3.7 s (da 3.5 a 4.5) | 1.8 s (da 1.7 a 2.0) |
slow-tool | una lunga riga your app | correggere il proprio codice | 11.0 s (da 9.5 a 12.2) | 9.2 s (da 6.7 a 11.0) |
reasoning | molti più token di output rispetto alla risposta | ridurre il reasoning effort | 25.6 s per cinque risposte (da 19.0 a 31.8) | 10.2 s (da 7.9 a 12.1) |
Da dove partire quando un agente è lento?
Parti dal riepilogo in cima alla trace, che divide il wall time tra gateway e applicazione. Il wall time è il tempo di attesa dell’utente. “In the gateway” indica il tempo durante il quale almeno una richiesta al modello era aperta. “In your app” è tutto il resto: gli intervalli tra le richieste, in cui era in esecuzione soltanto il tuo codice. Include anche il tempo di rete tra il codice e il gateway, pari a qualche decimo di secondo per chiamata nelle esecuzioni di questa pagina.
Questa suddivisione indica dove guardare:
- Quasi tutto nel gateway, barre a gradini: le chiamate si aspettano a vicenda. Vedi il primo caso.
- Una quota rilevante nell’applicazione: il problema non è il modello. Vedi il secondo caso.
- Quasi tutto nel gateway, una barra lunga: una chiamata domina il tempo totale. Il riepilogo la indica come “slowest”. Vedi il terzo caso.
Per vedere l’effetto di una modifica, apri la trace precedente, seleziona Compare e scegli quella successiva. La console mostra le due esecuzioni sulla stessa pagina: ogni metrica con i valori A, B e la variazione, ogni chiamata abbinata a quella con lo stesso nome e i due waterfall sullo stesso asse temporale. Tutte le immagini di questa pagina mostrano questa vista.
Come riconoscere le chiamate eseguite in serie che potrebbero partire insieme?
Il waterfall ha un andamento a gradini: ogni barra inizia dove finisce la precedente. L’agente della demo esegue tre controlli su un messaggio del cliente (sentiment, policy e rischio), ciascuno con una risposta di una frase, usando DeepSeek V4.1 Flash. Nessun controllo dipende dal risultato degli altri, ma la versione con il problema li attende in un ciclo:
for span, question in CHECKS.items():        # each call waits for the one before it
    await check(run, span, question)
La correzione richiede una riga:
await asyncio.gather(*(check(run, span, q) for span, q in CHECKS.items()))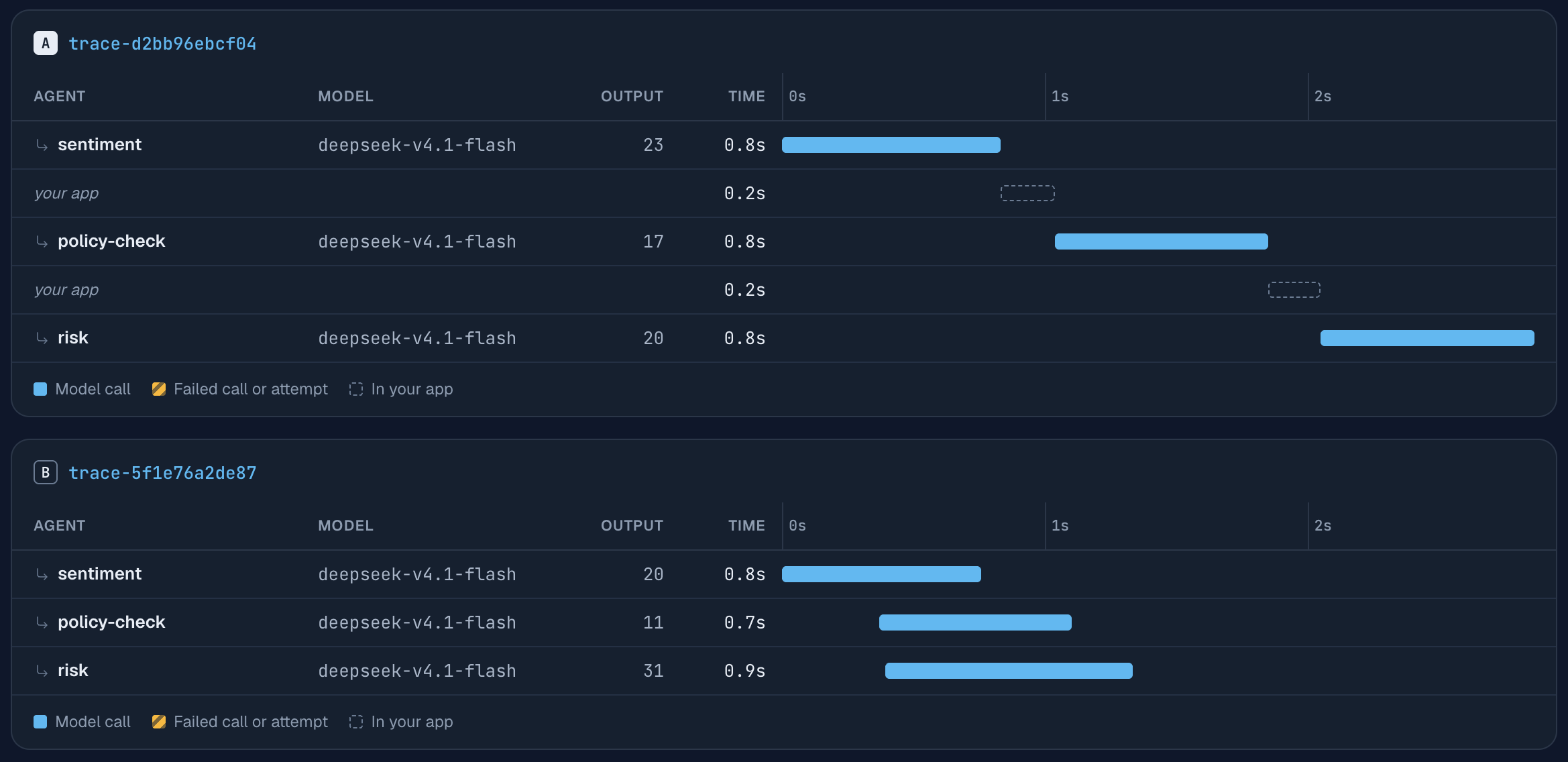
Nella trace A il wall time è 2.9 s: le tre chiamate durano 0.8 s ciascuna e vengono eseguite una dopo l’altra, con un intervallo di 0.2 s tra loro. Nella trace B le barre si sovrappongono e il wall time è 1.3 s. La tabella di confronto nella stessa pagina della console, sopra la parte mostrata qui, riporta un calo del wall time da 2.9 s a 1.3 s, pari al 53.4% (calcolato sui tempi non arrotondati). Per la stessa coppia lo script ha misurato 3.5 s e 1.5 s, perché conta anche l’apertura delle connessioni e il tempo di rete di ogni chiamata.
L’input è identico in entrambe le esecuzioni: 127 token. Il costo varia con l’output, la cui lunghezza cambia leggermente tra le esecuzioni: questa coppia è costata $0.000110 e $0.000112. Su cinque esecuzioni la mediana è stata $0.000105 per la versione seriale e $0.000109 per quella parallela. Le chiamate parallele inviano e ricevono gli stessi token, quindi il parallelismo non aumenta il costo.
Per verificare il tuo agente, considera ogni coppia di barre consecutive e chiediti se la seconda chiamata ha usato l’output della prima. Se non lo ha usato, le due chiamate possono sovrapporsi. Le chiamate che dipendono l’una dall’altra (un piano, poi il passaggio previsto dal piano) devono restare in sequenza.
Come capire se la parte lenta è nel tuo codice?
La riga your app è lunga. In questo caso, la versione con il problema risponde a una domanda dopo aver cercato il cliente in quattro tabelle, con una query alla volta. Ogni query è simulata da uno sleep di 1.1 s:
rows = [await lookup(t) for t in tables] # four queries, one at a timeAnche qui basta una riga per eseguire le quattro query insieme:
rows = await asyncio.gather(*(lookup(t) for t in tables))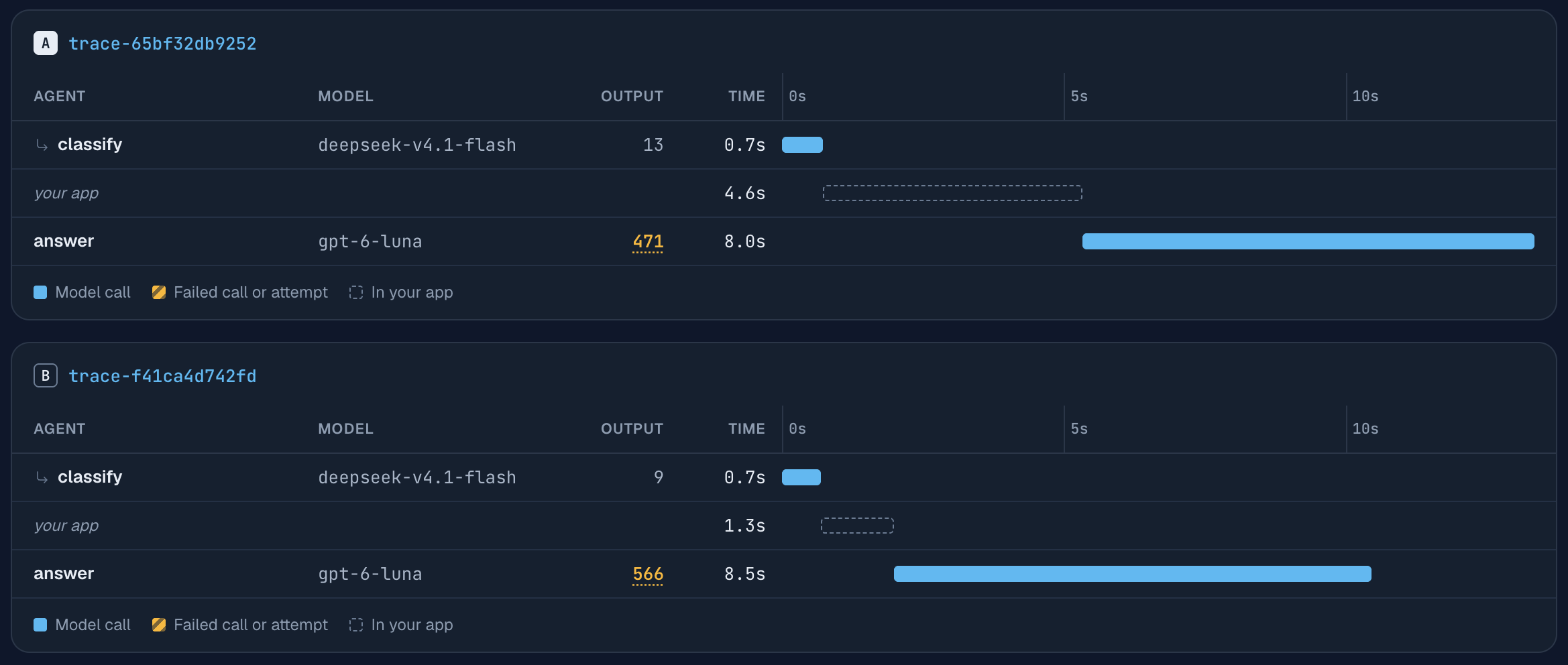
La riga interessata dalla correzione è passata da 4.6 s a 1.3 s. La tabella di confronto riporta una riduzione del 71.8% per “In your app”, anche qui calcolata sui tempi non arrotondati. Cambiare modello o prompt non avrebbe avuto alcun effetto su quella parte: nessuna richiesta al modello era aperta e l’agente stava aspettando le proprie query.
I tempi totali sono meno netti. In questa coppia il wall time è passato da 13.3 s a 10.5 s: un risparmio di 2.8 s a fronte di una correzione che ne vale 3.3 s. Il mezzo secondo mancante dipende dalla chiamata answer su GPT-6 Luna, che ha generato 471 token di output nella prima esecuzione e 566 nella seconda, impiegando rispettivamente 8.0 s e 8.5 s. Nelle cinque esecuzioni della tabella gli intervalli delle due versioni si sovrappongono: da 6.7 a 11.0 s dopo la correzione e da 9.5 a 12.2 s prima. Una singola esecuzione corretta può quindi essere più lenta di una singola esecuzione con il problema.
Per questo bisogna confrontare la riga modificata, non il totale di una sola esecuzione. La tabella per chiamata nella vista di confronto lo fa direttamente: abbina ogni chiamata alla sua controparte e mostra tempo, output e costo per A e B. Per dimostrare un miglioramento end-to-end, confronta la durata di molte trace di ciascuna variante. La latenza p95 in Logs (il tempo entro cui termina il 95% delle richieste) non mostrerà questa correzione. Misura le singole richieste, mentre qui il tempo risparmiato era tra una richiesta e l’altra.
Il gateway non può vedere cosa ha fatto il tuo codice durante l’intervallo, ma solo quanto è durato. Se l’intervallo è lungo e non sai perché, aggiungi span alle tue funzioni con OpenTelemetry.
E se la parte lenta fosse una sola chiamata al modello?
Guarda quanti token ha generato quella chiamata: è la generazione dell’output a richiedere tempo. Un modello con reasoning ragiona prima di rispondere. Quel ragionamento viene conteggiato nel costo e nel tempo come token di output, anche quando la risposta visibile è una sola frase. In questo caso, la versione con il problema pone a GPT-6 Luna cinque brevi domande sulle policy con l’istruzione “Rispondi in una frase”, lasciando il reasoning effort al valore predefinito. La versione corretta aggiunge un parametro:
await call(run, "answer", model=PLANNER_MODEL, messages=messages, reasoning_effort="none")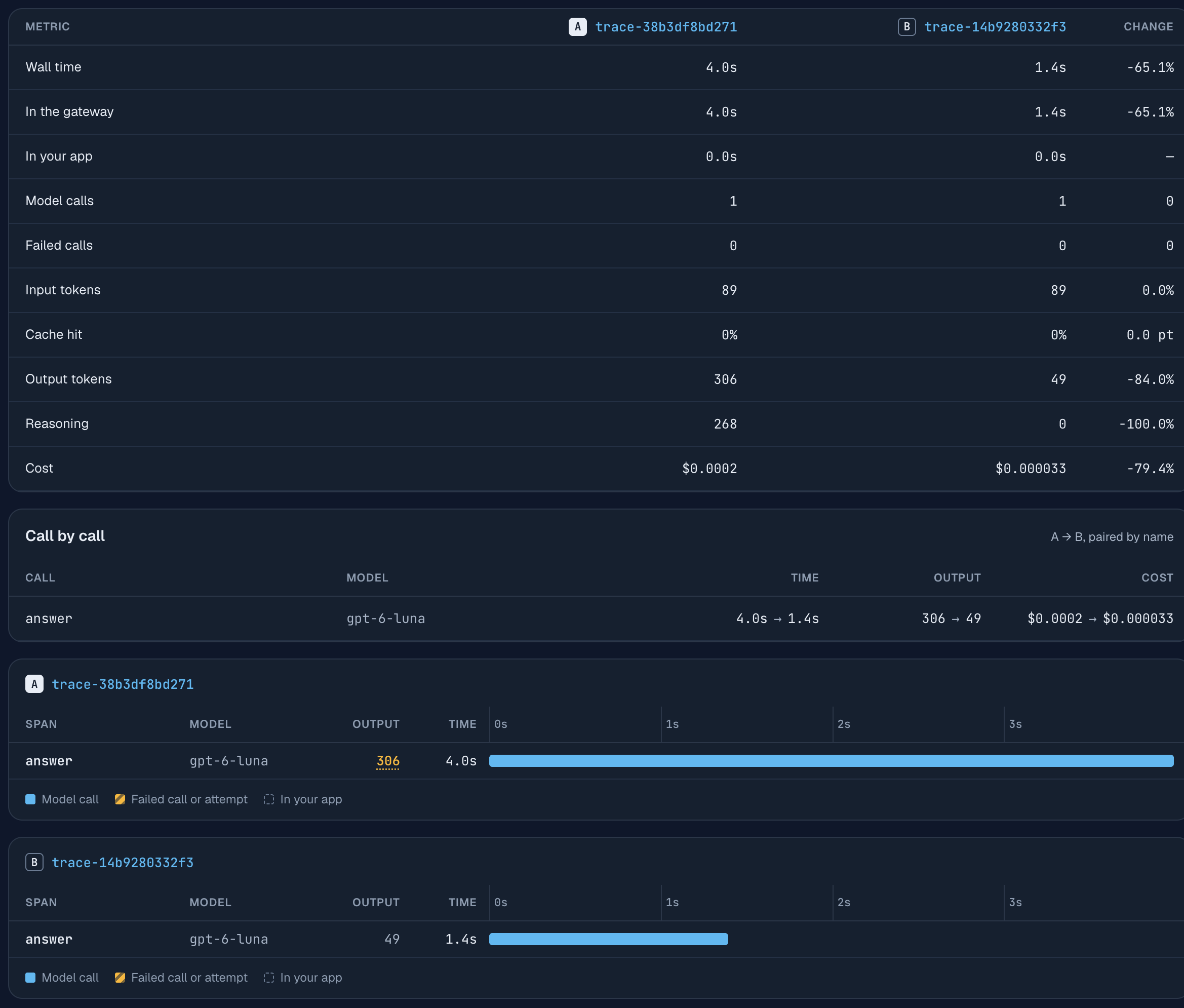
Questa è la prima delle cinque domande, prima e dopo la correzione. La risposta è una sola frase in entrambi i casi. Con l’effort predefinito il modello ha generato 306 token di output, di cui 268 di reasoning, impiegando 4.0 s. Con il reasoning disattivato ne ha generati 49 in 1.4 s. Il costo della chiamata è sceso da $0.00016, arrotondato dalla console a $0.0002, a $0.000033.
| Cinque risposte di una frase (mediana di cinque esecuzioni, quattro per la seconda riga) | Tempo | Token di output | Costo |
|---|---|---|---|
| reasoning effort predefinito | 25.6 s | 1,150 | $0.000614 |
reasoning_effort="none" | 10.2 s | 190 | $0.000134 |
Non serve il confronto per individuare questo problema. Il waterfall ha una colonna Output: quando l’output è consistente e costituito per la maggior parte da reasoning, il conteggio viene sottolineato, come per i 306 token qui sopra. Selezionando la chiamata, il pannello mostra i token di reasoning su una riga separata sotto quelli di output.
Disattivare il reasoning è adatto a passaggi come questi: ricerche di dati, classificazione, riformulazione del risultato di un tool. Non è adatto ai passaggi che richiedono un ragionamento articolato, che questa demo non verifica. Le nostre misurazioni di GPT-6 Luna riportano i token di reasoning e il costo per risposta a ogni impostazione; la guida al reasoning effort elenca i valori accettati da ciascun modello. Modifica il parametro per singolo passaggio e verifica le risposte prima e dopo.
Cosa non copre questa pagina?
Restano fuori due aspetti. Il primo è la velocità percepita della risposta. Lo streaming non riduce la durata di una chiamata, ma mostra prima il testo all’utente. Per una risposta in chat, spesso è questo che conta. Il pannello della chiamata include il campo First token per misurarlo. In queste trace è vuoto perché la demo non usa lo streaming.
Il secondo sono le cause esterne all’agente: un provider lento in quel momento oppure un rate limit che costringe il client ad aspettare e riprovare. Si presentano come una barra lunga o una chiamata fallita seguita da un retry. Modificare la struttura del codice non le risolve.
FAQ
Come trovo il passaggio più lento di un agente LLM?
Apri la trace dell’esecuzione e leggi il riepilogo: indica la chiamata più lenta e divide il wall time tra gateway e applicazione. Il waterfall sottostante mostra ogni chiamata come una barra. Il passaggio da esaminare è quello con la barra più lunga o con la riga your app più lunga.
Le chiamate LLM parallele costano più di quelle seriali?
No. Nella demo, il costo mediano dei tre controlli è stato $0.000105 in serie e $0.000109 in parallelo, con gli stessi 127 token di input. La differenza dipende dalla lunghezza dell’output, che varia tra le esecuzioni. Il costo dipende dai token e le chiamate parallele inviano e ricevono gli stessi token. Il limite da tenere d’occhio è il rate limit, perché le chiamate parallele arrivano tutte insieme.
Perché una chiamata al modello è lenta anche se la risposta è breve?
Di solito perché il modello ha prima ragionato. Il reasoning viene generato come token di output che non compaiono nella risposta. Cinque risposte di una frase su GPT-6 Luna hanno usato una mediana di 1,150 token di output con il reasoning effort predefinito e 190 con reasoning_effort="none".
Come misuro se una correzione ha reso l’agente più veloce?
Confronta la parte modificata, non un singolo tempo totale. Nella demo, eseguire quattro query insieme ha ridotto il tempo nel codice da 4.6 s a 1.3 s. Il wall time delle singole esecuzioni dopo la correzione variava invece da 6.7 s a 11.0 s, per la variabilità di una chiamata al modello. Confronta molte esecuzioni di ogni versione usando la durata delle trace.
Il gateway può mostrare cosa ha fatto il mio codice tra due chiamate al modello?
Mostra la durata dell’intervallo con una riga your app, ma non cosa è successo al suo interno. Per creare span nel tuo codice, usa un SDK OpenTelemetry e inoltra il suo header traceparent, così entrambe le viste condividono lo stesso ID di trace.
Letture correlate
- Tracciare un agente LLM: gli header e il waterfall usati in questa pagina.
- Perché il mio agente LLM costa tanto?: lo stesso metodo applicato ai costi.
- Fare debugging di un agente LLM: dalla segnalazione di un utente alla chiamata che ha causato il problema.
- Costo di Claude Code per subagente: le stesse viste per un agente di coding che non hai scritto tu.
- Chiedere a Claude informazioni sui log LLM: domande sui log delle richieste, con risposte tramite MCP.
- Dare all’agente tool per leggere i log: leggere gli stessi log con un proprio programma e misurare il costo dei token del modello.
- GPT-6 Luna vs GPT-5.6 Luna: token di reasoning e costo per risposta a ogni livello di effort.