
Perché il mio agente LLM costa tanto? Quattro cause in una trace
Quattro cause di costi elevati, riprodotte e corrette: timestamp che blocca la cache (hit da 0% a 73%), contesto crescente, loop di retry e modello sbagliato.
Le nostre scelte
prezzi live| Modello | Verdetto | Prezzo |
|---|---|---|
| GPT-6 Luna Con il timestamp spostato dalla prima riga del prompt, 4,157 dei 5,729 token di input distribuiti su quattro turni sono stati letti dalla cache con un avvio a freddo. Con il timestamp in prima posizione, nessuno dei 5,579 token è stato letto dalla cache. | Agente principale nella demo | da $0.1/M |
| DeepSeek V4.1 Flash Tre verifiche di una frase ciascuna sono costate $0.0010 su GPT-6.1 Sol e $0.0001 su questo modello. | Sottoagente nella demo | da $0.3/M |
Indice
- Da dove partire se il costo è più alto del previsto?
- Perché il tasso di cache hit è zero?
- Perché ogni turno invia più dati del precedente?
- Come si presenta un loop di retry?
- Come individuare un modello costoso che svolge un compito semplice?
- FAQ
- Come scoprire quale parte del mio agente LLM costa di più?
- Perché il tasso di cache hit del mio prompt è 0%?
- Perché il primo turno di una conversazione non trova nulla in cache?
- La cache dei prompt rende gratuita una cronologia lunga?
- Quanto si risparmia con la cache dei prompt?
- Un loop di retry compare tra gli errori?
- Letture correlate
Il costo di un agente cresce per ragioni che una singola richiesta non rivela: un prompt che non trova mai riscontro nella cache, una conversazione che reinvia sempre più dati a ogni turno, un loop che ripete lo stesso lavoro o un modello costoso impiegato per un compito alla portata di uno più economico. Tutti questi problemi diventano evidenti quando le chiamate vengono raggruppate in sessioni e trace. Questa guida li riproduce in un piccolo agente di assistenza, mostra dove individuarli nella console Synthorai, li corregge e confronta i costi prima e dopo.
TL;DR
- Un timestamp nella prima riga del prompt manteneva il tasso di cache hit allo 0%. Spostandolo alla fine, il tasso è salito al 73% e il costo dell’input su GPT-6 Luna è sceso del 66%.
- Una cronologia che reinviava tutti i risultati dei tool consumava il triplo dei token di input, ma costava solo il 21% in più per l’input, perché il 71% veniva letto dalla cache.
- Un loop di retry eseguiva 10 chiamate al modello quando ne bastavano 2, tutte con status 200.
- Tre chiamate di un sub-agent su GPT-6.1 Sol rappresentavano l’81% del costo di una sessione.
Questa guida prosegue da Tracciare un agente LLM, che descrive gli header delle richieste usati per raggruppare le chiamate in sessioni e trace. Configura la demo come indicato in quella guida (Python 3.10 o successivo, virtualenv attivo), poi esegui i quattro casi e replay-mismatch (un altro modo per perdere i vantaggi della cache) dalla stessa directory di github.com/synthorai-io/use-cases:
cd use-cases/agent-tracing
python incidents.py cache-miss context-growth replay-mismatch retry-loop wrong-model
Ogni caso viene eseguito due volte, prima con il problema e poi con la correzione, e contrassegna le chiamate con case e variant. I numeri provengono da una singola esecuzione di ciascun caso dell’11 ottobre 2026. Sono frazioni di centesimo perché la demo è molto piccola. Su un carico reale, contano i rapporti tra i valori.
| Caso | Dove si vede | Prima | Dopo |
|---|---|---|---|
cache-miss | Cache hit per turno nella pagina della sessione | 0% dalla cache, $0.0015 | 73% dalla cache con avvio a freddo (cache ancora vuota), $0.0011 |
context-growth | Input per turno in aumento scorrendo la pagina della sessione | 24,546 token di input, $0.0011 di costo dell’input | 8,053 token di input, $0.0009 di costo dell’input |
replay-mismatch | Cache hit fermo allo 0% nella pagina della sessione | 0% dalla cache, $0.0038 | 76% dalla cache, $0.0015 |
retry-loop | Una trace con molte più chiamate di quelle necessarie per un turno | 10 chiamate, $0.0004 | 2 chiamate, $0.0001 |
wrong-model | Tabella degli agenti nella pagina della sessione | $0.0012 | $0.0003 |
Da dove partire se il costo è più alto del previsto?
Parti dall’elenco Traces, ordinato per costo. Ogni riga rappresenta una sessione o una trace e riporta numero di chiamate, durata e costo. Le conversazioni più costose finiscono così in cima. Aprine una per capire quale dei problemi descritti sotto presenta.
Se contrassegni le richieste con X-Synthorai-Metadata, filtra prima l’elenco. Il campo di ricerca di Traces accetta un’etichetta: metadata.feature = support-agent lascia solo sessioni e trace di una funzionalità, mentre metadata.case = cache-miss trova entrambe le esecuzioni di un caso di questa pagina. Per i totali, la scheda Breakdown di Analytics contiene il riquadro Cost by metadata: scegli una chiave e vedrai richieste, token di input e costo per ciascun valore.
Perché il tasso di cache hit è zero?
Il tasso di cache hit è zero quando qualcosa all’inizio del prompt cambia a ogni richiesta. La cache dei prompt permette al provider di addebitare la parte iniziale ripetuta a una frazione del prezzo dell’input, ma solo fino al primo token diverso rispetto alla richiesta precedente. La versione difettosa di questo caso inserisce l’ora corrente nella prima riga di un prompt di sistema di circa 1,300 token:
# The clock is the first line, so the prompt differs from its first token on every turn.
system = f"Current time: {now}\n\n{SYSTEM}\n\n{MANUAL}"
In una conversazione di quattro turni su GPT-6 Luna, la pagina della sessione riporta Cache hit 0%: 0 token di input su 5,579. La correzione sposta in fondo la parte variabile:
# Stable text first, the part that changes last.
system, user = f"{SYSTEM}\n\n{MANUAL}", f"{text}\n\n(Current time: {now})"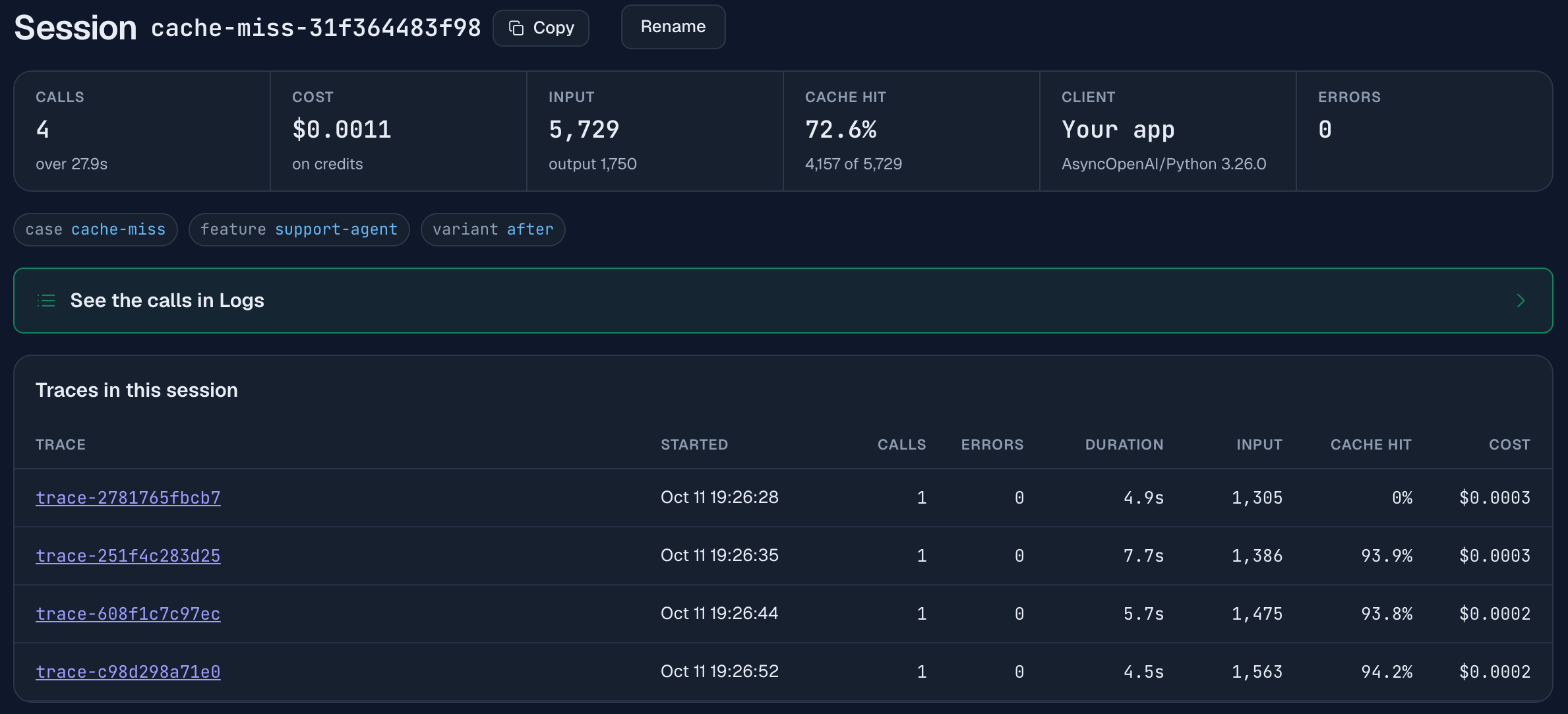
La pagina della sessione elenca l’input e il cache hit di ogni turno; la prima riga mostra 0%. Il primo turno non può leggere una voce che nessuna richiesta ha ancora scritto: la crea, senza leggere nulla dalla cache. I tre turni successivi leggono dalla cache 1,302, 1,383 e 1,472 token, quasi tutto ciò che il turno precedente aveva inviato. Ciascuno legge quindi dalla cache circa il 94% del proprio input. Sull’intera conversazione sono 4,157 token di input su 5,729, cioè il 73%.
Il risparmio riguarda l’input. Questo modello addebita $0.10 per milione di token di input, $0.125 per i token scritti nella cache e $0.01 per quelli letti dalla cache. Quasi tutti i token di un prompt lungo rientrano in una delle ultime due categorie.
L’esecuzione difettosa ha scritto 5,567 token nella cache senza leggerne nessuno. Quella corretta ne ha scritti 1,560 e letti 4,157: il costo dell’input è sceso da $0.00070 a $0.00024, una riduzione del 66%. Il costo della sessione è passato da $0.0015 a $0.0011. Il calo è inferiore a quello del solo input perché l’output rappresenta la quota maggiore del costo e, in questa esecuzione, la versione corretta ne ha prodotto di più (1,750 token contro 1,599).
Il risparmio dipende da ciò che è già in cache all’inizio della conversazione. Questa esecuzione è partita a freddo, quindi il primo turno non ha letto nulla. Un agente con traffico costante dovrebbe superare il 73%: ogni conversazione inizia con lo stesso prompt di sistema e trova ancora la voce della conversazione precedente, purché le richieste arrivino prima che scada. Un prompt usato da una sola conversazione paga il prezzo di scrittura al primo turno.
Il timestamp è il caso classico. Un ID della richiesta, un saluto casuale, un nome utente inserito nel primo paragrafo o le definizioni dei tool in un ordine diverso producono lo stesso effetto. Per un cache hit devono valere altre due condizioni: il prefisso stabile (l’inizio invariato del prompt) deve superare la lunghezza minima del provider (1,024 token per la maggior parte; vedi cache dei prompt) e le chiamate di una conversazione dovrebbero avere lo stesso X-Session-Id, che il gateway usa per mantenere coerenti i cache hit della conversazione.
Perché ogni turno invia più dati del precedente?
Ogni turno invia più dati perché la conversazione reinvia ogni volta la propria cronologia. Una certa crescita è normale: la cronologia si allunga. Nella versione difettosa di questo caso cresce molto più rapidamente. A ogni turno l’agente cerca i dati del cliente, riceve circa 1,100 token di cronologia degli ordini in JSON e conserva il risultato nella cronologia. Il sesto turno contiene quindi sei copie di dati quasi identici.
if variant == "before":
    history += [lookup_result]               # every old lookup is sent again on every later turn
history += [{"role": "user", "content": text}, {"role": "assistant", "content": reply}]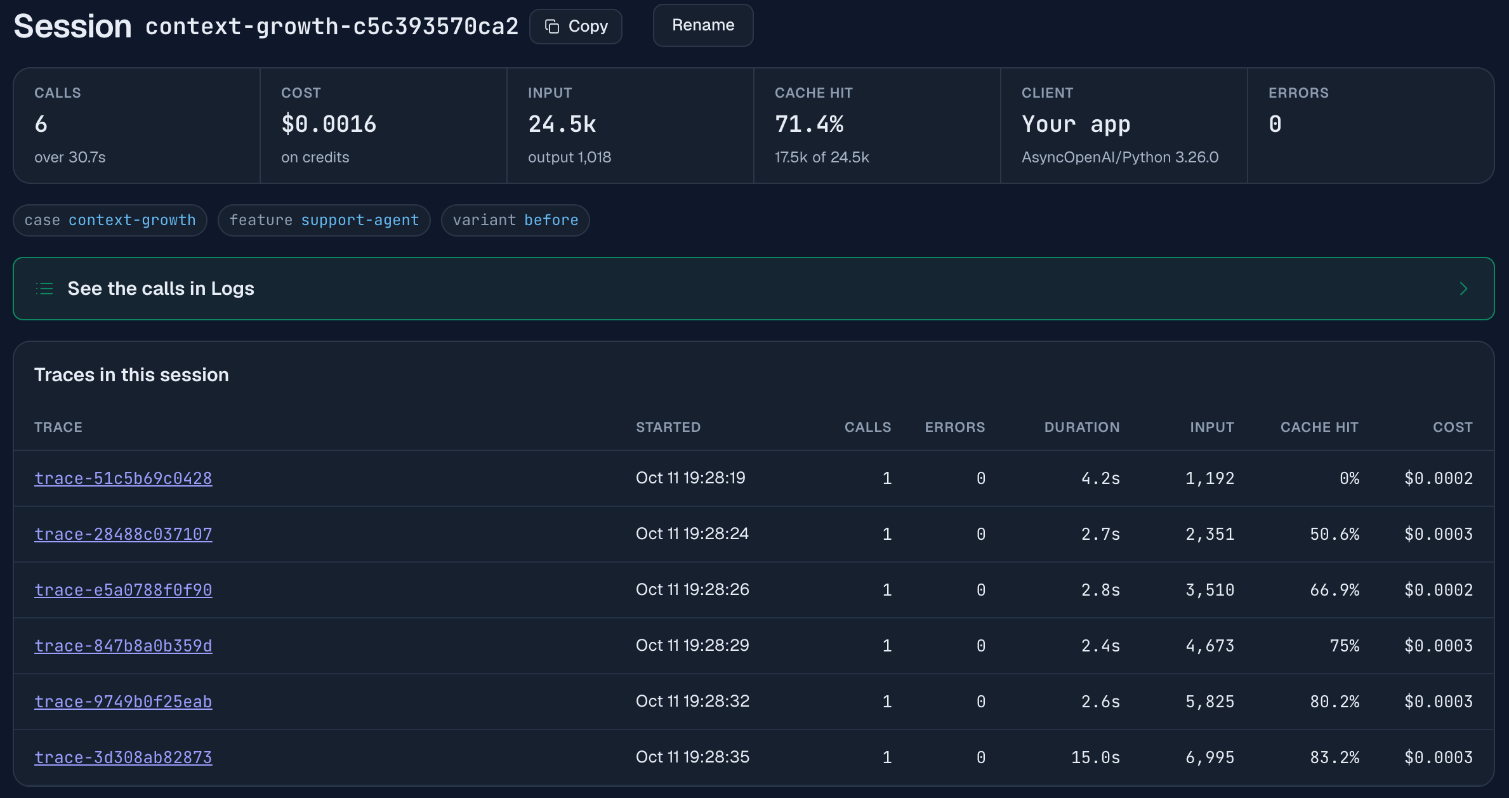
Il segnale è nella colonna Input della tabella “Traces in this session”: aumenta di circa 1,160 token a turno, da 1,192 al primo a 6,995 al sesto, mentre le risposte restano lunghe due frasi. I sei turni hanno usato 24,546 token di input. Nella versione corretta il turno corrente riceve comunque dati aggiornati, ma i risultati precedenti non vengono conservati: la risposta dell’assistente ha già registrato le informazioni rilevanti. I sei turni usano così 8,053 token di input, un terzo rispetto a prima.
Le due colonne accanto a Input spiegano perché il problema passa inosservato. Cache hit cresce insieme all’input e il costo per turno resta tra $0.0002 e $0.0003. Ogni turno inizia con l’intero prompt del turno precedente, quindi il provider legge quella parte dalla cache: 17,536 token di input su 24,546, il 71%. L’input della sessione difettosa è costato $0.0011, contro $0.0009 di quella corretta: il triplo dei token di input per un costo dell’input superiore del 21%.
In questo confronto, i totali delle sessioni non mostrano affatto il beneficio della correzione. La sessione difettosa è costata $0.0016 e quella corretta $0.0017, perché quest’ultima ha prodotto più output (1,756 token contro 1,018). L’output aggiuntivo è costato circa $0.0004, più dei $0.0002 risparmiati sull’input. Confronta le colonne Input e Cache hit, sulle quali agisce la correzione, non il totale di una singola sessione.
La cache dei prompt può quindi assorbire gran parte del costo di una cronologia crescente. Ci sono però tre cose che non fa:
- Non riduce il contesto. Il sesto turno invia comunque 6,995 token. Una sessione lunga raggiunge lo stesso il limite di contesto del modello, e un token letto dalla cache viene comunque addebitato, alla tariffa della cache.
- Funziona solo se la cronologia viene reinviata esattamente com’era stata inviata. La demo include il caso
replay-mismatch: a ogni messaggio utente viene aggiunta un’istruzione al momento dell’invio, ma il messaggio viene salvato senza quell’istruzione. Ogni turno ricostruisce quindi un prompt che il turno precedente non ha mai inviato. Quella conversazione ha letto dalla cache 0 token di input su 24,557 ed è costata $0.0038. Salvando il messaggio esattamente come inviato, si è passati a 18,844 token su 24,702, cioè il 76%, e a $0.0015. - Non è disponibile su tutti i modelli. Alla tariffa piena dell’input di GPT-6 Luna, il modello di questo caso, 24,546 token costano $0.0025, contro circa $0.0011 addebitati con la cache. Controlla la colonna Cache hit prima di farci affidamento.
Per il tuo agente: i risultati dei tool sono di solito la parte più voluminosa della cronologia e la meno utile da reinviare. Conserva la risposta che li ha usati, oppure un riepilogo di una riga, ed elimina il payload grezzo. Risparmierai su qualsiasi modello, con o senza cache. La nostra guida ai chatbot descrive la soluzione generale: comprimere i vecchi turni in un riepilogo.
Come si presenta un loop di retry?
Si presenta come una trace con molte più chiamate del necessario per un turno, con gli stessi nomi di span ripetuti. In questo caso l’API di tracciamento del corriere non funziona. L’agente chiama il tool, riceve un timeout e risponde che non può vedere dove si trova il pacco. Il codice controlla poi se la risposta indica una posizione del pacco. Non trovandola, esegue di nuovo l’intero turno, fino a cinque volte:
if "sorting" in reply or "out for delivery" in reply:
    break                                    # the reply names a parcel location
if variant == "after" and (tool_failed or not results):
    break                                    # a retry cannot help while the tool is down or unused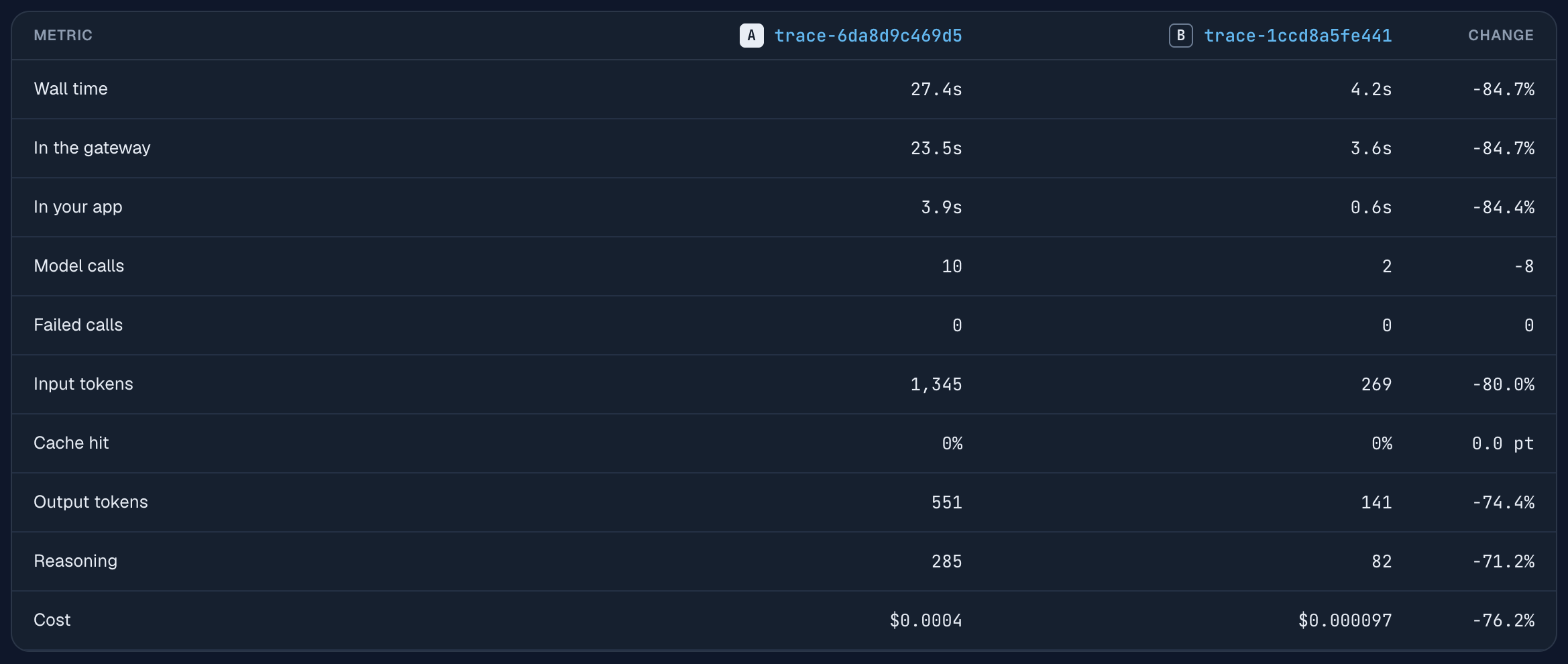
Questa è la vista Compare delle due esecuzioni: apri una trace, seleziona Compare e scegli l’altra. L’esecuzione difettosa ha effettuato 10 chiamate al modello in 27.4 s, per $0.0004, e alla fine il cliente ha comunque ricevuto la stessa risposta. “Failed calls” è 0 in entrambi i casi. Tutte le chiamate del loop sono riuscite con status 200, quindi qui non compare alcun errore. La versione corretta distingue un errore del tool da una risposta inadeguata e non ritenta quando il problema è il tool: 2 chiamate, 4.2 s, $0.0001.
Nel waterfall dell’esecuzione difettosa, le chiamate si chiamano plan-1, answer-1, plan-2, answer-2 e così via. Assegna agli span nomi che riportino il passaggio e il tentativo, come in questo esempio: il loop si riconosce a colpo d’occhio. Per trovare loop di cui non sei a conoscenza, ordina l’elenco Traces per numero di chiamate.
Come individuare un modello costoso che svolge un compito semplice?
Guarda la tabella “Agents in this session”, che suddivide le chiamate e il costo della sessione per agente. Nella versione difettosa di questo caso, i tre controlli di una frase ciascuno del sub-agent vengono eseguiti su GPT-6.1 Sol, un modello che costa $2 per milione di token di input e $10 per milione di token di output. L’agente principale risponde invece su GPT-6 Luna:
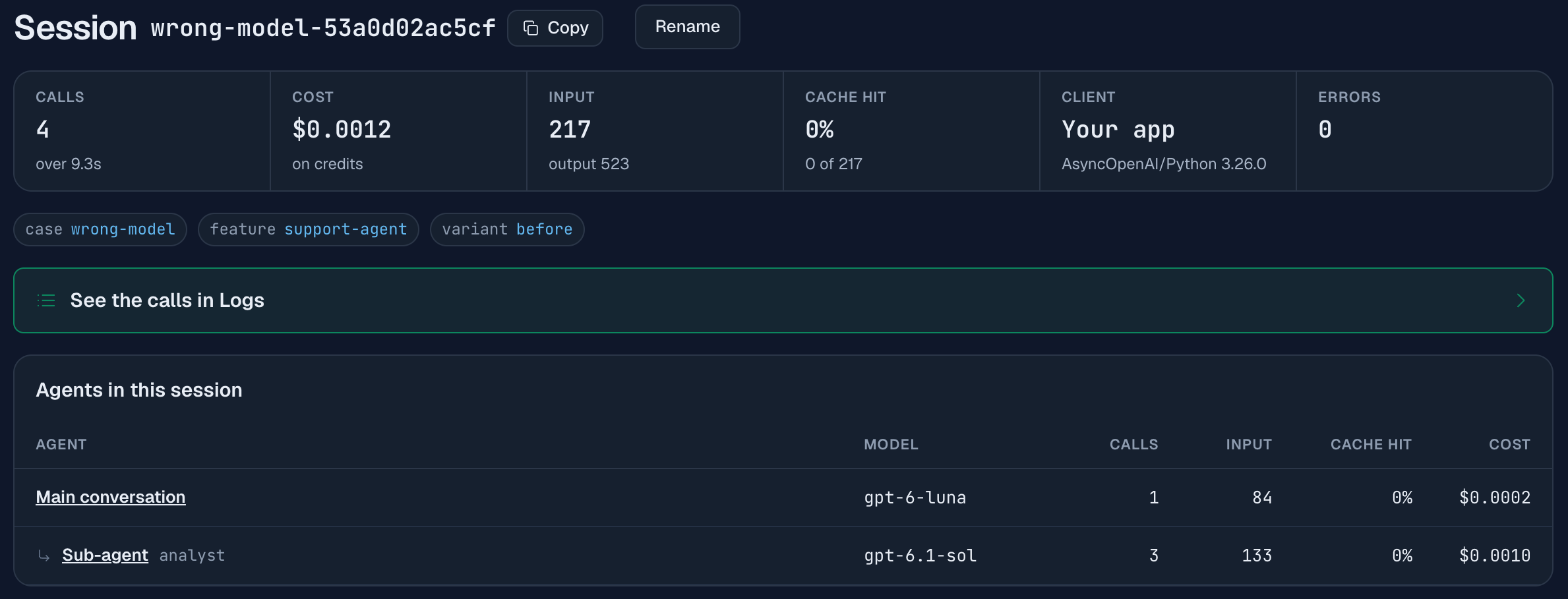
Le tre chiamate del sub-agent costano $0.0010 sui $0.0012 della sessione: l’81% del totale per il lavoro meno impegnativo dell’esecuzione. Gli stessi tre controlli su DeepSeek V4.1 Flash costano $0.0001 e portano il totale della sessione a $0.0003. Entrambe le versioni eseguono i controlli con il reasoning disattivato, quindi la differenza dipende dal prezzo del modello.
Questo caso misura solo il costo. Non abbiamo valutato la qualità dei controlli, e un modello più economico è la scelta giusta solo se le sue risposte sono adeguate a quel passaggio. La tabella mostra dove va la spesa, così sai quale passaggio conviene provare su un modello meno costoso.
La suddivisione compare quando le chiamate dei sub-agent includono X-Agent-Id. Senza questo header, la tabella “Models in this session” mostra la ripartizione per modello, che coincide con quella per agente solo se ogni agente usa un modello distinto. Per vedere un singolo agente su tutte le sessioni, la scheda Breakdown di Analytics contiene il riquadro Cost by agent.
FAQ
Come scoprire quale parte del mio agente LLM costa di più?
Raggruppa le chiamate in sessioni e trace tramite gli header delle richieste, poi ordina l’elenco Traces per costo e apri la prima voce. La pagina della sessione suddivide il costo per agente, modello e turno: basta per distinguere un problema di cache da uno di contesto o di scelta del modello.
Perché il tasso di cache hit del mio prompt è 0%?
La causa più comune è un valore variabile all’inizio del prompt, come un timestamp. La cache copre solo la parte del prompt che precede il primo token diverso. Nella demo, spostare il timestamp dalla prima riga del prompt di sistema alla fine del messaggio utente ha portato il tasso di cache hit da 0% a 73% con un avvio a freddo.
Perché il primo turno di una conversazione non trova nulla in cache?
Perché una voce di cache viene scritta da una richiesta, e il primo turno è proprio quella richiesta. Nella demo, i quattro turni di una conversazione hanno letto dalla cache rispettivamente 0%, 93.9%, 93.8% e 94.2% del loro input. Il primo turno legge dalla cache solo se una conversazione precedente ha inviato lo stesso prefisso abbastanza di recente da avere ancora la voce disponibile.
La cache dei prompt rende gratuita una cronologia lunga?
No, ma può nascondere gran parte del costo. Nella demo, una conversazione che reinviava tutti i vecchi risultati dei tool usava il triplo dei token di input della versione alleggerita (24,546 contro 8,053), ma il suo input costava solo il 21% in più perché il 71% veniva letto dalla cache. I token occupano comunque la finestra di contesto e lo sconto scompare appena la cronologia reinviata differisce da quella inviata in precedenza. Nel caso replay-mismatch della demo, un messaggio salvato in forma diversa da quella inviata ha portato la conversazione allo 0% di cache hit e a un costo più che doppio.
Quanto si risparmia con la cache dei prompt?
Dipende dal prezzo dell’input letto dalla cache per quel modello e da quanto pesa l’input sul costo totale. Nella demo su GPT-6 Luna, leggere dalla cache il 73% dell’input di una conversazione ha ridotto il costo dell’input del 66%. La sessione è costata $0.0011 contro $0.0015 senza cache. I token di output rappresentavano la maggior parte del costo e la cache non li modifica.
Un loop di retry compare tra gli errori?
Non necessariamente. Nella demo, tutte le chiamate del loop hanno restituito status 200. Il loop era visibile come una trace con 10 chiamate quando ne bastavano 2: controlla quindi il numero di chiamate per trace, non solo il tasso di errore.
Letture correlate
- Tracciare un agente LLM: gli header, le sessioni e le etichette su cui si basa questa pagina.
- Perché il mio agente LLM è lento?: lo stesso metodo applicato alla latenza.
- Fare debug di un agente LLM: dalla segnalazione di un utente alla chiamata che ha causato il problema.
- Costo di Claude Code per sub-agent: la stessa vista delle sessioni per un agente di sviluppo, in cui le scritture in cache rappresentano il 77% di un’esecuzione.
- Interrogare Claude sui log LLM: trovare tramite MCP la più costosa di queste sessioni.
- Dare al proprio agente strumenti per leggere i log: leggere gli stessi log con un proprio programma e calcolare il costo dei token del modello.
- Cache dei prompt: lunghezze minime dei prefissi e prezzi per provider.
- Il miglior LLM per ogni caso d’uso: costi in base alle caratteristiche del carico, per scegliere il modello di ogni passaggio.