
GPT-6 Luna vs GPT-5.6 Luna: metà prezzo, metà parole
Indice
- Come si confronta GPT-6 Luna con GPT-5.6 Luna nei benchmark?
- Cos’altro è cambiato oltre al prezzo?
- Come abbiamo condotto il test?
- GPT-6 Luna scrive meno di GPT-5.6 Luna?
- GPT-6 Luna omette informazioni?
- Come ottenere la lunghezza e i dettagli mancanti?
- Quanto si risparmia con GPT-6 Luna rispetto a GPT-5.6 Luna?
- I nostri risultati coincidono con gli altri test pubblicati?
- Cosa abbiamo osservato e quale modello conviene usare?
- FAQ
GPT-6 Luna è alla pari con GPT-5.6 Luna nei benchmark pubblici (38 contro 37 nell’Artificial Analysis Intelligence Index) e costa circa la metà per task. Cambia ciò che scrive: quando il prompt indica solo un obiettivo («scrivi la review del Q3»), GPT-6 Luna produce 0.55x le parole su 80 documenti aziendali. Non omette le parti richieste. Quando il prompt le elenca, i due modelli sono altrettanto completi. L’unico dettaglio che GPT-6 Luna omette più spesso nei prompt con il solo obiettivo è la durata di un incidente.
TL;DR
- Artificial Analysis assegna a GPT-6 Luna 38 punti e a GPT-5.6 Luna 37 con effort
max, a $0.07 contro $0.18 per task. - Con prompt che indicano solo l’obiettivo, GPT-6 Luna scrive 384 parole per documento contro le 703 di GPT-5.6 Luna.
- GPT-6 Luna omette la durata dell’incidente in 9 postmortem su 20 con prompt che indicano solo l’obiettivo; GPT-5.6 Luna in 2.
- Quando il prompt elenca le parti richieste, GPT-6 Luna produce 74 documenti completi su 80 contro 69, a $0.81 contro $1.61 per 1.000.
Come si confronta GPT-6 Luna con GPT-5.6 Luna nei benchmark?
Nei benchmark generali GPT-6 Luna è alla pari con GPT-5.6 Luna e costa il 48%-61% in meno per task. I risultati divergono solo nei documenti valutati con una rubric, cioè una checklist di criteri. I punteggi si riferiscono a uno specifico reasoning effort: l’impostazione API che regola quanto il modello ragiona prima di rispondere (da none a max, con medium come valore predefinito). I dati sono stati rilevati dalle pagine degli editori il 2026-10-02.
| GPT-6 Luna | GPT-5.6 Luna | |
|---|---|---|
| Data di rilascio | 2026-09-22 | 2026-07-09 |
| Prezzo di listino, input / output per 1M token | $0.10 / $0.50 | $0.20 / $1.20 |
| Artificial Analysis Intelligence Index v4.3.2 con effort max (10 valutazioni: conoscenza, ragionamento, coding, task agentici e documenti aziendali) | 38 | 37 |
| Costo per task dell’indice | $0.07 | $0.18 |
| Vals Index (coding, ambito legale, fiscale, finanziario e altri task professionali) | 51.2% | 51.7% |
| Costo per test Vals | $0.43 | $0.82 |
| GDPval-AA v2.1 Elo con effort max (documenti aziendali valutati con una rubric non pubblica; Elo è un punteggio basato su confronti diretti, più alto è meglio) | 1438 | 1463 |
| GDPval-AA v2.1 Elo con effort medium | 1262 | 1133 |
| Velocità di output, token al secondo | 131 | 124 |
Le critiche a GPT-6 Luna sono partite da GDPval-AA. Nella sua analisi al lancio, Artificial Analysis collocava GPT-6 Luna circa 75 punti Elo sotto GPT-5.6 Luna su GDPval-AA e circa 45 sotto su AA-Briefcase v1.1, un secondo benchmark sui documenti. Attribuiva il divario a «una qualità di presentazione inferiore e a documenti che omettono elementi della rubric»; i valutatori lo chiamavano «format tax». Ora la classifica mostra un distacco di 25 punti con effort max, mentre con medium GPT-6 Luna è avanti di 129 punti.
Rispetto ai modelli di altri vendor, GPT-6 Luna compete con la fascia flash: modelli economici e veloci. Nello stesso indice, DeepSeek V4.1 Flash con effort max ottiene 39 punti a $0.27 per task e Gemini 3.8 Flash con effort high ne ottiene 41 a $1.24. GPT-6 Luna rinuncia quindi a 1-3 punti, ma costa da 4 a 18 volte meno per task. Entrambi generano più velocemente, a 209 e 249 token al secondo.
Cos’altro è cambiato oltre al prezzo?
GPT-6 Luna mantiene i limiti e le impostazioni di GPT-5.6 Luna; cambiano solo il prezzo della cache e la data limite delle conoscenze. Entrambi hanno una finestra di contesto da 1,050,000 token e un limite di output di 128,000 token. Quando il prompt supera 272K token, l’intera richiesta viene fatturata a 2x per l’input e 1.5x per l’output. L’input in cache costa $0.01 per milione di token, contro $0.02, e la data limite delle conoscenze passa dal 16 febbraio al 18 maggio 2026. Nella Responses API l’effort si imposta con reasoning.effort (none, low, medium, high, xhigh, max); il ragionamento non è visibile e viene fatturato come token di output.
Una settimana dopo il lancio, OpenAI ha rilasciato GPT-6.1 Sol come successore di GPT-6 Sol nella fascia superiore. Nelle nostre misurazioni di GPT-6.1 Sol, le risposte sono tornate alla lunghezza precedente. Luna non ha ricevuto aggiornamenti, quindi abbiamo misurato quali testi GPT-6 Luna accorcia, cosa omette e come ottenere di nuovo i dettagli.
Come abbiamo condotto il test?
Abbiamo preparato task documentali con requisiti verificabili via codice, senza usare un modello come giudice. Ogni task fornisce al modello un blocco di dati sintetici e chiede di ricavarne un documento:
| Documento | Dati | Cosa si aspetta di trovare chi legge |
|---|---|---|
| Review trimestrale | ricavi di 6-12 regioni | tutte le regioni e l’indicazione di quella con il calo maggiore |
| Postmortem di un incidente | 7-10 eventi con timestamp | tutti gli eventi e la durata dell’incidente |
| Confronto tra vendor | 5-8 preventivi di hosting | tutti i vendor |
| Risposte ai clienti | 6-14 ticket di supporto | una risposta per ogni ticket, rivolta al cliente per nome |
Ogni task usa gli stessi dati con due tipi di prompt. Il prompt con il solo obiettivo specifica quale documento produrre, senza indicarne le parti («Scrivi la review regionale del Q3 per il team dirigente»); la valutazione considera solo gli elementi della tabella. Il prompt con le parti esplicite elenca sezioni, quantità e intervalli di parole; la valutazione considera tutti questi requisiti. Un documento è completo se non manca nulla, nessuna parte è troppo breve e tutti gli elementi richiesti sono presenti. Nei confronti tra vendor con il solo obiettivo valutiamo solo la lunghezza, perché scegliere il vendor migliore richiede un giudizio.
Il 2026-10-02 abbiamo eseguito gli 80 task con il solo obiettivo su entrambi i modelli a cinque livelli di effort e su GPT-6 Luna con un’impostazione di verbosity. Abbiamo poi eseguito gli 80 task con le parti esplicite su entrambi i modelli con l’effort predefinito: 1,040 chiamate alla Responses API. Ogni prompt conteneva una stringa casuale univoca, per evitare risposte dalla cache; i costi sono calcolati sui prezzi di listino OpenAI. I due modelli hanno risposto agli stessi task, quindi usiamo un test di McNemar esatto, un test appaiato sui casi in cui i modelli differiscono, con correzione di Holm, che rende più severa la soglia quando si verificano più confronti. Chiamiamo differenze solo i divari che restano significativi dopo la correzione.
GPT-6 Luna scrive meno di GPT-5.6 Luna?
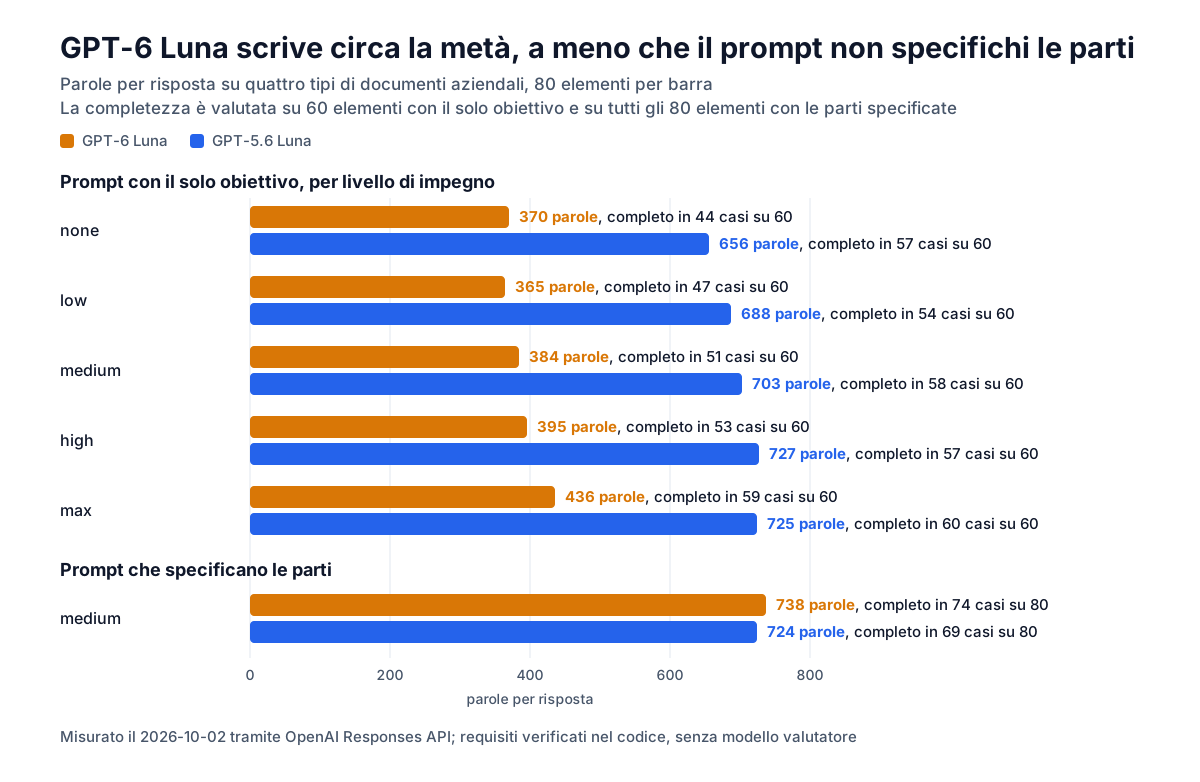
Con i prompt che indicano solo l’obiettivo e con l’effort predefinito, GPT-6 Luna ha scritto 0.55x le parole di GPT-5.6 Luna: 384 parole per documento contro 703. È stato più breve in tutti gli 80 task e in ogni tipo di documento, soprattutto nei postmortem (441 contro 981 parole) e meno nelle risposte ai clienti (576 contro 767).
Con le parti esplicite, il divario scompare: 738 parole contro 724.
La tendenza a rispondere in modo più breve non riguarda solo Luna. Sugli stessi task, GPT-6 Sol ha scritto 325 parole contro le 592 di GPT-5.6 Sol, mentre GPT-6.1 Sol è tornato a 565.
GPT-6 Luna omette informazioni?
Nei prompt che indicano solo l’obiettivo, GPT-6 Luna omette più spesso di GPT-5.6 Luna un solo elemento: la durata dell’incidente nel postmortem. Di solito indica l’intervallo orario («Finestra dell’incidente: 18:00-18:39 UTC») e lascia il calcolo a chi legge. A tutti i livelli di effort, il resto è presente: tutte le regioni e quella con il risultato peggiore, tutti gli eventi e una risposta indirizzata per nome per ogni ticket, con una sola eccezione a none.
| Prompt con il solo obiettivo | GPT-6 Luna: completi | GPT-6 Luna: postmortem senza durata | GPT-5.6 Luna: completi | GPT-5.6 Luna: postmortem senza durata |
|---|---|---|---|---|
none | 44 / 60 | 15 / 20 | 57 / 60 | 3 / 20 |
low | 47 / 60 | 13 / 20 | 54 / 60 | 6 / 20 |
medium | 51 / 60 | 9 / 20 | 58 / 60 | 2 / 20 |
high | 53 / 60 | 7 / 20 | 57 / 60 | 3 / 20 |
max | 59 / 60 | 1 / 20 | 60 / 60 | 0 / 20 |
Il divario con none (44 contro 57) resta significativo dopo la correzione. Con medium (51 contro 58) è significativo solo prima della correzione, quindi indica una tendenza; con max i due modelli sono alla pari. La differenza riguarda un solo tipo di documento: GPT-6 Luna tende a saltare un dato da calcolare nel postmortem, non a omettere contenuti in generale.
Con le parti esplicite, GPT-6 Luna ha prodotto 74 documenti completi su 80 e GPT-5.6 Luna 69: una parità. Tutti i casi incompleti, per entrambi i modelli, erano memo o paragrafi sull’impatto più brevi dell’intervallo di parole richiesto: 6 per GPT-6 Luna e 11 per GPT-5.6 Luna.
Come ottenere la lunghezza e i dettagli mancanti?
Basta elencare le parti nel prompt; i due parametri della richiesta non bastano. Con lo stesso effort, GPT-6 Luna è passato da 384 a 738 parole e ha indicato la durata in ogni postmortem quando il prompt la richiedeva. Una richiesta come questa è sufficiente:
Write the postmortem with these sections: Timeline (a table with every event),
Impact (120-200 words, state the total duration in minutes), Root Cause,
Action Items (5, each ending "Owner: <team>"), Lessons Learned (at least 3 bullets).
text.verbosity è un parametro della Responses API (low, medium, high) che regola la lunghezza e il livello di dettaglio della risposta visibile. Impostato su high, ha allungato del 7% i documenti di GPT-6 Luna generati da prompt con il solo obiettivo (410 parole), senza cambiare il numero di documenti completi: 52 su 60 contro 51.
Aumentare reasoning.effort incide più su quanto il modello ragiona che su quanto scrive. Passando da none a max, i documenti di GPT-6 Luna sono cresciuti da 370 a 436 parole, mentre i token di ragionamento sono passati da 0 a 4,192 per risposta. Con max, la durata mancava solo in 1 postmortem su 20, ma il costo era 4.5 volte quello di medium.
Ecco entrambi i parametri con l’OpenAI Python SDK:
from openai import OpenAI

client = OpenAI()
prompt = "Write the postmortem with these sections: ..."  # data and required parts
resp = client.responses.create(
    model="gpt-6-luna",
    reasoning={"effort": "medium"},   # none, low, medium (default), high, xhigh, max
    text={"verbosity": "high"},       # 7% longer in our runs; did not change completeness
    input=prompt,
)
print(resp.output_text)
usage = resp.usage
print(usage.output_tokens, usage.output_tokens_details.reasoning_tokens)
output_tokens include i token di ragionamento, quindi i token della risposta visibile sono la differenza tra i due numeri.
Quanto si risparmia con GPT-6 Luna rispetto a GPT-5.6 Luna?
Per produrre lo stesso documento, GPT-6 Luna costa il 49% in meno di GPT-5.6 Luna: $0.81 contro $1.61 per 1.000 documenti con le parti esplicite. La sola riduzione dei prezzi avrebbe portato a un risparmio maggiore. Applicando le tariffe di GPT-6 Luna ai token consumati da GPT-5.6 Luna si arriva a $0.68, il 58% in meno. Le risposte di GPT-6 Luna costano il 20% in più di questa cifra perché usa il doppio dei token di ragionamento (537 per risposta contro 271) e il suo output totale sale da 1,284 a 1,558 token.
Con i prompt che indicano solo l’obiettivo, il costo scende a $0.54 contro $1.66 per 1.000 documenti (68% in meno). Gran parte del risparmio aggiuntivo, però, viene dal fatto che GPT-6 Luna scrive la metà: è un risparmio solo se l’altra metà non serviva.
La velocità è simile. GPT-6 Luna ha generato 115 token di output al secondo sul tempo totale della richiesta, contro 125. Il tempo mediano per un documento con il solo obiettivo è stato di 8.1 secondi contro 11.1, perché c’era meno da scrivere.
I nostri risultati coincidono con gli altri test pubblicati?
Dove sono confrontabili, i nostri risultati concordano con i benchmark pubblici. In più mostrano quali testi sono più brevi, cosa manca e come rimediare.
| Domanda | Dati pubblicati altrove | La nostra misurazione | Esito |
|---|---|---|---|
| Capacità generali: GPT-6 Luna contro GPT-5.6 Luna | Artificial Analysis: 38 contro 37; Vals: 51.2% contro 51.7% | 74 documenti completi contro 69 su 80 con le parti esplicite: parità | Concorda: alla pari |
| Qualità dei documenti | GDPval-AA v2.1 Elo: 25 punti in meno con max, 129 in più con medium | con medium, 0.55x le parole nei prompt con il solo obiettivo; durata dell’incidente assente in 9 postmortem su 20 contro 2 | Quadro misto: nessuno dei due rileva un chiaro peggioramento con l’effort predefinito; il nostro test mostra risposte più brevi e l’elemento che si perde |
| Token di output | 51K contro 41K per task dell’indice con max, il 24% in più | 1,558 contro 1,284 per documento con medium, il 21% in più | Concorda |
| Costo | 61% in meno per task dell’indice; 48% in meno per test Vals | 49% in meno con le parti esplicite, 68% in meno con prompt che indicano solo l’obiettivo | Concorda |
Cosa abbiamo osservato e quale modello conviene usare?
Usa GPT-6 Luna quando controlli il prompt, specificando le parti necessarie. Mantieni GPT-5.6 Luna solo se non puoi modificare i prompt e chi legge si aspetta documenti lunghi. La scelta si basa su tre osservazioni:
- GPT-6 Luna segue ciò che chiede il prompt. Se indichi solo un obiettivo, produce un documento breve; se elenchi le parti, ne produce uno completo e lungo quanto quello di GPT-5.6 Luna.
- Le omissioni sono circoscritte. Nei quattro tipi di documento, l’unico elemento atteso che manca più spesso è la durata dell’incidente.
- Il risparmio viene dal taglio dei prezzi. Per lo stesso documento usa il 21% di token di output in più, quindi il risparmio del 49% è inferiore al 58% che si otterrebbe dai soli prezzi di listino.
| Workload | Scelta | Numeri |
|---|---|---|
| Output letto da software: classificazione, estrazione, routing | GPT-6 Luna con l’effort più basso compatibile con l’accuratezza richiesta | prezzi di listino inferiori del 50% (input) e del 58% (output); la lunghezza della risposta non conta se la legge un programma |
| Documenti basati su un template o su un prompt che scrivi tu | GPT-6 Luna con sezioni, quantità e lunghezze indicate nel prompt | 74 documenti completi su 80 contro 69; $0.81 contro $1.61 per 1.000 |
| Documenti generati da prompt degli utenti che non puoi modificare | GPT-6 Luna se puoi aggiungere alla richiesta le parti attese; altrimenti GPT-5.6 Luna | con il solo obiettivo: 384 contro 703 parole; durata assente in 9 postmortem su 20 contro 2 |
| Documenti valutati con una rubric | Inserisci la rubric nel prompt; non affidarti a text.verbosity | verbosity high: 52 documenti completi contro 51 su 60, il 7% di parole in più |
Prima di inviare documenti ai clienti, verifica via codice che contengano tutti gli elementi richiesti, indipendentemente dal modello usato.
FAQ
GPT-6 Luna è peggiore di GPT-5.6 Luna? GPT-6 Luna è stato completo quanto GPT-5.6 Luna quando il prompt elencava le parti richieste (74 documenti contro 69 su 80, una parità), alla metà del costo. Scrive circa la metà quando il prompt indica solo un obiettivo e, in quei casi, omette più spesso la durata dell’incidente nei postmortem.
text.verbosity: "high" fa scrivere a GPT-6 Luna quanto GPT-5.6 Luna?
Nei nostri test, text.verbosity: "high" ha aumentato del 7% le parole prodotte da GPT-6 Luna, portandolo a circa il 58% della lunghezza di GPT-5.6 Luna, senza cambiare il numero di documenti completi. Elencare le parti nel prompt ha portato i due modelli alla stessa lunghezza.
GPT-6.1 ha risolto il problema delle risposte brevi di GPT-6 Luna? L’aggiornamento 6.1 di OpenAI riguarda solo la fascia Sol: GPT-6.1 Sol è tornato a scrivere risposte lunghe quanto quelle di GPT-5.6 Sol. GPT-6 Luna non è cambiato dal rilascio del 2026-09-22.
Altre misurazioni: GPT-6.1 Sol vs Claude Sonnet 5.5, confronto tra LLM della fascia flash e come ridurre i costi di GPT-5.6.