
Debug di un agente LLM: 3 errori in una trace, uno con stato 200
Trova l'esecuzione di un utente tramite un'etichetta e analizza tre errori nella trace: un 404 con retry, risposte troncate con stato 200 e un 400 al secondo turno.
Le nostre scelte
prezzi live| Modello | Verdetto | Prezzo |
|---|---|---|
| GPT-6 Luna Ha rifiutato il secondo turno di una conversazione con un 400 in 0.5 s senza addebiti quando nella cronologia salvata mancava una chiamata a uno strumento. | Agente principale nella demo | da $0.1/M |
| DeepSeek V4.1 Flash Con max_tokens a 40, tre chiamate consecutive hanno restituito lo stato 200 ed esattamente 40 token di output senza una risposta utilizzabile. Con il limite aumentato e il ragionamento disattivato, una chiamata ha risposto in 49 token. | Sottoagente nella demo | da $0.3/M |
Indice
- Come trovare l’esecuzione di un utente?
- Come appare una chiamata fallita seguita da un retry?
- Perché l’agente non ha restituito nulla se tutte le chiamate sono riuscite?
- Perché il secondo turno fallisce se il primo ha funzionato?
- Cosa deve registrare ogni agente per consentire questa analisi?
- FAQ
- Come si fa il debug di un agente LLM in produzione?
- Perché il mio LLM restituisce una risposta vuota con stato 200?
- Cosa causa l’errore «No tool call found for function call output»?
- Conviene ritentare una chiamata LLM fallita?
- Altre letture
«Ieri pomeriggio l’assistente mi ha dato una risposta inutile»: le segnalazioni dei bug degli agenti arrivano quasi sempre così. Un utente, un orario approssimativo, nessun ID della richiesta. Per trovare l’esecuzione serve un’etichetta sulle richieste; per capire cosa è successo serve una trace. Di solito il problema riguarda una sola chiamata tra le tante e spesso non si presenta come un errore. Questa guida parte dalla segnalazione per arrivare alla chiamata difettosa, poi riproduce tre problemi in un piccolo agente di assistenza e mostra come appaiono nella console Synthorai.
TL;DR
- Con un’etichetta
_usersu ogni richiesta basta una ricerca nell’elenco Traces per trovare le esecuzioni dell’agente di un utente. - Una chiamata fallita e il suo retry compaiono affiancati se il retry mantiene lo stesso ID di trace. Il 404 della demo è costato 95 ms e $0.
- Con
max_tokens=40su un modello con reasoning, tre chiamate hanno restituito stato 200, 40 token di output e nessuna risposta. - Una cronologia salvata senza una chiamata a un tool ha fatto fallire il secondo turno con un 400, senza addebiti.
Questa guida riprende Tracciare un agente LLM, che descrive gli header usati qui. Configura la demo come indicato in quella guida (Python 3.10 o successivo, virtualenv attivo), poi esegui questi comandi dalla stessa directory di github.com/synthorai-io/use-cases:
cd use-cases/agent-tracing
python run.py --fail                    # a failed call with a retry
python incidents.py cut-off bad-history
I numeri riportati in questa pagina provengono da una singola esecuzione di ciascun caso, effettuata l’11 ottobre 2026.
| Cosa si vede nella trace | Cosa significa | Caso |
|---|---|---|
| un indicatore tratteggiato con un codice di stato, seguito da una chiamata simile | una chiamata è fallita ed è stata ritentata | run.py --fail |
| lo stesso span ripetuto più volte, tutti con 200, e la colonna Output pari al limite impostato | le risposte vengono troncate prima di essere utilizzabili | cut-off |
| un 400 al secondo turno di una sessione, 0 token, $0 | la richiesta costruita dal codice non è valida | bad-history |
Come trovare l’esecuzione di un utente?
Si usa l’etichetta inviata con le richieste. Se ogni richiesta include X-Synthorai-Metadata con una chiave _user, basta un filtro per trovare quelle dell’utente:
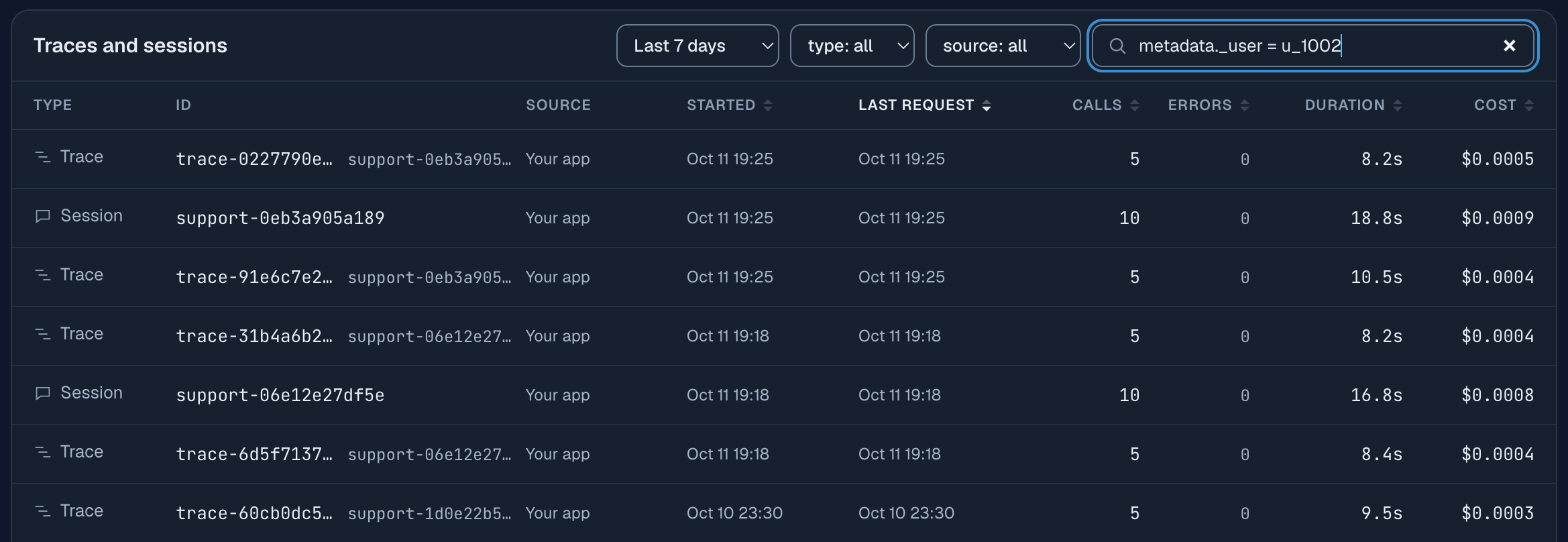
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}- Apri Traces, digita
metadata._user = u_1002nella casella di ricerca e premi Invio. Imposta un intervallo di tempo che includa l’orario della segnalazione. - Esamina l’elenco. Ora contiene solo le sessioni di quell’utente e le relative trace, ciascuna con chiamate, errori, durata e costo. Le colonne Calls, Errors, Duration e Cost sono ordinabili. Parti dalle trace con errori o con molte più chiamate rispetto a quelle vicine.
- Apri la trace. Mostra l’intera esecuzione; «Open session» mostra la conversazione in cui si inserisce e «See the calls in Logs» elenca le singole richieste.
Per cercare singole richieste anziché esecuzioni, la casella dei filtri in Logs accetta la stessa etichetta, insieme a status (error, success, 4xx, 5xx o un codice), latency, cost, model, session e trace.
Senza etichette, la ricerca parte dai dati disponibili: un ID di trace nei tuoi log va nella casella di ricerca di Traces; un ID della richiesta preso da un header di risposta va nel filtro di Logs come request_id. Per questo conviene registrare l’header di risposta x-request-id accanto agli ID interni dell’utente e della conversazione.
Per _user usa un ID utente interno, non un indirizzo email o un nome. Le etichette vengono salvate insieme alla richiesta.
Come appare una chiamata fallita seguita da un retry?
Appare come un indicatore tratteggiato con il codice di stato, accanto alla chiamata che l’ha sostituita. Nella guida al tracing, uno dei tre controlli paralleli richiede un ID di modello inesistente. La trace mostra policy-check come un indicatore di 95 ms con l’etichetta 404 e policy-check.retry come una barra normale accanto. Il riepilogo della trace riporta «6 model calls, 1 failed» e la pagina della sessione elenca «1 × 404 Not found». La chiamata fallita è costata $0.
Due scelte nel codice rendono leggibile questa situazione. Il retry mantiene l’ID di trace, quindi errore e nuovo tentativo compaiono nella stessa vista. Inoltre, il retry ha un nome di span distinto, che permette di distinguere i tentativi. Se il retry avvia una nuova trace, sembrano due esecuzioni scollegate, una delle quali è fallita senza un motivo visibile.
Un errore nella trace non è necessariamente un problema da risolvere. Questa esecuzione si è ripresa e il cliente ha ricevuto una risposta. La trace mostra quanto è costato l’errore: in questo caso 95 ms e nessun addebito. È il dato che serve per decidere se il retry è sufficiente o se va corretta la causa.
Perché l’agente non ha restituito nulla se tutte le chiamate sono riuscite?
L’agente non ha restituito nulla perché lo stato 200 indica solo che la richiesta è stata completata. In questo caso, al sottoagente basato su DeepSeek V4.1 Flash viene chiesto quali argomenti delle policy riguardi un messaggio. Il parametro max_tokens=40 è rimasto da un prompt precedente, più semplice. A differenza delle altre chiamate ai sottoagenti della demo, la versione difettosa di questo controllo lascia il reasoning al valore predefinito del modello (think nello snippet). Il modello ragiona prima di rispondere, il reasoning consuma tutti i 40 token e la risposta arriva vuota, con finish_reason impostato a length. Il codice trova una risposta vuota e riprova, per tre tentativi:
for attempt in range(1, 4):
    resp = await check(run, f"policy-check-{attempt}", prompt, think=variant == "before", max_tokens=limit)
    choice = resp.choices[0]
    if choice.finish_reason != "length" and (choice.message.content or "").strip():
        break                                    # a usable reply; otherwise try again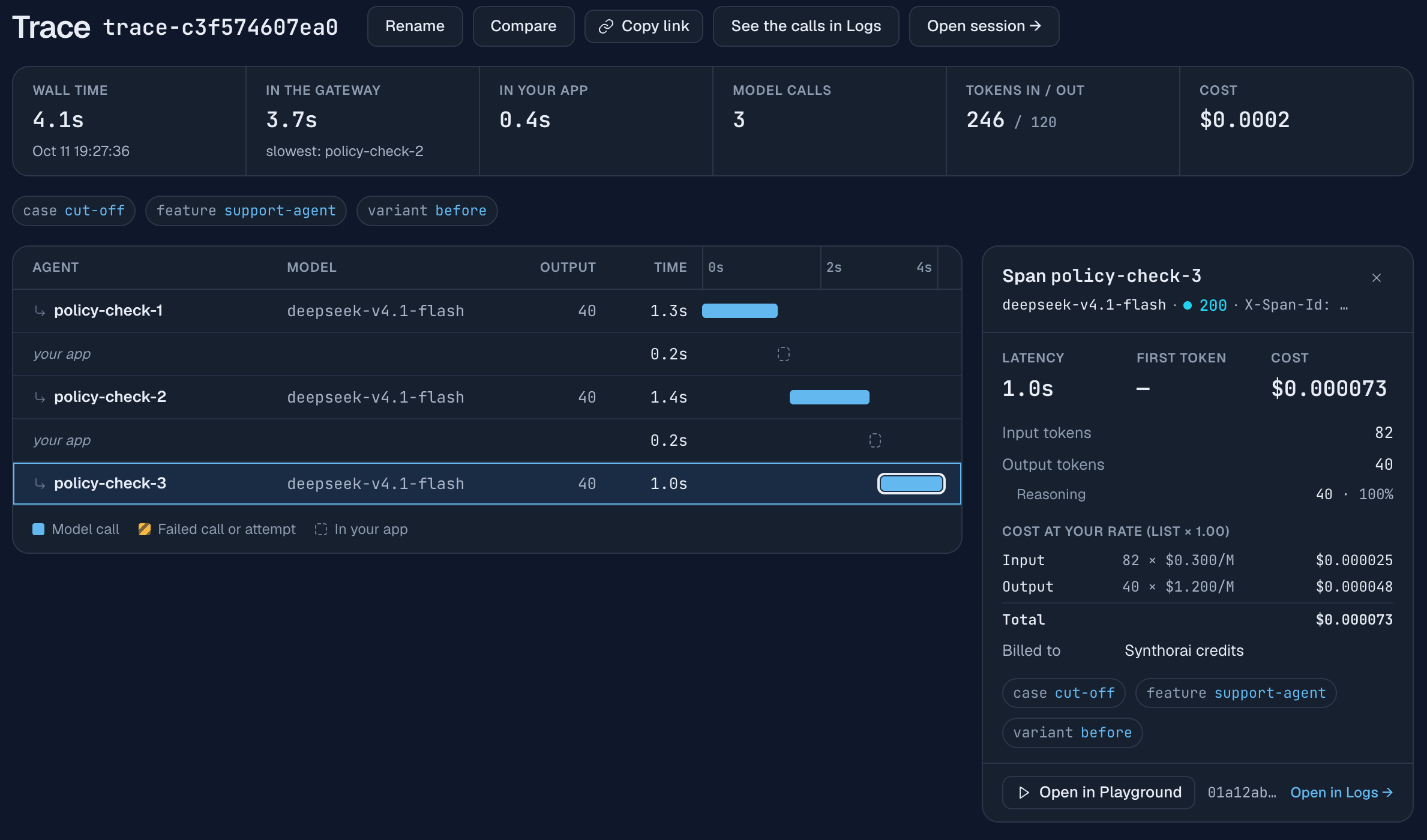
Nel waterfall non compare alcun errore. Gli indizi sono lo span ripetuto e la colonna Output: 40, 40 e 40, esattamente il limite. Selezionando una chiamata si apre il pannello a destra, che conferma il problema: stato 200, 40 token di output e, nella riga sottostante, «Reasoning 40 · 100%».
Un numero di token di output pari al limite impostato è il segnale tipico di una risposta troncata. La versione corretta alza il limite a 2,000 e disattiva il reasoning per questo controllo, che non ne ha bisogno. Una sola chiamata risponde quindi con 49 token di output e nella trace compare una barra al posto di tre. Anche alzare soltanto il limite ha eliminato i retry, ma quella singola chiamata ha consumato 1,876 token di output per il reasoning e ha richiesto 22 s.
Per il tuo agente:
- Controlla
finish_reasona ogni chiamata.lengthindica che la risposta è stata troncata. Registrala come errore nei tuoi log anche se lo stato è 200. - Dimensiona
max_tokensper reasoning e risposta insieme. Su un modello con reasoning il limite copre entrambi. Un limite calcolato solo per la risposta visibile può non lasciarle alcuno spazio. - Non ritentare una risposta troncata con lo stesso limite. Il secondo tentativo raggiungerà lo stesso limite. Aumentalo, riduci il reasoning effort o fai entrambe le cose.
Perché il secondo turno fallisce se il primo ha funzionato?
Di solito la causa è ciò che il codice ha salvato tra i turni. Una richiesta al modello contiene l’intera conversazione, quindi un bug nel salvataggio o nella ricostruzione della cronologia emerge solo dal secondo turno in poi. In questo caso il primo turno usa messaggi tenuti in memoria: GPT-6 Luna chiama un tool, riceve il risultato e risponde senza problemi. Poi il codice salva il turno. Memorizza il messaggio dell’assistente come solo testo, perdendo la chiamata al tool, e salva il risultato del tool accanto al messaggio:
# What the app stores for the next turn.
saved = msg.model_dump(exclude_none=True)
if variant == "before":
    saved.pop("tool_calls", None)                # the bug: the assistant message is saved as text only
    saved["content"] = saved.get("content") or ""
history = [saved, *results, {"role": "assistant", "content": answer.choices[0].message.content or ""}]
Quando il cliente scrive di nuovo, il secondo turno viene costruito dalla cronologia salvata. La richiesta contiene il risultato di un tool, ma la chiamata corrispondente non è più nella cronologia. Viene quindi rifiutata con questo errore («function call output» è il nome usato dal provider per il risultato di un tool):
400 No tool call found for function call output with call_id call_Nqc1zUFvwLLuF5oGMEE9WheQ.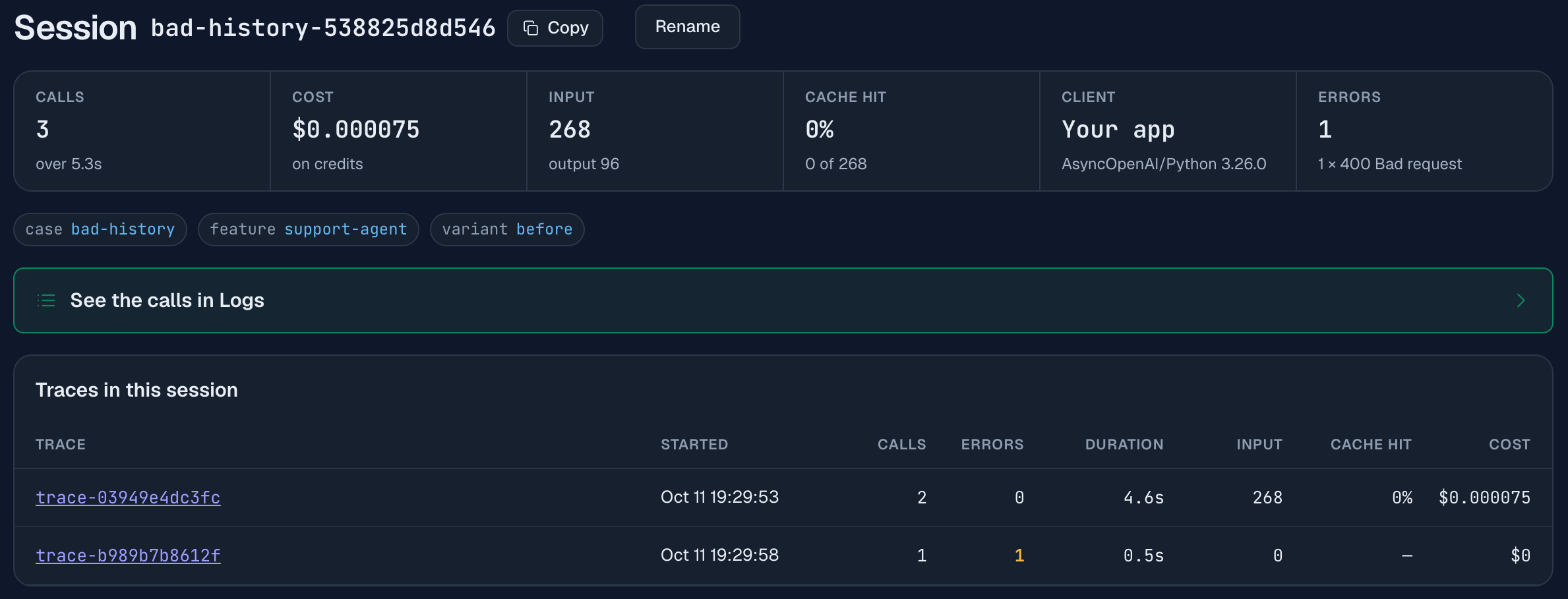
La pagina della sessione mostra la sequenza: due trace, la prima con 2 chiamate e nessun errore, la seconda con 1 chiamata e 1 errore, e «1 × 400 Bad request» nel riquadro degli errori. La trace fallita mostra 0 token di input, una durata di 0.5 s e un costo di $0. Questi tre valori insieme indicano che il modello non è mai stato eseguito: la richiesta è stata rifiutata perché non valida. Questo distingue il caso da un problema del modello o del provider, dove si vedrebbero token, una durata maggiore o uno stato 5xx.
Un 400 indica un bug nella richiesta, quindi riprovare non serve. Il testo dell’errore dice cosa correggere. Salvando il messaggio completo dell’assistente, il secondo turno riesce.
Lo stesso schema (primo turno riuscito, un turno successivo rifiutato) può derivare da altri bug nella cronologia: un risultato di tool salvato senza l’ID della chiamata, messaggi memorizzati nell’ordine sbagliato oppure una cronologia tagliata nel mezzo di uno scambio con un tool, mantenendo il risultato ma eliminando la chiamata. Se accorci la cronologia per contenere i costi, taglia tra un turno e l’altro, mai all’interno di un turno.
Cosa deve registrare ogni agente per consentire questa analisi?
Registra cinque elementi:
- Un ID di trace per esecuzione e un ID di sessione per conversazione, inviati come
X-Trace-IdeX-Session-Ide riportati anche nei tuoi log. - Un nome di span per chiamata che identifichi il passaggio e il tentativo, come
plan-2opolicy-check.retry. - Etichette per utente, funzionalità e release, inviate come
X-Synthorai-Metadata. - L’header di risposta
x-request-iddi ogni chiamata, accanto ai tuoi ID. finish_reasone il numero di token di output di ogni chiamata, trattandolengthcome un errore.
Imposta anche un timeout del client e un valore di max_tokens per ogni chiamata, lasciando un margine ampio per entrambi. Senza questi limiti, una chiamata può proseguire finché il modello continua a scrivere, e il codice resta in attesa. Un limite calcolato solo per la risposta visibile causa però il bug del secondo caso; un timeout più breve di una generazione lunga interrompe chiamate che stavano funzionando. Su un modello con reasoning, una singola chiamata può richiedere minuti. La demo attende 300 s e limita ogni chiamata a 2,000 token di output, salvo quando la chiamata imposta un proprio limite.
FAQ
Come si fa il debug di un agente LLM in produzione?
Trova prima l’esecuzione: filtra il log delle richieste per un’etichetta dell’utente o della conversazione, poi apri la trace di una richiesta corrispondente. La trace mostra in ordine tutte le chiamate al modello dell’esecuzione, evidenziando quelle fallite. Puoi così individuare il passaggio difettoso prima di leggere il codice.
Perché il mio LLM restituisce una risposta vuota con stato 200?
Di solito il limite di output viene raggiunto prima che il modello scriva la risposta. Su un modello con reasoning, max_tokens copre sia il reasoning sia la risposta. Controlla finish_reason: se è length e il numero di token di output è pari al limite, la risposta è stata troncata. Nella demo, tre chiamate consecutive hanno restituito 200 con esattamente 40 token di output e nessuna risposta utilizzabile.
Cosa causa l’errore «No tool call found for function call output»?
La cronologia della conversazione contiene il risultato di un tool, ma manca la chiamata corrispondente. Succede quando il messaggio dell’assistente che ha effettuato la chiamata viene salvato senza tool_calls, oppure quando la cronologia viene tagliata tra una chiamata e il suo risultato. Salva il messaggio completo dell’assistente e taglia solo tra i turni.
Conviene ritentare una chiamata LLM fallita?
Dipende dallo stato. Un 429 (limite di frequenza raggiunto) o un 5xx (errore del server) può riuscire al tentativo successivo. Un 400 indica un problema nella richiesta e fallirà allo stesso modo. Una risposta troncata da max_tokens verrà troncata di nuovo se il limite non cambia. Quando riprovi, mantieni lo stesso ID di trace, così entrambi i tentativi compaiono nella stessa trace.
Altre letture
- Tracciare un agente LLM: gli header, il waterfall e l’esempio di chiamata fallita.
- Perché il mio agente LLM è lento?: analizzare la latenza nella stessa trace.
- Perché il mio agente LLM costa tanto?: analizzare i costi nelle sessioni.
- Costi di Claude Code per sottoagente: le stesse viste per un agente di programmazione che non hai scritto tu.
- Interrogare Claude sui log LLM: «È fallita qualche richiesta di questo utente?», con risposta tramite MCP.
- Fornire all’agente strumenti per leggere i log: leggere gli stessi log con un programma scritto da te e calcolare il costo dei token del modello.
- Riferimento degli header di richiesta: ID, etichette e relativi limiti.