
Traccia un agente LLM con 3 header HTTP, senza SDK di tracing
Aggiungi tre header alle chiamate al modello dell'agente e visualizza ogni esecuzione: chiamate parallele, tempo nel tuo codice, errori e costi.
Le nostre scelte
prezzi live| Modello | Verdetto | Prezzo |
|---|---|---|
| GPT-6 Luna Gestisce il ciclo di chiamate a funzione della demo. Le sue due chiamate per turno (pianificazione e risposta) costano complessivamente $0.0002 nell'esecuzione mostrata in questa pagina. | Agente principale nella demo | da $0.1/M |
| DeepSeek V4.1 Flash Esegue i tre controlli paralleli di una frase ciascuno con il ragionamento disattivato. Le sue sei chiamate nella sessione mostrata in questa pagina costano $0.0004, e una settima chiamata al sottoagente è fallita con un costo di $0. | Sottoagente nella demo | da $0.3/M |
Indice
- Cosa bisogna inviare per ottenere una traccia?
- Cosa fa l’agente della demo?
- Come si legge il grafico waterfall?
- Cosa aggiunge una sessione rispetto a una traccia?
- Come si suddividono i costi per funzionalità o utente?
- Cosa succede quando una chiamata fallisce?
- Come si ottiene il costo di ogni chiamata nel codice?
- E se l’agente invia già header di tracciamento?
- Cosa si fa con una traccia una volta ottenuta?
- Cosa non copre la demo?
- Domande frequenti
- Serve OpenTelemetry per tracciare un agente LLM?
- Qual è la differenza tra una traccia e una sessione?
- Gli header di tracciamento cambiano l’instradamento, la fatturazione o ciò che vede il modello?
- Per quanto tempo vengono conservate le tracce?
- Una chiamata fallita ha un costo?
- Letture correlate
È difficile fare debug di un agente che effettua cinque chiamate al modello per rispondere a un messaggio se si ha solo un elenco di richieste nel log. Non si capisce quali chiamate appartengano alla stessa esecuzione, quali siano partite in parallelo o quanto tempo sia stato impiegato dal proprio codice. In questa guida aggiungiamo tre header alle richieste di un piccolo agente di assistenza. Poi leggiamo il risultato nella console Synthorai come traccia (un’esecuzione rappresentata su una linea temporale) e sessione (una conversazione con il relativo costo). Non serve installare un SDK di tracing né avviare un collector, cioè un servizio separato che riceve le tracce. Il codice è su github.com/synthorai-io/use-cases, nella directory agent-tracing/. Servono Python 3.10 o successivo e una chiave API della console.
TL;DR
- Tre header (
X-Trace-Id,X-Span-Id,X-Session-Id) su ogni chiamata al modello trasformano il log delle richieste in tracce e sessioni nella console Synthorai, senza SDK di tracing. - Nella traccia della demo, gli 8.5 s complessivi si dividono in circa 7.0 s nelle chiamate ai modelli e 1.6 s al di fuori di esse, nel codice dell’agente e sulla rete.
- Una chiamata fallita con un 404 è rimasta nella traccia, con un costo di $0.
- L’esecuzione della demo, con 21 chiamate ai modelli, è costata $0.0017.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put your API key in it
cd agent-tracing
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python run.py --fail
Quando l’abbiamo eseguita l’11 ottobre 2026, la demo ha effettuato 21 chiamate ai modelli in meno di un minuto, per un costo di $0.0017. Stampa due ID di sessione e quattro ID di traccia. Aprendo Tracce nella console si ritrovano gli stessi ID. La console mostra gli orari nel fuso del browser: per questo gli screenshot di queste pagine riportano 19:24 invece di 11:24 UTC.
Cosa bisogna inviare per ottenere una traccia?
Ogni chiamata al modello deve contenere tre header, con valori stringa scelti da te. Il gateway registra già tutte le richieste. Gli header gli indicano soltanto quali richieste raggruppare.
| Header | Usa lo stesso valore per | Risultato |
|---|---|---|
X-Trace-Id | tutte le chiamate di un’esecuzione (la gestione di un messaggio utente dall’inizio alla fine) | le chiamate in un unico grafico waterfall |
X-Span-Id | una sola chiamata | il nome della riga della chiamata nel grafico waterfall |
X-Session-Id | tutte le chiamate di una conversazione | le esecuzioni raggruppate, con i totali della conversazione |
Uno span è un singolo passaggio di una traccia. In questa guida ogni span corrisponde a una chiamata al modello. Ogni ID può contenere fino a 128 caratteri ASCII stampabili. Il gateway restituisce gli ID nella risposta e non li inoltra al provider del modello.
Altri tre header sono facoltativi. X-Agent-Id indica quale sottoagente ha effettuato la chiamata, X-Parent-Agent-Id quale agente ha avviato quel sottoagente e X-Synthorai-Metadata contiene etichette come la funzionalità o l’utente finale. Sono tutti descritti nella documentazione degli header di richiesta. La demo invia X-Agent-Id e le etichette, ma non X-Parent-Agent-Id: l’unico sottoagente viene avviato dall’agente principale, quindi non ci sono livelli annidati da descrivere.
Nella demo una sola funzione costruisce gli header della chiamata. Il livello di tracciamento è tutto qui:
@dataclass
class Run:
    """One agent run, which the gateway shows as one trace."""
    session_id: str
    labels: dict = field(default_factory=dict)
    trace_id: str = field(default_factory=lambda: new_id("trace"))

    def headers(self, span: str, agent: str | None = None, parent: str | None = None) -> dict:
        h = {
            "X-Session-Id": self.session_id,
            "X-Trace-Id": self.trace_id,
            "X-Span-Id": span,
        }
        if agent:
            # Only sub-agents need an id. Calls without one belong to the main agent.
            h["X-Agent-Id"] = agent
        if parent:
            h["X-Parent-Agent-Id"] = parent
        if self.labels:
            h["X-Synthorai-Metadata"] = json.dumps(self.labels, separators=(",", ":"))
        return h
Tutte le chiamate al modello dell’agente passano attraverso un wrapper che aggiunge questi header. Nell’SDK Python di OpenAI, gli header della singola richiesta si passano in extra_headers:
raw = await client.chat.completions.with_raw_response.create(
    model=model, messages=messages,
    extra_headers=run.headers(span, agent, parent), **kwargs)
resp = raw.parse()
request_id = raw.headers.get("x-request-id")   # the gateway's id for this call
with_raw_response serve solo a leggere gli header della risposta. Se non ti serve l’ID della richiesta, basta un normale create(..., extra_headers=...).
Cosa fa l’agente della demo?
Risponde al messaggio di un cliente in quattro fasi e cinque chiamate ai modelli, scelte per rendere visibili diversi casi nella traccia. L’agente principale usa GPT-6 Luna, il sottoagente DeepSeek V4.1 Flash; entrambi si configurano tramite variabili d’ambiente. Le chiamate del sottoagente impostano reasoning_effort="none", perché un controllo di una frase non richiede una fase di ragionamento del modello. Se configuri il sottoagente con un modello che rifiuta quel valore, modifica o svuota ANALYST_REASONING.
| Span | Chi | Cosa succede |
|---|---|---|
plan | agente principale | legge il messaggio e richiede dei tool (function calling: il modello restituisce il nome di una funzione e gli argomenti da eseguire nel tuo codice) |
| nessuno | il tuo codice | esegue in parallelo due tool locali: una ricerca dell’ordine (1.2 s) e una ricerca nelle policy (0.6 s) |
sentiment, policy-check, risk | sottoagente analyst | tre controlli di una frase, inviati contemporaneamente |
answer | agente principale | scrive la risposta usando i risultati dei tool e dei tre controlli |
I tool sono semplici funzioni Python con un sleep, che simulano un database e un indice di ricerca. Con --fail, una chiamata policy-check richiede prima un modello inesistente, riceve un 404 e viene ritentata con il nome di span policy-check.retry.
run.py esegue due conversazioni di due turni ciascuna. Ogni conversazione riceve un ID di sessione e ogni turno un nuovo ID di traccia:
session_id, history = new_id("support"), []
for text in turns:
    run = Run(session_id, labels={"feature": "support-agent", "release": "v2", "_user": user})
    reply = await handle(run, history, text)
Come si legge il grafico waterfall?
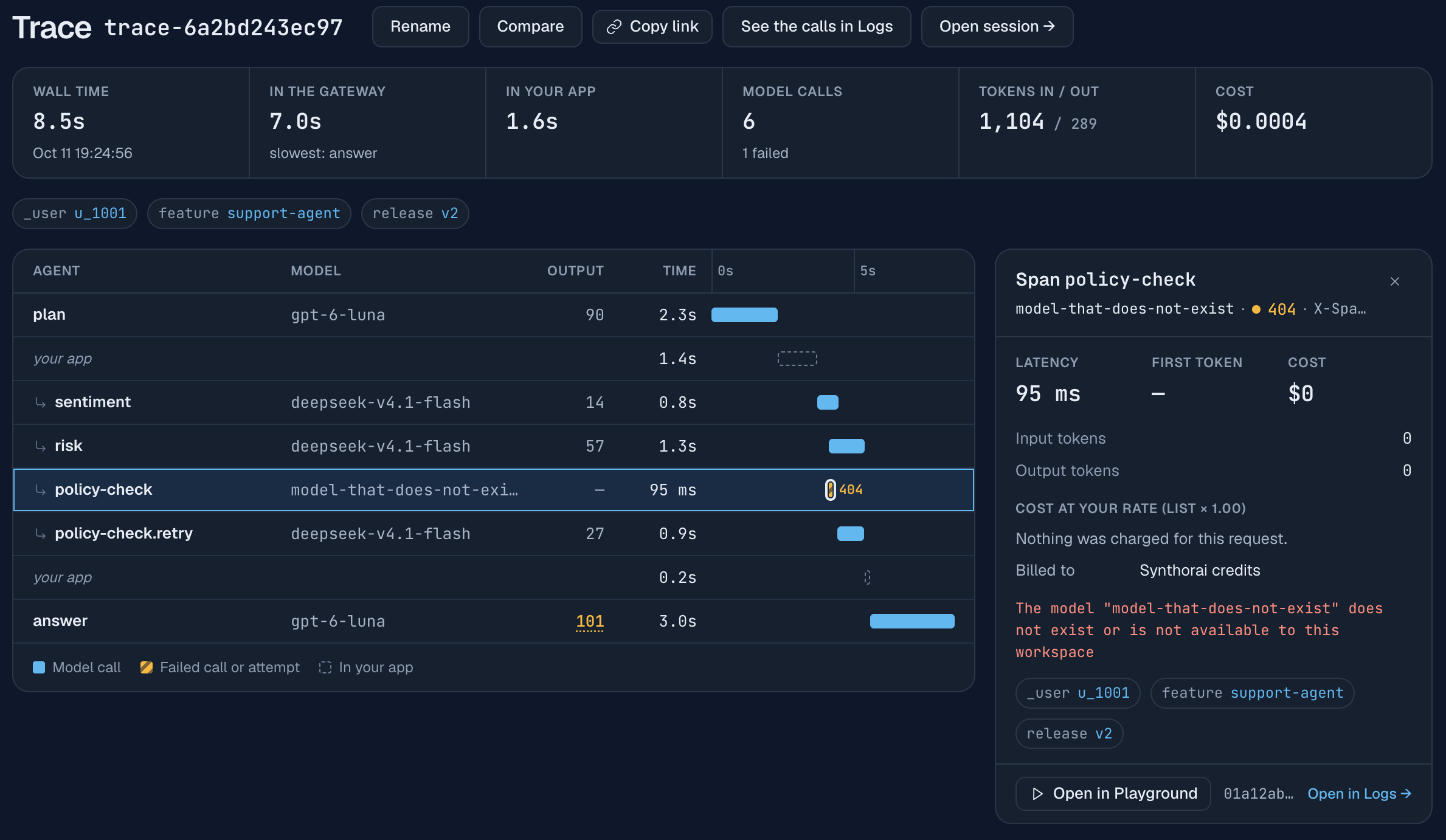
Ogni riga rappresenta una chiamata al modello oppure un intervallo nel tuo codice. Le righe sono disposte su un asse temporale che parte dall’arrivo della prima chiamata al gateway. Lo screenshot sopra mostra il secondo turno della prima conversazione. Dall’alto:
planha impiegato 2.3 s. La barra indica il tempo trascorso nel gateway per quella richiesta, dalla ricezione al completamento della risposta.your appha impiegato 1.4 s. In quell’intervallo non c’erano richieste in corso, quindi il tempo è stato speso fuori dal gateway: nel tuo codice e sulla rete tra il codice e il gateway. Qui corrisponde ai due tool locali; il più lento ha un’attesa di 1.2 s. In un agente reale, questa riga rende visibile una query lenta al database o una ricerca vettoriale lenta.sentiment,riskepolicy-check.retrysi sovrappongono. L’agente ha inviato i tre controlli conasyncio.gather: le barre sovrapposte indicano chiamate parallele. La freccia davanti ai nomi identifica le chiamate di un sottoagente.policy-checkè un segno tratteggiato di 95 ms con404. Una chiamata fallita rimane nella traccia con il codice di stato ricevuto dal tuo codice.answerha impiegato 3.0 s ed è la chiamata più lenta, come indica anche il riepilogo sopra il grafico.- La colonna Output riporta i token di output di ogni chiamata. La generazione dell’output è ciò che occupa il tempo della chiamata, quindi questa colonna di solito spiega la lunghezza della barra accanto:
answerha prodotto 101 token, i tre controlli da 14 a 57 ciascuno. La console sottolinea il conteggio quando la maggior parte di un output più lungo è costituita da ragionamento, come per i 101 token di questo caso.
Il riepilogo divide gli 8.5 s complessivi in 7.0 s nel gateway e 1.6 s nell’app. Questa suddivisione risponde alla prima domanda di quasi ogni indagine sulla latenza: bisogna intervenire sulle chiamate ai modelli o sul proprio codice? In questa esecuzione, l’82% dell’attesa era dovuto ai modelli. Le due chiamate dell’agente principale, plan e answer, ne occupano 5.3 s: un modello più veloce per l’agente principale aiuterebbe quindi più di un’accelerazione dei tre controlli.
Il gateway non può vedere dentro il tuo codice. Ricava le righe your app dagli intervalli tra le richieste: un intervallo indica quanto a lungo è stato eseguito il codice, non cosa abbia fatto. Per avere span delle tue funzioni serve un SDK OpenTelemetry, lo standard aperto per il tracciamento. I due sistemi possono condividere gli ID: quando non invii X-Trace-Id, il gateway legge traceparent, l’header standard che contiene un ID di traccia.
Cosa aggiunge una sessione rispetto a una traccia?
Una sessione raggruppa le esecuzioni di una conversazione e ne calcola i totali. Puoi aprirla dall’elenco delle tracce oppure usare «Apri sessione» su qualsiasi traccia.
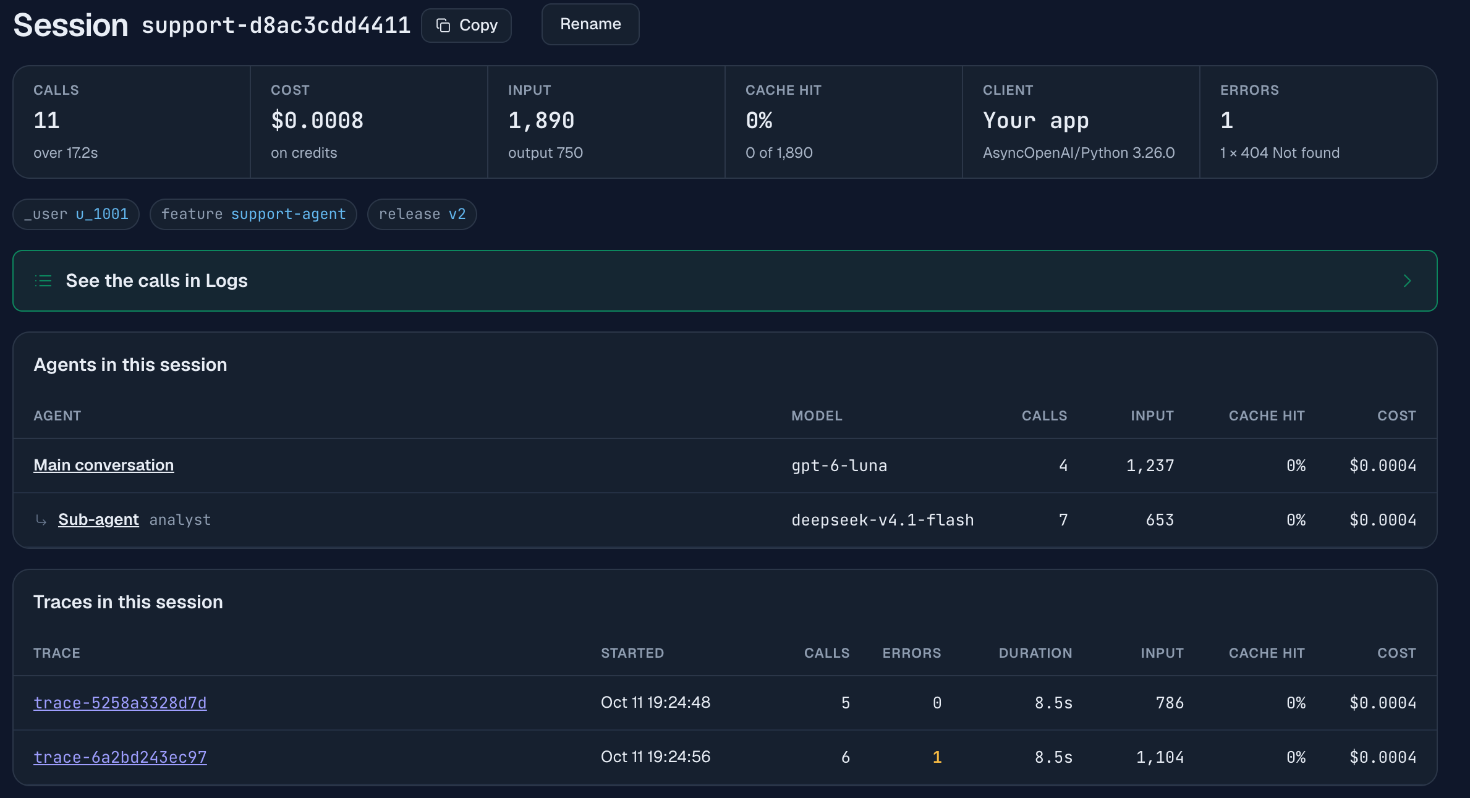
La sessione sopra è una conversazione con un cliente di due turni: 11 chiamate, 1,890 token di input e 750 di output, $0.0008, un errore. La pagina ha tre parti:
- Agenti in questa sessione suddivide chiamate e costi per agente. L’agente principale ha effettuato 4 chiamate a GPT-6 Luna per $0.0004. Il sottoagente
analystha effettuato 7 chiamate per $0.0004: sei a DeepSeek V4.1 Flash e una fallita. La tabella compare perché le chiamate del sottoagente contenevanoX-Agent-Id: analyst. Le chiamate senza quell’header vengono attribuite alla conversazione principale. - Tracce in questa sessione elenca ogni turno con errori, durata, token di input, cache hit e costo. Puoi così trovare il turno lento, fallito o costoso di una conversazione lunga senza scorrere il log.
- Cache hit è la quota di token di input letti dalla cache dei prompt del provider. Qui è 0% perché i prompt sono lunghi poche centinaia di token e i provider memorizzano solo prefissi oltre una lunghezza minima (1,024 token per la maggior parte; vedi cache dei prompt).
L’ID di sessione ha una seconda funzione, utile quando i prompt diventano abbastanza lunghi da essere memorizzati in cache. Invia lo stesso X-Session-Id su tutte le chiamate di una conversazione: il gateway lo usa per mantenere coerenti i cache hit dei prompt della conversazione, così il secondo turno legge la cache scritta dal primo. Su /v1/chat/completions e /v1/responses puoi inserire il valore nel corpo della richiesta come session_id, se il tuo framework rende scomodo impostare gli header.
Come si suddividono i costi per funzionalità o utente?
Invia X-Synthorai-Metadata con un oggetto JSON piatto di stringhe, poi usalo per raggruppare o filtrare. La demo etichetta ogni chiamata con una funzionalità, una release e l’utente finale:
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}Le etichette compaiono come piccoli tag sulla traccia e sulla sessione. Per vedere i totali, apri Analisi, seleziona la scheda Ripartizione e cerca il riquadro Costo per metadati. Scegli una chiave: verranno elencati tutti i suoi valori con richieste, errori, token di input e costo:
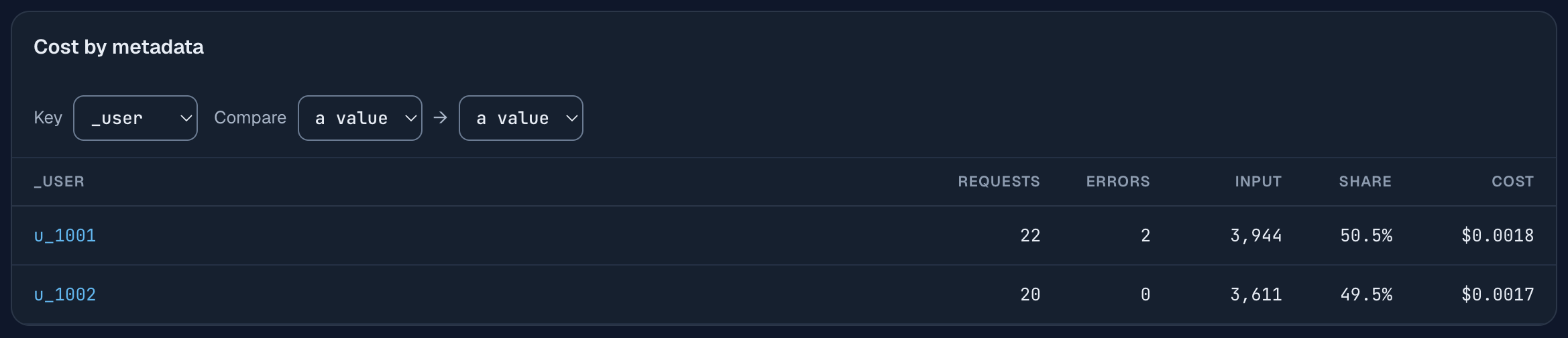
Il riquadro sopra copre un’ora in cui la demo è stata eseguita due volte: 22 richieste e $0.0018 per u_1001, le cui esecuzioni includono le due chiamate fallite, e 20 richieste e $0.0017 per u_1002. Dopo una sola esecuzione vedrai 11 e 10. Seleziona feature come chiave per vedere il costo di ciascuna funzionalità, oppure release per verificare l’effetto di una modifica al prompt sui costi. Il riquadro può anche affiancare due valori di una chiave. Nella stessa scheda, il riquadro Costo per agente somma ogni X-Agent-Id tra le sessioni.
Per risalire da un totale alle esecuzioni che lo compongono, puoi cercare per etichetta. Digita metadata._user = u_1002 nella casella di ricerca dell’elenco delle tracce e premi Invio: rimarranno solo le sessioni e le tracce di quell’utente. La casella dei filtri nei Log accetta la stessa espressione per le singole richieste.
Le regole per le etichette sono poche:
- Al massimo 10 etichette per richiesta. Una chiave contiene da 1 a 32 caratteri tra
a-z,0-9,_,.e-. Il valore è una stringa di massimo 128 byte. _useridentifica l’utente finale per cui è stata effettuata la richiesta. Le altre chiavi che iniziano con un underscore sono riservate.- Un’etichetta che viola una regola viene scartata, ma la richiesta viene comunque eseguita. L’header di risposta
X-Synthorai-Metadata-Droppedelenca le chiavi scartate: registralo nei log durante la configurazione. Per verificare abbiamo inviato una chiave chiamataBad?Keye l’header restituito contenevaBad?Key. - Non inserire nelle etichette testo dei prompt, dati personali o segreti. Per
_userusa il tuo ID utente interno, non un indirizzo email.
Cosa succede quando una chiamata fallisce?
Rimane nella traccia come segno tratteggiato con il relativo codice di stato e non costa nulla. Nella demo, la chiamata policy-check fallita ha richiesto un ID di modello inesistente. Selezionandola nel grafico waterfall si apre il pannello a destra nello screenshot sopra, con l’errore ricevuto dal codice: The model "model-that-does-not-exist" does not exist or is not available to this workspace, una latenza di 95 ms, un costo di $0 e la nota che non è stato addebitato nulla.
La demo assegna al retry un nome di span distinto:
try:
    await call(run, span, model=BROKEN_MODEL, messages=messages, agent="analyst")
except APIStatusError:
    span = f"{span}.retry"      # the retry is its own span, so both show in the waterfall
resp = await call(run, span, model=ANALYST_MODEL, messages=messages, agent="analyst", max_tokens=400,
                  **analyst_options())   # reasoning_effort="none" unless ANALYST_REASONING says otherwise
Mantenendo l’ID di traccia e cambiando il nome dello span, il tentativo fallito e il retry compaiono insieme nello stesso grafico. Se la logica di retry è in una libreria che riutilizza gli stessi header, entrambi i tentativi compaiono comunque, in due righe con lo stesso nome.
Anche gli errori vengono aggregati. Il riepilogo della traccia riporta «6 chiamate ai modelli, 1 fallita», la sessione elenca gli errori per codice di stato (1 × 404 Not found) e l’elenco delle tracce ha una colonna Errori ordinabile, per trovare le esecuzioni da esaminare.
Come si ottiene il costo di ogni chiamata nel codice?
Richiedi al gateway il record di fatturazione usando l’ID della richiesta restituito nella risposta. GET /v1/generation?id=<request id> restituisce costo, conteggi dei token, latenza e stato di una singola richiesta.
async def cost_of(http: httpx.AsyncClient, request_id: str) -> float | None:
    """The billing record of one request. It is written a moment after the call returns."""
    if not request_id:
        return None                                  # a call that got no response has no record
    for _ in range(6):
        try:
            r = await http.get(f"{BASE_URL}/generation", params={"id": request_id})
            if r.status_code == 200:
                return r.json()["data"]["total_cost"]
        except (httpx.HTTPError, KeyError, TypeError, ValueError):
            pass                                     # a dropped connection or a half-written record: try again
        await asyncio.sleep(2)
    return None
Il record viene scritto poco dopo il completamento della risposta, quindi la funzione ritenta finché non riceve un 200. Accetta un httpx.AsyncClient che il chiamante crea una sola volta, con l’header Authorization impostato, e passa a ogni ricerca. Cercare venti chiamate con un unico client permette di riutilizzare poche connessioni. Creare un client per ogni ricerca apre invece venti connessioni contemporaneamente; nelle nostre esecuzioni una o due sono state interrotte. La demo stampa una riga per chiamata usando i tempi misurati localmente e questi record. Questo è il primo turno della sessione negli screenshot:
trace trace-5258a3328d7d  session support-d8ac3cdd4411
  plan                 main     gpt-6-luna                 200   1878 ms    153 in   22 out  $0.000026
  sentiment            analyst  deepseek-v4.1-flash        200   1431 ms     91 in   28 out  $0.000061
  risk                 analyst  deepseek-v4.1-flash        200   1877 ms     96 in   33 out  $0.000068
  policy-check         analyst  deepseek-v4.1-flash        200   1885 ms     96 in   39 out  $0.000076
  answer               main     gpt-6-luna                 200   4142 ms    350 in  339 out  $0.000205
Questi tempi sono misurati nel client e includono la rete, quindi sono più lunghi delle barre nella console, che misurano la richiesta dentro il gateway. Nel secondo turno, quello del grafico waterfall sopra, plan ha impiegato 2,499 ms nel client e 2.3 s nel gateway; answer rispettivamente 3,161 ms e 3.0 s. Per le chiamate inviate in parallelo la differenza può essere maggiore: la chiamata fallita ha impiegato 694 ms nel client e 95 ms nel gateway.
Copia questa funzione se vuoi riportare nei tuoi log il costo fatturato di ogni chiamata. Non è adatta a fermare un’esecuzione che sta spendendo troppo: ogni record arriva poco dopo la chiamata e la funzione può attenderlo per diversi secondi. Per gestire un budget in tempo reale, calcola il costo del campo usage di ogni risposta durante l’esecuzione, poi usa questi record per verificare i conti.
E se l’agente invia già header di tracciamento?
Potresti non dover aggiungere nulla. Per ciascuno dei tre ID assente dalla richiesta, il gateway legge l’header equivalente già inviato dagli strumenti più comuni:
| Strumento | Header inviato | Interpretato come |
|---|---|---|
| Strumentazione HTTP OpenTelemetry | traceparent | traccia, con l’ID padre come span |
| LiteLLM SDK | X-Litellm-Trace-Id, X-Litellm-Session-Id | traccia, sessione |
| Langfuse SDK | baggage: langfuse_trace_id=…, langfuse_session_id=… | traccia, sessione |
| Open WebUI | X-OpenWebUI-Chat-Id | sessione |
| Claude Code | X-Claude-Code-Session-Id | sessione |
| OpenAI Codex CLI | Session-Id | sessione |
Se sono presenti entrambi, i tuoi X-Trace-Id, X-Span-Id e X-Session-Id hanno la precedenza. L’elenco completo è nella documentazione degli header di richiesta. Per i framework di agenti che non inviano nessuno di questi header, devi aggiungerli tramite l’opzione che offrono per gli header personalizzati.
Cosa si fa con una traccia una volta ottenuta?
L’uso più comune è confrontarla con un’altra. Ogni pagina di traccia ha un pulsante Confronta: scegli una seconda traccia e la console le mostra entrambe sulla stessa pagina. Per ogni metrica riporta A, B e la variazione, abbina le chiamate con lo stesso nome e dispone i due grafici waterfall su un unico asse temporale. Così puoi verificare l’effetto di una modifica al prompt, al modello o al tuo codice su un’esecuzione.
Tre guide successive usano lo stesso agente e gli stessi header. In ciascuna, i problemi vengono riprodotti, corretti e confrontati in questo modo:
- Perché il mio agente LLM è lento? Chiamate in serie, un tool lento nel tuo codice e ragionamento per risposte di una riga.
- Perché il mio agente LLM costa troppo? Un timestamp che invalida la cache, contesto crescente, un ciclo di retry e un modello sbagliato.
- Fare debug di un agente LLM Dalla segnalazione di un utente alla chiamata che ha causato il problema.
Altre tre esaminano lo stesso log da prospettive diverse:
- Costi di Claude Code per sottoagente Un agente di programmazione che non hai scritto tu, analizzato tramite le stesse viste di sessioni e agenti.
- Chiedi a Claude di analizzare i tuoi log LLM Domande su queste sessioni, con risposte in una finestra di chat tramite una connessione MCP in sola lettura.
- Dai al tuo agente strumenti per leggere i log Gli stessi strumenti in un tuo programma e il costo dei token del modello.
Cosa non copre la demo?
La demo copre le chiamate ai modelli. In produzione di solito si aggiungono quattro aspetti:
- Span per il tuo codice. Il gateway mostra gli intervalli tra le chiamate ai modelli, ma non cosa sia successo al loro interno. Strumenta tool, recupero dei dati e code con OpenTelemetry e propaga
traceparent, così un unico ID di traccia collega entrambe le viste. - Corpi dei prompt e delle risposte. Questa guida usa i record di tempi, token e costi di ogni chiamata. Non tratta l’ispezione dei contenuti inviati al modello.
- Budget.
cost_ofrestituisce l’importo fatturato a posteriori. Per fermare un’esecuzione al raggiungimento di un limite devi calcolare il costo del campousagedi ogni risposta quando arriva: bastano poche righe nel ciclo dell’agente, non incluse nella demo. - Campionamento. Ogni chiamata viene registrata, perché la traccia è costruita dal log delle richieste che il gateway conserva già. Non c’è nulla da campionare e il solo overhead lato agente consiste in pochi header.
Domande frequenti
Serve OpenTelemetry per tracciare un agente LLM?
No. Tre header (X-Trace-Id, X-Span-Id, X-Session-Id) su ogni chiamata al modello bastano per ottenere un grafico waterfall delle chiamate, con gli intervalli tra di esse attribuiti alla tua app. OpenTelemetry diventa utile quando vuoi anche span delle tue funzioni.
Qual è la differenza tra una traccia e una sessione?
Una traccia è una singola esecuzione dell’agente: tutto ciò che viene fatto per gestire un messaggio utente o un’attività. Una sessione è una conversazione composta da più esecuzioni. Nella demo, ogni conversazione con un cliente è una sessione con due tracce, ciascuna contenente cinque o sei chiamate ai modelli.
Gli header di tracciamento cambiano l’instradamento, la fatturazione o ciò che vede il modello?
X-Trace-Id e X-Span-Id non cambiano nulla. X-Session-Id mantiene coerenti i cache hit dei prompt di una conversazione. Nessuno degli header viene inoltrato al provider del modello e la fatturazione usa l’ID di richiesta del gateway.
Per quanto tempo vengono conservate le tracce?
Tracce e sessioni sono costruite dal log delle richieste e coprono gli stessi 90 giorni. L’elenco delle tracce si apre sugli ultimi 7 giorni.
Una chiamata fallita ha un costo?
La chiamata fallita della demo, un 404 per un ID di modello sconosciuto, è stata registrata con un costo di $0 e la nota che non è stato addebitato nulla.
Letture correlate
- Creare un chatbot LLM: il caso con un solo agente, con gestione del contesto, memoria e cache dei prompt.
- Documentazione degli header di richiesta: tutti gli header di questa pagina, con gli alias letti dagli altri strumenti.
- Tracce e sessioni nella console: l’elenco, il grafico waterfall e la pagina della sessione.
- Anatomia del consumo di token LLM: il significato dei conteggi dei token in ogni record, per provider.