
Log LLM in Claude: connettore MCP con OAuth, senza API key
Aggiungi un gateway LLM a Claude come connettore personalizzato, accedi, autorizza la lettura del log delle richieste e fai domande in chat. Tre domande, 14 chiamate ai tool, risultati verificati.
Le nostre scelte
prezzi live| Modello | Verdetto | Prezzo |
|---|---|---|
| Claude Fable 5.1 Ha risposto a tre domande su un log delle richieste con 14 chiamate agli strumenti. Ogni costo, conteggio dei token, conteggio delle richieste e stato corrispondeva ai dati di fatturazione, così come la spiegazione della sessione più costosa. | Modello nella chat | da $10/M |
Indice
- Come si aggiunge il gateway a Claude?
- Cosa autorizzi quando accedi?
- Dove compare la connessione nel gateway?
- Quali domande abbiamo fatto, e le risposte erano corrette?
- Cosa va verificato in una risposta?
- Quanto costa, e come si limita l’accesso?
- FAQ
- Claude può leggere i log delle mie richieste LLM?
- Serve un’API key per collegare Claude a un server MCP?
- Quanto è preciso Claude nell’analisi dei log?
- Quanto costa chiedere a Claude informazioni sui log del gateway?
- È sicuro collegare Claude a un log delle richieste?
- Altre letture
«Quale sessione è costata di più stamattina, e perché?» Per rispondere puoi cercare nella console oppure chiedere a Claude, in una chat che abbia accesso agli stessi dati. In questa guida aggiungiamo il gateway Synthorai a Claude come connettore MCP, il protocollo che permette di fornire tool a un modello. Accediamo senza incollare un’API key, autorizziamo soltanto la lettura del log delle richieste e facciamo tre domande sulle sessioni delle guide precedenti di questa serie. Tutti i numeri nelle risposte corrispondevano ai dati di fatturazione.
TL;DR
- Claude si collega al server MCP del gateway Synthorai tramite un connettore personalizzato e l’accesso OAuth, senza API key da incollare.
- Autorizzando soltanto il log delle richieste, abbiamo dato a Claude quattro tool di sola lettura e una chiave con scope
logs.read, che scade dopo 7 giorni. - Claude Fable 5.1 ha risposto a tre domande sui log con 14 chiamate ai tool. Tutti i valori corrispondevano ai dati di fatturazione.
- I tool dei log restituiscono costi, token e stato, mai il testo dei prompt o delle risposte.
La connessione usa MCP (Model Context Protocol), lo standard per fornire tool a un assistente: un server elenca quelli disponibili e l’assistente li chiama. Il gateway espone questo server all’indirizzo https://synthorai.io/v1/mcp. Claude chiama «connettore» un server MCP aggiunto al tuo account. Questa pagina non contiene codice e non richiede installazioni.
Abbiamo configurato la connessione il 10 ottobre 2026 e fatto le domande il giorno successivo, usando claude.ai nel browser e Claude Fable 5.1 come modello della chat. In Claude Desktop si aggiunge un connettore personalizzato nello stesso modo.
Come si aggiunge il gateway a Claude?
Aggiungi un connettore personalizzato indicando un nome e l’URL del server. In Claude, apri Personalizza, poi Connettori, seleziona Aggiungi e scegli «Aggiungi connettore personalizzato»:
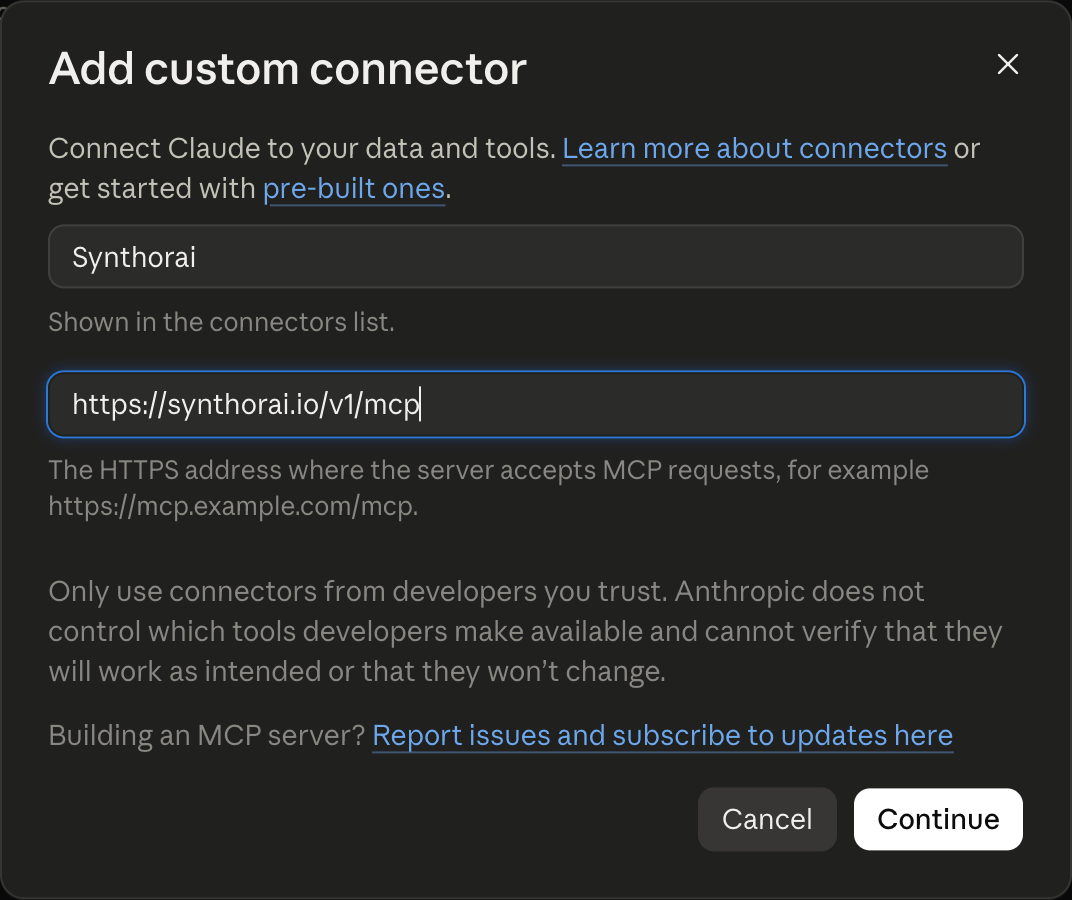
Seleziona Continua e Claude verifica il server. Poi mostra come si collegherà, con due opzioni già rilevate dalle informazioni fornite dal server:
- Autenticazione: «Accedi ora». Ogni persona accede al server prima di usarne i tool. È OAuth: il server chiede di autorizzare la connessione nel browser e fornisce a Claude un access token. Non devi digitare un’API key né salvarla in un file.
- Client OAuth: «Registra automaticamente». Claude si registra sul server al momento della connessione. Non devi creare un client id.
Lascia entrambe le opzioni così come sono e seleziona Aggiungi. Claude ti porta su Synthorai per autorizzare la connessione. Se invece la pagina del connettore indica che la connessione è scaduta, seleziona Riconnetti: nel nostro caso è stato questo passaggio ad aprire la pagina di autorizzazione.
Cosa autorizzi quando accedi?
Scegli il workspace, lo scopo della connessione, i dati a cui può accedere e la scadenza dell’accesso. La pagina è fornita dal gateway. Se non hai già effettuato l’accesso alla sua console, ti chiede prima di accedere:
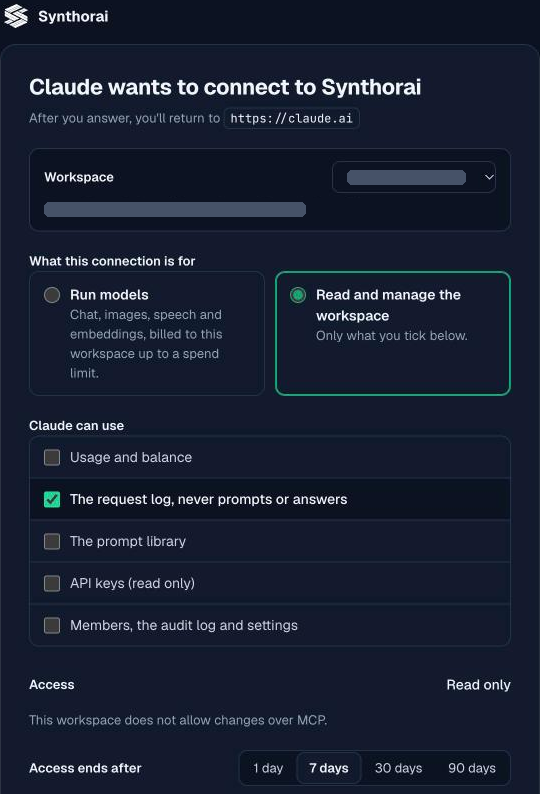
- Workspace. La connessione vede un solo workspace. Scegli quello che contiene le richieste su cui vuoi fare domande.
- Scopo della connessione. «Eseguire modelli» permette a Claude di chiamare modelli tramite il gateway, addebitando i costi al workspace. Per questa guida usiamo «Leggere e gestire il workspace», che concede soltanto i permessi selezionati sotto.
- Dati utilizzabili da Claude. Cinque gruppi: utilizzo e saldo, log delle richieste, libreria dei prompt, API key (sola lettura), membri con log di audit e impostazioni. Abbiamo selezionato soltanto il log delle richieste.
- Accesso. Sola lettura. Il nostro workspace non consente modifiche tramite MCP, in base a un’impostazione del workspace, quindi la pagina non offre altre opzioni.
- Scadenza dell’accesso. 1, 7, 30 o 90 giorni. Abbiamo lasciato 7.
Seleziona Consenti e il browser torna a Claude, che indica il connettore come collegato e ne elenca i tool:
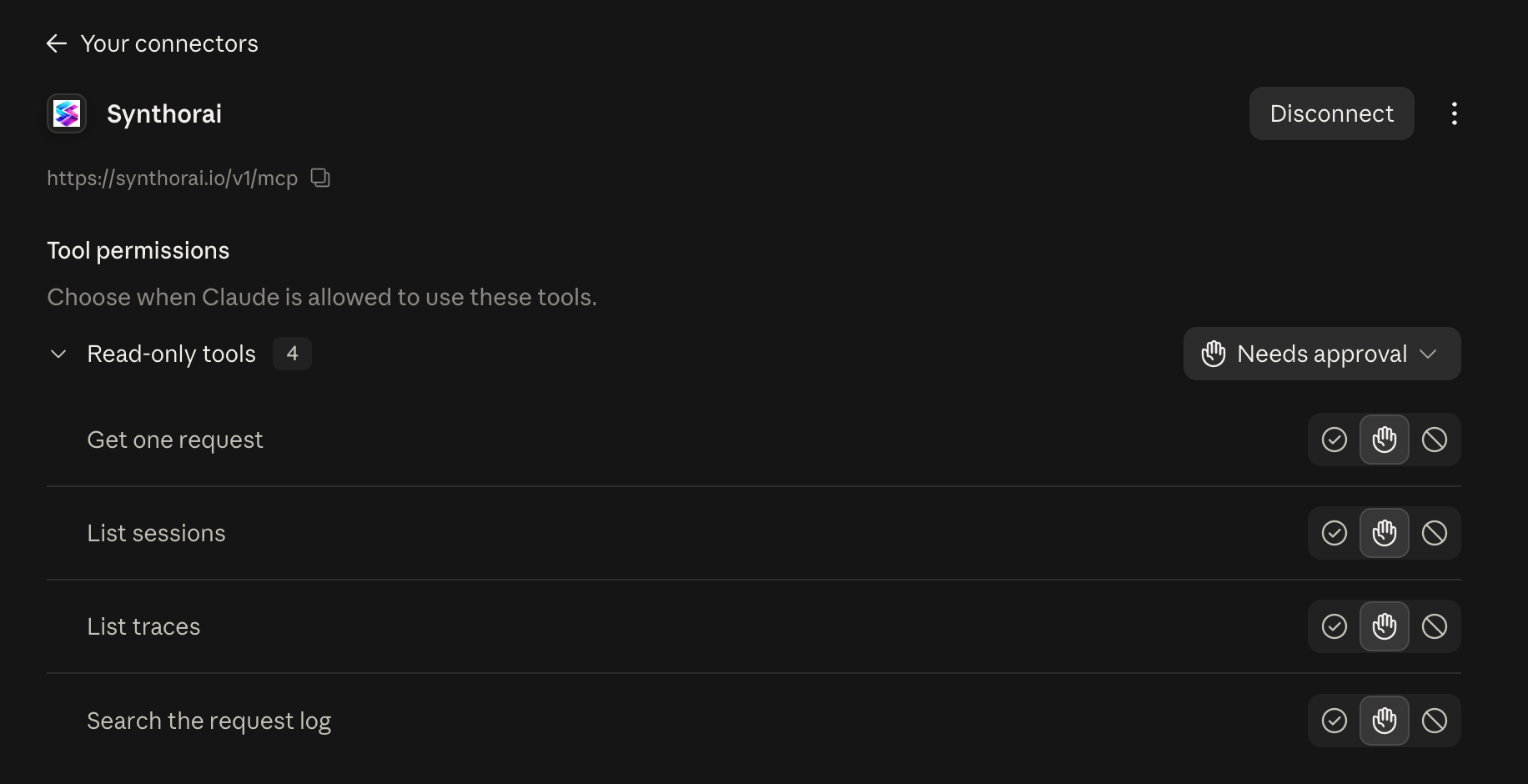
Il connettore ha quattro tool, tutti di sola lettura: search_requests, get_request, list_sessions e list_traces. Restituiscono i dati della chiamata e del suo esito (modello, stato, token, costo, tempi, sessione, trace ed etichette), mai il prompt o la risposta. In questa pagina puoi anche impostare ciascun tool come sempre consentito, soggetto ad approvazione oppure bloccato.
Dove compare la connessione nel gateway?
Compare come chiave dedicata nella sezione API key, nella scheda Chiavi amministrative:
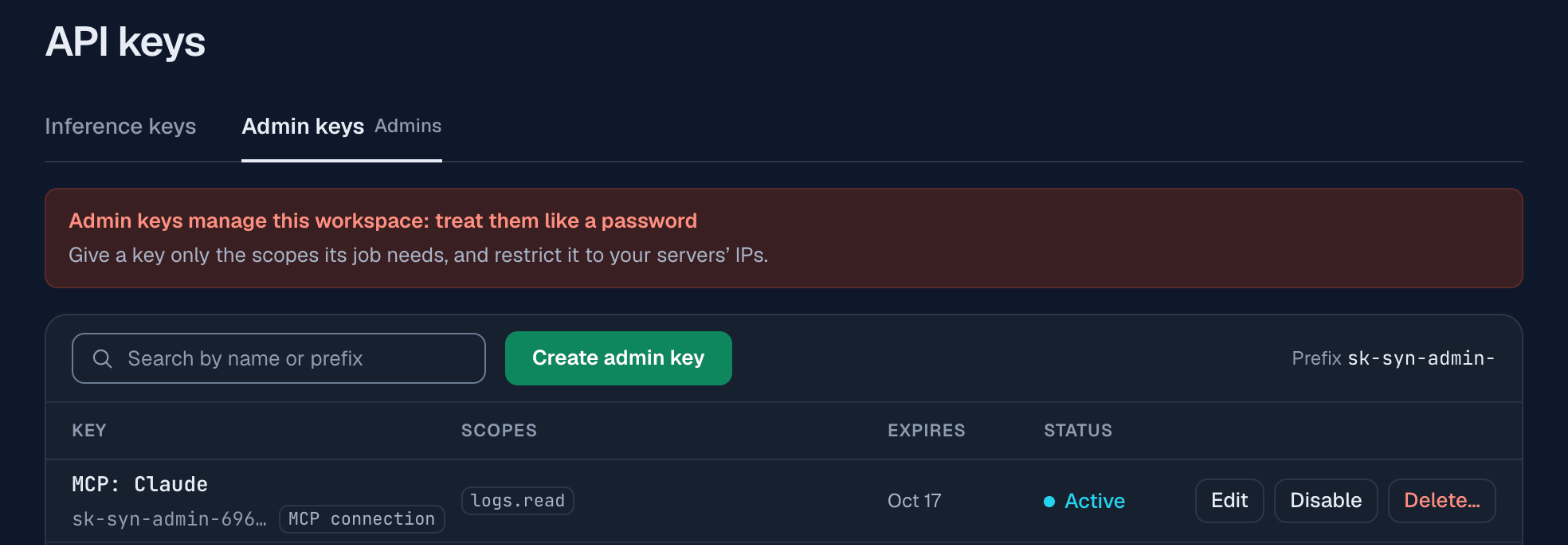
La chiave si chiama MCP: Claude, ha l’unico scope selezionato (logs.read) e scade nel giorno scelto. Uno scope è un permesso associato a una chiave. Non vedi né gestisci direttamente la chiave, ma puoi disabilitarla o eliminarla qui. La connessione si interrompe subito, indipendentemente da ciò che Claude ha memorizzato.
Quali domande abbiamo fatto, e le risposte erano corrette?
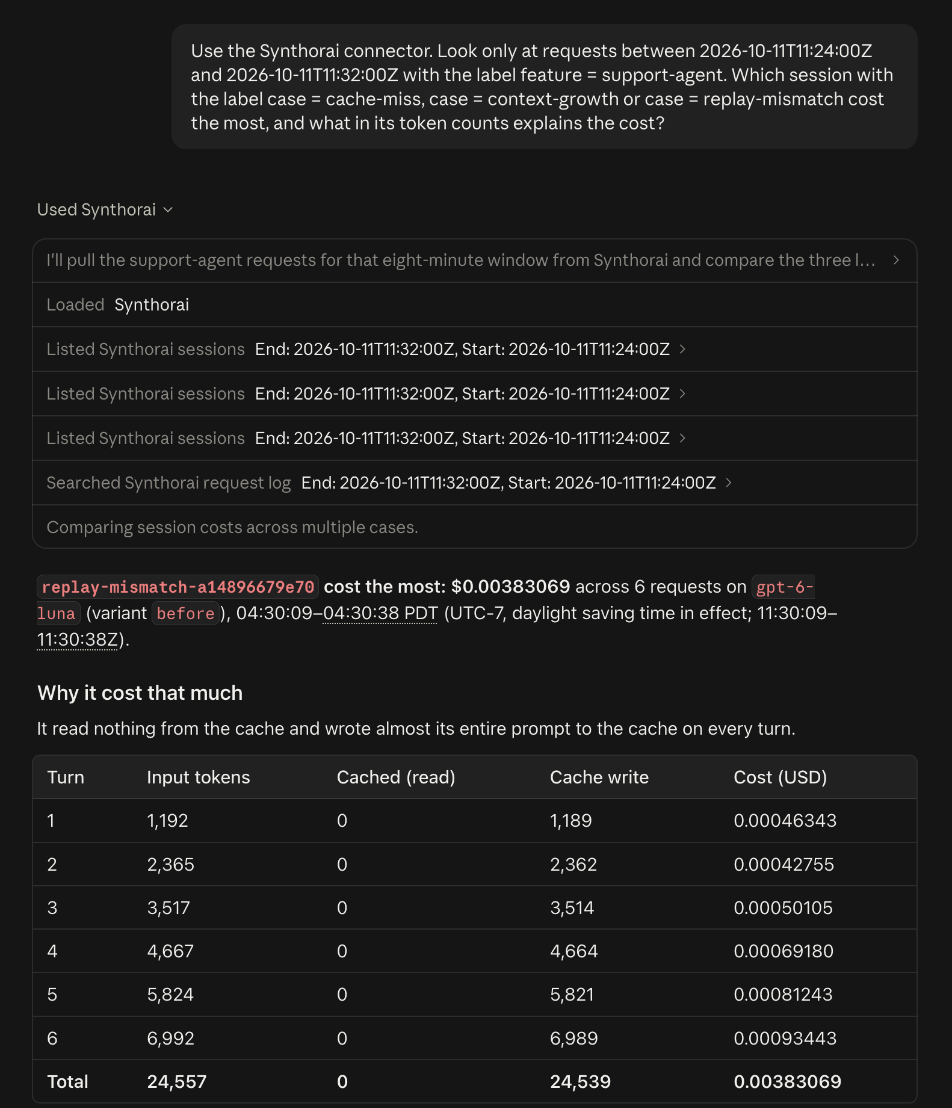
Abbiamo fatto tre domande sulle richieste appena eseguite dalle demo di questa serie. Tutti i valori nelle risposte corrispondevano ai dati di fatturazione stampati dagli script delle demo. Ogni domanda specifica un intervallo temporale e un’etichetta per delimitare la ricerca. Un’etichetta è una coppia chiave-valore che l’applicazione invia con ogni richiesta nell’header X-Synthorai-Metadata. Le demo assegnano a ogni richiesta le etichette feature, case (il problema riprodotto) e variant (before per l’esecuzione con il problema, after per quella corretta, la sua controparte). La cache dei prompt, citata nelle risposte, applica una tariffa inferiore ai prefissi ripetuti: una scrittura al primo invio, poi una lettura.
Usa il connettore Synthorai. Considera soltanto le richieste tra 2026-10-11T11:24:00Z e 2026-10-11T11:32:00Z con l’etichetta feature = support-agent. Quale sessione con etichetta case = cache-miss, case = context-growth o case = replay-mismatch è costata di più, e quali conteggi dei token ne spiegano il costo?
| Domanda | Risposta di Claude | Chiamate ai tool | Dati di fatturazione |
|---|---|---|---|
Quale sessione cache-miss, context-growth o replay-mismatch è costata di più, e perché? | replay-mismatch-a14896679e70, $0.003831 per 6 richieste: nessuno dei suoi 24,557 token di input è stato letto dalla cache. La controparte ne ha letti 18,844 su 24,702 ed è costata $0.001522 | 3 × list_sessions, 1 × search_requests | $0.003831, 24,557 di input, 0 dalla cache; $0.001522, 24,702 di input, 18,844 dalla cache |
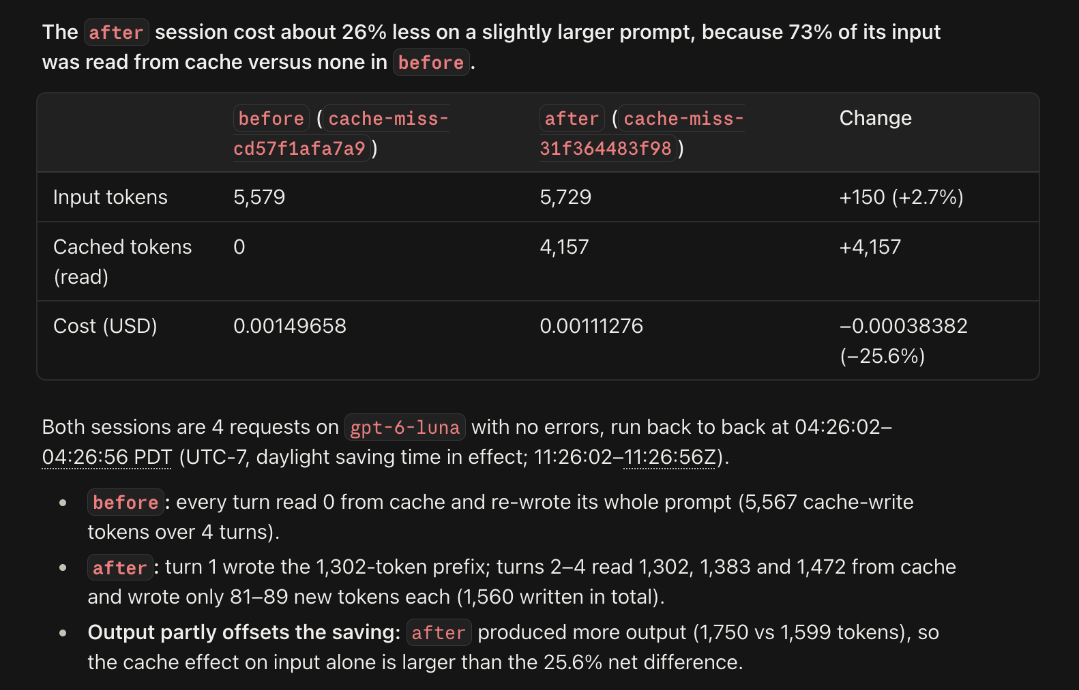
Confronta le due sessioni cache-miss, prima e dopo la correzione | Prima: 5,579 token di input, 0 dalla cache, $0.001497. Dopo: 5,729, 4,157 dalla cache (73%), $0.001113, il 25.6% in meno | 2 × list_sessions, 1 × search_requests | 5,579, 0 e $0.001497; 5,729, 4,157 e $0.001113 |
Ci sono richieste fallite per u_1001? E per u_1002? | Una delle 11 richieste di u_1001, un 404 per un modello inesistente, è stata ritentata con successo un secondo dopo. Tutte le 10 richieste di u_1002 sono riuscite | 7 × search_requests | 21 chiamate nelle due conversazioni, un 404 |
Tre aspetti delle risposte vanno oltre la semplice lettura dei numeri:
- Ha usato le etichette senza istruzioni specifiche. Aprendo una chiamata al tool nella chat se ne vedono gli argomenti: la prima chiamata a
list_sessionscontenevalabelsconcase = cache-missefeature = support-agent, l’intervallo temporale e un limite di 50. Ha eseguito una chiamata per ciascun caso. Per la terza domanda ha prima cercato quale campo contenesse l’utente, ha trovato l’etichetta_usere l’ha usata come filtro. - Ha individuato il confronto che avrebbe fatto una persona. La prima risposta riguarda la sessione di Perché il mio agente LLM costa così tanto? in cui un messaggio era stato salvato in modo diverso da come era stato inviato. Claude ha trovato la controparte corretta tramite l’etichetta
variant = after, ha osservato che il volume dei prompt era quasi identico e ha attribuito la differenza di 2.5x ai token scritti in cache rispetto a quelli letti. Ha anche elencato i singoli turni della sessione più costosa: con la crescita del prompt, il costo raddoppia all’incirca dal primo al sesto turno. - Ha chiarito cosa mostrano i numeri e cosa no. La seconda risposta segnala che la sessione corretta ha prodotto più output (1,750 token contro 1,599), quindi il risparmio sul solo input è superiore alla differenza netta del 25.6%. La prima precisa che il connettore non restituisce il contenuto dei prompt, quindi non può vedere cosa abbia impedito la corrispondenza con la cache.
Abbiamo verificato anche la spiegazione della prima risposta, non soltanto i numeri. Il modello usato in quelle sessioni è GPT-6 Luna, che addebita, per milione di token, $0.10 per l’input, $0.01 per l’input letto dalla cache, $0.125 per l’input scritto in cache e $0.50 per l’output. A queste tariffe, i 24,539 token scritti in cache, gli altri 18 token di input e i 1,523 token di output della sessione più costosa danno un totale di $0.003831. Per la controparte, 5,840 token scritti, 18,844 letti, altri 18 token di input e 1,204 token di output danno $0.001522. Entrambi i totali coincidono con gli importi addebitati, quindi la spiegazione basata sulla differenza tra scritture e letture è corretta.
Cosa va verificato in una risposta?
Controlla prima l’ambito delle chiamate ai tool, poi le spiegazioni che dipendono dalle tariffe o dalla tua configurazione. I numeri delle nostre tre risposte erano corretti. I valori copiati dal risultato di un tool sono i più affidabili; percentuali e rapporti sono calcoli del modello, quindi vanno ricontrollati. Quattro aspetti possono comunque trarre in inganno:
- La risposta copre soltanto ciò che le chiamate ai tool hanno cercato. Ogni chiamata ha un intervallo temporale, etichette e un limite. La chat elenca tutte le chiamate con i relativi argomenti, quindi puoi verificare se «la sessione più costosa» sia stata scelta tra tutte le sessioni o soltanto tra le prime 50.
- Le spiegazioni si basano su conoscenze generali. I dati registrano cosa è successo. Il motivo è una deduzione del modello e potrebbe non essere valido per i tuoi modelli o le tue tariffe. Ricalcola un valore, come abbiamo fatto sopra, prima di intervenire sulla base di una spiegazione.
- Gli orari sono mostrati nel tuo fuso orario. Il log è in UTC e abbiamo formulato le domande in UTC. Le risposte riportavano gli orari del Pacifico, il fuso che Claude aveva per il nostro account, quindi confrontali con l’intervallo UTC della domanda.
- I tool non restituiscono mai i contenuti. Claude può dirti che una richiesta è fallita con un 404 e riportare il messaggio di errore. Non può dirti cosa abbia chiesto l’utente e lo segnala quando la domanda richiede questa informazione.
Un’etichetta e un intervallo temporale ristretto mantengono la risposta precisa e contenuta, perché ogni riga restituita da un tool entra nella conversazione.
Quanto costa, e come si limita l’accesso?
Le chiamate ai tool dei log sono gratuite e il lavoro del modello rientra nel tuo piano Claude, quindi le domande non aggiungono costi alla fattura del gateway. Un’indagine lunga consuma però la quota del piano, perché i risultati dei tool contano come contenuto della conversazione.
La connessione è limitata a ciò che hai autorizzato:
- Un solo gruppo di dati. Abbiamo selezionato soltanto il log delle richieste, quindi la connessione non ha tool per saldi, prompt, chiavi o membri.
- Sola lettura. Nessun tool modifica dati o chiama un modello.
- Una scadenza. La chiave scade dopo il periodo scelto e puoi eliminarla prima.
- Nessun testo di prompt o risposte. I tool restituiscono soltanto metadati.
- Permessi dei tool in Claude. Ogni tool può essere impostato per chiedere conferma prima dell’esecuzione, l’opzione predefinita nella pagina del connettore. La nostra chat usava la modalità di autorizzazione Auto di Claude: Claude usa autonomamente i connettori e si ferma soltanto quando qualcosa sembra rischioso. Le chiamate di sola lettura sono quindi partite senza chiedere conferma.
Condividi una chat di questo tipo con cautela. Una risposta può riportare id di sessione, id utente presi dall’etichetta _user e nomi dei modelli.
FAQ
Claude può leggere i log delle mie richieste LLM?
Sì, tramite un connettore verso un server MCP che li espone. Dopo aver aggiunto il gateway Synthorai come connettore personalizzato e autorizzato l’accesso al log delle richieste, Claude può cercare richieste, elencare sessioni e trace e leggere costi, token, stato ed etichette. Non può leggere prompt o risposte, perché i tool non li restituiscono.
Serve un’API key per collegare Claude a un server MCP?
Non serve se il server supporta l’accesso OAuth. Aggiungendo https://synthorai.io/v1/mcp come connettore personalizzato si apre una pagina di autorizzazione. Il gateway crea autonomamente una chiave per la connessione, con i soli scope selezionati e una scadenza da 1 a 90 giorni. La chiave compare nella sezione API key, dove puoi eliminarla.
Quanto è preciso Claude nell’analisi dei log?
Nel nostro test con Claude Fable 5.1, tutti i valori delle tre risposte corrispondevano ai dati di fatturazione: costi, conteggi dei token, numero di richieste e codici di stato. Anche la spiegazione della sessione più costosa si è confermata corretta ricalcolando l’importo dalle tariffe del modello. Controlla comunque su quali chiamate ai tool si basa la risposta.
Quanto costa chiedere a Claude informazioni sui log del gateway?
Non aggiunge costi alla fattura del gateway: i tool dei log sono gratuiti e le tre domande di questa pagina hanno richiesto 14 chiamate ai tool. Il lavoro del modello consuma la quota del tuo piano Claude. Un programma che fa domande tramite API paga invece i token del modello, il cui costo viene misurato in Fornire tool per i log al tuo agente.
È sicuro collegare Claude a un log delle richieste?
La sicurezza dipende da ciò che autorizzi. Questa connessione aveva accesso a un solo gruppo di dati (il log delle richieste), permessi di sola lettura, scadenza dopo 7 giorni e nessun accesso al testo di prompt o risposte. Non può modificare il workspace né chiamare un modello. Eliminando la sua chiave nella sezione API key interrompi la connessione.
Altre letture
- Tracciare un agente LLM: come assegnare alle richieste gli id di sessione e le etichette usati come filtri in queste domande.
- Perché il mio agente LLM costa così tanto?: le sessioni a cui si riferiscono le prime due domande.
- Perché il mio agente LLM è lento? e Fare debug di un agente LLM: lo stesso tipo di indagine, svolta manualmente nella console.
- Costi di Claude Code per sottoagente: come appaiono le sessioni di Claude Code nello stesso log.
- Fornire tool per i log al tuo agente: gli stessi tool usati da un programma con un’API key e il costo dei token del modello.
- Documentazione del server MCP: tutti i tool, gli scope delle chiavi e come limitare una connessione.