
Migliori API LLM Flash 2026: GLM conviene, Gemini 3.8 vince
Indice
- Come si confrontano i nove modelli e come li abbiamo testati?
- Quali modelli rientrano nella fascia Flash e conviene passare all’ultimo?
- Quanto costano i nove modelli?
- Quali input accettano e si può disattivare il thinking?
- Quanto costa un task completo, non un token?
- Quale modello Flash scegliere?
- Quali modelli Flash falliscono con le impostazioni predefinite?
- Basta un modello Flash o serve quello più grande?
- Cosa si rompe quando un modello Flash arriva in produzione?
- Come lo gestisce Synthorai
- FAQ
La migliore API LLM di fascia Flash a settembre 2026 dipende da cosa serve: GLM 5.3 Flash offre il miglior punteggio nei benchmark per dollaro, Gemini 3.8 Flash è il modello più completo e quello da scegliere per audio e video, Claude Sonnet 5 inventa meno risposte ma costa di più, mentre Seed 2.0 Mini è il modello più economico ad aver superato tutti i nostri test. Per fascia Flash intendiamo il modello piccolo e veloce di ciascun vendor. Abbiamo valutato sedici modelli e verificato che, per ogni vendor, il modello attuale supera il precedente modello piccolo. In questo articolo confrontiamo i nove modelli attuali per prezzo di listino, costo della cache, tipi di input, controlli sul ragionamento, benchmark indipendenti, costo per task e problemi riscontrati in produzione.
TL;DR
- Passa al modello attuale di ciascun vendor: Claude Sonnet 5, GPT-5.6 Terra e Gemini 3.8 Flash costano più per token di Haiku 4.5, GPT-5.4 mini e Gemini 3.5 Flash-Lite, ma 2.5-3.9 volte meno per risposta corretta.
- Miglior rapporto qualità-prezzo: GLM 5.3 Flash, con un indice Artificial Analysis di 41.9 a $0.25 per task.
- Migliore in assoluto e nel multimodale: Gemini 3.8 Flash.
- Meno risposte inventate: Claude Sonnet 5, al costo per task più alto.
- Più economico: Seed 2.0 Mini a $0.10 / $0.40.
Come si confrontano i nove modelli e come li abbiamo testati?
Prezzi e funzionalità provengono dalle pagine dei vendor. Per i benchmark abbiamo usato leaderboard indipendenti che eseguono tutti i modelli sullo stesso harness. Il nostro test, invece, serve solo come soglia di ammissione e non come classifica. Le leaderboard sono Artificial Analysis (AA) Intelligence Index v4.3 e il relativo tasso di non allucinazione, che misura quanto spesso un modello rifiuta di rispondere invece di tirare a indovinare, LiveBench, Vals Index e i voti di Arena per testo e WebDev. Il nostro test comprende 11 task con un risultato numerico verificabile, tra cui conteggio di cifre, somma di numeri primi, percorsi su griglia, cambio di monete, potenza modulare e knapsack. Abbiamo eseguito ogni task 3 volte. Abbiamo inoltre letto per intero le risposte a cinque domande su un’azienda, un istituto, una città, una lega e un premio inesistenti, per verificare se il modello rifiutasse di rispondere o inventasse. Per thinking intendiamo i token di ragionamento generati prima della risposta, fatturati come output e configurabili per richiesta con un campo come reasoning_effort. Ogni modello è stato eseguito con l’impostazione predefinita e con tutte le impostazioni di thinking supportate.
| Modello | Indice AA | AA non allucinazione | LiveBench | Vals Index | Arena testo / WebDev | Nostro test: default / migliore | Risposte inventate di default |
|---|---|---|---|---|---|---|---|
| GPT-5.6 Terra | 42.3 a max | 12.1 | 77.9 | 59.6 | 1466 / 1521 | 31 / 33 | 2 su 5 |
| GLM 5.3 Flash | 41.9 | 72.4 | 71.6 | 47.2 | 1475 / 1607 | 31 / 31 | 0 su 5 |
| Gemini 3.8 Flash | 41.2 a high | 44.8 | 75.8 | 62.3 | 1493 / 1568 | 32 / 33 | 0 su 5 |
| Qwen3.8 Flash | 39.9 | 54.7 | 76.2 | non presente | non presente / 1635 | 33 / 33 | 2 su 5 |
| DeepSeek V4.1 Flash | 39.5 a max | 3.5 | 81.1 | 57.9 | non presente / 1614 | 33 / 33 | 4 su 5 |
| Claude Sonnet 5 | 38.4 a max | 60.6 | 76.0 | 59.6 | 1461 / 1537 | 33 / 33 | 0 su 5 |
| GPT-5.6 Luna | 37.5 a max | 7.4 | 73.6 | 59.9 | 1453 / 1519 | 31 / 32 | 4 su 5 |
| Hy3 | 25.8 | 25.9 | non presente | non presente | 1456 / 1513 | 33 / 33 | 0 su 5 |
| Seed 2.0 Mini | non presente | non presente | non presente | non presente | non presente | 33 / 33 | 0 su 5 |
Fonti consultate il 2026-09-17: Artificial Analysis, LiveBench, Vals Index, Arena testo e Arena WebDev. I punteggi Arena sono rating in stile Elo, quindi una differenza di 20 punti è ridotta. Qwen3.8 Flash compare con il nome Qwen3.8-Flash-Next, il modello open-weight su cui si basa l’API. Le misurazioni sono state eseguite il 2026-09-16 e il 2026-09-17. Due modelli sono stati eseguiti di nuovo il secondo giorno per verificare la comparabilità dei risultati.
Nessun modello è primo in tutte le leaderboard: Terra guida l’indice, DeepSeek LiveBench, Gemini 3.8 Flash Vals e Arena testo, Qwen3.8 Flash Arena WebDev. Il tasso di non allucinazione di AA e le nostre cinque domande inventate concordano su quali modelli tendono a indovinare: DeepSeek V4.1 Flash, Luna e Terra rifiutano raramente di rispondere, mentre GLM 5.3 Flash e Sonnet 5 lo fanno spesso. Seed 2.0 Mini non compare in nessun benchmark indipendente, quindi il nostro test è l’unico dato disponibile.
Quali modelli rientrano nella fascia Flash e conviene passare all’ultimo?
Il modello piccolo più recente di ogni vendor rientra nella fascia Flash, e conviene sempre usare quello. Google, DeepSeek, Alibaba, Z.ai, ByteDance e Tencent chiamano i propri modelli Flash, Mini oppure offrono un solo modello economico. L’attuale generazione di Anthropic comprende Fable, Opus e Sonnet, mentre Haiku 4.5 appartiene alla generazione precedente (ottobre 2025, ritiro non prima del 15 ottobre 2026). Consideriamo quindi Claude Sonnet 5 come modello Flash di Claude. La documentazione di OpenAI colloca GPT-5.6 Terra nella precedente fascia mini e GPT-5.6 Luna nella fascia nano. Sonnet 5 ($2 / $10) e Terra ($2 / $12) costano per token diverse volte più degli altri sette modelli e ricadono in una fascia di prezzo separata.
Abbiamo valutato anche il precedente modello piccolo di quattro vendor, misurando il costo per risposta corretta: la spesa totale delle 33 run divisa per il numero di risposte corrette. Un modello corretto solo la metà delle volte paga quindi il doppio per risposta. Il modello attuale ha vinto ogni confronto. Nelle tre coppie citate nel TL;DR costa di più per token, ma meno per risposta corretta:
- Claude Sonnet 5 rispetto a Claude Haiku 4.5. Haiku ha raggiunto 32 su 33 solo con thinking al massimo. Sonnet 5 ha ottenuto 33 su 33 con ogni impostazione che abilita il thinking e, a
max, la sua opzione più economica, è costato 2.9 volte meno per risposta corretta. Entrambi hanno rifiutato tutte e cinque le domande inventate. - GPT-5.6 Terra rispetto a GPT-5.4 mini. Mini ha ottenuto 9 su 33 con l’impostazione predefinita e ha richiesto
highper arrivare a 33. Terra ha ottenuto 33 conlow, spendendo 2.5 volte meno. Terra ha inventato due risposte, mentre mini ha rifiutato tutte e cinque le domande. - Gemini 3.8 Flash rispetto a Gemini 3.5 Flash-Lite e Gemini 3.7 Flash. Rispetto a Flash-Lite costa 3.9 volte meno per risposta corretta e ha rifiutato le tre domande inventate a cui Flash-Lite ha risposto. Flash-Lite resta utile solo per estrazioni a singolo passaggio. Rispetto a 3.7 Flash, il prezzo di listino è invariato e 3.8 costa circa il 10% in più per chiamata. L’upgrade offre quindi più capacità, non un risparmio.
- GPT-5.6 Luna rispetto a GPT-5.4 nano costa circa un terzo per risposta corretta, a parità di risultato, 31 su 33. Anche Qwen3.8 Flash supera Qwen3.6 Flash e Qwen3.5 Flash, che consumano circa dieci volte più token di thinking e costano da 6 a 27 volte di più per risposta corretta.
Il resto dell’articolo considera solo i nove modelli attuali.
Quanto costano i nove modelli?
Li abbiamo divisi in tre fasce in base al prezzo di listino dell’output. La barra mostra il costo misurato per risposta corretta con l’impostazione migliore di ciascun modello. In questo modo emergono insieme un listino economico e un consumo elevato di thinking. L’etichetta riporta il prezzo di listino e il costo della lettura dalla cache, espresso come quota del prezzo di input per un prefisso ripetuto del prompt.
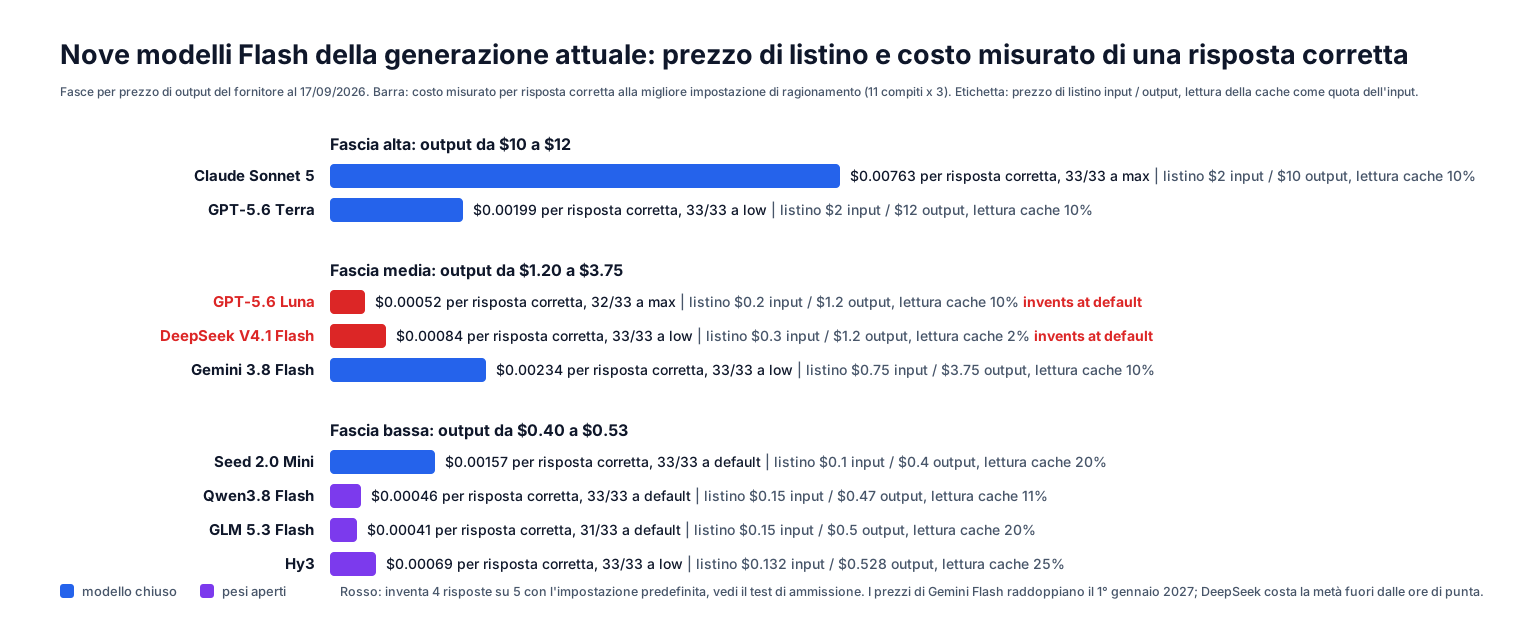
La fascia di prezzo aiuta poco a prevedere il costo effettivo: GPT-5.6 Terra, pur essendo nella fascia più cara, è costato meno per risposta corretta di Gemini 3.8 Flash e solo circa un quarto in più di Seed 2.0 Mini. Il consumo di thinking incide sul costo quanto il listino. I prezzi cambiano spesso e variano anche per orario e area geografica: i prezzi dei modelli Google 3.x Flash raddoppiano il 1 gennaio 2027 (Gemini 3.8 Flash passa a $1.50 / $7.50), DeepSeek applica metà prezzo fuori dalle fasce 01:00-04:00 e 06:00-10:00 UTC nei giorni feriali, OpenAI ha ridotto il prezzo di GPT-5.6 Luna dell’80% a luglio e Qwen3.8 Flash costa dal 19 al 25% in meno fuori dalla regione Singapore di Alibaba. Nei giorni dei test, tre modelli piccoli attuali non erano disponibili su Synthorai e non sono quindi stati misurati: Mistral Small 4 ($0.15 / $0.60), StepFun Step 3.7 Flash ($0.20 / $1.15) e Amazon Nova 2 Lite ($0.30 / $2.50).
Quali input accettano e si può disattivare il thinking?
Otto modelli su nove accettano immagini, quattro ricevono video, due audio e Hy3, il modello Hunyuan 3 di Tencent, supporta solo testo. L’ultima colonna indica se l’estrazione JSON con schema rigoroso ha restituito valori corretti in 8 run su una fattura.
| Modello | Input | Contesto / output max | Open weights | Thinking disattivabile | Thinking predefinito | JSON con schema |
|---|---|---|---|---|---|---|
| Claude Sonnet 5 | testo, immagine | 1M / 128K | no | sì | adaptive, high | 8/8 tramite tool call |
| GPT-5.6 Terra | testo, immagine | 1.05M / 128K | no | sì | medium | 8/8 |
| Gemini 3.8 Flash | testo, immagine, audio, video, PDF | 1M / 64K | no | no | medium | 8/8 |
| GPT-5.6 Luna | testo, immagine | 1.05M / 128K | no | sì | medium | 8/8 |
| DeepSeek V4.1 Flash | testo, immagine | 1M / 384K | MIT | sì | high | solo json_object, 8/8 |
| Seed 2.0 Mini | testo, immagine, audio, video | 256K / 128K | no | sì | medium | 8/8 |
| Qwen3.8 Flash | testo, immagine, video | 1M / 128K | licenza Qwen | sì | xhigh | 3/8, interi errati |
| GLM 5.3 Flash | testo, immagine, video, file | 1M / 128K | MIT | no | max | solo json_object, 8/8 |
| Hy3 | testo | 256K / 128K | Apache 2.0 | sì | high | solo json_object, 7/8 |
“Tramite tool call” significa che lo schema è stato passato come input di un tool e Claude è stato obbligato a invocarlo. “Solo json_object” significa che, con il nostro formato di richiesta, lo schema rigoroso non ha prodotto una risposta corretta, mentre {"type": "json_object"} ha funzionato indicando le chiavi nel prompt. Per l’input audio le opzioni sono Gemini 3.8 Flash o Seed 2.0 Mini. Per output oltre 128K serve DeepSeek V4.1 Flash. Per eseguire il modello su infrastruttura propria, le opzioni open-weight sono DeepSeek, GLM, Hy3 e Qwen3.8 Flash.
Quanto costa un task completo, non un token?
Il costo di una chiamata dipende dal prezzo moltiplicato per i token che il modello decide di consumare. In questa fascia, il secondo fattore varia più del primo. La metrica pubblica più equa è il costo calcolato da Artificial Analysis per eseguire un task del proprio indice, includendo i token di thinking. Il dato è disponibile per otto dei nove modelli.
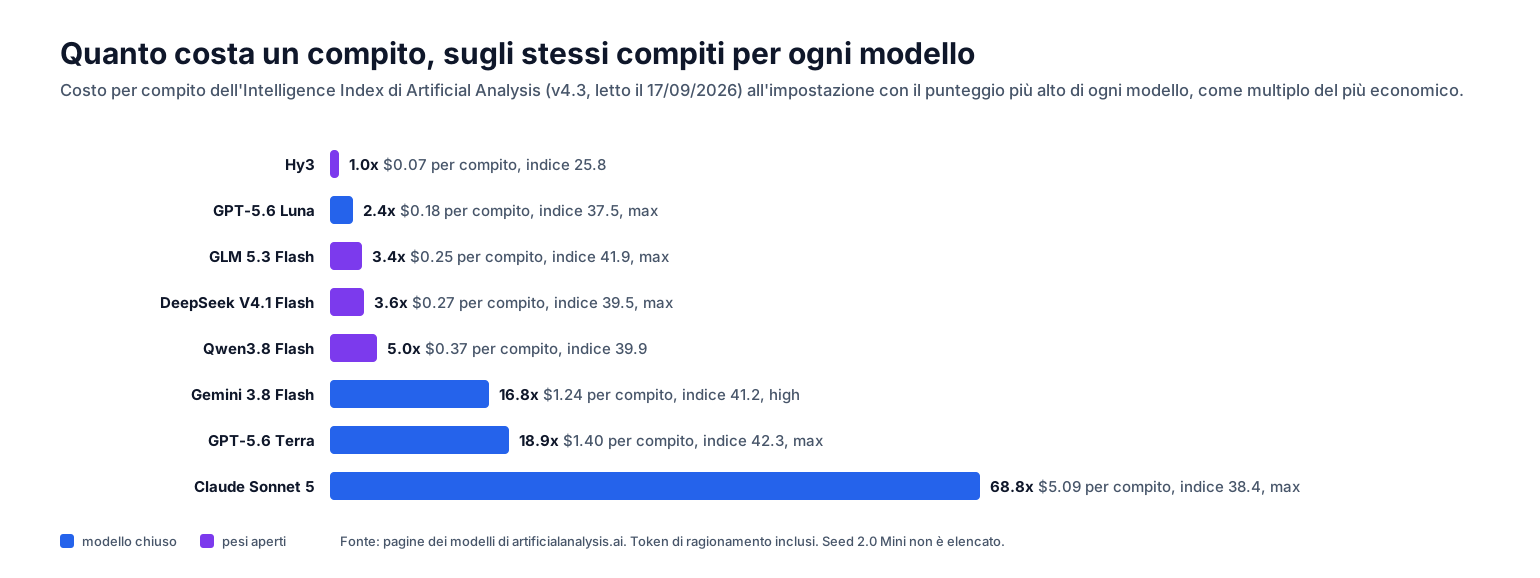
GLM 5.3 Flash è a meno di mezzo punto da GPT-5.6 Terra, ma costa un quinto per task. Qwen3.8 Flash ha un prezzo di listino quasi identico a GLM, ma costa il 50% in più per task perché ha generato 240 milioni di token di output durante l’esecuzione dell’indice, contro i 180 milioni di GLM. Claude Sonnet 5 a max costa $5.09 per task, contro $1.79 con l’impostazione predefinita high, per ottenere sei punti in più nell’indice. Le nostre singole chiamate mostrano lo stesso effetto: Seed 2.0 Mini ha un prezzo di listino inferiore a Qwen3.8 Flash, ma è costato 3.4 volte di più per risposta corretta perché ha usato una mediana di 2,810 token di thinking per task, contro 530.
Le letture dalla cache costano il 2% dell’input con DeepSeek, circa il 10% con Google, OpenAI, Anthropic e Alibaba, il 20% con Z.ai e ByteDance e il 25% con Tencent. Nel traffico agent e RAG, cioè retrieval-augmented generation, dove i documenti recuperati vengono inseriti in ogni prompt, il costo di lettura determina la fattura: un prefisso di 100K token in cache costa $0.0006 per chiamata con DeepSeek V4.1 Flash, contro $0.02 con Sonnet 5 o Terra. OpenRouter ha riferito che il 90% dei token serviti da V4.1 Flash in una giornata dopo il lancio proveniva da letture della cache (post). Le modalità batch, con risposta entro alcune ore, dimezzano i prezzi di Gemini 3.8 Flash, GPT-5.6 Luna, Terra e Sonnet 5. Qwen3.8 Flash, GLM 5.3 Flash e Hy3 non le offrono.
Quale modello Flash scegliere?
GLM 5.3 Flash per il rapporto qualità-prezzo, Gemini 3.8 Flash per prestazioni e input multimodale, Claude Sonnet 5 per ridurre le risposte inventate, Seed 2.0 Mini per il prezzo.
| Esigenza | Scelta | Motivo |
|---|---|---|
| Miglior rapporto qualità-prezzo | GLM 5.3 Flash | indice 41.9, secondo solo a Terra, a $0.25 per task; tasso di non allucinazione più alto tra i nove (72.4); $0.15 / $0.50; input di immagini, video e file; pesi MIT |
| Migliore in assoluto | Gemini 3.8 Flash | primo tra i nove su Vals e Arena testo, 1.1 punti di indice dietro Terra ma con un costo per task inferiore dell’11%; 33 su 33 a low, ha rifiutato tutte le domande inventate |
| Migliore nel multimodale | Gemini 3.8 Flash | input audio, video e PDF, audio fatturato come testo; JSON con schema corretto in 8 casi su 8 |
| Meno risposte inventate, veloce | Claude Sonnet 5 | 33 su 33 con ogni impostazione che abilita il thinking, ha rifiutato tutte e cinque le domande inventate con thinking attivo e disattivato, primo token della risposta in 2.2 secondi; è il più costoso per task, quindi va usato quando una risposta inventata costa più della chiamata |
| Più economico | Seed 2.0 Mini | $0.10 / $0.40; 33 su 33 di default, JSON con schema 8 su 8, ha rifiutato tutte e cinque le domande inventate, input audio e video |
Tre modelli restano fuori dalle raccomandazioni, ciascuno per un motivo diverso. GPT-5.6 Terra ha l’indice più alto e ottiene 33 su 33 a low con un costo di $0.00199 per risposta corretta, ma ha inventato due risposte su cinque a $12 per milione di token di output. DeepSeek V4.1 Flash è primo su LiveBench e ha la cache meno costosa, ma accetta solo testo e immagini e, con il thinking attivo, ha inventato quattro risposte su cinque. Qwen3.8 Flash ha ottenuto il punteggio perfetto più economico nel nostro test, $0.00046 per risposta corretta, ed è primo su Arena WebDev. Ha però inventato due risposte, scritto interi errati con uno schema rigoroso e impiegato quasi tre minuti per una spiegazione di 400 parole.
Meglio instradare le richieste in base al tipo invece di scegliere un solo modello: i task chiusi con risposta verificabile vanno al modello più economico che supera il test (GLM 5.3 Flash, Qwen3.8 Flash, Hy3); le domande fattuali aperte a un modello capace di rifiutare (GLM 5.3 Flash, Sonnet 5, Gemini 3.8 Flash); le lunghe esecuzioni agent al modello più potente compatibile con il budget.
Quali modelli Flash falliscono con le impostazioni predefinite?
Due su nove. Entrambi superano la soglia se le domande aperte vengono instradate verso un’impostazione che rifiuta di rispondere. Le soglie di ammissione, applicate con l’impostazione predefinita del modello, sono almeno 30 task corretti su 33 e non più di due risposte inventate su cinque.
| Modello | Con l’impostazione predefinita | Modifica | Dopo la modifica |
|---|---|---|---|
| DeepSeek V4.1 Flash | ha inventato 4 risposte su 5 (“50 dipendenti”, “1790 °C”, un personaggio dei Simpson come vincitore del premio) | disattivare il thinking per le domande aperte | ha rifiutato 5 domande su 5, ma ha ottenuto 21 su 33 nei task, quindi questa configurazione va usata solo per domande aperte |
| GPT-5.6 Luna | ha inventato 4 risposte su 5 (“circa 20 dipendenti”, “1974”, “1,400 °C”) | disattivare il thinking per le domande aperte | ha rifiutato 4 domande su 5, ma ha ottenuto 7 su 33 nei task, quindi vale lo stesso instradamento |
GPT-5.6 Terra e Qwen3.8 Flash sono esattamente sulla soglia, con due risposte inventate ciascuno (“0 dipendenti” e “circa 1,455 °C” per Terra). Per le domande aperte vanno quindi trattati allo stesso modo.
Basta un modello Flash o serve quello più grande?
Per attività circoscritte, basta. Nei benchmark agent più brevi, dove il modello opera in una shell su repository reali, DeepSeek V4.1 Flash supera DeepSeek V4 Pro su Terminal-Bench 2.1 (90.6 contro 87.9) e DeepSWE (74.2 contro 62.7). Gemini 3.8 Flash ottiene 89.4 su Terminal-Bench 2.1, contro 89.1 di Claude Opus 5. Tutti e nove i modelli hanno completato 3 volte su 3 il nostro loop di tool calling in due turni.
Il divario torna ampio sui task lunghi e sui contesti estesi. Nella tabella di Google per Terminal-Bench 4.0, Gemini 3.8 Flash ottiene 19.1 contro 51.8 di Opus 5. Nel test multi-needle retrieval di OpenAI tra 512K e 1M token, GPT-5.6 Luna ottiene 41.3 contro 72.5 di GPT-5.6 Terra. Una finestra da 1M non garantisce quindi un richiamo affidabile di 1M token sui modelli più piccoli. I modelli Flash sono adatti a estrazione, classificazione, brevi passaggi con tool e modifiche al codice dalla struttura nota. Per pianificare lunghe esecuzioni agent e rispondere su documenti molto estesi, conviene usare un modello più grande.
Cosa si rompe quando un modello Flash arriva in produzione?
I problemi dipendono più dai default e dalla forma delle richieste che dalle capacità del modello.
- Due modelli non permettono di disattivare il thinking. Gemini 3.8 Flash e GLM 5.3 Flash hanno restituito un errore 400 con tutte le impostazioni di disattivazione provate.
- I default si trovano ai due estremi. GLM 5.3 Flash usa
maxdi default e Qwen3.8 Flash usaxhigh(Alibaba). Sulle nostre cinque domande inventate, Qwen3.8 Flash ha consumato una mediana di 11,680 token di ragionamento. Google include il thinking inmax_output_tokens, quindi un limite troppo basso può produrre una risposta troncata o vuota che viene comunque fatturata (guida al thinking). - Claude usa controlli propri. Claude Sonnet 5 configura la profondità del thinking con
output_config.efforte rifiuta il precedentebudget_tokens(effort);reasoning_effortnon è un suo parametro. - Nei loop con tool bisogna reinviare il ragionamento. La modalità thinking di DeepSeek richiede il
reasoning_contentdei turni precedenti (modalità thinking), mentre Gemini associa thought signature alle parti delle function call. I framework che ricostruiscono la cronologia dei messaggi eliminano entrambi. - Il JSON rigoroso non è uniforme. Qwen3.8 Flash ha rispettato i tipi dello schema, ma in 5 run su 8 ha scritto interi errati (
-561994nelle righe della fattura). Con Qwen, GLM, Hy3 e DeepSeek è meglio usarejson_object, indicando le chiavi nel prompt. Con Claude, va usata una tool call. - Il thinking modifica l’affidabilità delle risposte. DeepSeek V4.1 Flash ha inventato quattro risposte su cinque con il thinking attivo e nessuna con il thinking disattivato.
- Gli ID dei modelli cambiano.
deepseek-v4-flashserve V4.1 Flash dal 10 settembre (prezzi) e Claude Haiku 4.5 potrebbe essere ritirato dal 15 ottobre (deprecazioni). Quando disponibile, conviene fissare uno snapshot datato, comeseed-2-0-mini-260428. - Gli host di terze parti per modelli open-weight non sono equivalenti. DeepSeek, GLM, Qwen e Hy3 sono offerti da molti provider con quantizzazione e comportamento della cache diversi. A settembre è stato scoperto che un reseller inoltrava le richieste a pagamento verso un modello più economico (Hacker News). Confronta le risposte del tuo provider con quelle dell’API ufficiale del vendor.
La velocità dipende più dall’impostazione predefinita del thinking che dalle dimensioni del modello. Abbiamo misurato una spiegazione in streaming di 400 parole con il default di ogni modello, 3 run ciascuno, il 2026-09-17:
| Modello, impostazione predefinita | Primo token della risposta | Tempo totale | Token di output al secondo |
|---|---|---|---|
| Claude Sonnet 5 | 2.2 s | 10.5 s | 70 |
| Gemini 3.8 Flash | 10.7 s | 14.3 s | 114 |
| GPT-5.6 Luna | 24.9 s | 26.1 s | 89 |
| GPT-5.6 Terra | 33.3 s | 34.2 s | 63 |
| GLM 5.3 Flash | 36.7 s | 39.3 s | 128 |
| DeepSeek V4.1 Flash | 40.4 s | 40.6 s | 158 |
| Seed 2.0 Mini | 61.3 s | 61.5 s | 81 |
| Hy3 | 123.0 s | 134.5 s | 35 |
| Qwen3.8 Flash | 159.9 s | 165.8 s | 72 |
I token al secondo includono ragionamento e risposta per l’intera chiamata. Il thinking adattivo di Sonnet 5 non ha consumato token per un task di scrittura e ha iniziato subito a rispondere. Qwen3.8 Flash ha invece usato una mediana di 10,697 token di ragionamento. Un prompt aperto può quindi richiedere minuti anche su un modello economico nei task chiusi.
L’impostazione occupa un solo campo in una richiesta compatibile con OpenAI e il consumo di thinking viene restituito in usage:
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key="sk-syn-...")
r = client.chat.completions.create(
    model="gemini-3.8-flash",          # or glm-5.3-flash, gpt-5.6-terra, ...
    reasoning_effort="low",
    max_tokens=32768,
    messages=[{"role": "user", "content": "Compute 7 raised to the power 222, modulo 1000. Reply with a single integer."}],
)
u = r.usage
print(r.choices[0].message.content, u.completion_tokens, u.completion_tokens_details.reasoning_tokens)
Per Claude Sonnet 5, invia la stessa richiesta alla Messages API con output_config: {"effort": "low"}.
Come lo gestisce Synthorai
Tutti i modelli citati sono disponibili tramite un singolo ID model sullo stesso endpoint, compatibile con OpenAI o Anthropic. La pagina di confronto dei modelli permette di confrontarne due per prezzo, cache, tipi di input, contesto e benchmark dei vendor. I prezzi correnti di tutti e nove sono disponibili nella comparazione dei prezzi dei modelli.
FAQ
Claude Sonnet 5 è un modello Flash? Anthropic non lo definisce così, ma è il modello più piccolo dell’attuale generazione Claude, dato che Claude Haiku 4.5 risale a ottobre 2025 e potrebbe essere ritirato dal 15 ottobre 2026. Claude Sonnet 5 costa $2 / $10 contro $1 / $5 di Haiku, ma nel nostro test è costato 2.9 volte meno per risposta corretta.
L’API Gemini Flash è gratuita? Gemini 3.8 Flash offre un piano gratuito in Google AI Studio, ma Google usa i contenuti del piano gratuito per migliorare i propri prodotti (prezzi) e consente solo il servizio a pagamento per le applicazioni destinate a SEE, Svizzera o Regno Unito (termini). Il piano a pagamento costa $0.75 / $3.75 fino al 31 dicembre 2026, poi $1.50 / $7.50.
Meglio Gemini Flash o Flash-Lite? Gemini 3.8 Flash, a meno che ogni richiesta non sia un’estrazione a singolo passaggio. Ottiene 41.2 nell’indice Artificial Analysis contro 23 di Gemini 3.5 Flash-Lite, nel nostro test è costato 3.9 volte meno per risposta corretta e ha rifiutato tutte e cinque le domande inventate, mentre Flash-Lite ha risposto a tre. Flash-Lite costa $0.30 / $2.50 e risponde in circa 4 secondi.
GPT-5.6 Luna o GPT-5.6 Terra?
GPT-5.6 Luna per i grandi volumi, GPT-5.6 Terra per il ragionamento più complesso. Luna costa $0.20 / $1.20 e ha ottenuto 31 su 33 con il default, a $0.00030 per risposta corretta. Terra costa $2 / $12, ha ottenuto 33 su 33 a low per $0.00199 e ha il punteggio di indice più alto tra i nove. Entrambi hanno inventato risposte con il default: Luna quattro su cinque, Terra due.
Qual è il miglior modello Flash per il coding? Qwen3.8 Flash, DeepSeek V4.1 Flash e GLM 5.3 Flash guidano Arena WebDev (1635, 1614 e 1607). DeepSeek è primo nella categoria agentic coding di LiveBench (77.3). DeepSeek e Claude Sonnet 5 guidano Vibe Code Bench di Vals (84.7 e 81.3).
Correlati: costo dell’API DeepSeek V4.1 Flash, costo dell’API GLM 5.3, costo dell’API Gemini 3.7 Flash, prompt caching tra provider, miglior LLM per caso d’uso.