
Costo API GLM 5.3: pensa sempre, 2.5x meno di 5.2 per risposta
Indice
- Cos’è GLM 5.3 e quanto costa?
- È ancora possibile disattivare il ragionamento?
- Quale livello di effort produce risposte corrette?
- Inventa risposte quando una domanda non ne ha una?
- GLM 5.3 rispetta uno schema JSON?
- Quanto costa un’immagine su GLM 5.3 Flash?
- Cos’altro è cambiato rispetto a GLM 5.2?
- Come lo gestisce Synthorai
- FAQ
GLM 5.3 costa come GLM 5.2: $1.40 per milione di token in input e $4.40 per milione in output. Non è più possibile disattivare il ragionamento: ogni tentativo restituisce un errore 400 e il livello predefinito è max. Abbiamo eseguito tre volte 11 task con una risposta verificabile. max è stata l’unica impostazione a ottenere 33 risposte corrette su 33, con un costo di $0.00468 per risposta corretta, 2.5x inferiore rispetto a GLM 5.2 con max, perché GLM 5.3 usa circa la metà del ragionamento. low costa il 63% in meno per risposta corretta, ma ne sbaglia 5 su 33. GLM 5.3 Flash arriva a 31 su 33 a un decimo del prezzo. reasoning_effort, il parametro che stabilisce quanto a lungo il modello ragiona prima di rispondere, ora determina sia l’accuratezza sia il costo. Abbiamo misurato entrambe le versioni insieme a GLM 5.2 e DeepSeek V4.1 Flash nello stesso batch.
TL;DR
- GLM 5.3 e GLM 5.3 Flash rifiutano
thinking: disabled,reasoning_effort: noneemediumcon l’errore 1210. Funzionano sololow,highemax, che è il valore predefinito. - Con
max, GLM 5.3 ha ottenuto 33 risposte corrette su 33 a $0.00468 per risposta corretta. GLM 5.2 conmaxè costato $0.01173. - Con
low, GLM 5.3 ha ottenuto 28 risposte corrette su 33 e GLM 5.3 Flash 24 su 33. - Entrambe le versioni di GLM 5.3 ignorano un
json_schemastrict.json_objectha restituito i valori corretti 8 volte su 8.
Cos’è GLM 5.3 e quanto costa?
È GLM 5.2 riaddestrato, allo stesso prezzo, affiancato da un modello più piccolo che costa un decimo. Secondo la guida di Z.ai, GLM 5.3 “usa lo stesso modello di base di GLM-5.2 e tutti i miglioramenti derivano dal post-training”. Accetta solo testo. GLM 5.3 Flash ha “320B parametri totali, di cui 18B attivi”: solo 18B lavorano su ciascun token, riducendo così i costi. Accetta immagini, video e file. Entrambi hanno un contesto da 1M token e un output massimo di 128K. Questi sono i prezzi per milione di token riportati nella pagina dei prezzi di Z.ai:
| Modello | Input | Input dalla cache | Output |
|---|---|---|---|
| GLM 5.3 | $1.40 | $0.26 | $4.40 |
| GLM 5.3 Flash | $0.15 | $0.03 | $0.50 |
| GLM 5.2 | $1.40 | $0.26 | $4.40 |
| DeepSeek V4.1 Flash | $0.30 nelle ore di punta | $0.006 nelle ore di punta | $1.20 nelle ore di punta |
La scheda del modello e la guida di Flash di Z.ai attribuiscono i miglioramenti soprattutto ai task agentici e di coding:
| Benchmark | Cosa misura | GLM 5.2 | GLM 5.3 | GLM 5.3 Flash |
|---|---|---|---|---|
| Terminal Bench 3.0 | task agentici in un terminale | 4.6 | 28.3 | non indicato |
| DeepSWE v1.1 | correzione di repository reali | 46.2 | 66.9 | 63.4 |
| AutomationBench | automazione dei workflow | 26.2 | 48.2 | 48.8 |
| CyberGym | task sulle vulnerabilità di sicurezza | 77.2 | 84.5 | non indicato |
| HLE with tools | domande difficili con uso di strumenti | 54.7 | 62.5 | non indicato |
Di seguito riportiamo ciò che abbiamo potuto verificare direttamente: task con un’unica risposta verificabile, non benchmark agentici.
È ancora possibile disattivare il ragionamento?
No. GLM 5.2 accettava thinking: {"type": "disabled"}. GLM 5.3 e GLM 5.3 Flash restituiscono HTTP 400 con il codice di errore 1210 (“questo modello ragiona sempre; non è possibile disattivare il ragionamento; usa low, high o max”) quando si usa thinking: disabled, enable_thinking: false oppure si imposta reasoning_effort su none, minimal, medium o xhigh. Se reasoning_effort viene omesso, il valore è max. thinking_budget, il limite ai token di ragionamento supportato da alcuni provider, viene accettato ma ignorato da GLM 5.3: con la stessa domanda, tutti i valori da 0 a 1,024 hanno prodotto circa 101 token di ragionamento.
resp = client.chat.completions.create(
    model="glm-5.3",
    messages=[{"role": "user", "content": prompt}],
    reasoning_effort="high",   # "low" | "high" | "max"; omitted means "max"
    max_tokens=8192,           # GLM 5.3 Flash rejects anything above 131,072
)
reasoning_tokens = resp.usage.completion_tokens_details.reasoning_tokens  # billed as output
thinking_text = resp.choices[0].message.reasoning_content                # the thinking itself, as text
La vecchia opzione economica non funzionava bene: con il ragionamento disattivato, GLM 5.2 ha risposto correttamente a 10 dei nostri 33 task e DeepSeek V4.1 Flash a 22.
Quale livello di effort produce risposte corrette?
Per GLM 5.3, solo max. Per GLM 5.3 Flash, nessuno. Abbiamo eseguito tre volte 11 task la cui risposta è un singolo numero verificabile: somme di numeri primi, conteggi di cifre, percorsi su griglia, combinazioni di monete, una regola applicata 40 volte, il resto della divisione per 1000 di 7 elevato alla potenza 222, una conversione di base, un problema dello zaino e il conteggio di numeri a quattro cifre soggetti a tre vincoli. I token di ragionamento rappresentano il ragionamento nascosto generato prima della risposta e vengono fatturati come output. Il costo per risposta corretta è la spesa totale divisa per il numero di risposte corrette, calcolata sul prezzo di listino:
| Modello | Effort | Risposte corrette | Token di ragionamento, mediana (massimo) | Costo per risposta corretta |
|---|---|---|---|---|
| GLM 5.3 | low | 28/33 | 143 (1,826) | $0.00173 |
| GLM 5.3 | high | 29/33 | 226 (1,950) | $0.00197 |
| GLM 5.3 | max (predefinito) | 33/33 | 538 (7,733) | $0.00468 |
| GLM 5.3 Flash | low | 24/33 | 120 (467) | $0.00012 |
| GLM 5.3 Flash | high | 29/33 | 196 (1,582) | $0.00021 |
| GLM 5.3 Flash | max (predefinito) | 31/33 | 419 (5,024) | $0.00040 |
| GLM 5.2 | max | 33/33 | 1,129 (21,917) | $0.01173 |
| DeepSeek V4.1 Flash | low | 33/33 | 337 (6,797) | $0.00102 |
| DeepSeek V4.1 Flash | max | 33/33 | 386 (10,769) | $0.00138 |
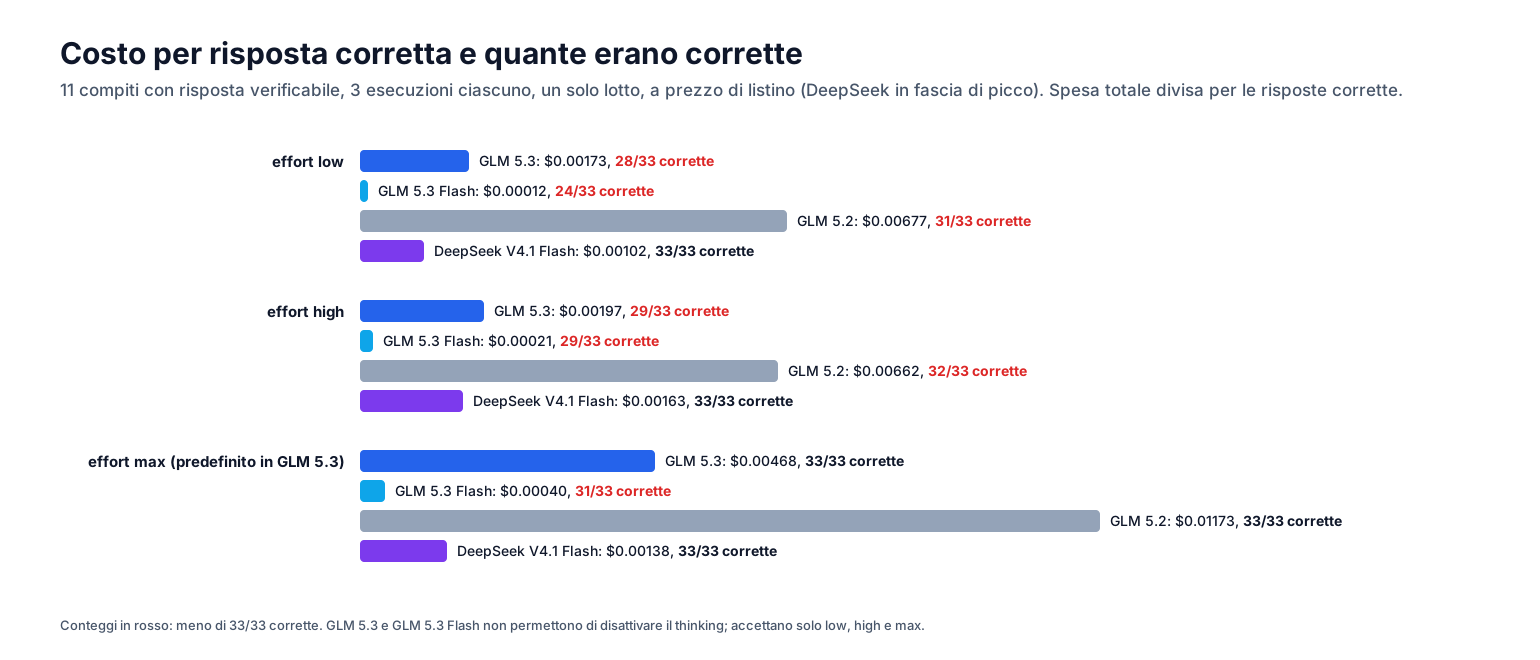
La differenza di 2.5x rispetto a GLM 5.2 dipende dal volume del ragionamento: una mediana di 538 token contro 1,129 e un massimo di 7,733 contro 21,917. Le impostazioni inferiori risparmiano saltando alcuni controlli. Con low, GLM 5.3 ha risposto due volte 216 al problema dei percorsi sulla griglia, mentre una cella bloccata porta il risultato a 132. Ha inoltre sbagliato una volta ciascuno le combinazioni di monete, il problema dello zaino e la conversione di base. GLM 5.3 Flash con low ha sempre fallito la regola in 40 passaggi e il conteggio con vincoli. DeepSeek V4.1 Flash, invece, ha ottenuto 33 su 33 con ogni impostazione.
Su GLM 5.3 conviene mantenere il valore predefinito per qualsiasi task con calcoli aritmetici o più passaggi. low ha senso solo quando una risposta errata è facile ed economica da intercettare. Con max, GLM 5.3 costa 3.4x più di DeepSeek V4.1 Flash per risposta corretta. GLM 5.3 Flash costa meno di un terzo, ma sbaglia 2 risposte su 33.
Inventa risposte quando una domanda non ne ha una?
No, anche con il ragionamento sempre attivo. Abbiamo posto cinque domande su entità inventate, per le quali l’unica risposta corretta era “Non lo so”: il prezzo delle azioni di Verantis Dynamics, il punto di fusione di Oridium-7 e il vincitore del 1987 Pan-Continental Robotics Prize. Abbiamo usato l’effort predefinito con un limite di 16,384 token:
| Modello | Ha dichiarato di non sapere | Ha inventato una risposta | Ha raggiunto il limite senza rispondere | Token di ragionamento | Costo per domanda |
|---|---|---|---|---|---|
| GLM 5.3 | 5/5 | 0/5 | 0/5 | da 230 a 542 | $0.0022 |
| GLM 5.3 Flash | 5/5 | 0/5 | 0/5 | da 238 a 625 | $0.0003 |
| GLM 5.2 | 5/5 | 0/5 | 0/5 | da 134 a 1,559 | $0.0035 |
| DeepSeek V4.1 Flash | 1/5 | 3/5 | 1/5 | da 7,021 a 16,384 | $0.0139 |
Entrambe le versioni di GLM 5.3 hanno dichiarato di non avere informazioni dopo poche centinaia di token di ragionamento. DeepSeek V4.1 Flash ha ragionato per 7,000-16,000 token e poi, nella maggior parte dei casi, ha inventato una risposta (Andrew Martin, the robot protagonist of Isaac Asimov's The Bicentennial Man, won). In un test dedicato eseguito il giorno precedente, più richieste avevano invece raggiunto il limite, ma il modello raramente dichiarava di non sapere. Per le ricerche che possono legittimamente non produrre risultati, questa è la differenza più rilevante che abbiamo misurato tra i due modelli di fascia Flash.
GLM 5.3 rispetta uno schema JSON?
Non uno schema strict. Usa json_object. Impostando response_format su un json_schema strict per estrarre i dati di una fattura, GLM 5.3 e GLM 5.3 Flash hanno restituito HTTP 200 e ignorato lo schema in 16 esecuzioni su 16. Il JSON era racchiuso in un code fence Markdown e conteneva chiavi non richieste dallo schema (invoice_date, reference), quindi nessun risultato poteva essere interpretato come l’oggetto richiesto. La documentazione dell’API di Z.ai elenca solo text e json_object. Il problema è che lo schema viene accettato senza segnalazioni.
Con {"type": "json_object"} e i campi specificati nel prompt, entrambe le versioni hanno restituito tutti i valori corretti in 8 esecuzioni su 8. Lo stesso vale per GLM 5.2 e DeepSeek V4.1 Flash. Poiché il ragionamento resta attivo, l’estrazione usa una mediana di 240 token di output su GLM 5.3 e 140 su Flash, contro 25 su V4.1 Flash con il ragionamento disattivato. Valida comunque il risultato rispetto al tuo schema.
Quanto costa un’immagine su GLM 5.3 Flash?
Il costo cresce con l’area in pixel e non si ferma a 2048x2048. Per questo, nonostante la tariffa inferiore, le immagini grandi costano più che su DeepSeek V4.1 Flash. Abbiamo inviato PNG generati a GLM 5.3 Flash (GLM 5.3 accetta solo testo) e sottratto il costo del prompt contenente solo testo:
| Immagine | Token GLM 5.3 Flash | Costo a $0.15/M | Token DeepSeek V4.1 Flash | Costo a $0.30/M |
|---|---|---|---|---|
| 512x512 | 363 | $0.000054 | 184 | $0.000055 |
| 1024x1024 | 1,371 | $0.000206 | 652 | $0.000196 |
| 2048x2048 | 5,478 | $0.000822 | 994 | $0.000298 |
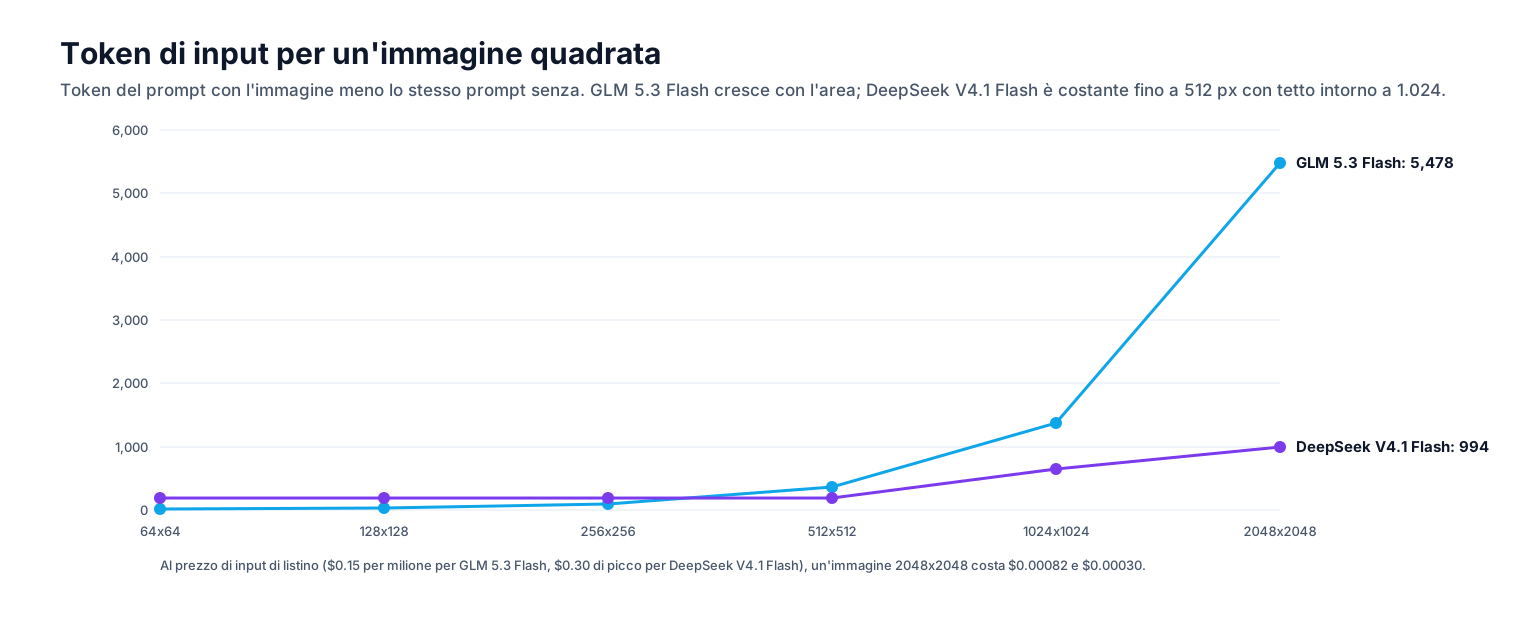
Oltre 512 pixel, GLM 5.3 Flash usa circa un token ogni 766 pixel. detail, il contenuto dell’immagine e il formato del file non modificano il conteggio. I dati di DeepSeek V4.1 Flash provengono dal test del giorno precedente. Ridimensiona screenshot e pagine di documenti prima dell’invio: a 2048x2048, GLM 5.3 Flash costa 2.8x di più per immagine.
Cos’altro è cambiato rispetto a GLM 5.2?
La velocità, ma poco a livello di integrazione. Nella stessa finestra temporale e in streaming con low, GLM 5.3 ha generato da 59 a 64 token di output al secondo, GLM 5.3 Flash da 70 a 82, GLM 5.2 da 51 a 55 e DeepSeek V4.1 Flash da 124 a 161. In un loop di function calling su due turni, ogni modello ha effettuato una chiamata per turno. Le tre versioni GLM conteggiano lo stesso numero di token su testo inglese, cinese e Python, rispettivamente 737, 484 e 488, quindi i token budget possono essere riutilizzati senza modifiche.
La parte iniziale ripetuta di un prompt viene fatturata alla tariffa della cache, con un conteggio a blocchi di 64 token: per un prompt da 1,153 token, 1,024 sono stati letti dalla cache. Entrambe le versioni accettano prompt vicini al limite di 1M token, anche se la scheda del modello Flash indica 300,000 token. Un prompt da 990,000 token con un valore nascosto nella parte iniziale ha restituito quel valore (non abbiamo testato il richiamo di contenuti vicino alla fine). Un prompt da circa 1.07M token ha invece ricevuto un errore 400, Prompt exceeds max length, senza essere troncato. C’è una breaking change da considerare durante l’upgrade: GLM 5.3 Flash rifiuta valori di max_tokens superiori a 131,072.
Come lo gestisce Synthorai
Sul gateway, GLM 5.3, GLM 5.3 Flash e GLM 5.2 sono disponibili come glm-5.3, glm-5.3-flash e glm-5.2, ai prezzi di listino Z.ai, sugli endpoint /v1/chat/completions e /v1/responses. L’errore 1210 viene inoltrato senza modifiche. Un client che continua a inviare il parametro usato per disattivare il ragionamento su GLM 5.2 fallisce quindi in modo esplicito, invece di eseguire silenziosamente il ragionamento con max. Il testo del ragionamento viene restituito in reasoning_content. Le immagini vengono inviate a GLM 5.3 Flash come parti di contenuto image_url.
FAQ
Si può disattivare il ragionamento su GLM 5.3?
No. GLM 5.3 e GLM 5.3 Flash restituiscono un errore 400 con codice 1210 per ogni tentativo di disattivazione. Accettano solo low, high e max, con max come valore predefinito. Nei nostri test, low è costato il 63% in meno per risposta corretta, ma ha ottenuto 28 risposte corrette su 33 anziché 33.
GLM 5.3 costa meno di GLM 5.2?
Non per token: entrambi costano $1.40 per l’input e $4.40 per l’output. Per risposta corretta, sì. Con max, GLM 5.3 è costato $0.00468 contro $0.01173 per GLM 5.2, perché usa circa la metà del ragionamento.
GLM 5.3 Flash può sostituire GLM 5.3?
Sì, se un errore numerico occasionale viene intercettato a valle, e costa un decimo. Con max, GLM 5.3 Flash ha ottenuto 31 risposte corrette su 33 a $0.00040 per risposta corretta, contro 33 su 33 a $0.00468 per GLM 5.3. Evita Flash con low per i calcoli aritmetici in più passaggi, dove ha ottenuto 24 risposte corrette su 33.
Articoli correlati: reasoning_effort di GLM 5.2, tool call di GLM 5.2, costo di DeepSeek V4.1 Flash, controlli del ragionamento negli LLM, output strutturati degli LLM.