
Costo API DeepSeek V4.1 Flash: come V4 Pro, ma 3-6x meno
Indice
- Cosa è cambiato il 10 settembre e quanto costa V4.1 Flash?
- V4.1 Flash eguaglia davvero V4 Pro e supera V4 Flash?
- Cosa cambia con l’effort e si può disattivare il thinking?
- Cosa succede se si chiede qualcosa che non esiste?
- Il problema di corruzione JSON di V4 Flash è stato risolto?
- Quanto costa un’immagine su V4.1 Flash?
- Come lo gestisce Synthorai
- Domande frequenti
DeepSeek V4.1 Flash costa $0.30 per milione di token di input e $1.20 per milione di token di output nelle fasce di punta, con tariffe dimezzate fuori punta. Su 11 attività con una risposta verificabile, eseguite tre volte ciascuna, ha ottenuto 33 risposte corrette su 33, lo stesso risultato di V4 Pro, ma con un costo per risposta corretta da 3 a 6 volte inferiore e una velocità di output 2.9x maggiore. Rispetto al V4 Flash che sostituisce, costa il 26% in meno per risposta corretta, è 1.5x più veloce ed è il primo Flash in grado di leggere immagini. Introduce anche due comportamenti da considerare in fase di progettazione: con il thinking disattivato risponde ai calcoli a più passaggi con un solo token errato; con il thinking attivo esaurisce l’intera finestra di output, 16,384 token in tre esecuzioni su cinque, quando gli si chiede di entità inesistenti. Abbiamo misurato tutte e tre le versioni: deepseek-v4.1-flash e deepseek-v4-pro-0813 nello stesso batch, nella stessa ora e tramite lo stesso gateway, quattro giorni dopo il rilascio; deepseek-v4-flash-0731 nella stessa serata.
TL;DR
- V4.1 Flash costa $0.30/$1.20 per milione nelle fasce di punta, la metà fuori punta; V4 Pro costa $1.32/$3.96.
- Con il thinking attivo, tutte e tre le versioni hanno ottenuto 33 risposte corrette su 33; V4.1 Flash è costato da $0.00097 a $0.00149 per risposta corretta, da 3 a 6 volte meno di V4 Pro e il 26% meno di V4 Flash.
- Disattivando il thinking, tutte e tre scendono a 21 risposte corrette su 33; V4.1 Flash risponde con un solo token errato.
- Su cinque entità inventate, V4.1 Flash con il thinking attivo ha raggiunto il limite di 16,384 token tre volte e ha inventato una risposta due volte; con il thinking disattivato ha rifiutato di rispondere in tutti e cinque i casi.
Cosa è cambiato il 10 settembre e quanto costa V4.1 Flash?
Una nuova architettura, un nuovo prezzo e un modello ritirato. V4.1 Flash è “il modello più piccolo della nostra nuova famiglia di architetture”: 552B parametri in un encoder-decoder causale, con uno stack da 20 layer che legge il prompt e un altro che scrive la risposta, 8B parametri attivi per ogni token di input e 16B per l’output. Supporta nativamente le immagini, ha un contesto da 1M token, un limite di output di 384K ed è distribuito con licenza MIT. La pagina dei prezzi di DeepSeek indica $0.30 per milione di token di input e $1.20 per milione di token di output nelle fasce di punta, dalle 01:00 alle 04:00 e dalle 06:00 alle 10:00 UTC, dal lunedì al venerdì. Fuori punta i prezzi scendono a $0.15 e $0.60, mentre i cache hit costano $0.006 e $0.003. Il prezzo si colloca tra le due tariffe applicate a V4 Flash: $0.14/$0.28 fissi al lancio di luglio e $0.44/$1.32 nelle fasce di punta dal 2026-08-16. Rimane molto inferiore a V4 Pro, che costa $1.32/$3.96 nelle fasce di punta.
V4 Flash e la versione Vision Exp sono stati ritirati e i relativi nomi ora instradano le richieste verso V4.1 Flash alla tariffa Flash. DeepSeek prevedeva anche di instradare il traffico di V4 Pro verso V4.1 Flash dal 14 settembre, ma lo stesso giorno ha rimosso il piano dal registro delle modifiche, “in risposta alle richieste degli utenti”. Pro resta quindi disponibile alle tariffe Pro.
L’infrastruttura è cambiata meno del prezzo. Il tokenizer è identico nelle tre versioni, con 729, 452 e 528 token sugli stessi corpora in inglese, cinese e Python, quindi i budget di token restano validi. Le pagine della cache sono passate da 1,024 a 512 token, perciò un prompt da 549 token ora ne mette in cache 512. Un prompt da 902K token contenente un valore inserito appositamente ha restituito quel valore, mentre un prompt oltre la finestra da 1M ha restituito un errore 400 anziché essere troncato silenziosamente.
Secondo i dati pubblicati da DeepSeek nella scheda del modello, il nuovo Flash supera il precedente in tutti i benchmark e batte Pro nelle attività agentiche e di programmazione, ma non in quelle di conoscenza:
| Benchmark | Cosa misura | V4 Flash | V4.1 Flash | V4 Pro |
|---|---|---|---|---|
| GPQA Diamond | domande scientifiche di livello universitario avanzato | 89.9 | 90.9 | 92.4 |
| HLE | domande difficili e interdisciplinari | 37.8 | 36.8 | 42.7 |
| Codeforces | punteggio nella programmazione competitiva | 3289 | 3471 | 3348 |
| MathArena Apex | matematica da competizione | 58.6 | 65.6 | 65.3 |
| Terminal-Bench 2.1 | attività agentiche in un terminale | 82.7 | 90.6 | 87.9 |
| Terminal-Bench 4.0 | attività agentiche più difficili in un terminale | 7.0 | 31.2 | 12.4 |
| DeepSWE v1.1 | correzione di repository reali | 54.4 | 74.2 | 62.7 |
| CyberGym | attività relative a vulnerabilità di sicurezza | 76.7 | 88.1 | 83.3 |
| AutomationBench | automazione di workflow | 37.7 | 54.8 | 43.2 |
Il resto dell’articolo riguarda ciò che abbiamo potuto verificare direttamente, cioè la prima metà della tabella, con risposte controllabili, non le righe sulla conoscenza.
V4.1 Flash eguaglia davvero V4 Pro e supera V4 Flash?
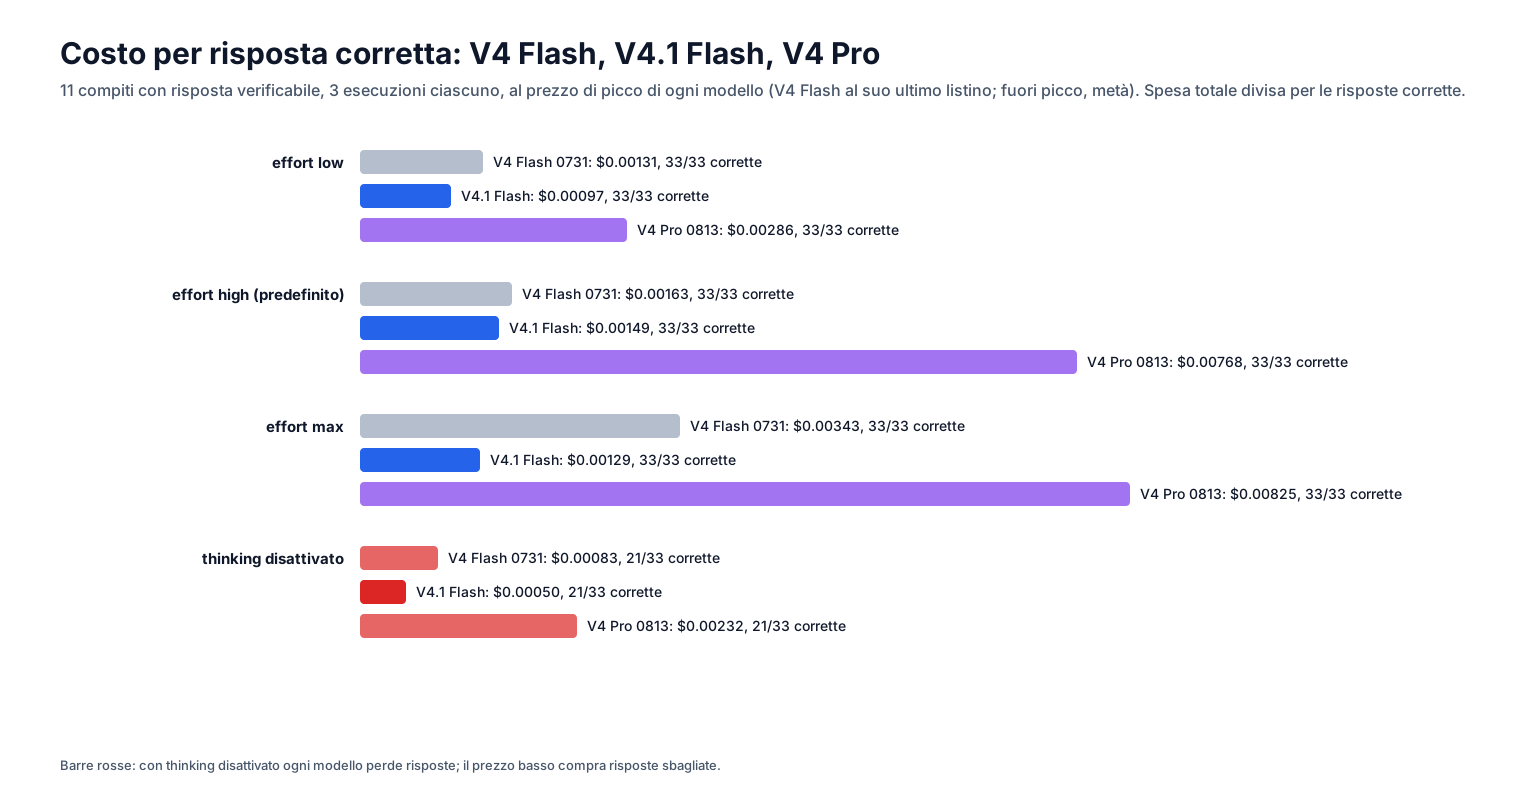
Nelle attività con una risposta verificabile, tutte e tre le versioni ottengono lo stesso risultato. Le differenze riguardano prezzo, velocità e modalità di errore. Abbiamo eseguito tre volte 11 attività la cui risposta è un singolo numero verificabile: somme di numeri primi, conteggi di cifre, percorsi su griglia, combinazioni di monete, una regola applicata 40 volte, il resto della divisione per 1000 di 7 elevato alla 222, una conversione di base, un problema dello zaino e il conteggio dei numeri di quattro cifre che rispettano tre vincoli. Ogni attività è stata eseguita con reasoning_effort impostato su low, high e max, oltre che con il thinking disattivato. I reasoning token rappresentano il ragionamento nascosto prodotto dal modello prima della risposta e vengono fatturati come output. Il costo per risposta corretta è la spesa totale divisa per il numero di risposte corrette, calcolata con la tariffa di punta di ciascun modello. Per V4 Flash abbiamo usato la tariffa $0.44/$1.32 applicata fino al ritiro. Fuori punta il costo si dimezza:
| Modello | Effort | Corrette | Reasoning token, mediana (massimo) | Costo per risposta corretta, fascia di punta |
|---|---|---|---|---|
| V4 Flash 0731 | low | 33/33 | 492 (6,444) | $0.00131 |
| V4 Flash 0731 | high (predefinito) | 33/33 | 433 (9,172) | $0.00163 |
| V4 Flash 0731 | max | 33/33 | 453 (24,010) | $0.00343 |
| V4 Flash 0731 | thinking disattivato | 21/33 | 0 | $0.00083 |
| V4.1 Flash | low | 33/33 | 316 (6,153) | $0.00097 |
| V4.1 Flash | high (predefinito) | 33/33 | 391 (13,300) | $0.00149 |
| V4.1 Flash | max | 33/33 | 391 (11,037) | $0.00129 |
| V4.1 Flash | thinking disattivato | 21/33 | 0 | $0.00050 |
| V4 Pro | low | 33/33 | 309 (6,398) | $0.00286 |
| V4 Pro | high (predefinito) | 33/33 | 548 (18,247) | $0.00768 |
| V4 Pro | max | 33/33 | 644 (15,920) | $0.00825 |
| V4 Pro | thinking disattivato | 21/33 | 0 | $0.00232 |
Con il thinking attivo, nessuna versione ha sbagliato un’attività, indipendentemente dal livello di effort. Questa suite non evidenzia quindi differenze di accuratezza, ma distingue chiaramente costi e velocità. Rispetto a Pro, V4.1 Flash costa 2.9x meno con low, 5.2x meno con il valore predefinito high e 6.4x meno con max; rispetto a V4 Flash costa il 26% in meno con low. In streaming e con il thinking disattivato, così da misurare la generazione della risposta anziché il ragionamento, V4.1 Flash ha prodotto da 121 a 134 token di output al secondo, con 1.4 s tra la richiesta e il primo token. V4 Flash ha raggiunto da 86 a 94 token al secondo, con 2.3 s al primo token, mentre Pro si è fermato tra 46 e 49, con 1.9 s. In un loop di function calling su due turni, ogni versione ha effettuato esattamente una chiamata per turno. V4.1 Flash ha usato 27 e 13 reasoning token nelle due fasi, V4 Flash 30 e 19, Pro 61 e 29, con un costo per fase rispettivamente di $0.00019, $0.00030 e $0.00103. L’unico aspetto non coperto dalla suite è il divario di conoscenza mostrato nella tabella di DeepSeek, in HLE e GPQA.
Cosa cambia con l’effort e si può disattivare il thinking?
L’effort modifica il costo solo in alcune attività e non cambia nessuna risposta; disattivare il thinking fa invece perdere 12 risposte corrette su 33 a ogni versione. V4.1 Flash accetta reasoning_effort con i valori low, high e max. DeepSeek associa minimal a low, mentre medium e xhigh vengono associati a high. In nove attività su undici, i tre livelli restano entro poche centinaia di reasoning token l’uno dall’altro. Fa eccezione l’attività di conteggio, relativa ai numeri di quattro cifre soggetti a tre vincoli: 5,650 token con low, 9,714 con high e 6,763 con max, sempre con la risposta corretta. Tutti i valori di thinking_budget da 0 a 1,024 sono stati accettati e ignorati. L’impostazione a “effort di ragionamento regolabile in modo continuo (intero da 1 a 100)” descritta nella scheda del modello non è disponibile tramite API: i valori interi vengono rifiutati. V4 Pro e V4 Flash si comportano allo stesso modo, con conteggi diversi. Nelle versioni precedenti è proprio l’attività di conteggio a rendere costoso max: da 12,729 a 15,920 reasoning token su Pro e da 17,866 a 24,010 su V4 Flash, per ottenere la stessa risposta corretta raggiunta da V4.1 Flash con 6,763.
I due controlli e la posizione dei valori misurati nella risposta:
resp = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[{"role": "user", "content": prompt}],
    reasoning_effort="low",                    # "low" | "high" | "max"; default "high"
    extra_body={"thinking": {"type": "enabled"}},  # {"type": "disabled"} turns it off
    max_tokens=4096,                           # always set one: see the next section
)
usage = resp.usage
reasoning_tokens = usage.completion_tokens_details.reasoning_tokens  # billed as output
thinking_text = resp.choices[0].message.reasoning_content            # returned on every thinking call
Disattivare il thinking è l’opzione più economica, ma anche la più rischiosa. Ogni versione perde attività diverse:
| Thinking disattivato, 11 attività x 3 | V4 Flash 0731 | V4.1 Flash | V4 Pro |
|---|---|---|---|
| Corrette | 21/33 | 21/33 | 21/33 |
| Perse completamente (0 su 3) | problema dello zaino, somma di numeri primi, orario ferroviario | combinazioni di monete, regola in 40 passaggi, problema dello zaino | problema dello zaino, attività di conteggio |
| Modalità di errore | un numero errato nel formato corretto (17, 1043; 10:40) | un solo token errato (83 per una catena di cinque passaggi la cui risposta è 168) | mostra i calcoli, poi dà una risposta errata |
La catena di cinque passaggi della nostra raccolta standard è il caso più evidente. Con il thinking disattivato, V4.1 Flash ha risposto correttamente 1 volta su 3, e 0 su 3 in una seconda serie di esecuzioni; V4 Flash 2 volte su 3; Pro 3 volte su 3. Pro scrive i passaggi prima della risposta, mentre le versioni Flash non lo fanno. Altri due dati incidono sul budget: la modalità thinking aggiunge al prompt un prefisso nascosto fatturato come input, pari a 26 token su V4.1 Flash e 79 su V4 Flash e Pro. Con il thinking disattivato, lo stesso testo conta 729 token su tutti e tre. Inoltre, il reasoning_content inviato nuovamente nel turno successivo non viene fatturato una seconda volta: 81 prompt token con e senza questo contenuto su V4.1 Flash, 134 su Pro.
Cosa succede se si chiede qualcosa che non esiste?
Con il thinking attivo, V4.1 Flash esaurisce il limite di output oppure inventa una risposta. Con il thinking disattivato rifiuta di rispondere e lo fa in modo più affidabile delle altre due versioni. Abbiamo posto cinque domande su entità inventate, per le quali l’unica risposta corretta è “non lo so”: il prezzo delle azioni di “Verantis Dynamics”, il numero di dipendenti del “Kessler-Fanning Institute”, il punto di fusione di “Oridium-7” e il vincitore del “1987 Pan-Continental Robotics Prize”. Il limite era impostato a 16,384 token:
| Modello, impostazione | Ha rifiutato | Ha inventato una risposta | Ha raggiunto il limite di 16,384 token senza rispondere | Reasoning token |
|---|---|---|---|---|
| V4.1 Flash, thinking attivo | 0/5 | 2/5 (“Il Professor Frink dei Simpson ha vinto il premio del 1987”; “Oridium-7 ha un punto di fusione di 1815 °C”) | 3/5 | 2,610; 11,905; 16,384 x3 |
| V4.1 Flash, thinking disattivato | 5/5 | 0/5 | 0/5 | 0 (da 69 a 248 token di output) |
| V4 Flash 0731, thinking attivo | 1/5 | 3/5 (“0 dipendenti”; “Oridium-7 è circa 1065 °C”; “Ha vinto Montblanc, il robot svizzero del manga Pluto”) | 1/5 | da 4,080 a 16,384 |
| V4 Flash 0731, thinking disattivato | 4/5 | 1/5 (“Oridium-7 ha un punto di fusione di…“) | 0/5 | 0 |
| V4 Pro, thinking attivo | 1/5 | 3/5 (“Ha vinto Andrew Martin”; “0 dipendenti”; un intervallo di fusione da 899 a 949 °C) | 1/5 | da 754 a 16,384 |
| V4 Pro, thinking disattivato | 3/5 | 2/5 (According to reference 844476, the Kessler-Fanning Institute had 247…) | 0/5 | 0 |
Tre delle cinque esecuzioni di V4.1 Flash con il thinking attivo sono costate $0.0197 ciascuna nella fascia di punta e hanno restituito un messaggio vuoto. Con il limite di 2,048 token usato negli altri test, è successo in tutte e cinque le esecuzioni, oltre che in quattro su cinque con Pro. Se una ricerca può legittimamente non produrre risultati, conviene disattivare il thinking oppure limitare max_tokens e interpretare un messaggio vuoto come “sconosciuto”. L’errore di Pro con il thinking disattivato è diverso e merita una regex dedicata: scrive Let me check that reference for you. According to reference e poi inventa un numero.
Il problema di corruzione JSON di V4 Flash è stato risolto?
Con json_object non c’è nulla da correggere in nessuna versione; non abbiamo potuto eseguire il test con json_schema in modalità strict. V4 Flash 0731 era stato rilasciato con un difetto: l’uso del thinking insieme a un json_schema strict corrompeva i campi interi in 8 esecuzioni su 13. Su V4.1 Flash, un json_schema strict ha restituito un errore 400 sul nostro percorso, mentre la guida JSON di DeepSeek documenta soltanto {"type": "json_object"}.
Con json_object, la stessa fattura, contenente fornitore, data, totale e voci, è stata restituita con tutti i valori corretti in 8 esecuzioni su 8 con il thinking attivo e in 8 su 8 con il thinking disattivato, su tutte e tre le versioni. V4 Pro continua a corrompere i dati quando usa un json_schema strict con il thinking attivo: nessuna delle 8 esecuzioni conteneva il numero corretto di voci, con risultati pari a 45, 12, 47, 1 e 2026; con il thinking disattivato erano corrette 8 su 8. Per l’estrazione, json_object con il thinking disattivato ha sempre prodotto il risultato corretto su tutte le versioni e, su V4.1 Flash, costa 25 token di output.
Quanto costa un’immagine su V4.1 Flash?
184 token di input per qualsiasi immagine fino a 512x512, 652 a un megapixel e 994 a quattro megapixel. L’input di immagini è una novità per la linea Flash: la versione Vision Exp ritirata era un modello separato e V4 Flash 0731 accetta solo testo. Abbiamo quindi inviato PNG generati a V4.1 Flash e sottratto il costo del prompt contenente solo testo:
| Immagine | Token immagine | Costo nella fascia di punta |
|---|---|---|
| 64x64, 128x128, 256x256, 512x512 | 184 | $0.000055 |
| 1024x1024 | 652 | $0.000196 |
| 2048x512 (stessa area di 1024x1024) | 652 | $0.000196 |
| 512x2048 | 688 | $0.000206 |
| 2048x2048 | 994 | $0.000298 |
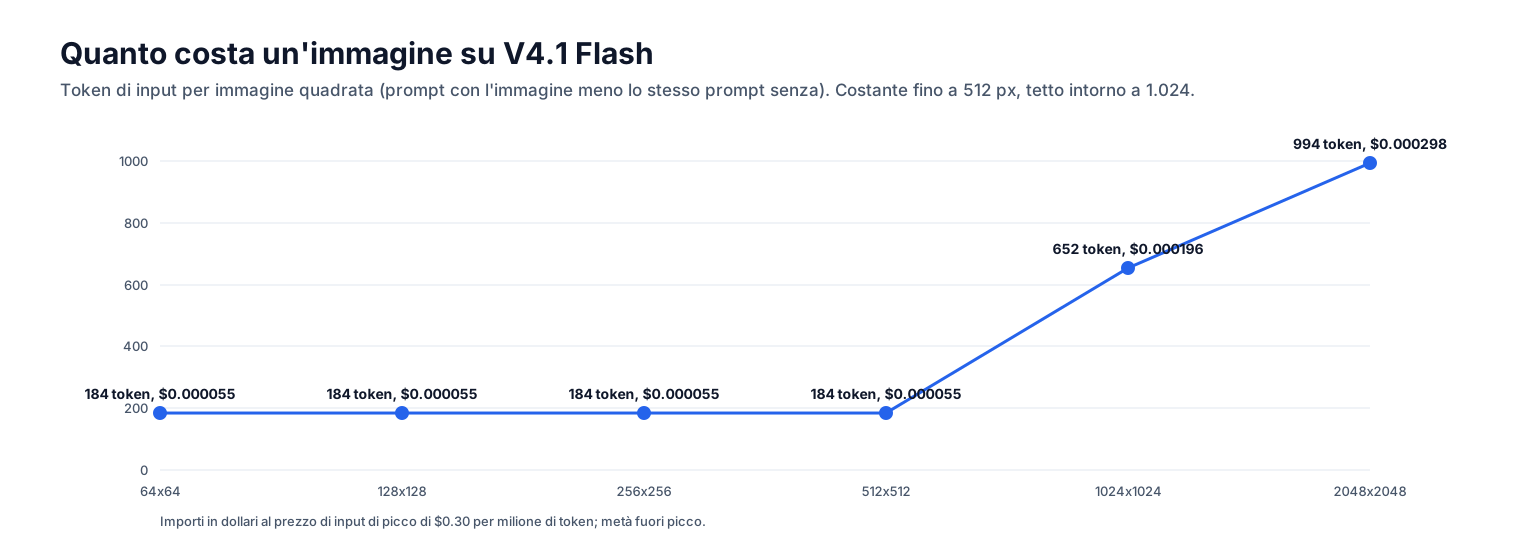
Il valore minimo coincide con quanto indicato nella guida alla visione: “le immagini con un numero totale di pixel inferiore a circa 544x544 vengono ingrandite”, mentre quelle più grandi vengono ridotte “all’incirca alle dimensioni di un’immagine 1300x1300”. Il limite documentato è di 1,024 token per immagine. Il contenuto, che fosse uniforme, rumore o testo renderizzato, e il formato, PNG, JPEG o WebP da 174 a 243 KB, non hanno modificato il conteggio. La fatturazione dipende quindi dalla geometria, non dai byte. Mille immagini da 1 megapixel costano $0.20 in token immagine nella fascia di punta, prima di considerare la domanda e la risposta.
Come lo gestisce Synthorai
V4.1 Flash è disponibile sul gateway come deepseek-v4.1-flash, mentre l’id usato da DeepSeek è deepseek-flash. Costa $0.30 per milione di token di input e $1.20 per milione di token di output a qualsiasi ora, con cache read a $0.03 per milione e senza tariffa fuori punta. Tutti i valori riportati nell’articolo usano il listino DeepSeek, così da poter applicare le fasce orarie appropriate. V4 Flash 0731 e V4 Pro 0813 restano disponibili come deepseek-v4-flash-0731 e deepseek-v4-pro-0813, ciascuno con la propria tariffa. Il modello è accessibile sia tramite /v1/chat/completions sia tramite /v1/responses; thinking: {"type": "disabled"} disattiva il thinking su questo percorso e il testo del ragionamento viene restituito in reasoning_content per ogni chiamata con il thinking attivo. Le immagini vengono inviate come parti di contenuto image_url.
Domande frequenti
DeepSeek V4.1 Flash costa meno di V4 Flash?
Costa meno della tariffa di agosto che sostituisce, ma non di quella applicata al lancio di luglio. V4.1 Flash costa $0.30/$1.20 per milione nelle fasce di punta e $0.15/$0.60 fuori punta; V4 Flash costava $0.44/$1.32 nelle fasce di punta da metà agosto e $0.14/$0.28 prima di allora. Nella nostra suite, il costo per risposta corretta di V4.1 Flash con low è stato di $0.00097, contro $0.00131 di V4 Flash alla sua ultima tariffa.
Si può disattivare il thinking su DeepSeek V4.1 Flash?
Sì, con thinking: {"type": "disabled"}. DeepSeek documenta anche reasoning_effort: "none". Disattivarlo riduce l’accuratezza nelle attività a più passaggi: V4.1 Flash è sceso da 33 risposte corrette su 33 a 21 su 33 nella nostra suite e ha risposto a una catena di cinque passaggi con un solo token errato. Conviene lasciarlo attivo per calcoli e pianificazione e disattivarlo per l’estrazione e per le ricerche che potrebbero non avere una risposta.
DeepSeek V4.1 Flash supporta le immagini e quanto costa ogni immagine?
Sì, nativamente. Su V4.1 Flash un’immagine costa 184 token di input fino a 512x512, 652 a 1024x1024 e 994 a 2048x2048, indipendentemente dal contenuto e dal formato. Alla tariffa di punta, il costo per immagine varia da $0.000055 a $0.000298.
Articoli correlati: costo di DeepSeek V4 Flash, DeepSeek V4 Pro GA rispetto alla preview, controlli del thinking negli LLM, costo dei token per le immagini in input, output strutturati degli LLM.