
Test A/B de prompt : à 10%, un coût multiplié par 1.9
Déployez un nouveau prompt sur 10% du trafic, par session. Résultat : 8.0% des 200 sessions l'ont reçu, sans changer de version, pour un coût par appel multiplié par 1.94.
Nos choix
prix en direct| Modèle | Verdict | Prix |
|---|---|---|
| GPT-6 Luna v1 de support-answer a coûté $0.000110 par appel sur les 1,272 appels du déploiement, avec une latence médiane de 4.9 s. Avec reasoning_effort none, le coût était de $0.000034. | Version de production dans la démo | dès $0.1/M |
| DeepSeek V4.1 Flash v3, avec le même prompt sur ce modèle, a répondu plus vite (médiane de 3.1 s), mais a coûté $0.000213 par appel, soit 1.94 fois le coût de v1, car elle a généré 1.6 fois plus de tokens de sortie à un prix par token plus élevé. | Version candidate dans la démo | dès $0.3/M |
Sommaire
- Comment envoyer 10% du trafic de production vers une nouvelle version ?
- Quels appels sont envoyés à la candidate ?
- Comment comparer les deux versions ?
- Désactiver le raisonnement change-t-il le résultat ?
- Les tests faussent-ils la comparaison ?
- Qu’est-ce qui n’est pas couvert ?
- FAQ
- Comment faire un test A/B de prompt en production ?
- Le déploiement progressif conserve-t-il la même version pour chaque conversation ?
- Un changement de prompt peut-il augmenter le coût sans modifier le texte ?
- Pour aller plus loin
Le déploiement progressif d’un prompt consiste à envoyer une partie des appels d’un même identifiant de prompt vers une version candidate. Le reste continue d’utiliser la version de production. On peut ainsi comparer les deux sur du trafic réel avant de basculer tous les appels. Dans la bibliothèque de prompts Synthorai, ce réglage se fait sur le label production (« v1, avec v3 à 10% »). La passerelle choisit la version de chaque appel à partir de son identifiant de session : une conversation ne change donc jamais de version en cours de route. Lors de notre essai à 10%, 16 sessions sur 200 (8.0%) ont reçu la version candidate, et chaque session a conservé la même version. La candidate utilisait un autre modèle, sans que personne ait mesuré le coût de ce changement. Les totaux par version, sur la seule phase à 10%, ont montré un coût par appel multiplié par 1.92.
TL;DR
- Avec un déploiement à 10%, 16 sessions sur 200 (8.0%, intervalle à 95% de 5.0 à 12.6%) ont reçu la candidate ; à 50%, c’était le cas de 111 sessions sur 200 (55.5%).
- Les 400 sessions de trois tours ont toutes conservé une seule version du prompt. Même constat pour chaque utilisateur final identifié par
_user, par le champuserdu corps de la requête ou parsafety_identifier. - La candidate, qui utilisait le même prompt sur DeepSeek V4.1 Flash au lieu de GPT-6 Luna, coûtait $0.000213 par appel contre $0.000110, avec une latence médiane de 3.1 s contre 4.9 s.
- Aucun des appels fixés à
prompt_version=1n’a été envoyé à la candidate : 0 sur 40.
Ce guide reprend la configuration des deux prompts et de leurs versions décrite dans Gestion des versions de prompts. Depuis le même répertoire de github.com/synthorai-io/use-cases :
cd use-cases/prompt-library
python rollout.py       # 10%, then 50%, then stops the rollout
python effort.py        # each version with and without a caller-sent reasoning_effort
Le déploiement a eu lieu le 19 octobre 2026 et a généré 1,840 appels. Les vérifications de répartition par utilisateur final ont eu lieu le 20 octobre. La production correspond à la v1 de support-answer sur GPT-6 Luna. La candidate est la v3 : le même texte système et les mêmes messages sur DeepSeek V4.1 Flash. Seul le modèle change.
Comment envoyer 10% du trafic de production vers une nouvelle version ?
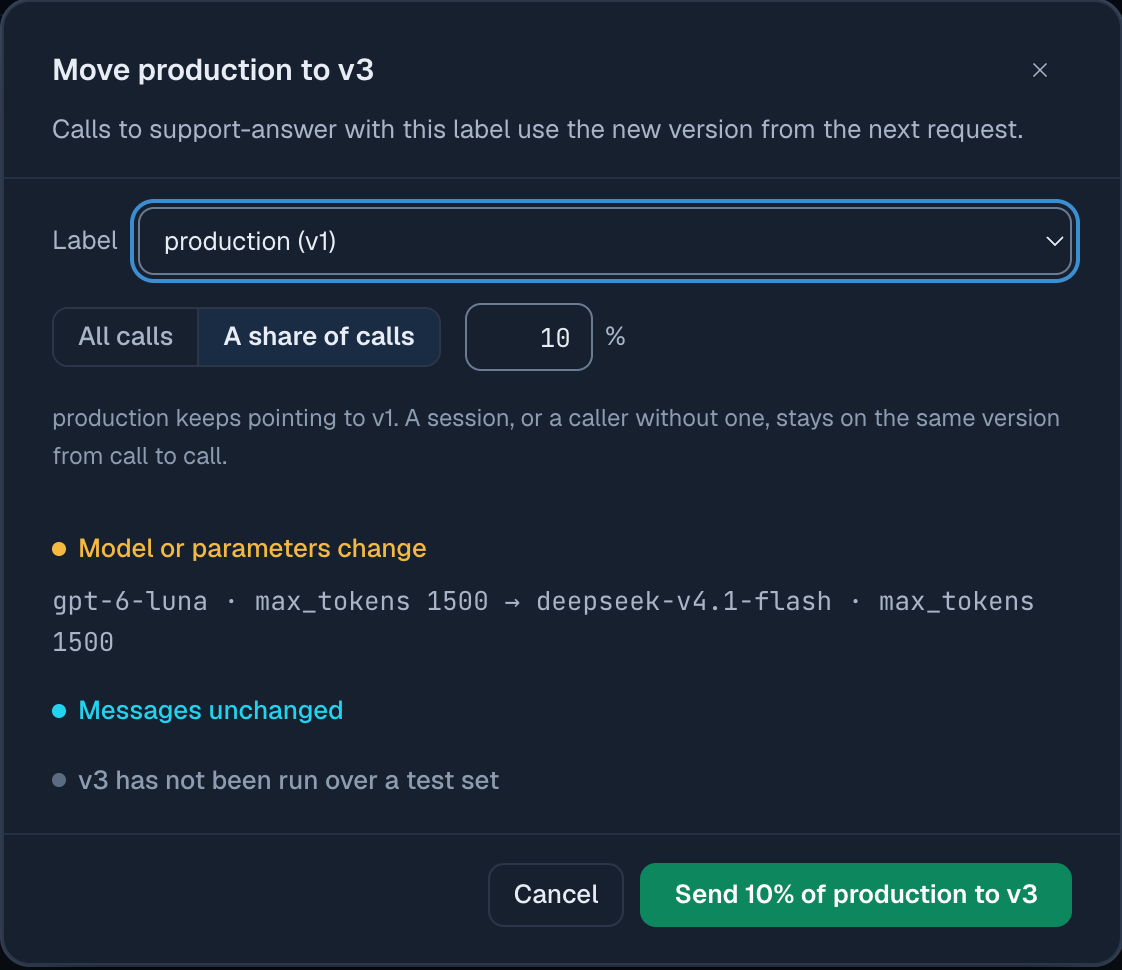
Il suffit d’associer une seconde version et un pourcentage au label production. Avec une clé d’administration, un appel active le déploiement, un autre l’arrête :
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})

admin.put("/prompts/support-answer/labels/production/rollout", json={"version": 3, "percent": 10})
# ... compare the two versions ...
admin.delete("/prompts/support-answer/labels/production/rollout")   # production is v1 only again
Rien ne change côté appelant : il continue d’appeler support-answer sans préciser de version. L’en-tête de réponse X-Synthorai-Prompt-Version indique quelle version a traité chaque appel. Pour mettre la candidate en production, on déplace le label production vers celle-ci, ce qui met fin au déploiement progressif. Dans la console, le même réglage s’appelle « Déployer progressivement » sur la page de la candidate. La liste des prompts affiche alors le label sous la forme « production v1 · v3 10% ».
Quels appels sont envoyés à la candidate ?
La passerelle choisit une version à partir d’une clé stable pour chaque appel. Tant que le pourcentage reste identique, une même clé reçoit toujours la même version. La clé retenue est la première disponible dans cet ordre :
- l’identifiant de session (
X-Session-Id, l’en-tête utilisé dans Tracer un agent LLM) ; - l’utilisateur final : le label
_userdansX-Synthorai-Metadata, à défaut le champuserdu corps de la requête,safety_identifierou le champmetadata.user_idd’Anthropic ; - en l’absence de ces éléments, la requête elle-même : le choix se fait alors indépendamment pour chaque appel.
rollout.py a vérifié chaque cas avec une répartition à 10%, puis à 50%. Une session comportait 3 tours, un utilisateur final effectuait 2 appels :
| Appels | À 10% : sur v3 | À 50% : sur v3 | Une seule version conservée |
|---|---|---|---|
200 sessions, X-Session-Id | 16 = 8.0% (5.0 à 12.6%) | 111 = 55.5% (48.6 à 62.2%) | 400 sessions sur 400 |
50 utilisateurs finaux, label _user | 6 | 27 | 100 utilisateurs sur 100 |
| 100 appels sans aucun de ces identifiants | 11 = 11.0% (6.3 à 18.6%) | 49 = 49.0% (39.4 à 58.7%) | sans objet |
20 appels fixés à prompt_version=1 | 0 | 0 |
Les plages entre parenthèses sont des intervalles de confiance à 95% : elles indiquent où la proportion réelle est susceptible de se situer compte tenu du nombre d’essais. Elles contiennent toutes le pourcentage configuré. Une exécution distincte à 50% a vérifié les deux champs du corps de la requête : 50 utilisateurs identifiés uniquement par user et 20 uniquement par safety_identifier, avec 2 appels chacun. Les 70 ont tous conservé une seule version ; 25 des 50 premiers et 8 des 20 autres ont reçu la v3.
Cela a deux conséquences pour vos déploiements. L’identifiant de session garantit la cohérence d’une conversation à plusieurs tours : envoyez-le à chaque appel de la conversation. Sans aucune clé, un même utilisateur peut recevoir la v1 sur un appel et la v3 sur le suivant. Par ailleurs, un appel qui fixe explicitement sa version avec prompt_version reste hors du déploiement progressif. Un test ou un traitement batch qui impose une version continue de recevoir exactement cette version.
Comment comparer les deux versions ?
La page Prompts agrège par version les appels, les erreurs, les dépenses, les tokens et la latence. L’API Requests renvoie les mêmes chiffres avec les filtres prompt_id et prompt_version. La démo les a récupérés après le déploiement :
| Version | Requêtes | Dépense | Dépense par appel | Latence médiane | Tokens de sortie par appel, moyenne | Tokens de raisonnement par appel, moyenne |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | 1,272 | $0.1405 | $0.000110 | 4.9 s | 198 | 149 |
| v3, DeepSeek V4.1 Flash | 568 | $0.1208 | $0.000213 | 3.1 s | 321 | 256 |
Les tokens de raisonnement sont les tokens que le modèle produit pour réfléchir avant de répondre. Ils sont facturés comme des tokens de sortie et n’apparaissent pas dans la réponse.
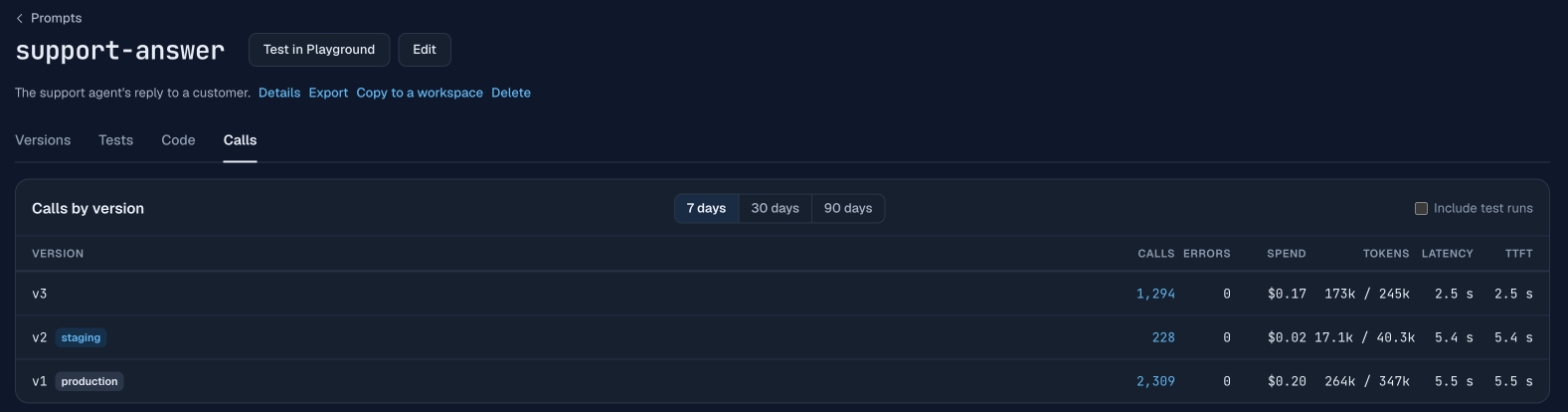
L’onglet Appels du prompt affiche le même type de totaux. Sur 7 jours, il compte tous les appels de la démo pour chaque version, pas seulement ceux du déploiement progressif. Ses chiffres sont donc supérieurs à ceux du tableau.
Sur l’ensemble de l’exécution, la v3 est plus rapide et coûte 1.94 fois plus par appel. Deux facteurs se cumulent. Sur cette passerelle, DeepSeek V4.1 Flash coûte plus cher par token que GPT-6 Luna : $0.15 en entrée et $0.60 en sortie par million de tokens en heures creuses, contre $0.10 et $0.50. La v3 a aussi produit 1.6 fois plus de tokens de sortie. Le raisonnement explique presque tout l’écart : 256 tokens de raisonnement par appel contre 149, tandis que les réponses elles-mêmes comptaient 65 et 48 tokens en médiane. Aucun de ces chiffres n’apparaît dans le texte du prompt. L’écart était déjà visible sur la seule phase à 10% : les 71 appels traités par la v3 coûtaient $0.000212 chacun, contre $0.000111 pour les 749 appels traités par la v1, soit 1.92 fois plus.
Le prix dépend aussi de l’heure. Tous les appels DeepSeek du déploiement ont eu lieu pendant la plage d’heures creuses de la passerelle pour ce modèle, de 22:00 à 08:00, heure de Pékin. Ils ont été facturés à la moitié des tarifs d’heures pleines de $0.30 et $1.20. L’exécution de 140 appels du 20 octobre a eu lieu en heures pleines. La v3 y coûtait $0.000394 par appel contre $0.000107 pour la v1, soit 3.7 fois plus, sur respectivement 66 et 74 appels.
Sur les 1,840 appels, 1,839 ont renvoyé un statut 200. Un appel a dépassé le délai d’attente de 300 s côté client et compte comme une erreur. Les autres tours de sa session ont tout de même été traités.
Désactiver le raisonnement change-t-il le résultat ?
Cela réduit le coût des deux versions d’au moins deux tiers, mais ne rend pas la v3 moins chère. effort.py a appelé chaque version 50 fois sans reasoning_effort, puis 50 fois avec reasoning_effort: "none" envoyé par l’appelant. Les messages clients provenaient du jeu de tests de Tester un prompt avant sa mise en production et mentionnaient tous un numéro de commande (40 messages, dont 10 utilisés deux fois) :
| Version | reasoning_effort | Coût par appel | Tokens de sortie, moyenne | Latence médiane | Réponse contenant le numéro de commande | Réponse jugée pertinente |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | par défaut | $0.000107 | 192 | 4.8 s | 50/50 | 37/50 |
| v1, GPT-6 Luna | none | $0.000034 | 45 | 1.8 s | 50/50 | 35/50 |
| v3, DeepSeek V4.1 Flash | par défaut | $0.000200 | 300 | 3.2 s | 50/50 | 43/50 |
| v3, DeepSeek V4.1 Flash | none | $0.000049 | 55 | 1.7 s | 50/50 | 39/50 |
Le réglage « none » a entièrement supprimé le raisonnement sur les deux modèles et réduit le coût par appel de 68% pour la v1 et de 75% pour la v3. La qualité des réponses s’est maintenue, dans les limites de ce que permettent d’observer 50 appels : chaque réponse mentionnait toujours le numéro de commande. Le contrôle par évaluateur, un appel à Claude Sonnet 5.5 qui vérifie si la réponse traite la question du client, a varié de 2 et 4 réponses sur 50. Le test exact de Fisher donne p = 0.82 et 0.44. Ce test calcule la probabilité d’observer un écart au moins aussi grand si « none » n’avait aucun effet ; des valeurs aussi élevées indiquent que la variation reste compatible avec le hasard. Avec « none » sur les deux versions, la v3 coûtait encore 1.44 fois plus que la v1 par appel ($0.000049 contre $0.000034). Ces appels ont eux aussi eu lieu pendant les heures creuses de la passerelle pour DeepSeek.
Pendant un déploiement progressif, l’appelant ne sait pas quelle version répondra. Le reasoning_effort qu’il envoie s’applique donc aux deux. Ce paramètre peut aussi être enregistré dans la version : la passerelle ajoute alors le reasoning_effort stocké aux requêtes Chat Completions et Responses si l’appel ne définit pas lui-même le raisonnement. Une candidate configurée ainsi conserve son propre réglage pendant le déploiement. Les totaux par version comparent alors les versions telles qu’elles seraient mises en production.
Les tests faussent-ils la comparaison ?
Par défaut, les tests ne faussent pas la comparaison : les totaux par version de la page Prompts excluent le trafic de test. Cela comprend les appels du Playground, y compris les tests lancés depuis la console, et les appels portant le label source: prompt-test ou source: eval dans X-Synthorai-Metadata. L’option « Inclure les tests » permet de les comptabiliser. Sur support-answer, son activation a ajouté 150 appels à chacune des versions v1 et v2 : 110 appels par version issus d’une évaluation étiquetée et 40 par version issus d’un test dans la console. La v3 est restée inchangée. Les logs et l’API Requests conservent tous les appels. Si une évaluation a eu lieu pendant votre déploiement, filtrez donc ces données par label :
X-Synthorai-Metadata: {"source":"eval"}Qu’est-ce qui n’est pas couvert ?
- Les tests statistiques sur le coût et la latence. Le tableau par version ci-dessus compare des totaux et des moyennes ; nous n’avons pas testé les écarts. Avant de prendre une décision sur cette base, testez l’écart, surtout s’il est faible.
- La qualité des réponses sur le trafic réel. Un déploiement progressif indique combien une version coûte et à quelle vitesse elle répond. Pour vérifier si ses réponses sont justes, il est plus simple d’utiliser un jeu d’entrées fixe avant le déploiement. Tester un prompt avant sa mise en production le fait pour la v2.
- Les arrêts automatiques. Rien dans la démo n’arrête un déploiement lorsque le taux d’erreur ou le coût de la candidate dépasse un seuil. Un administrateur modifie le pourcentage, déplace le label vers la candidate ou arrête le déploiement.
FAQ
Comment faire un test A/B de prompt en production ?
Associez une version candidate et un pourcentage au label de production, continuez d’appeler le même identifiant de prompt et comparez les totaux des deux versions. Dans la démo, un réglage à 10% a envoyé 16 sessions sur 200 vers la candidate. Après quelques centaines d’appels, les totaux montraient déjà son coût.
Le déploiement progressif conserve-t-il la même version pour chaque conversation ?
Une conversation conserve la même version si ses appels portent un identifiant de session. Les 400 sessions de la démo ont toutes gardé une seule version sur leurs trois tours. Sans identifiant de session, la passerelle utilise l’identifiant de l’utilisateur final. Sans l’un ni l’autre, elle choisit indépendamment pour chaque appel.
Un changement de prompt peut-il augmenter le coût sans modifier le texte ?
Un changement de modèle à texte identique peut augmenter le coût, comme dans la démo. La candidate sur DeepSeek V4.1 Flash coûtait 1.94 fois plus par appel que la version sur GPT-6 Luna. Ses tokens étaient plus chers sur cette passerelle et elle en utilisait davantage pour le raisonnement. Comparez le coût par appel de la version complète, pas le tarif du modèle.
Pour aller plus loin
- Gestion des versions de prompts : appeler un prompt par son identifiant et déplacer un label.
- Tester un prompt avant sa mise en production : jeux de tests et contrôles, avec une comparaison de la v2 à la v1.
- Pourquoi mon agent LLM coûte-t-il cher ? : quatre autres causes de factures élevées, repérées dans les traces.
- Guide de la bibliothèque de prompts : déploiement progressif, statistiques par version et détail de chaque champ.