
Tester un prompt avant livraison : une régression de 16%
Un prompt raccourci a perdu une règle. Sur 110 nouveaux messages, il a omis 18 fois le numéro de commande (16%), contre jamais pour l'ancien, malgré un test de 40 lignes sans échec.
Nos choix
prix en direct| Modèle | Verdict | Prix |
|---|---|---|
| GPT-6 Luna v1 de support-answer a indiqué le numéro de commande dans 275 appels de test sur 275. v2, avec un prompt système plus court, l’a indiqué dans 92 appels sur 110 lors de l’exécution définie à l’avance. | Modèle utilisé pour les deux versions testées | dès $0.1/M |
| Claude Sonnet 5.5 A évalué si chaque réponse répond à la question du client, avec PASS ou FAIL. Ses appels ont représenté $0.12 sur les $0.14 qu’ont coûté les six exécutions de test. | Modèle évaluateur dans la démo | dès $2/M |
Sommaire
- Que contient un test de prompt ?
- Comment lancer un test de prompt depuis le code ou la CI ?
- Le test a-t-il détecté la régression ?
- Pourquoi une exécution sans échec peut-elle masquer une régression ?
- Le prompt raccourci a-t-il dégradé autre chose ?
- Combien coûte un test de prompt ?
- Comment le test aide-t-il à décider d’une mise en production ?
- Qu’est-ce qui n’est pas couvert ?
- FAQ
- Comment tester un prompt LLM avant de le déployer ?
- Combien de cas faut-il pour un test de non-régression de prompt ?
- Un modèle juge peut-il remplacer les vérifications par expression régulière ?
- À lire aussi
Tester un prompt avant sa mise en production consiste à exécuter sa nouvelle version et la version actuelle sur les mêmes entrées prédéfinies, puis à vérifier chaque réponse selon des règles écrites. Nous l’avons fait pour la v2 d’un prompt de support. Son texte système avait été raccourci et la règle « toujours indiquer le numéro de commande » avait disparu. Le test devait détecter cette régression, c’est-à-dire une modification qui dégrade les réponses. Sur 110 messages jamais utilisés dans les exécutions précédentes, v2 a omis le numéro de commande dans 18 réponses (16%), contre aucune pour v1. L’écart dépasse largement ce que le hasard peut expliquer (test exact de Fisher, p = 3.6 × 10⁻⁶). Pourtant, une exécution antérieure sur 40 messages n’avait révélé aucune omission. Une seule exécution sans échec ne suffit donc pas à valider une version.
TL;DR
- Lors d’un test défini à l’avance, v2 de support-answer a omis le numéro de commande dans 18 réponses sur 110, contre 0 sur 110 pour v1 (p = 3.6 × 10⁻⁶).
- Sur trois exécutions antérieures de 40 lignes, l’une avait validé v2 sur les 40 lignes. Pris isolément, l’un des trois jeux finaux n’aurait pas non plus détecté la régression.
- v1 a indiqué le numéro de commande dans les 275 appels de test effectués par le script de démonstration.
- Six exécutions de 15 à 20 lignes ont coûté $0.14, dont $0.12 pour le modèle juge.
Ce guide fait suite à Gestion des versions de prompts, qui présente la création de support-answer et de ses versions. v1 et v2 utilisent toutes deux GPT-6 Luna ; seul le texte système change. Depuis le même répertoire de github.com/synthorai-io/use-cases :
cd use-cases/prompt-library
python evals.py                        # v2 against v1 on the orders and general sets, three runs each
python evals.py --set fresh --runs 1   # the test fixed before the run
python evals.py --read RUN_ID          # read back a run started in the console
Les exécutions présentées ici datent du 19 octobre 2026. Le modèle juge est Claude Sonnet 5.5, distinct du modèle utilisé par les versions testées.
Que contient un test de prompt ?
Un jeu de test comprend un tableau d’entrées et une liste de vérifications. Chaque ligne fournit les valeurs des variables du prompt, avec éventuellement un message utilisateur et une réponse attendue. À chaque exécution, le test appelle la version candidate et la version de référence pour chaque ligne, puis applique toutes les vérifications à chaque réponse. Voici les types de vérifications disponibles :
| Vérification | Réussite si la réponse |
|---|---|
contains / not_contains | contient, ou ne contient pas, une chaîne donnée |
regex / not_regex | correspond, ou ne correspond pas, à une expression régulière (syntaxe RE2 de Go) |
equals_expected | est identique à la réponse attendue pour cette ligne |
json / schema | est un JSON valide / respecte le schéma de sortie de la version |
max_latency_ms / max_cost_usd | respecte les limites de délai et de coût |
judge | reçoit la note PASS d’un modèle selon un critère que vous rédigez |
Un jeu contient jusqu’à 50 lignes, et chaque vérification s’applique à toutes ses lignes. Cette contrainte détermine le découpage du test. Vérifier que « la réponse contient un numéro de commande » n’a de sens que si le message en fournit un. La démonstration regroupe donc ces messages dans des jeux distincts :
| Jeu | Lignes | Vérifications |
|---|---|---|
| orders (15 lignes, puis 40) | messages contenant chacun un numéro de commande, sur la livraison, les retours, les articles erronés ou endommagés et la facturation | numéro de commande présent (regex \bA-\d{5}\b) ; évaluation par modèle : répond à la question du client |
| fresh orders 1 à 3 | 110 messages supplémentaires du même type, absents de tous les autres jeux, répartis en 40, 35 et 35 lignes | les deux mêmes |
| general (20 lignes) | messages sans numéro de commande, dont plusieurs sur les délais de remboursement | not_contains “refund by” et “business days” ; latence inférieure à 20 s ; évaluation par modèle : répond à la question ; évaluation par modèle : ne promet aucune date de remboursement |
La vérification par modèle juge nécessite un appel par réponse et renvoie PASS ou FAIL. Elle a un coût et peut se tromper. La démonstration la réserve donc aux critères qu’une expression régulière ne peut pas couvrir et présente ses résultats séparément.
Comment lancer un test de prompt depuis le code ou la CI ?
La CI (intégration continue, qui exécute les vérifications à chaque modification avant fusion) peut lancer un test de prompt via l’API. C’est votre code qui exécute le test : il crée une exécution, appelle les deux versions avec prompt_version pour chaque ligne, évalue les réponses et enregistre les résultats dans l’exécution. La console l’affiche ensuite comme n’importe quelle autre. Voici la boucle de la démonstration, abrégée :
EVAL = {"X-Synthorai-Metadata": '{"source":"eval"}'}   # keeps test calls out of per-version stats

run = admin.post("/prompts/support-answer/eval-runs",
                 json={"set_id": set_id, "candidate": 2, "baseline": 1}).json()["data"]
results = []
for i, row in enumerate(rows, 1):
    entry = {"row": i}
    for side, version in (("candidate", 2), ("baseline", 1)):
        answer = call_by_version("support-answer", row, version, headers=EVAL)   # a Chat Completions call
        entry[side] = {"version": version, "answer": answer.text,
                       "checks": {"order number": bool(ORDER.search(answer.text)),
                                  "answers": judge(ANSWERS, row, answer.text)}}
    results.append(entry)
    admin.put(f"/prompts/support-answer/eval-runs/{run['id']}",
              json={"status": "finished" if i == len(rows) else "running", "done": i, "checked": i,
                    "passed": sum(all(e["candidate"]["checks"].values()) for e in results),
                    "results": {"rows": results}})
call_by_version appelle le prompt par son identifiant en renseignant prompt_version, comme dans Gestion des versions de prompts. judge appelle le modèle juge en lui demandant PASS ou FAIL. Le marquage source: eval compte pendant un déploiement : les totaux par version de la page Prompts excluent les appels ainsi marqués. Les tests ne faussent donc pas la comparaison du trafic réel.
La démonstration exécute ses vérifications par expression régulière en Python. Pour obtenir exactement la même évaluation que dans la console, envoyez les vérifications et les réponses à POST /api/v1/prompt-checks/grade. Cet endpoint applique contains, not_contains, regex, not_regex, equals_expected et json côté serveur avec RE2, puis renvoie un résultat de réussite ou d’échec pour chaque paire vérification-réponse. Un essai rapide a donné les résultats attendus : (?i)refund sur « REFUND by Friday » réussit, tandis que not_regex (?i)refund.{0,40}\bby\b sur la même réponse échoue.
Le bouton d’exécution de la console fonctionne de la même façon depuis le navigateur : il appelle les deux versions pour chaque ligne et stocke les résultats. Une exécution du jeu orders de 40 lignes depuis la console (exécution 10 ci-dessous) n’a évalué que la version candidate ; les réponses de v1 étaient affichées à côté, sans vérifications.
Le test a-t-il détecté la régression ?
Oui. Nous avions défini le test avant de l’exécuter : 110 nouveaux messages jamais utilisés auparavant, un appel par version pour chaque ligne, et un seul test exact de Fisher sur la présence du numéro de commande dans l’ensemble des 110 lignes, avec un seuil de 0.05. Le test exact de Fisher donne la probabilité d’observer un écart au moins aussi grand si les deux versions se comportaient réellement de la même façon. Le test est bilatéral : il prend en compte un écart dans les deux sens. Nous avons ajouté les lignes et cette règle au dépôt avant le premier appel. Résultat :
| Jeu | v2 indique le numéro de commande | v1 indique le numéro de commande | p de Fisher pour ce jeu seul |
|---|---|---|---|
| fresh orders 1 (40 lignes) | 33/40 | 40/40 | 0.012 |
| fresh orders 2 (35 lignes) | 27/35 | 35/35 | 0.005 |
| fresh orders 3 (35 lignes) | 32/35 | 35/35 | 0.239 |
| Ensemble des 110 lignes | 92/110 | 110/110 | 3.6 × 10⁻⁶ |
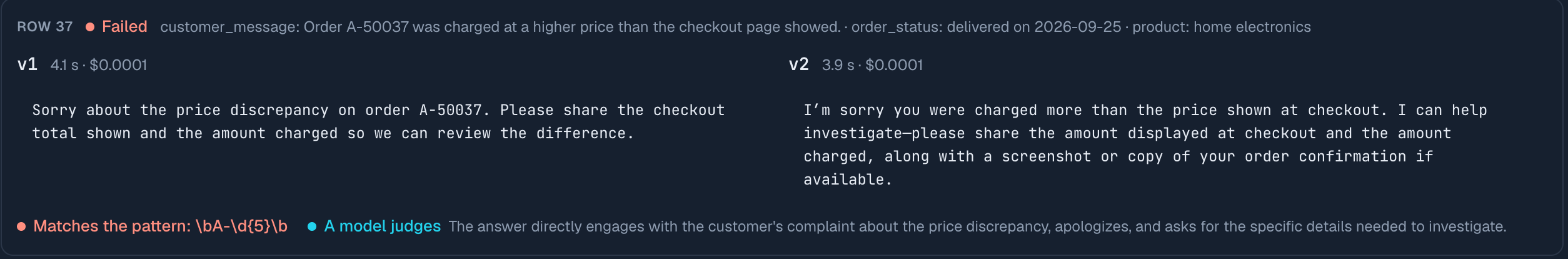
v2 omet le numéro de commande dans 16% des réponses. Les omissions touchent plusieurs sujets, pas un seul type de message : 4 sur 22 pour chacun des thèmes livraison, retours, articles erronés et articles endommagés, et 2 sur 22 pour la facturation. Exemple typique : à la question « La commande A-50918 apparaît avec deux débits en attente dans mon application bancaire », la réponse explique qu’il peut s’agir de deux autorisations en attente plutôt que de deux débits. Le modèle juge la valide, mais elle ne mentionne jamais la commande.
Les valeurs de p par jeu décrivent les trois jeux ; elles ne constituent pas le test retenu. Deux des trois jeux auraient signalé le problème de v2 à eux seuls, mais pas le troisième.
Pourquoi une exécution sans échec peut-elle masquer une régression ?
Une règle enfreinte seulement de temps en temps peut être respectée sur toute une exécution. Avant le test ci-dessus, la démonstration avait comparé v2 à v1 trois fois sur un jeu de 40 lignes :
| Exécution | v2 indique le numéro de commande | v1 |
|---|---|---|
| 7 | 35/40 | 40/40 |
| 8 | 36/40 | 40/40 |
| 9 | 40/40 | 40/40 |
| 10 (console) | 39/40 | 40/40 selon l’évaluation des réponses stockées par le script de démonstration |
v2 a réussi les 40 lignes de l’exécution 9. Une équipe qui n’aurait lancé le test qu’une fois et obtenu ce résultat aurait donc mis v2 en production. Aucune de ces exécutions ne donne non plus un résultat significatif à elle seule : face à une référence sans aucune omission, une exécution de 40 lignes ou plus nécessite au moins 6 omissions pour passer sous 0.05 (34 sur 40 donne p = 0.026 ; 35 sur 40 donne 0.055). Les jeux plus petits en nécessitent moins : 5 omissions sur 20 donnent déjà p = 0.047.
Pour dimensionner un test, il faut donc assez de lignes pour que 6 omissions soient probables, et pas seulement attendues en moyenne. Avec un taux d’omission de 16%, 48 lignes donnent 80% de chances d’obtenir au moins 6 omissions. Avec 38 lignes, cette probabilité n’est que de 58%, même si le nombre attendu est de 6. À 6.25%, le taux observé sur le jeu de 40 lignes ci-dessus (10 omissions sur 160 réponses), il faut 126 lignes pour atteindre 80% de chances. Pour une règle importante, utilisez plus de lignes qu’un seul jeu ne peut en contenir, répartissez-les sur plusieurs jeux et décidez à l’avance comment combiner les résultats. Répéter les mêmes lignes n’apporte pas autant d’éléments que de nouvelles lignes : les exécutions retestent les mêmes messages et ne sont donc pas des échantillons indépendants. Dans la démonstration, trois lignes sur lesquelles v2 avait échoué lors d’une exécution ont aussi échoué lors d’une autre.
Le prompt raccourci a-t-il dégradé autre chose ?
Les autres vérifications n’ont détecté aucune autre régression. Sur le jeu general, avec trois exécutions par version :
- Aucune date de remboursement : aucune version n’a écrit « refund by » ni « business days ». La vérification par modèle juge a échoué sur au plus 2 réponses sur 20 par version et par exécution, sans différence entre les versions.
- Latence : v1 a dépassé 20 s sur 2 lignes lors d’une exécution ; v2 n’a jamais dépassé ce seuil.
- Réponse à la question (évaluation par modèle) : v2 a obtenu un meilleur score sur tous les jeux, avec 88 sur 110 contre 75 sur 110 sur les nouveaux jeux. Cette comparaison n’avait pas été définie à l’avance : elle reste donc une tendance. Selon le modèle juge, le prompt raccourci répond plus directement.
Le modèle juge de la console et celui de la démonstration utilisent des prompts différents (celui de la console rédige une justification). Sur les mêmes 40 messages, mais avec des réponses issues d’exécutions différentes, la console a validé v2 sur 40 sur 40, contre 32 à 35 pour le juge de la démonstration. Ne comparez les résultats qu’au sein d’un même évaluateur.
Combien coûte un test de prompt ?
Avec les modèles de cette démonstration, comptez environ un dixième de centime de dollar par ligne pour deux versions et une vérification par modèle juge :
| Exécutions | Lignes par exécution | Appels | Coût |
|---|---|---|---|
| 6 exécutions des jeux de 15 et 20 lignes | 15 ou 20 | réponses et évaluations par modèle | $0.1400, dont $0.1198 pour les appels au juge |
| 3 exécutions du jeu de 40 lignes | 40 | 240 réponses + 240 évaluations par modèle | $0.115 |
| le test défini à l’avance | 110 | 220 réponses + 220 évaluations par modèle | $0.1076 |
Le juge représente l’essentiel du coût : chaque réponse déclenche un appel distinct à un modèle plus gros. Une exécution de 40 lignes a pris 10 minutes avec des appels séquentiels. Des appels parallèles réduiraient ce délai, mais consommeraient davantage votre quota de requêtes par unité de temps.
Comment le test aide-t-il à décider d’une mise en production ?
Lorsque vous déplacez production dans la console, la boîte de dialogue affiche la dernière exécution de test de la version à côté du changement. Elle éclaire la décision sans bloquer l’opération. Les jeux de test et les réponses d’une exécution sont stockés chiffrés ; les réponses sont conservées 30 jours.
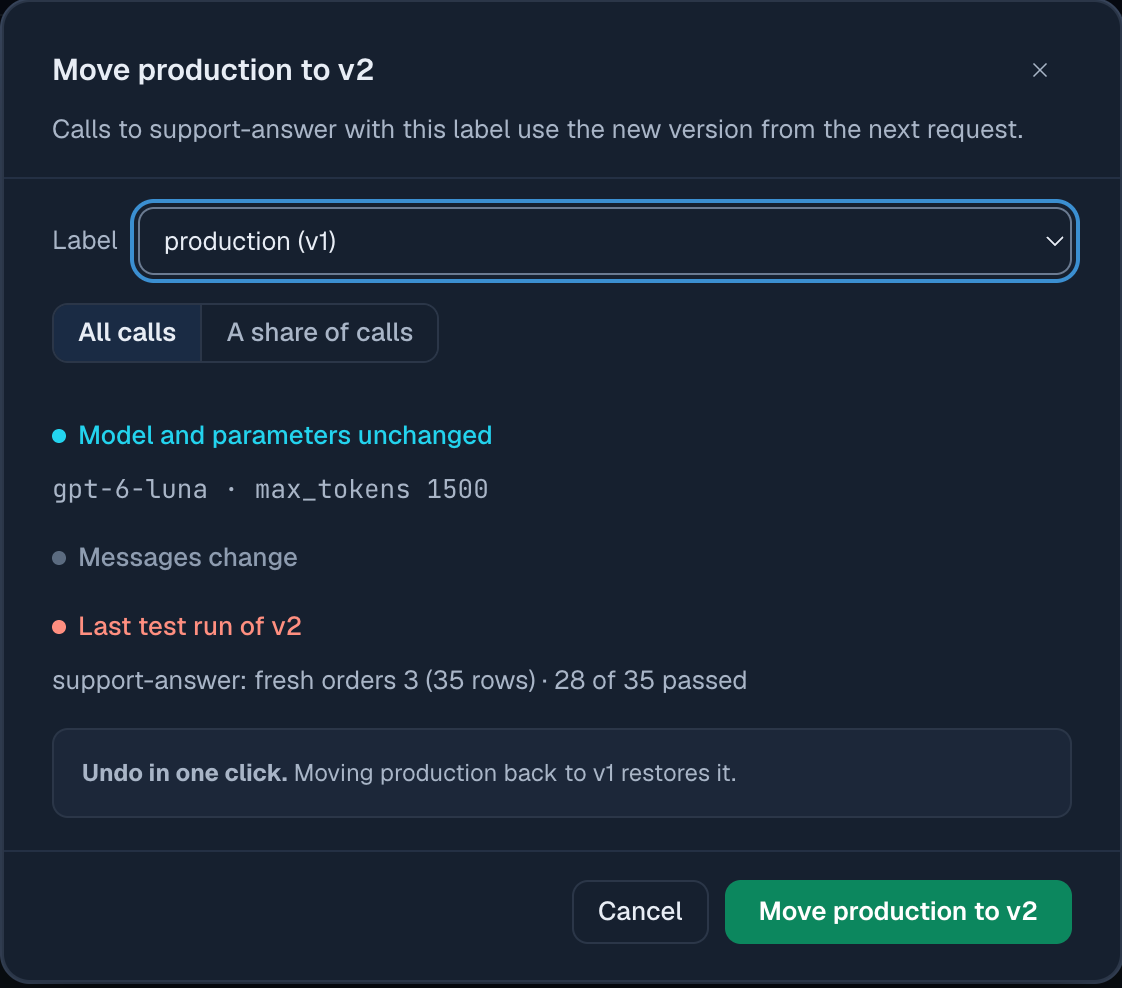
La boîte de dialogue ne compte une ligne comme réussie que si toutes les vérifications du jeu ont réussi. Le résultat de 28 sur 35 combine donc la vérification par expression régulière et celle du modèle juge.
Qu’est-ce qui n’est pas couvert ?
- Vérifications par ligne. Une vérification s’applique à toutes les lignes de son jeu. C’est pourquoi la démonstration sépare les messages avec et sans numéro de commande.
- Tests exécutés côté serveur. Avec l’API comme avec le bouton d’exécution de la console, les appels aux modèles partent du côté de l’appelant. Aucun endpoint n’exécute un test entier côté serveur en attendant sa fin.
- Fiabilité du modèle juge. Nous n’avons pas comparé ses évaluations à des évaluations humaines. Ses scores indiquent donc des tendances, et cet article ne présente de résultat établi que pour la vérification par expression régulière.
FAQ
Comment tester un prompt LLM avant de le déployer ?
Exécutez la nouvelle version et la version actuelle sur les mêmes entrées prédéfinies, vérifiez chaque réponse selon des règles écrites et comparez le nombre de réussites avec un test de significativité choisi à l’avance. Dans la démonstration, 110 nouveaux messages et un test exact de Fisher ont permis de distinguer un taux d’omission de 16% d’un taux de 0%.
Combien de cas faut-il pour un test de non-régression de prompt ?
Prévoyez assez de lignes pour qu’au moins 6 violations de la règle soient probables si la régression existe. Pour atteindre 80% de chances, il faut 48 lignes avec un taux d’échec de 16%, et 126 lignes avec un taux de 6.25%. Dans la démonstration, une exécution de 40 lignes a validé une version qui enfreignait la règle dans 16% des réponses du test principal.
Un modèle juge peut-il remplacer les vérifications par expression régulière ?
Un modèle juge ne doit pas remplacer une vérification qu’une expression régulière peut couvrir. Dans la démonstration, la console et le script utilisaient des prompts de jugement différents. Ils ont validé v2 sur respectivement 40 sur 40 et 32 à 35 sur 40 pour les mêmes messages. Une expression régulière, elle, donne toujours le même résultat sur un même texte.
À lire aussi
- Gestion des versions de prompts : appeler un prompt par son identifiant et déplacer un label.
- Tester une modification de prompt en A/B : mesurer le coût d’une version sur le trafic réel.
- Guide de la bibliothèque de prompts : jeux de test, vérifications et exécutions d’évaluation.
- Les prompts dans la console : l’éditeur de tests et la boîte de dialogue de déplacement.