
Versions de prompts : un changement en moins de 10 s, sans redéployer
Stockez les prompts LLM dans une bibliothèque, appelez-les par prompt_id et publiez-les en déplaçant un label. Mesures : 8 à 9 s avant les appels réels, et les mêmes 114.5 tokens de prompt qu'en ligne.
Nos choix
prix en direct| Modèle | Verdict | Prix |
|---|---|---|
| GPT-6 Luna Versions v1 et v2 de support-answer servies. Un appel par identifiant de prompt a envoyé le même nombre de tokens de prompt (114.5, médiane de 20 paires) que la requête rendue envoyée directement. | Modèle du prompt de réponse de la démo | dès $0.1/M |
| DeepSeek V4.1 Flash Exécution de policy-check v1 avec un schéma de sortie stocké sur la version : une réponse JSON en 18 tokens de sortie pour $0.000033, avec reasoning_effort défini sur none. | Modèle de la vérification JSON de la démo | dès $0.3/M |
Sommaire
- Comment appeler un prompt par son identifiant ?
- Un appel par identifiant coûte-t-il plus cher qu’un prompt écrit dans le code ?
- En combien de temps un déplacement de label atteint-il les appels ?
- Que se passe-t-il lorsqu’un appel ne peut pas être traité ?
- Que peut contenir une version en dehors du texte ?
- Où voir quelle version a répondu à un appel ?
- Quels sujets ne sont pas couverts ici ?
- FAQ
- Qu’est-ce que la gestion des versions de prompts ?
- Appeler un prompt par identifiant ajoute-t-il de la latence ou des tokens ?
- En combien de temps un changement de prompt atteint-il la production ?
- Puis-je continuer à utiliser le SDK OpenAI ou Anthropic ?
- Pour aller plus loin
La gestion des versions de prompts consiste à sortir les prompts du code pour les stocker sous forme de versions numérotées et immuables. On les appelle par leur identifiant, puis on choisit la version utilisée en production en déplaçant un label. Un label est un pointeur nommé, par exemple production ou staging, qui désigne une seule version à la fois. Dans la bibliothèque de prompts Synthorai, la requête indique le prompt via prompt_id. La passerelle y insère les messages, le modèle et les paramètres de la version. Déplacer le label production change donc la version utilisée par les appels suivants. Lors de nos essais, le changement a atteint les appels réels en 8 à 9 secondes sous trafic continu, et dès le premier appel après une période sans trafic. Un appel par identifiant envoyait exactement autant de tokens de prompt que la même requête écrite dans le code.
TL;DR
- Un appel par
prompt_idà la passerelle Synthorai a envoyé une médiane de 114.5 tokens de prompt sur 20 paires, comme la requête envoyée directement. - Sous trafic continu, le déplacement du label
productiona été pris en compte par les appels après 8.0 à 8.5 s (médiane), et immédiatement après 15 s sans appel. - Sur 20 déplacements de label, aucun appel n’a reçu l’ancienne version après qu’un premier appel avait reçu la nouvelle.
- Les appels impossibles à traiter ont échoué avec un code 400 ou 404 avant toute exécution de modèle, sans facturation.
Ce guide reprend les prompts de l’agent de support de Tracer un agent LLM, les place dans la bibliothèque et les appelle de toutes les façons acceptées par la passerelle. Le code se trouve sur github.com/synthorai-io/use-cases, dans prompt-library/. Il nécessite Python 3.10 ou ultérieur, une clé d’inférence et une clé d’administration dotée du droit prompts.write, à créer dans la console.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put both keys in it
cd prompt-library
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python setup.py         # saves the prompts and their versions; safe to run again
python call.py          # every way to call a prompt
python ship.py          # moves production and times it
python errors.py        # what a call that cannot be served answers
Les essais présentés ici datent du 19 octobre 2026. setup.py enregistre deux prompts. support-answer correspond à l’étape de réponse de l’agent, avec quatre versions qui introduisent chacune un changement réaliste. policy-check est un contrôle effectué par un sous-agent qui répond en JSON :
| Prompt | Version | Changement | Modèle |
|---|---|---|---|
support-answer | v1 | référence : indiquer le numéro de commande, ne jamais promettre de date de remboursement | GPT-6 Luna |
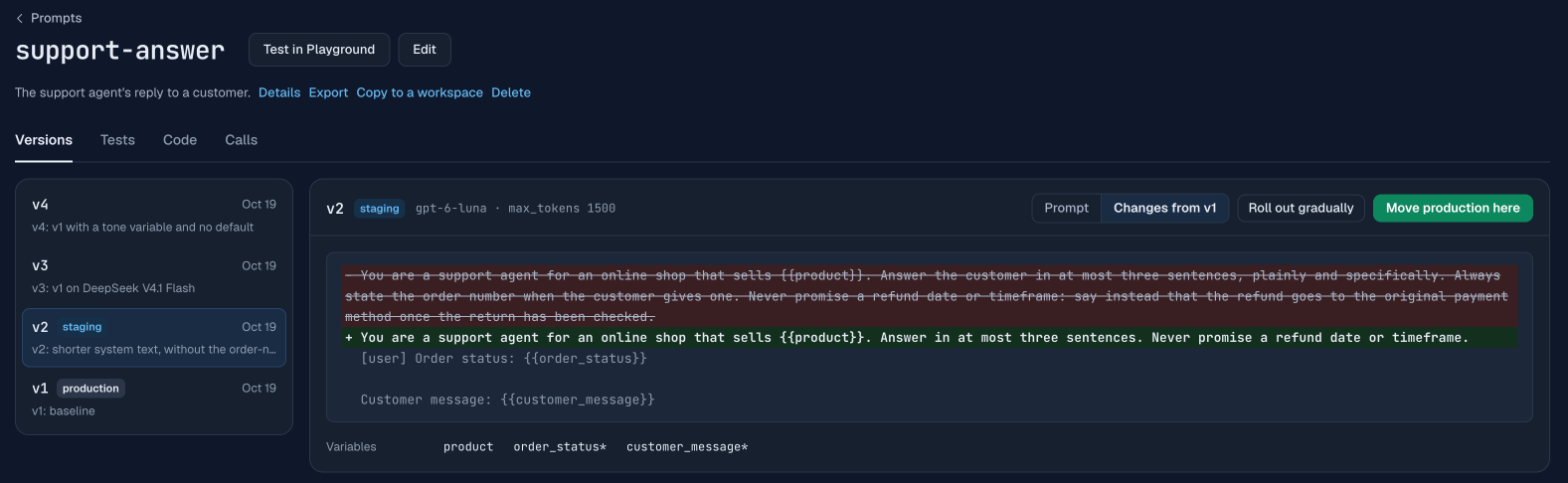
support-answer | v2 | texte système raccourci, sans la règle sur le numéro de commande | GPT-6 Luna |
support-answer | v3 | texte de v1 sur un autre modèle | DeepSeek V4.1 Flash |
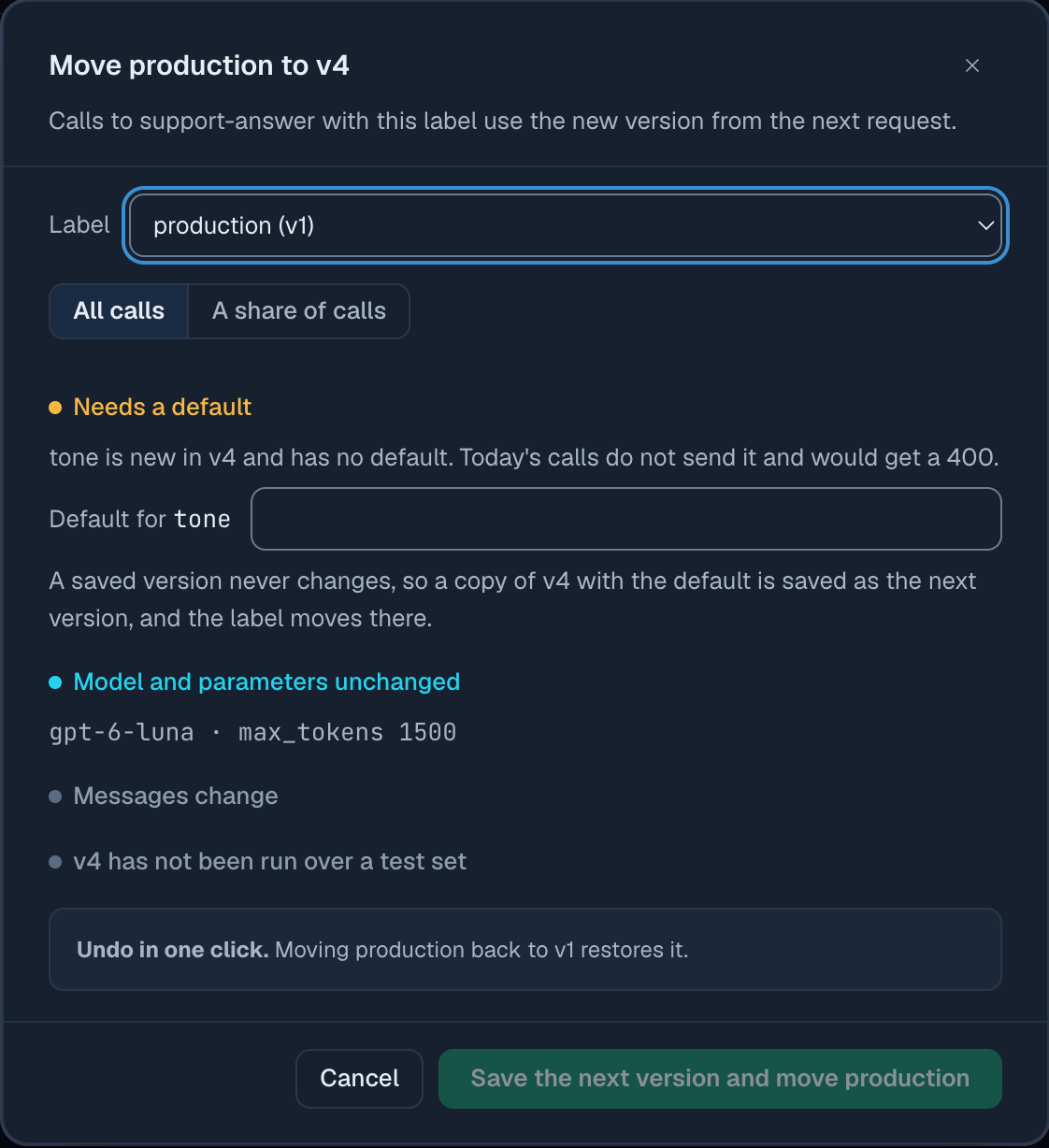
support-answer | v4 | v1 avec une variable {{tone}} sans valeur par défaut | GPT-6 Luna |
policy-check | v1 | sujets et niveau de risque, en JSON conforme à un schéma | DeepSeek V4.1 Flash |
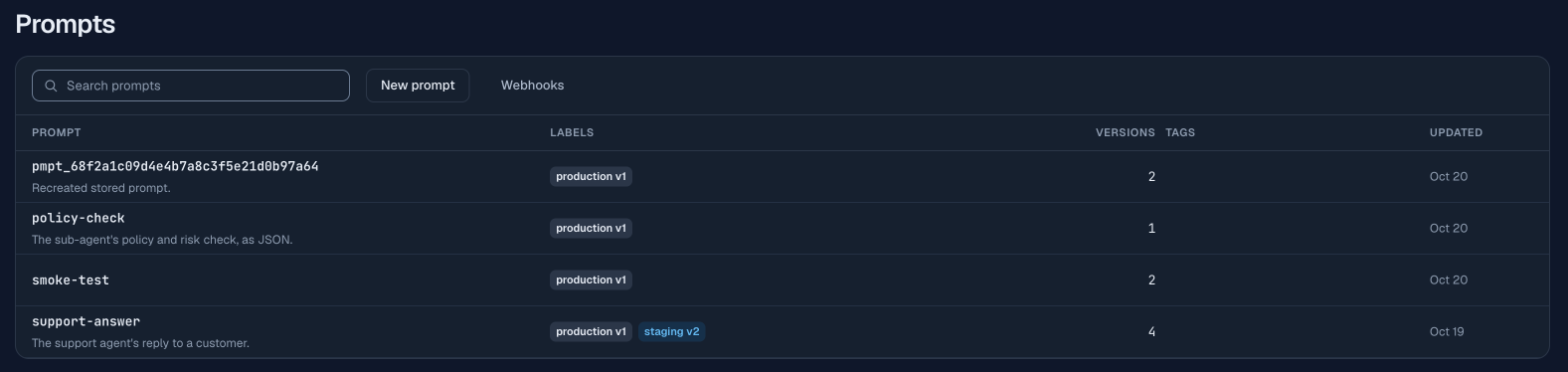
production pointe vers v1 et staging vers v2. Les deux guides suivants utilisent v2 et v3 pour tester une version avant sa mise en production et la déployer sur une partie du trafic de production. La console compare chaque version à la précédente :
Comment appeler un prompt par son identifiant ?
Envoyez une requête ordinaire à /v1/chat/completions, /v1/responses ou /v1/messages, en ajoutant prompt_id et prompt_variables dans le corps. Une variable est un emplacement {{name}} dans le texte de la version ; prompt_variables fournit sa valeur pour cet appel. Les SDK exigent un modèle et un message : indiquez n’importe quel nom de modèle et un message utilisateur vide. La passerelle utilise le modèle de la version et supprime le message vide. Avec le SDK Python OpenAI, les champs supplémentaires passent par extra_body :
import os
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key=os.environ["SYNTHORAI_API_KEY"])

raw = client.chat.completions.with_raw_response.create(
    model="any",                                   # the version's model is used
    messages=[{"role": "user", "content": ""}],    # required by the SDK; dropped
    extra_body={
        "prompt_id": "support-answer",
        "prompt_variables": {
            "customer_message": "Where is order A-50977? It has been a week.",
            "order_status": "in transit, shipped on 2026-10-01",
        },
    },
)
print(raw.headers["x-synthorai-prompt-version"])   # which version answered
print(raw.parse().choices[0].message.content)
L’appel ne contient pas product, car la version lui donne une valeur par défaut (« home electronics »). L’en-tête de réponse X-Synthorai-Prompt-Version indique la version qui a répondu. Lorsqu’un appel utilise un label, c’est le seul moyen pour l’appelant de connaître la version utilisée.
Sans version explicite, l’appel utilise celle que désigne production. Deux champs permettent d’en choisir une autre. Un appel peut envoyer l’un ou l’autre, mais pas les deux :
| Champ | Exemple | Version utilisée dans la démo |
|---|---|---|
| aucun | v1 (production) | |
prompt_label | "staging" | v2 |
prompt_version | 1 | v1 |
Le même appel par identifiant a fonctionné sur les trois endpoints : Chat Completions et Responses via le SDK OpenAI, et Messages via le SDK Anthropic avec le même extra_body. Tous trois ont utilisé v1 sur GPT-6 Luna. Sur Responses, les messages de la version sont placés dans input ; le guide de la bibliothèque de prompts détaille la correspondance des champs pour chaque endpoint.
Un appel par identifiant coûte-t-il plus cher qu’un prompt écrit dans le code ?
Un appel par identifiant coûte autant que la requête écrite dans le code, car la passerelle envoie une requête ordinaire au fournisseur. Nous l’avons vérifié sur 20 paires. Pour chaque paire, nous avons généré la requête à partir du prompt, envoyé cette requête directement, puis envoyé les mêmes valeurs par identifiant. L’ordre alternait entre les paires. Les deux appels d’une paire utilisaient le même sel, une courte chaîne aléatoire ajoutée au message pour que deux paires ne correspondent jamais à la même requête :
| Tokens de prompt, médiane | Latence côté client, médiane | |
|---|---|---|
Par prompt_id | 114.5 | 4.1 s |
| Requête directe | 114.5 | 4.6 s |
Le nombre de tokens est identique. L’appel par identifiant était le plus rapide des deux, ce qu’un surcoût de traitement ne peut pas expliquer. Nous attribuons donc l’écart aux variations entre appels de GPT-6 Luna et concluons que l’appel par identifiant n’a ajouté aucun délai mesurable. Nous n’avons pas testé statistiquement la différence de latence.
Pour voir ce qu’un appel enverrait sans solliciter de modèle, utilisez le rendu. POST /v1/prompts/{id}/render accepte les mêmes variables et renvoie la requête ainsi que la version retenue :
curl https://synthorai.io/v1/prompts/support-answer/render \
  -H "Authorization: Bearer $SYNTHORAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"format": "chat", "prompt_variables": {"customer_message": "Where is order A-50977?", "order_status": "in transit"}}'
Un rendu n’est pas facturé et n’apparaît pas dans les logs : après le rendu de la démo, aucune requête portant son identifiant de session n’y figurait. Il compte toutefois dans la limite de débit de la clé.
En combien de temps un déplacement de label atteint-il les appels ?
En moins de 10 secondes : lors de nos essais, 8 à 9 s sous trafic continu, et immédiatement après une période sans trafic. Publier une version demande un seul appel avec une clé d’administration pour faire pointer un label vers un numéro de version :
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})
admin.put("/prompts/support-answer/labels/production", json={"version": 3}).raise_for_status()
Pour revenir en arrière, faites le même appel avec l’ancien numéro de version. Le code continue d’appeler le même identifiant, sans redéploiement. Seuls un administrateur ou le propriétaire de l’espace de travail peuvent déplacer un label. Chaque déplacement est consigné dans le journal d’audit de l’espace de travail.
ship.py a mesuré ce délai. Le script envoyait un appel toutes les 0.5 s, déplaçait production via l’API, puis poursuivait les appels jusqu’à ce que l’en-tête indique la nouvelle version, et pendant encore 10 s. Il a effectué 5 passages de v1 à v3 et 5 retours, puis répété ces 10 déplacements après 15 s sans appel :
| Cas | Envoi du dernier appel ayant reçu l’ancienne version | Envoi du premier appel ayant reçu la nouvelle version |
|---|---|---|
| Un appel toutes les 0.5 s, de v1 à v3 | médiane de 8.02 s après le déplacement (7.53 à 8.53) | médiane de 8.52 s (8.03 à 9.03) |
| Un appel toutes les 0.5 s, de v3 à v1 | médiane de 7.52 s (7.52 à 8.52) | médiane de 8.02 s (8.02 à 9.02) |
| Après 15 s sans appel, dans les deux sens | aucun | 0.0 s, pour les 10 déplacements |
Les temps sont mesurés à partir du retour de l’appel API qui déplace le label. La documentation annonce une prise en compte en « environ 10 secondes ». Les deux cas correspondent au comportement d’une passerelle qui conserve le label lu pendant quelques secondes à compter de sa dernière lecture : sous trafic continu, le changement devient visible à l’expiration de cette copie ; après une pause, le premier appel relit le label. Sur les 20 déplacements, aucun appel n’a reçu l’ancienne version après qu’un premier appel avait reçu la nouvelle. La propagation ne provoque donc pas d’alternance entre les versions.
Que se passe-t-il lorsqu’un appel ne peut pas être traité ?
L’appel échoue avant toute invocation de modèle, avec un code 400 ou 404 au format d’erreur de l’endpoint utilisé, sans facturation. errors.py a envoyé cinq appels de ce type :
| Appel | Statut | Code | Message |
|---|---|---|---|
v4 sans tone | 400 | prompt_variable_missing | « prompt_variables : tone manquant (ni valeur fournie ni valeur par défaut) » |
| une version et un label | 400 | prompt_invalid | « envoyez prompt_version ou prompt_label, pas les deux » |
| un identifiant inexistant | 404 | prompt_not_found | « prompt_id : aucun prompt “support-answer-missing” dans cet espace de travail » |
| version 99 | 404 | prompt_not_found | « le prompt “support-answer” n’a pas de version 99 » |
| un label sans version cible | 404 | prompt_not_found | « le label “development” du prompt “support-answer” ne pointe encore vers aucune version » |
Aucun de ces cinq appels n’a de ligne de facturation. La première ligne illustre un changement qui casserait les appels existants : v4 ajoute une variable sans valeur par défaut, donc tout appel sans tone échoue. La console détecte ce problème avant la publication. Lorsqu’on déplace production vers v4, une boîte de dialogue vérifie les conséquences pour les appels actuels et demande une valeur par défaut, qu’elle enregistre dans la version suivante.
Si la bibliothèque est temporairement illisible, la passerelle utilise la dernière copie lue pendant une durée maximale de 24 heures et ajoute X-Synthorai-Prompt-Stale: 1 à la réponse. Pour un prompt dont elle ne possède aucune copie récente, elle renvoie une erreur 503 prompt_unavailable ; réessayez l’appel. Nous n’avons observé aucun de ces deux cas dans la démo.
Que peut contenir une version en dehors du texte ?
Une version contient le texte système, les messages, le modèle, cinq paramètres, un schéma de sortie et des outils de type fonction. Pour les paramètres, ceux de l’appelant sont prioritaires : les valeurs temperature, max_tokens, top_p, response_format et reasoning_effort de la version ne s’appliquent que si la requête ne définit pas le même champ.
policy-check stocke son schéma JSON dans la version. Les appelants reçoivent donc un JSON conforme sans avoir à préciser de format. Lors de l’enregistrement via l’API, la version indique le format dans params et contient le schéma dans schema :
version = {
    "model": "deepseek-v4.1-flash",
    "system": "You review messages to an online electronics shop's support desk. ...",
    "messages": [{"role": "user", "content": "{{customer_message}}"}],
    "params": {"max_tokens": 300, "response_format": "json_schema"},
    "schema": {"name": "policy_check", "strict": True, "schema": {
        "type": "object",
        "properties": {"topics": {"type": "array", "items": {"type": "string"}},
                       "risk": {"type": "string", "enum": ["low", "medium", "high"]}},
        "required": ["topics", "risk"], "additionalProperties": False}},
}
admin.post("/prompts/policy-check/versions", json={"body": version, "note": "v1: JSON check"}).raise_for_status()
L’enregistrement d’un schéma sans response_format: "json_schema" est refusé avec une erreur 400 qui en indique la raison. Un appel de policy-check sur DeepSeek V4.1 Flash a renvoyé {"topics": ["shipping", "refunds"], "risk": "medium"} avec 151 tokens d’entrée et 18 tokens de sortie, pour $0.000033. Cet appel fournissait reasoning_effort: "none" côté appelant, car les versions de la démo avaient été enregistrées avant que ce paramètre puisse être stocké dans une version. Une version peut désormais le conserver dans params : nous avons enregistré une version de test avec reasoning_effort: "none", puis généré son rendu. La requête contenait reasoning_effort sur Chat Completions et reasoning.effort sur Responses. Sur Messages, la valeur de la version est omise, car les modèles Claude attendent les paramètres de réflexion sous une autre forme ; fournissez-les côté appelant sur cet endpoint.
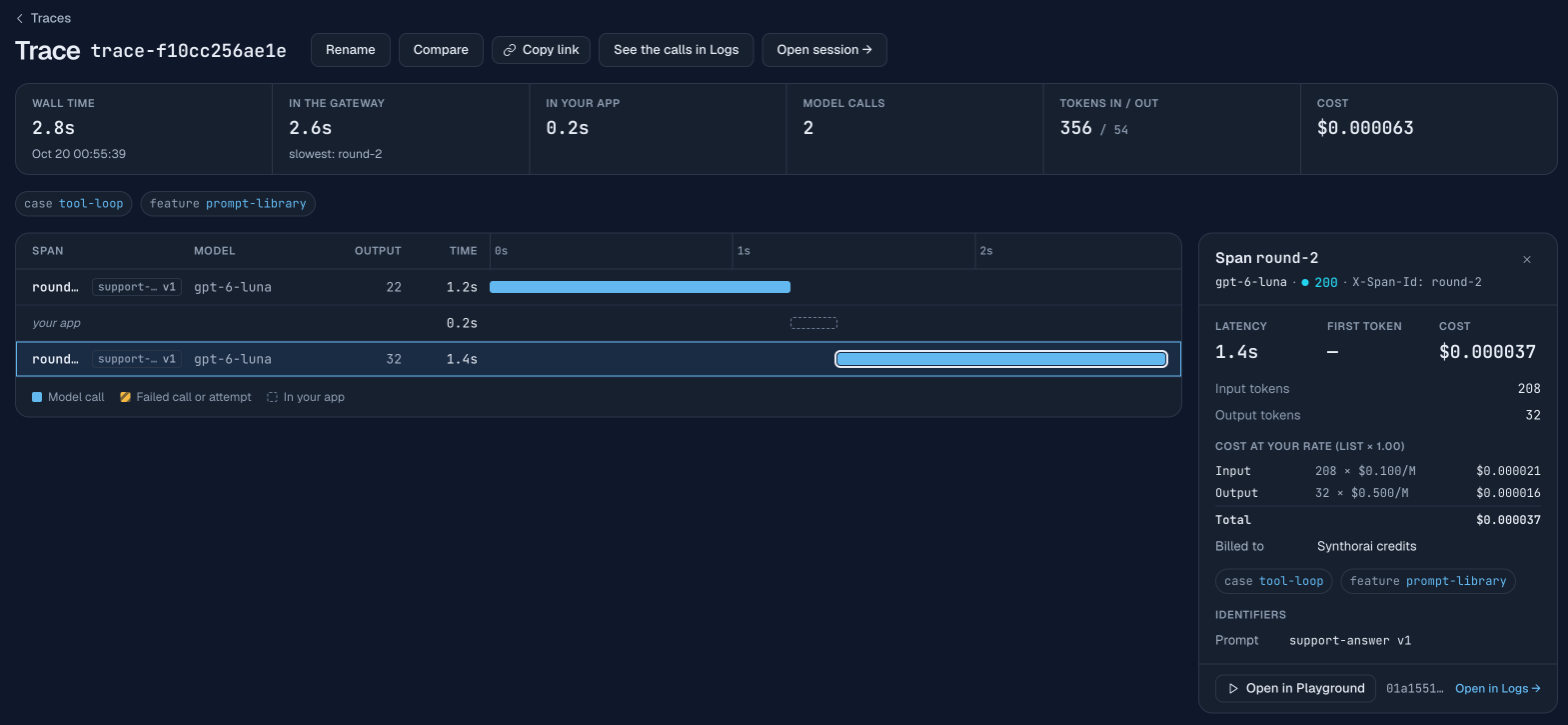
Les appels d’outils et les conversations à plusieurs tours fonctionnent comme sans prompt de bibliothèque. Les messages de la version viennent en premier, suivis de la conversation envoyée par l’appelant. Au premier tour de la boucle d’outils de la démo, le modèle a demandé lookup_order({"order_id": "A-50977"}). Au deuxième tour, l’appel d’outil du modèle et le résultat de l’outil ont été envoyés sous forme de messages ordinaires, avec le même identifiant de prompt, et v1 a répondu à partir du résultat.
Où voir quelle version a répondu à un appel ?
Chaque appel est enregistré avec son prompt et sa version. On peut les retrouver à trois endroits :
- Dans la réponse : l’en-tête
X-Synthorai-Prompt-Version, que la démo inscrit à côté de chaque appel dans ses résultats. - Dans les logs : le filtre
prompt = support-answeravecprompt_version = 3liste les appels de cette version. Le détail d’une requête indique son prompt et sa version.GET /api/v1/requestsaccepte les mêmes filtresprompt_idetprompt_version. - Dans une trace : chaque ligne d’appel au modèle dans la vue en cascade porte un badge « prompt vN », et le panneau de l’appel indique le prompt et la version. Les en-têtes de traçage de Tracer un agent LLM fonctionnent sans modification avec les appels par identifiant.
La page Prompts agrège les appels, les erreurs, les dépenses, les tokens et la latence par version sur 7, 30 ou 90 jours. Le guide de déploiement progressif utilise cette vue pour comparer deux versions sur du trafic réel.
Quels sujets ne sont pas couverts ici ?
- Déploiements progressifs et tests. L’envoi d’une part du trafic de production à une version candidate est décrit dans Tester un changement de prompt en A/B. Les tests sur un jeu d’entrées fixe sont traités dans Tester un prompt avant sa mise en production.
- Fragments réutilisables. Un bloc de texte stocké une seule fois et inclus dans plusieurs prompts avec
{{>id}}; chaque version enregistrée fige la version du fragment qu’elle inclut. - Webhooks de changement. Un POST signé lors de la création d’une version ou du déplacement d’un label permet de synchroniser les prompts avec git ou un canal de discussion. Le fichier
webhook.pyde la démo vérifie une signature, mais nous n’avons pas reçu de notification réelle. - Idempotence à la création. Un en-tête
Idempotency-Keypermet de réessayer une requête sans risque : pendant 24 heures, l’API renvoie la première réponse pour une clé déjà utilisée, au lieu de créer le prompt deux fois. Cela reste vrai après la suppression du prompt. Pour recréer un prompt supprimé, envoyez donc une nouvelle clé.
FAQ
Qu’est-ce que la gestion des versions de prompts ?
La gestion des versions de prompts consiste à conserver chaque prompt sous forme de versions numérotées, immuables une fois enregistrées, puis à choisir la version utilisée en production avec un label plutôt qu’une modification du code. Pour revenir en arrière, il suffit de faire pointer le label vers la version précédente.
Appeler un prompt par identifiant ajoute-t-il de la latence ou des tokens ?
Sur nos 20 paires, ni l’un ni l’autre : la médiane était de 114.5 tokens de prompt dans les deux cas, et l’appel par identifiant n’était pas plus lent. La passerelle détermine la version à utiliser et envoie une requête ordinaire au fournisseur.
En combien de temps un changement de prompt atteint-il la production ?
En environ 10 secondes. Lors de nos essais sous trafic continu, le premier appel ayant reçu la nouvelle version était envoyé 8.0 à 8.5 s (médiane) après le déplacement du label. Après une pause de trafic de 15 s, le changement était pris en compte immédiatement.
Puis-je continuer à utiliser le SDK OpenAI ou Anthropic ?
Les deux SDK fonctionnent sans modification : ils transmettent les champs du prompt via extra_body, avec n’importe quel nom de modèle et un message utilisateur vide pour satisfaire leurs arguments obligatoires.
Pour aller plus loin
- Guide de la bibliothèque de prompts : tous les champs, erreurs et en-têtes de réponse présentés ici.
- Les prompts dans la console : l’éditeur, la comparaison des versions et la boîte de dialogue de déplacement.
- Tester un changement de prompt en A/B : un déploiement sur 10% du trafic et la comparaison par version.
- Tester un prompt avant sa mise en production : jeux de test, contrôles et conclusions qu’une exécution permet ou non de tirer.
- Tracer un agent LLM : les en-têtes de session et de trace que la démo continue d’envoyer.