
Gemini Nano Banana 2.1 vs GPT Image 2
Lequel choisir, et quand
Les deux facturent $30 par million de tokens de sortie image, la différence se joue donc sur l'entrée et sur ce que chacun accepte. gemini-nano-banana-2.1 coûte $1.5 par million de tokens d'entrée contre $5 pour gpt-image-2, accepte la vidéo en plus du texte et de l'image, prend jusqu'à 14 images de référence et peut renvoyer du texte en même temps que l'image. gpt-image-2 propose l'édition avec inpainting par masque et des résolutions libres dont les côtés vont jusqu'à 3840 pixels, là où gemini-nano-banana-2.1 propose le 1K, le 2K et le 4K dans des formats d'image fixes. Choisissez gemini-nano-banana-2.1 pour les travaux riches en images de référence ou en plusieurs tours, et gpt-image-2 pour les retouches par masque et les tailles personnalisées.
Tarifs
| Gemini Nano Banana 2.1 | GPT Image 2 | Δ | |
|---|---|---|---|
| Entrée / 1M de tokens | $1.5 | $5 | 0.3× |
| Sortie / 1M de tokens | $30 | $30 | = |
Tarifs relevés dans le catalogue en direct à la génération du site ; la page de chaque modèle affiche la grille tarifaire à jour.
Leur position : prix en sortie pour 1M de tokens, parmi les 11 modèles de génération d'images facturés dans cette unité (échelle logarithmique)
Spécifications
| Gemini Nano Banana 2.1 | GPT Image 2 | |
|---|---|---|
| Modalités d'entrée | texte image vidéo | texte image |
| Modalités de sortie | texte image | image |
| Date de sortie | 2026-10-06 | 2026-04-21 |
| Tailles de sortie |
|
|
| Modes d'entrée | text-to-image, single-turn and multi-turn editing, up to 14 reference images | text-to-image, image edit with mask inpainting |
| Images par requête | - | 10 |
| Formats | - | png, jpeg, webp |
| Notes | 1K, 2K and 4K output at fifteen aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9, 9:21, 1:4, 4:1, 1:8, 8:1) up to 14 reference images per request single-turn editing and multi-turn conversational iteration | Flexible resolutions: edges up to 3840px in multiples of 16, ratio <=3:1, ~0.65-8.3MP total (incl. 4K 3840x2160) editing with mask inpainting all image inputs processed at high fidelity significantly improved text rendering (precise placement can still struggle) |
Les spécifications sont reprises de la documentation de chaque fournisseur ; quand un fournisseur ne publie pas une valeur, la ligne est omise et non déduite. Sources complètes : Gemini Nano Banana 2.1 · GPT Image 2
Un prompt, deux modèles, mesurés via la passerelle
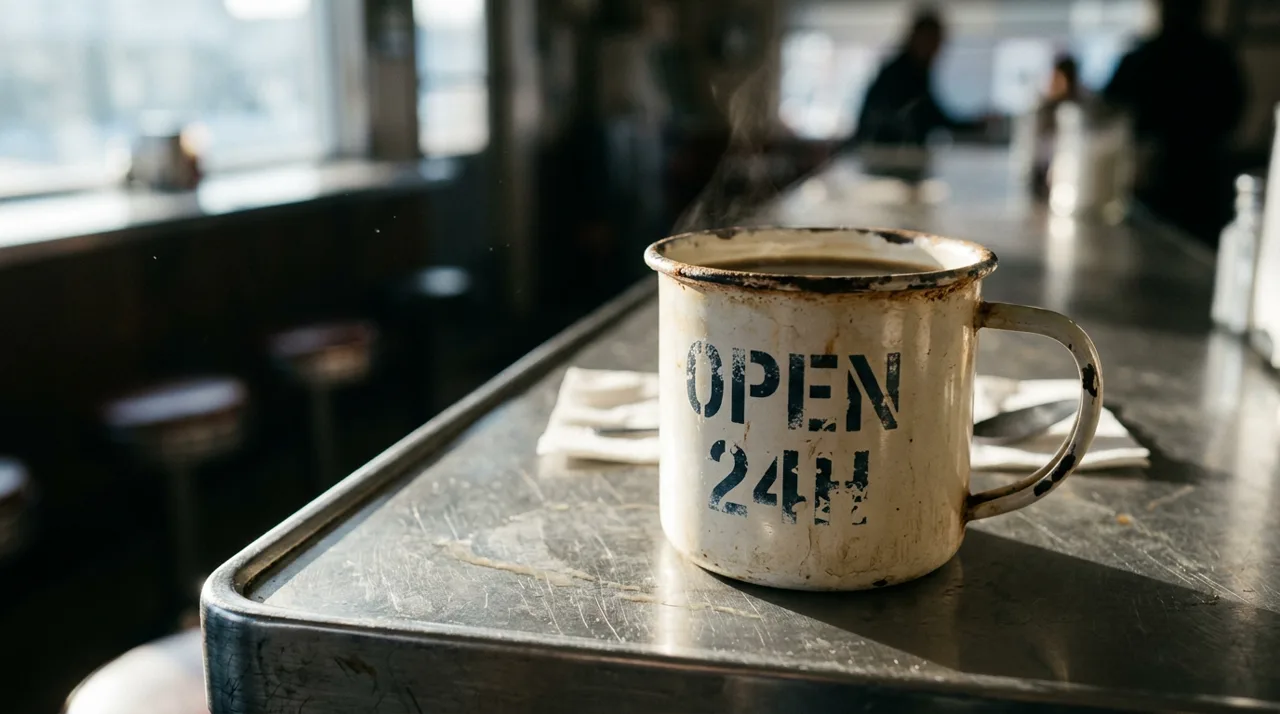
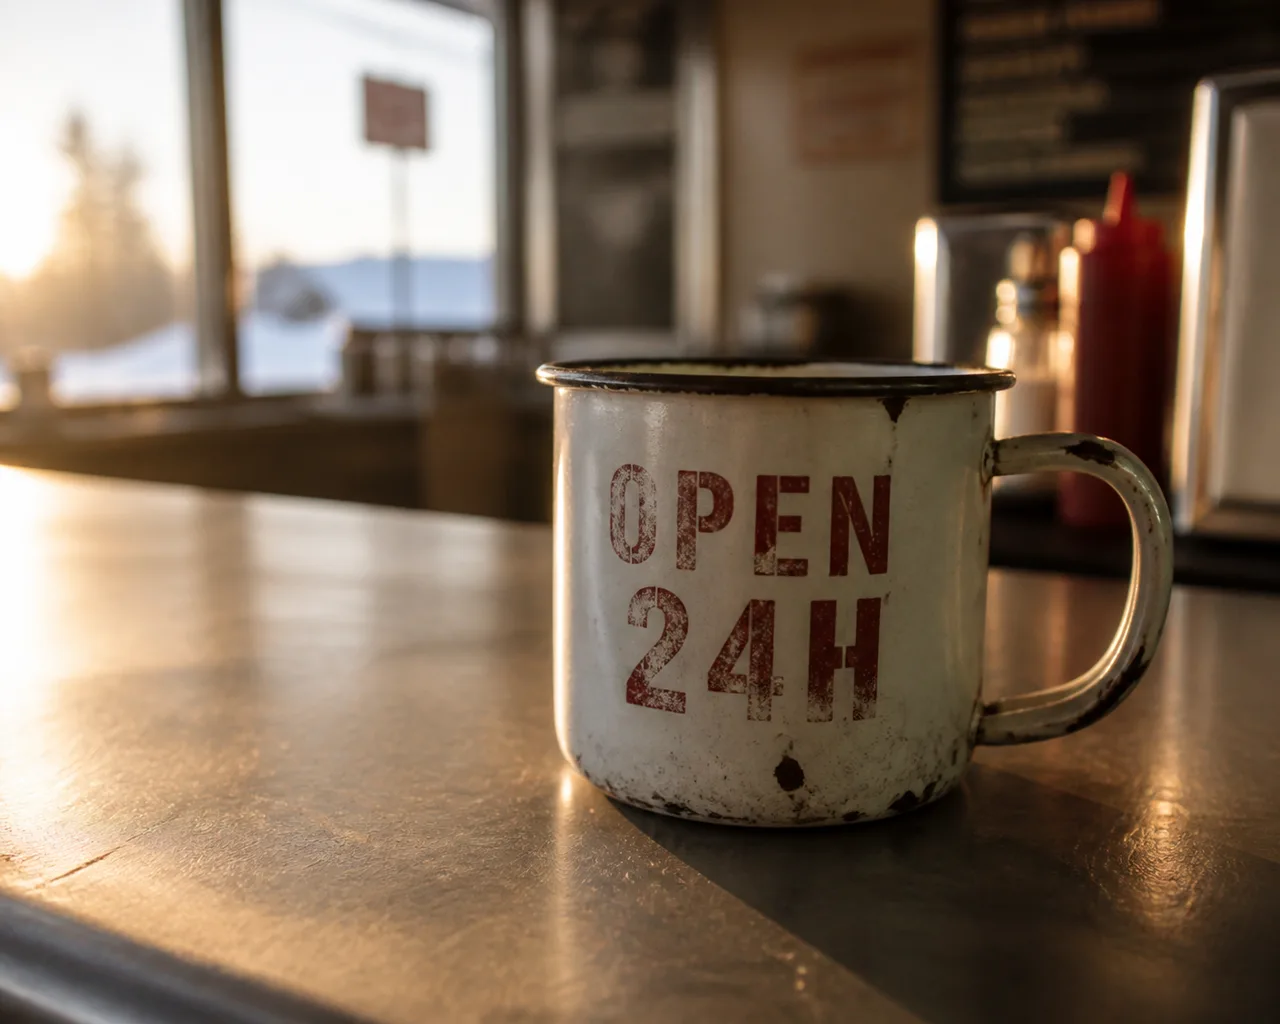
Un prompt, une requête par modèle, sans nouvel essai ni tri des résultats : c'est le premier résultat renvoyé par chaque modèle. Ni la taille ni la durée n'ont été imposées. Chaque modèle a utilisé sa valeur par défaut, car une requête calibrée pour convenir à tous n'en mettrait aucun en valeur. Les fichiers sont réencodés pour le web : jugez la composition et le respect du prompt, pas la compression.
Passez de l'un à l'autre en changeant une seule ligne
Les deux identifiants figurent dans chaque onglet ci-dessous : les deux lignes surlignées sont le seul changement. Même endpoint, même clé, même format de requête.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-nano-banana-2.1",
    # model="gpt-image-2",  # décommentez cette ligne, commentez celle du dessus
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-nano-banana-2.1",
// model: "gpt-image-2", // décommentez cette ligne, commentez celle du dessus
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-nano-banana-2.1",
# "model": "gpt-image-2", # décommentez cette ligne, commentez celle du dessus
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-nano-banana-2.1",
// Model: "gpt-image-2", // décommentez cette ligne, commentez celle du dessus
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-nano-banana-2.1")
// .model("gpt-image-2") // décommentez cette ligne, commentez celle du dessus
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Lequel est le moins cher, Gemini Nano Banana 2.1 ou GPT Image 2 ?
Gemini Nano Banana 2.1 est moins cher sur la ligne « Entrée / 1M de tokens » ($1.5 contre $5, soit un écart de 3.3×). D'autres lignes peuvent dire l'inverse : le tableau ci-dessus donne la grille tarifaire complète, et le coût réel dépend de la composition de votre trafic.
Puis-je faire un test A/B entre Gemini Nano Banana 2.1 et GPT Image 2 sans deux intégrations ?
Oui. Les deux passent par le même endpoint compatible OpenAI, avec une seule clé API. Pour passer de l'un à l'autre, il suffit de changer l'identifiant du modèle, soit une ligne : vous pouvez donc envoyer une part du trafic à chacun et comparer directement les factures.
Le prix change-t-il avec la taille de l'image ?
Cela dépend du mode de facturation du modèle. Un modèle facturé à l'image coûte le même prix quelle que soit la taille du prompt ou de la sortie. Un modèle facturé au token coûte plus cher à mesure que la résolution générée augmente : une image 4K revient à plusieurs fois le prix d'une petite. Le tableau ci-dessus indique le cas de chacun.