
GPT Image 2 vs GPT Image 2.5 Sunburst
Lequel choisir, et quand
Gardez gpt-image-2 pour un flux existant qui utilise ses dimensions flexibles. Essayez gpt-image-2.5-sunburst pour les niveaux xhigh ou max et mesurez les jetons de sortie à la taille voulue.
Tarifs
| GPT Image 2 | GPT Image 2.5 Sunburst | Δ | |
|---|---|---|---|
| Entrée / 1M de tokens | $5 | $5 | = |
| Sortie / 1M de tokens | $30 | $30 | = |
| Jetons d’image de référence / million | $8 | $8 | = |
Tarifs relevés dans le catalogue en direct à la génération du site ; la page de chaque modèle affiche la grille tarifaire à jour.
Leur position : prix en sortie pour 1M de tokens, parmi les 15 modèles de génération d'images facturés dans cette unité (échelle logarithmique)
Spécifications
| GPT Image 2 | GPT Image 2.5 Sunburst | |
|---|---|---|
| Modalités d'entrée | texte image | texte image |
| Modalités de sortie | image | image |
| Date de sortie | 2026-04-21 | 2026-09-08 |
| Tailles de sortie |
|
|
| Modes d'entrée | text-to-image, édition d'image avec retouche par masque | Génération à partir de texte et retouche avec une image de référence |
| Images par requête | 10 | 4 |
| Formats | png, jpeg, webp | png, jpeg, webp |
| Notes | Résolutions flexibles: côtés jusqu'à 3840px par multiples de 16, rapport <=3:1, environ 0,65 à 8,3 MP au total (4K 3840x2160 compris) édition avec retouche par masque toutes les images d'entrée traitées en haute fidélité rendu de texte nettement amélioré (le placement précis peut encore poser problème) | La largeur et la hauteur personnalisées doivent être des multiples de 16, avec un rapport de 1:3 à 3:1. quality ajoute xhigh et max au-dessus de high. Sur Synthorai, envoyez l’image de référence en base64 dans le champ image d’une requête JSON à /v1/images/generations. |
Les spécifications sont reprises de la documentation de chaque fournisseur ; quand un fournisseur ne publie pas une valeur, la ligne est omise et non déduite. Sources complètes : GPT Image 2 · GPT Image 2.5 Sunburst
Un prompt, deux modèles, mesurés via la passerelle
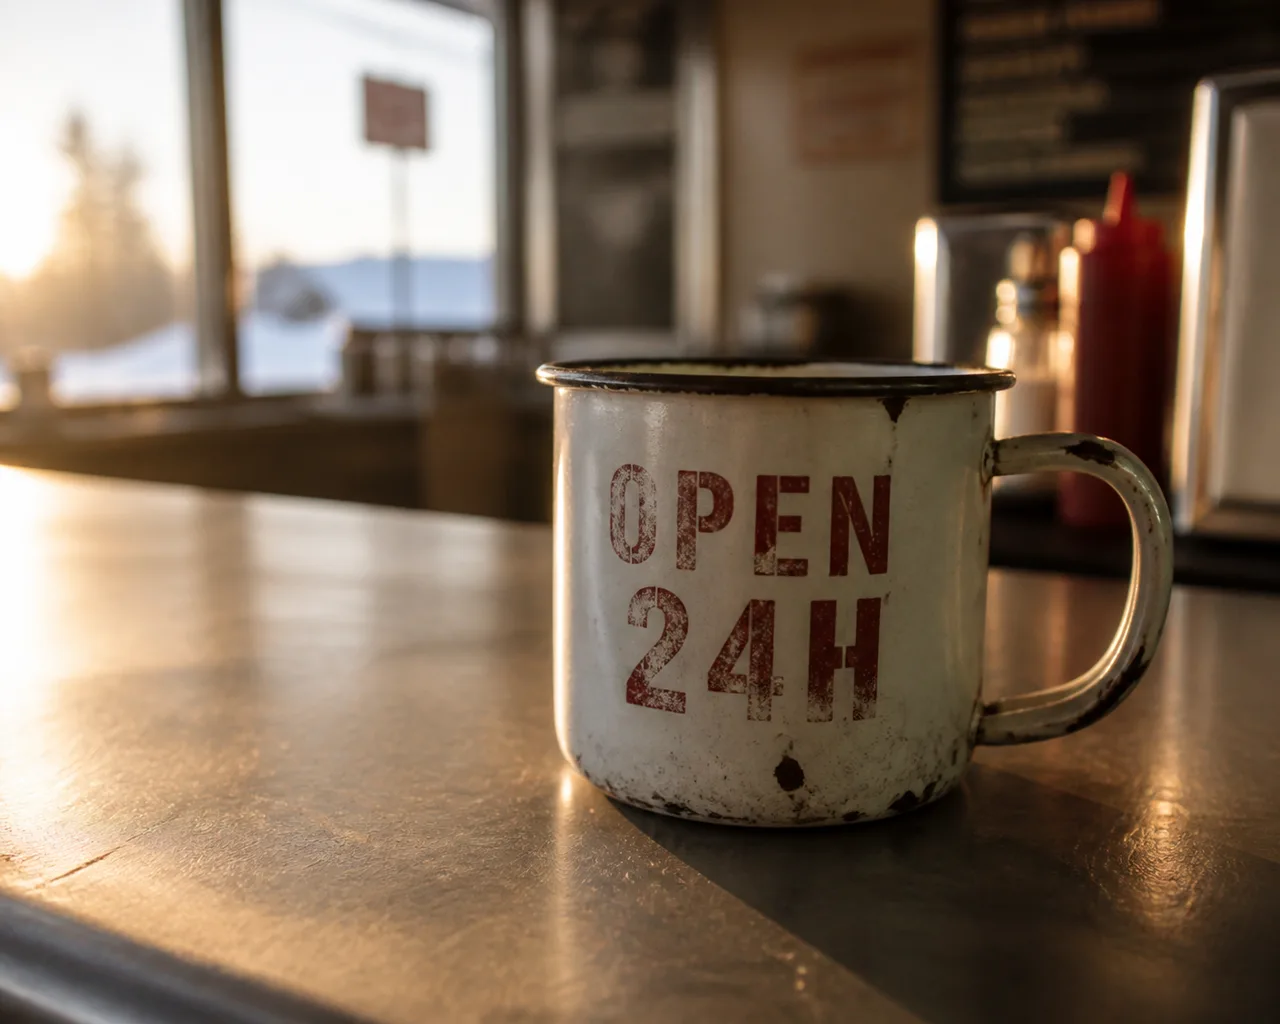
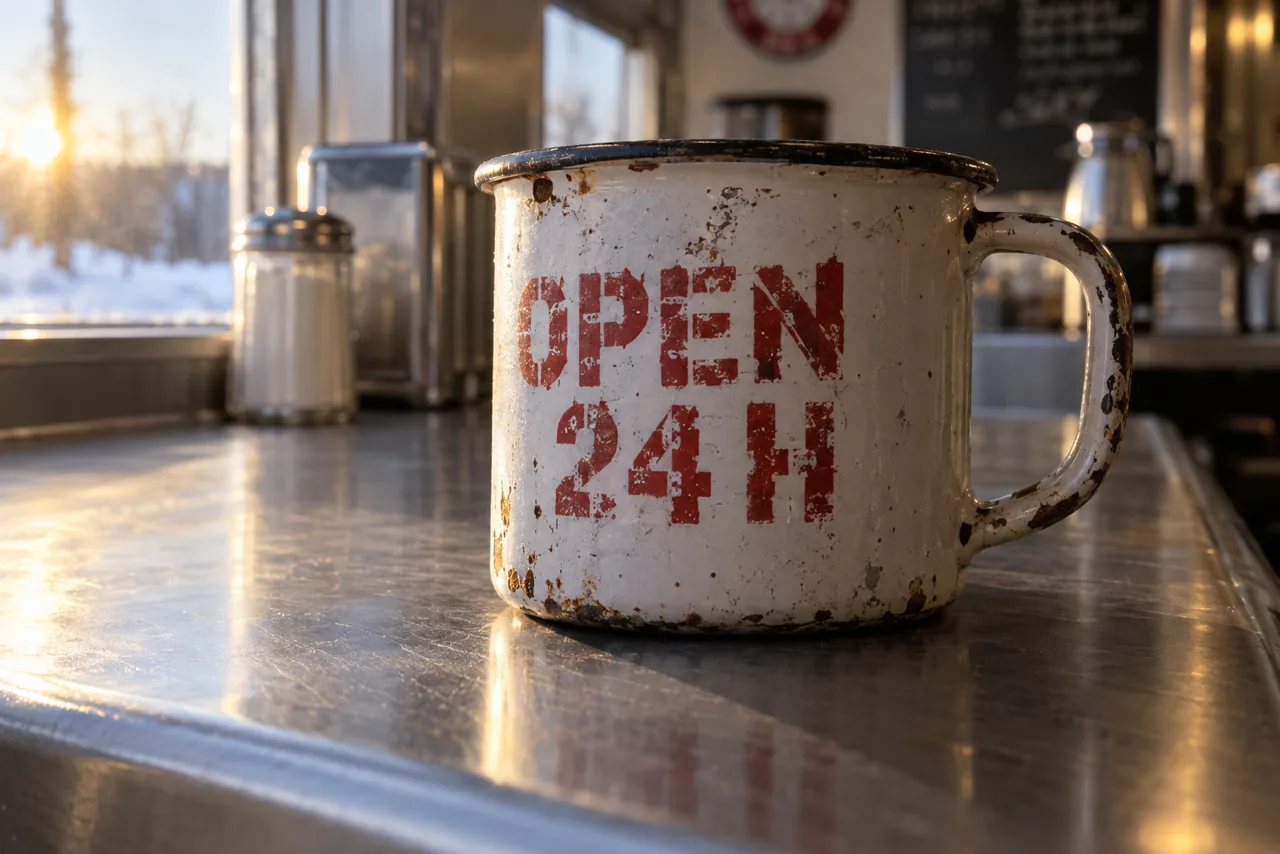
Un prompt, une requête par modèle, sans nouvel essai ni tri des résultats : c'est le premier résultat renvoyé par chaque modèle. Ni la taille ni la durée n'ont été imposées. Chaque modèle a utilisé sa valeur par défaut, car une requête calibrée pour convenir à tous n'en mettrait aucun en valeur. Les fichiers sont réencodés pour le web : jugez la composition et le respect du prompt, pas la compression.
Passez de l'un à l'autre en changeant une seule ligne
Les deux identifiants figurent dans chaque onglet ci-dessous : les deux lignes surlignées sont le seul changement. Même endpoint, même clé, même format de requête.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gpt-image-2",
    # model="gpt-image-2.5-sunburst",  # décommentez cette ligne, commentez celle du dessus
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gpt-image-2",
// model: "gpt-image-2.5-sunburst", // décommentez cette ligne, commentez celle du dessus
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-2",
# "model": "gpt-image-2.5-sunburst", # décommentez cette ligne, commentez celle du dessus
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gpt-image-2",
// Model: "gpt-image-2.5-sunburst", // décommentez cette ligne, commentez celle du dessus
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gpt-image-2")
// .model("gpt-image-2.5-sunburst") // décommentez cette ligne, commentez celle du dessus
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Lequel est le moins cher, GPT Image 2 ou GPT Image 2.5 Sunburst ?
Les deux affichent $5 pour « Entrée / 1M de tokens ». Les autres tarifs et les quantités utilisées peuvent changer le coût total.
Puis-je faire un test A/B entre GPT Image 2 et GPT Image 2.5 Sunburst sans deux intégrations ?
Oui. Les deux passent par le même endpoint compatible OpenAI, avec une seule clé API. Pour passer de l'un à l'autre, il suffit de changer l'identifiant du modèle, soit une ligne : vous pouvez donc envoyer une part du trafic à chacun et comparer directement les factures.
Le prix change-t-il avec la taille de l'image ?
Cela dépend du mode de facturation du modèle. Un modèle facturé à l'image coûte le même prix quelle que soit la taille du prompt ou de la sortie. Un modèle facturé au token coûte plus cher à mesure que la résolution générée augmente : une image 4K revient à plusieurs fois le prix d'une petite. Le tableau ci-dessus indique le cas de chacun.