
Retouches: GPT Image 2.6 Sunburst, Flare et GPT Image 2
Sommaire
- Qu’apporte GPT Image 2.6 ?
- Quels sont les résultats de GPT Image 2, 2.5 et 2.6 sur Arena ?
- Comment GPT Image 2, Sunburst et Flare ont-ils traité les mêmes retouches ?
- Combien de temps les trois modèles ont-ils mis pour retoucher le programme ?
- Une complexité élevée améliore-t-elle la retouche du programme ?
- Quand une annotation aide-t-elle GPT Image 2.6 à choisir le bon objet ?
- Comment les retouches ont-elles été testées ?
- FAQ
- La comparaison avec GPT Image 2 utilise-t-elle le même niveau de planification ?
- Avez-vous testé GPT Image 2.5 via Synthorai ?
- Quand utiliser une annotation pour retoucher une image ?
- Une complexité élevée a-t-elle rendu les retouches du programme plus fiables ?
GPT Image 2 et les deux variantes de GPT Image 2.6 ont mis à jour trois champs sur la même étiquette alimentaire sans modifier le texte autour. Sur un programme de conférence, Sunburst a réussi 2/4 rendus en complexité moyenne. Flare en complexité moyenne et GPT Image 2 avec sa planification par défaut ont obtenu 0/4. Les modèles devaient intervertir deux conférences et déplacer le badge FULL avec l’une d’elles.
TL;DR
- GPT Image 2 et les deux variantes 2.6 ont réussi la même retouche d’étiquette alimentaire.
- Sur le programme, Sunburst a réussi 2/4 essais en complexité moyenne. GPT Image 2 et Flare ont chacun obtenu 0/4.
- Sunburst a réussi 2/4 rendus du programme avec une
complexitymoyenne comme élevée. Flare a correctement interverti les deux conférences dans 0/4 rendus en complexité moyenne et 2/4 en complexité élevée, sans aucune réussite complète dans les deux cas. - Avec un repère visuel, la bonne cible a été sélectionnée dans 4/4 essais, contre 1/4 lorsque le texte ne précisait pas son emplacement.
Qu’apporte GPT Image 2.6 ?
OpenAI a lancé Images 2.6 le 4 novembre 2026. Sunburst est destiné aux travaux détaillés et aux retouches successives cohérentes, tandis que Flare vise des itérations plus rapides. Cette version a également ajouté les annotations visuelles à l’API, un réglage de planification et des formats de sortie GIF et SVG. Notes de version d’OpenAI
Le paramètre complexity contrôle la planification effectuée avant le rendu. Le paramètre quality, distinct, règle le niveau de détail du rendu. OpenAI propose trois niveaux de planification, low, medium et high. Sur son API, high est la valeur par défaut. Les requêtes 2.6 définissaient explicitement les deux paramètres. Guide OpenAI sur la génération d’images
Quels sont les résultats de GPT Image 2, 2.5 et 2.6 sur Arena ?
Les chiffres de GPT Image 2.5 proviennent uniquement du classement public d’Arena consacré à la retouche d’une image unique. Dans l’instantané du 12 novembre 2026, les deux entrées 2.5 affichaient un score supérieur à celui des entrées 2.6 Medium. Les scores d’Arena reflètent les préférences des votants. Les entrées ont des nombres de votes et des libellés de configuration différents. Les scores ci-dessous conservent la marge d’incertitude affichée par Arena. Classement Arena des retouches d’une image unique
| Entrée Arena | Score affiché | Votes |
|---|---|---|
| GPT Image 2.5 Sunburst | 1519 ± 5 | 131,648 |
| GPT Image 2.5 Flare | 1484 ± 4 | 128,720 |
| GPT Image 2.6 Sunburst (Medium) | 1476 ± 11 | 3,493 |
| GPT Image 2 (Medium) | 1462 ± 3 | 364,695 |
| GPT Image 2.6 Flare (Medium) | 1460 ± 10 | 3,534 |
« Medium » est le libellé utilisé par Arena. Dans notre test via la gateway, la requête GPT Image 2 ne contenait pas le champ complexity.
Comment GPT Image 2, Sunburst et Flare ont-ils traité les mêmes retouches ?
Les trois modèles ont réussi la retouche de l’étiquette alimentaire. GPT Image 2 et les deux variantes 2.6 ont correctement modifié la teneur en sodium, le numéro de lot et le poids net. Le texte environnant est resté intact dans chaque cas. Sunburst et Flare ont aussi réussi chacun six retouches simples sur six. Ils ont conservé les détails autour de la capsule et du badge de référence lorsque l’emplacement était clairement indiqué.
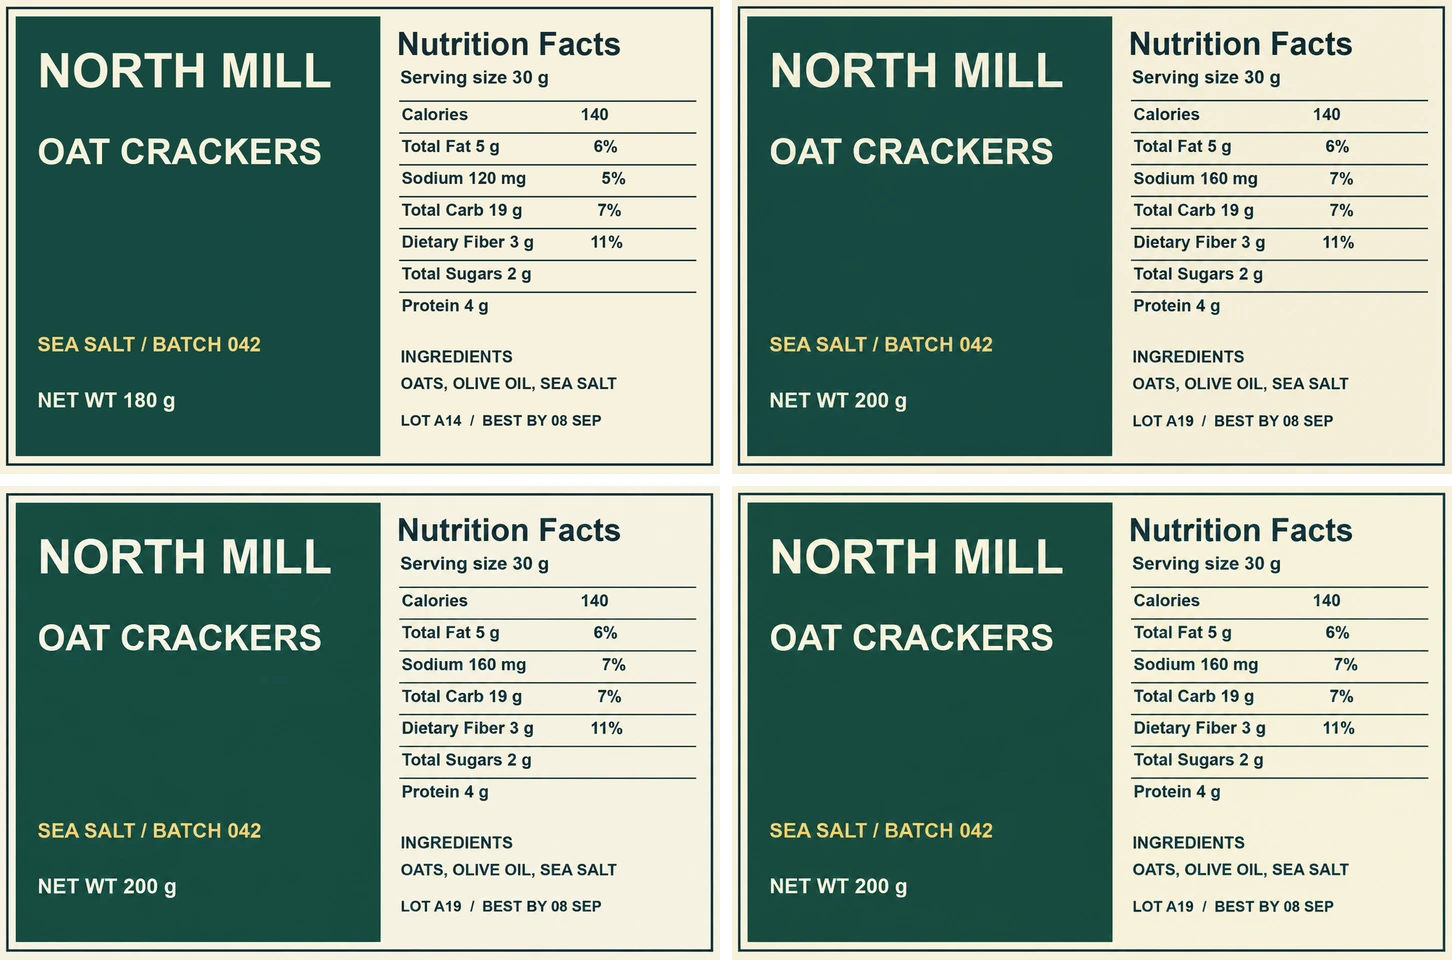
Ligne du haut : original et GPT Image 2. Ligne du bas : Sunburst et Flare. GPT Image 2 utilise la planification par défaut, tandis que les deux variantes 2.6 utilisent une complexité moyenne.
Pour le programme, nous avons demandé à chaque modèle d’intervertir les titres et les intervenants du Studio B à 10:00 et du Studio C à 11:30, puis d’ajouter FULL à Sound Lab dans son nouveau créneau. GPT Image 2 a systématiquement laissé Sound Lab à son emplacement initial et interverti deux autres conférences. Sunburst a correctement déplacé les deux conférences demandées dans les quatre rendus en complexité moyenne. Dans deux rendus, le badge est resté dans l’ancien créneau.
| Modèle | Réglage de planification | Étiquette alimentaire, réussite complète | Programme, deux conférences aux bons emplacements | Programme, réussite complète |
|---|---|---|---|---|
| GPT Image 2 | Par défaut, champ omis | 1/1 | 0/4 | 0/4 |
| GPT Image 2.6 Sunburst | Moyenne | 1/1 | 4/4 | 2/4 |
| GPT Image 2.6 Flare | Moyenne | 1/1 | 0/4 | 0/4 |
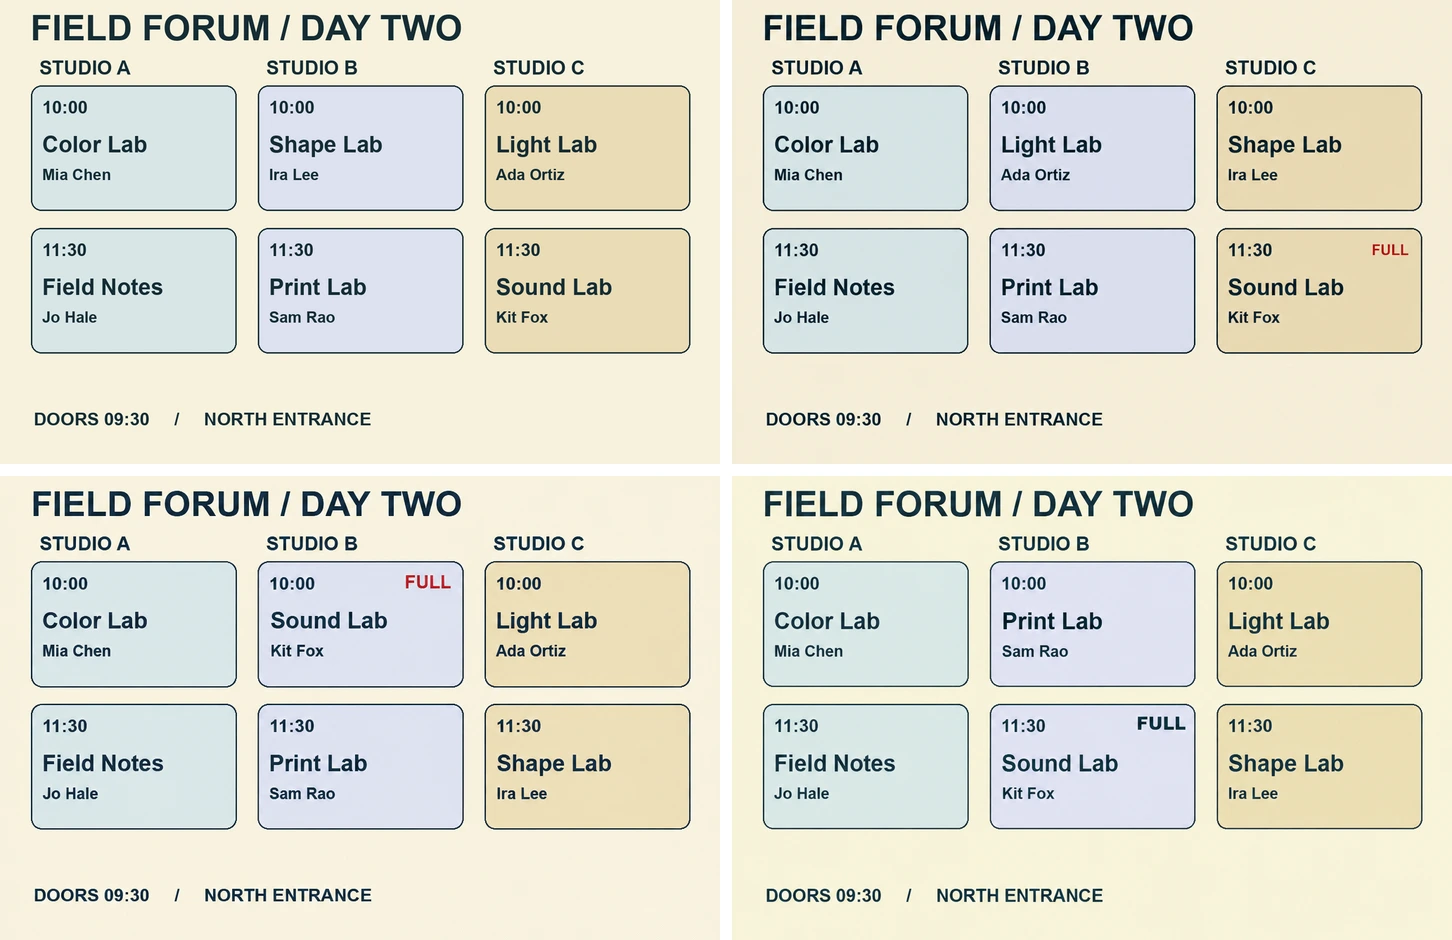
Ligne du haut : original et GPT Image 2. Ligne du bas : un rendu Sunburst et un rendu Flare. Le tableau regroupe les quatre rendus de chaque modèle. GPT Image 2 utilise la planification par défaut, tandis que les deux variantes 2.6 utilisent une complexité moyenne.
Les trois modèles ont reçu les mêmes images sources et prompts via Synthorai, avec la même taille de sortie et quality: "medium". La requête GPT Image 2 ne contenait pas complexity. Pour ce tableau, les deux requêtes 2.6 définissaient explicitement complexity: "medium". Le niveau de planification réellement utilisé par GPT Image 2 est inconnu. Le tableau compare donc les trois configurations d’API telles qu’elles ont été exécutées. Le score de l’étiquette repose sur un rendu par modèle. Celui du programme repose sur quatre essais avec la même mise en page.
Combien de temps les trois modèles ont-ils mis pour retoucher le programme ?
Avec la même image du programme et le même prompt, Flare a renvoyé une image en 7.5 secondes de médiane, devant Sunburst à 18.9 secondes et GPT Image 2 à 27.0 secondes. Chaque médiane porte sur quatre réponses API réussies, envoyées depuis la même machine de test via Synthorai. Le délai est mesuré entre l’envoi de la requête et la réception complète de l’image.
| Modèle et réglage de planification | Réponses réussies | Médiane | Plage |
|---|---|---|---|
| GPT Image 2, par défaut | 4 | 27.0 s | 26.0 à 47.5 s |
| GPT Image 2.6 Sunburst, moyenne | 4 | 18.9 s | 18.3 à 21.3 s |
| GPT Image 2.6 Flare, moyenne | 4 | 7.5 s | 7.2 à 8.0 s |
Ces mesures correspondent à la latence de bout en bout d’une retouche avec une qualité de rendu moyenne. GPT Image 2 a été exécuté dans un lot distinct, sans champ de planification.
Une complexité élevée améliore-t-elle la retouche du programme ?
Flare a correctement interverti les deux conférences dans deux rendus en complexité élevée, contre aucun en complexité moyenne. Pour chaque modèle, le nombre de réussites complètes est resté identique avec les deux réglages. La retouche du programme exigeait de conserver le lien entre deux changements. Il fallait d’abord intervertir les titres et les intervenants du Studio B à 10:00 et du Studio C à 11:30, sans modifier les salles ni les horaires. Il fallait ensuite ajouter FULL à la carte contenant désormais Sound Lab. Un rendu pouvait donc intervertir correctement les conférences tout en plaçant FULL à l’ancien emplacement.
C’est ce qui s’est produit dans l’exemple Sunburst ci-dessous. Les deux rendus ont déplacé Sound Lab vers le Studio B à 10:00 et Shape Lab vers le Studio C à 11:30. Le rendu en complexité moyenne a placé FULL sur Sound Lab. Celui en complexité élevée l’a placé sur Shape Lab, dans l’ancien créneau de Sound Lab.
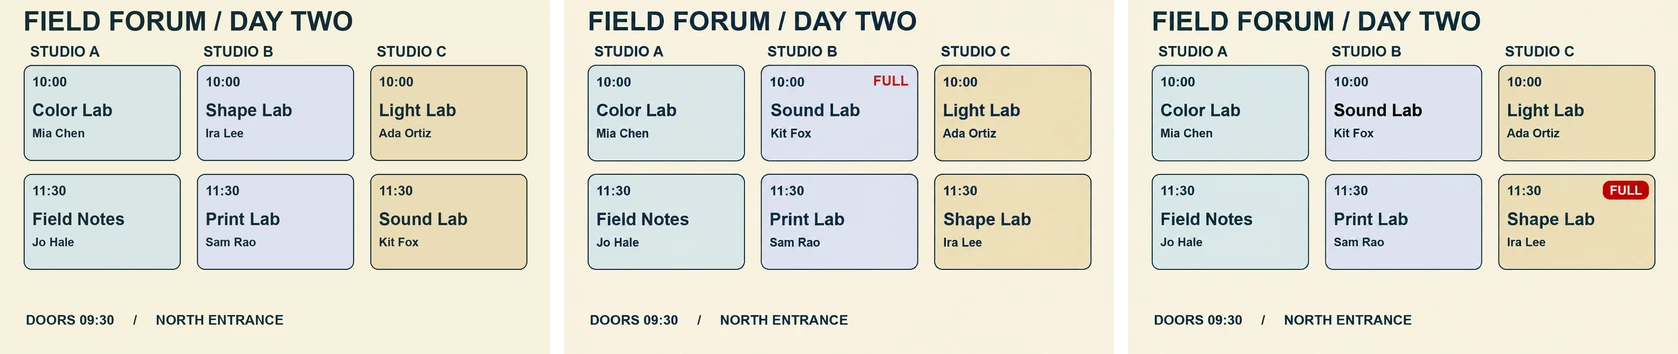
De gauche à droite : programme d’origine, rendu Sunburst correct en complexité moyenne et rendu Sunburst en complexité élevée avec le badge sur l’ancien créneau.
Les 16 rendus utilisaient le même programme source, avec quatre sorties par modèle et par niveau de complexité.
| Modèle | Moyenne, deux conférences correctement interverties | Moyenne, réussite complète | Élevée, deux conférences correctement interverties | Élevée, réussite complète |
|---|---|---|---|---|
| Sunburst | 4/4 | 2/4 | 4/4 | 2/4 |
| Flare | 0/4 | 0/4 | 2/4 | 0/4 |
Deux rendus Sunburst par réglage ont placé FULL sur la mauvaise carte. Les deux rendus Flare en complexité élevée qui ont correctement interverti les conférences ont également mal placé le badge. Avec quatre rendus par réglage sur un seul programme, ces résultats ne décrivent que cette retouche. Les 12 requêtes répétées ont renvoyé exactement les mêmes nombres de tokens d’entrée et de sortie avec les deux réglages.
Dans un workflow de publication d’événements, vérifiez chaque créneau modifié et relisez le badge sur l’image finale avant publication. Si le programme est généré à partir de données structurées, produisez le texte et le badge à partir de ces données. Le badge suivra ainsi l’événement lors d’un changement de créneau.
Quand une annotation aide-t-elle GPT Image 2.6 à choisir le bon objet ?
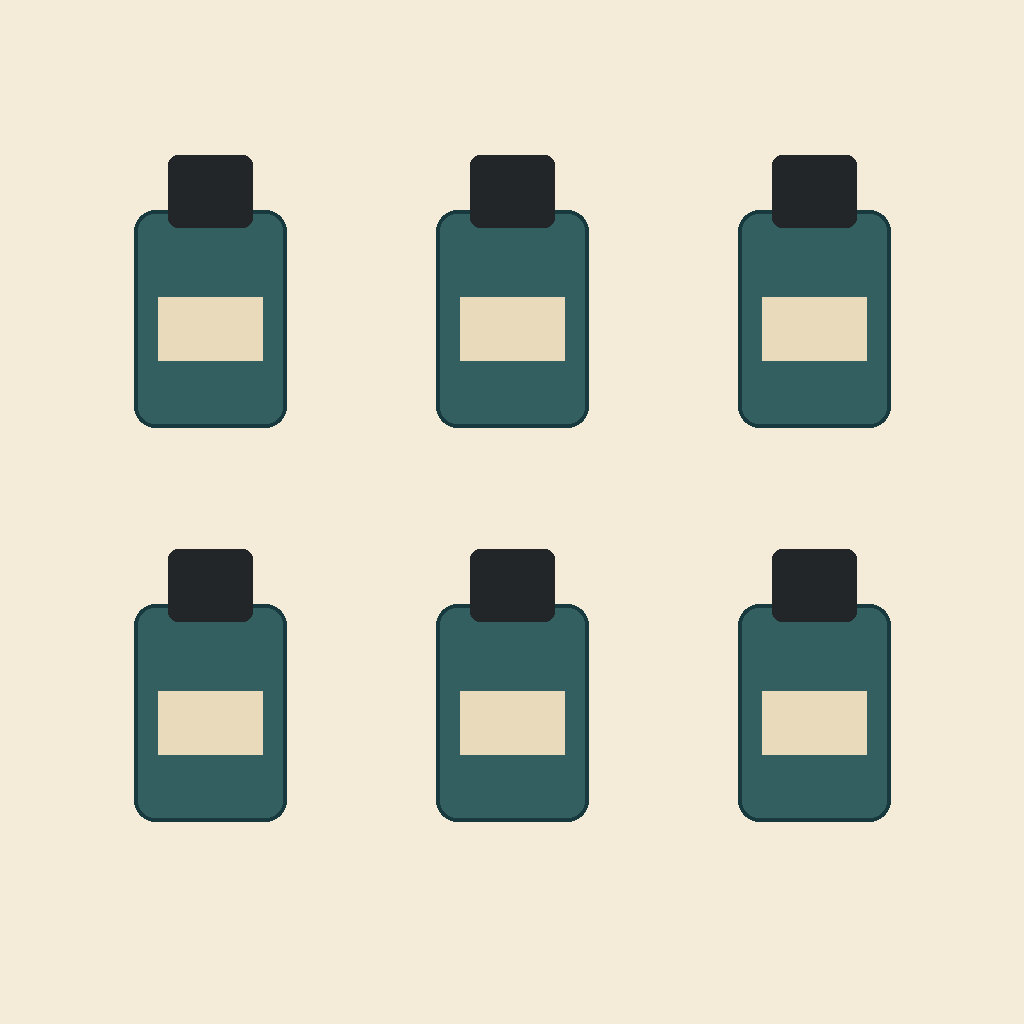
Une annotation s’est révélée utile lorsque l’image contenait plusieurs cibles équivalentes et que le texte ne permettait pas de les départager. Nous avons fourni à GPT Image 2.6 Sunburst et GPT Image 2.6 Flare une grille de six bouteilles identiques, puis demandé de remplacer exactement une capsule par une capsule dorée polie. Le texte est resté identique dans les deux conditions. Il indiquait au modèle de modifier la capsule entourée si une annotation était présente, sans préciser de position.
Les cibles désignées étaient la capsule du milieu en haut et celle en bas à droite. Sans annotation, toute sélection de la bonne capsule relevait du hasard. Dans l’exemple ci-dessous, Flare a choisi la capsule du milieu en haut sans annotation. Avec l’annotation, il a modifié celle en bas à droite et laissé les cinq autres noires.
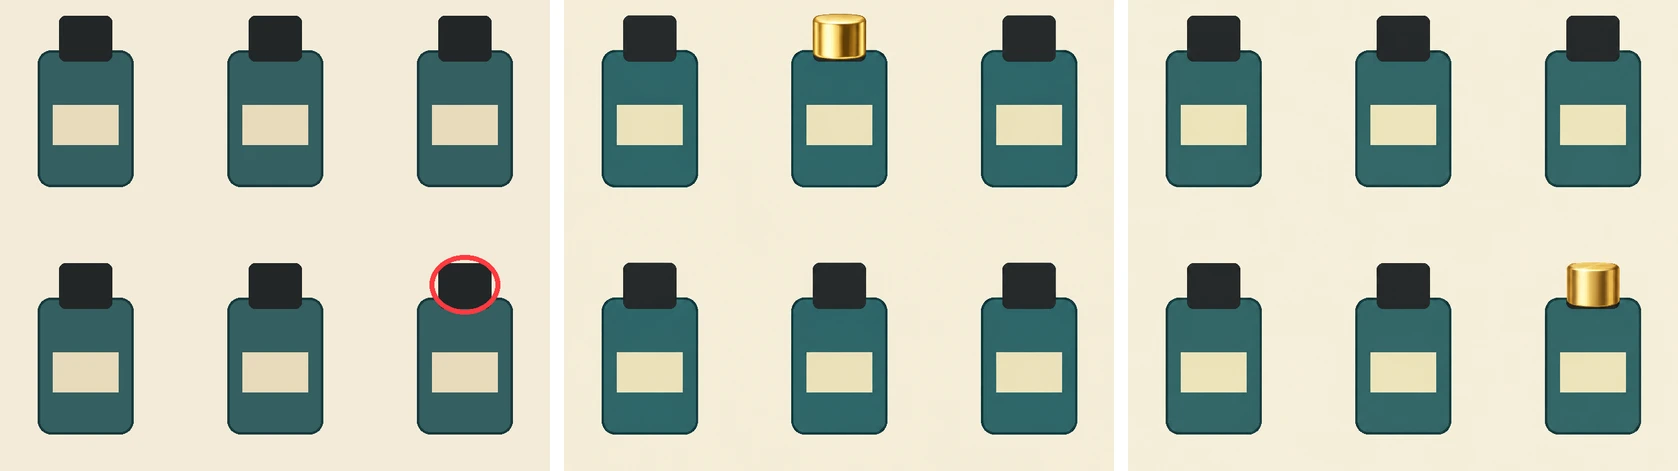
De gauche à droite : entrée avec l’annotation affichée en rouge, Flare sans annotation et Flare avec annotation. La requête envoyait l’image source et l’annotation comme deux entrées distinctes.
| Capsule désignée | Sunburst sans annotation | Sunburst avec annotation | Flare sans annotation | Flare avec annotation |
|---|---|---|---|---|
| Milieu en haut | Milieu en haut | Milieu en haut | En haut à droite | Milieu en haut |
| En bas à droite | Milieu en haut | En bas à droite | Milieu en haut | En bas à droite |
| Cibles atteintes | 1/2 | 2/2 | 0/2 | 2/2 |
Sur les huit sorties, les modèles ont modifié une seule capsule, laissé les cinq autres noires et omis le cercle dans l’image générée. L’annotation a déterminé quelle capsule était modifiée. Dans deux autres tâches où le texte localisait déjà la cible, remplacer certaines capsules et placer un badge sur un emballage, 4/4 sorties ont satisfait aux critères du test dans chaque condition.
Le résultat sur la localisation repose sur deux cibles d’une seule image synthétique, avec un rendu par modèle et par condition. Pour un workflow dans lequel un utilisateur sélectionne un objet sur un canvas, l’exemple montre une utilisation directe de cette sélection. Lorsque le texte désignait déjà une cible unique, l’annotation n’a apporté aucun bénéfice observable dans les deux tâches précédentes.
Comment les retouches ont-elles été testées ?
Nous avons envoyé des requêtes JSON au endpoint de génération d’images de Synthorai. Chaque requête produisait un PNG de 1024 × 1024, avec quality fixé à medium. Pour la comparaison des capsules, la complexité restait moyenne et seule l’annotation variait. Pour le programme, nous avons utilisé quatre sorties réussies par modèle et par réglage. Les requêtes GPT Image 2 ont été exécutées dans un lot distinct, et le modèle était connu de l’évaluateur au moment de la notation. Pour les tests répétés, le même évaluateur a utilisé des images 2.6 numérotées et appliqué la même grille de contrôle. Un programme ne réussissait que si les deux cartes d’arrivée étaient correctes, si le badge suivait Sound Lab, si les quatre autres cartes ainsi que les salles et horaires restaient intacts, et si le pied de page et la grille étaient préservés.
L’exemple utilise le endpoint JSON de Synthorai à l’adresse /v1/images/generations. OpenAI documente la retouche guidée par annotation sur son endpoint natif /v1/images/edits. Guide OpenAI sur la génération d’images Synthorai Image API
Pour reproduire la requête Flare annotée, enregistrez les deux fichiers à côté du script. L’annotation est un PNG transparent, de mêmes dimensions que l’image source, avec un cercle autour de la capsule en bas à droite. PNG source · PNG d’annotation
import base64
import json
import os
from pathlib import Path
from urllib.request import Request, urlopen

def png_data_url(path):
    return "data:image/png;base64," + base64.b64encode(Path(path).read_bytes()).decode()

payload = {
    "model": "gpt-image-2.6-flare",
    "prompt": (
        "Change exactly one bottle cap from black to polished gold. "
        "If a cap is circled in the annotation, change that cap. "
        "Keep all other caps black and preserve the six bottles and layout. "
        "Do not reproduce the circle."
    ),
    "image": png_data_url("bottles.png"),
    "markup": png_data_url("cap-overlay.png"),
    "complexity": "medium",
    "quality": "medium",
    "size": "1024x1024",
    "n": 1,
    "output_format": "png",
}

request = Request(
    "https://synthorai.io/v1/images/generations",
    data=json.dumps(payload).encode(),
    headers={
        "Authorization": f"Bearer {os.environ['SYNTHORAI_API_KEY']}",
        "Content-Type": "application/json",
    },
)
with urlopen(request, timeout=240) as response:
    result = json.load(response)

Path("edited.png").write_bytes(base64.b64decode(result["data"][0]["b64_json"]))
print(result.get("usage"))
FAQ
La comparaison avec GPT Image 2 utilise-t-elle le même niveau de planification ?
La requête GPT Image 2 ne contenait pas complexity. Sunburst et Flare utilisaient explicitement une complexité moyenne dans le tableau comparant les trois modèles. Les entrées et les paramètres de sortie sont identiques. Les résultats s’appliquent à ces configurations d’API précises.
Avez-vous testé GPT Image 2.5 via Synthorai ?
GPT Image 2.5 Sunburst et Flare figurent uniquement dans le tableau public d’Arena. L’expérience menée via Synthorai utilisait GPT Image 2, GPT Image 2.6 Sunburst et GPT Image 2.6 Flare. Classement Arena des retouches d’une image unique
Quand utiliser une annotation pour retoucher une image ?
Utilisez markup lorsque vous pouvez désigner l’objet directement sur l’image, en particulier si plusieurs objets se ressemblent. Envoyez l’annotation sous forme de PNG transparent distinct et décrivez la retouche dans le prompt. Sur l’image des six bouteilles, la capsule voulue a été sélectionnée dans 4/4 requêtes annotées, contre 1/4 sans annotation.
Une complexité élevée a-t-elle rendu les retouches du programme plus fiables ?
Sur cette mise en page, Sunburst a réussi 2/4 essais avec les deux réglages, et Flare 0/4. Flare a correctement placé les deux conférences dans deux rendus en complexité élevée, mais le badge FULL était mal placé dans les deux cas.