
Gemini 3.1 Flash Image vs Gemini Nano Banana 2.1
Lequel choisir, et quand
gemini-nano-banana-2.1 est la mise à jour par Google de gemini-3.1-flash-image, et les deux tarifs principaux évoluent en sens inverse : la sortie image passe de $60 à $30 par million de tokens, tandis que l'entrée monte de $0.5 à $1.5. La sortie domine la facture dans la plupart des usages image, le modèle le plus récent est donc généralement le moins cher ; le tarif d'entrée plus élevé ne compte que lorsqu'une requête embarque beaucoup d'entrée, de la vidéo par exemple. Les deux acceptent du texte, des images et de la vidéo en entrée, renvoient image et texte, et prennent jusqu'à 14 images de référence. gemini-nano-banana-2.1 ajoute des formats d'image très larges et très hauts (quinze contre dix) et propose trois niveaux de réflexion ; gemini-3.1-flash-image conserve une taille de sortie 0.5K que le nouveau modèle ne propose pas.
Tarifs
| Gemini 3.1 Flash Image | Gemini Nano Banana 2.1 | Δ | |
|---|---|---|---|
| Entrée / 1M de tokens | $0.5 | $1.5 | 0.33× |
| Sortie / 1M de tokens | $60 | $30 | 2× |
Tarifs relevés dans le catalogue en direct à la génération du site ; la page de chaque modèle affiche la grille tarifaire à jour.
Leur position : prix en sortie pour 1M de tokens, parmi les 11 modèles de génération d'images facturés dans cette unité (échelle logarithmique)
Spécifications
| Gemini 3.1 Flash Image | Gemini Nano Banana 2.1 | |
|---|---|---|
| Modalités d'entrée | texte image vidéo | texte image vidéo |
| Modalités de sortie | texte image | texte image |
| Date de sortie | 2026-05-28 | 2026-10-06 |
| Tailles de sortie |
|
|
| Modes d'entrée | text-to-image, single-turn and multi-turn editing, up to 14 reference images | text-to-image, single-turn and multi-turn editing, up to 14 reference images |
| Formats | jpeg, png | - |
| Notes | 0.5K, 1K, 2K and 4K output at ten aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9), JPEG or PNG up to 14 reference images per request, up to ten of them objects rendered with high fidelity plus character and style references single-turn editing and multi-turn conversational iteration | 1K, 2K and 4K output at fifteen aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9, 9:21, 1:4, 4:1, 1:8, 8:1) up to 14 reference images per request single-turn editing and multi-turn conversational iteration |
Les spécifications sont reprises de la documentation de chaque fournisseur ; quand un fournisseur ne publie pas une valeur, la ligne est omise et non déduite. Sources complètes : Gemini 3.1 Flash Image · Gemini Nano Banana 2.1
Un prompt, deux modèles, mesurés via la passerelle
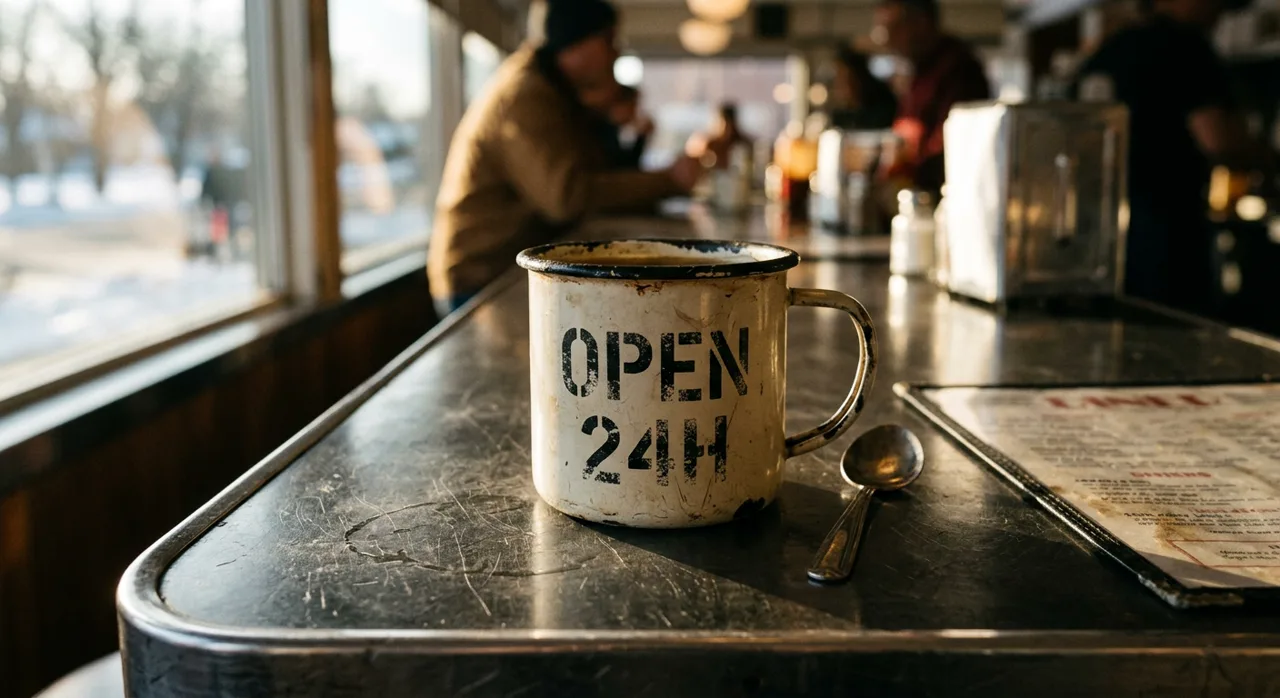
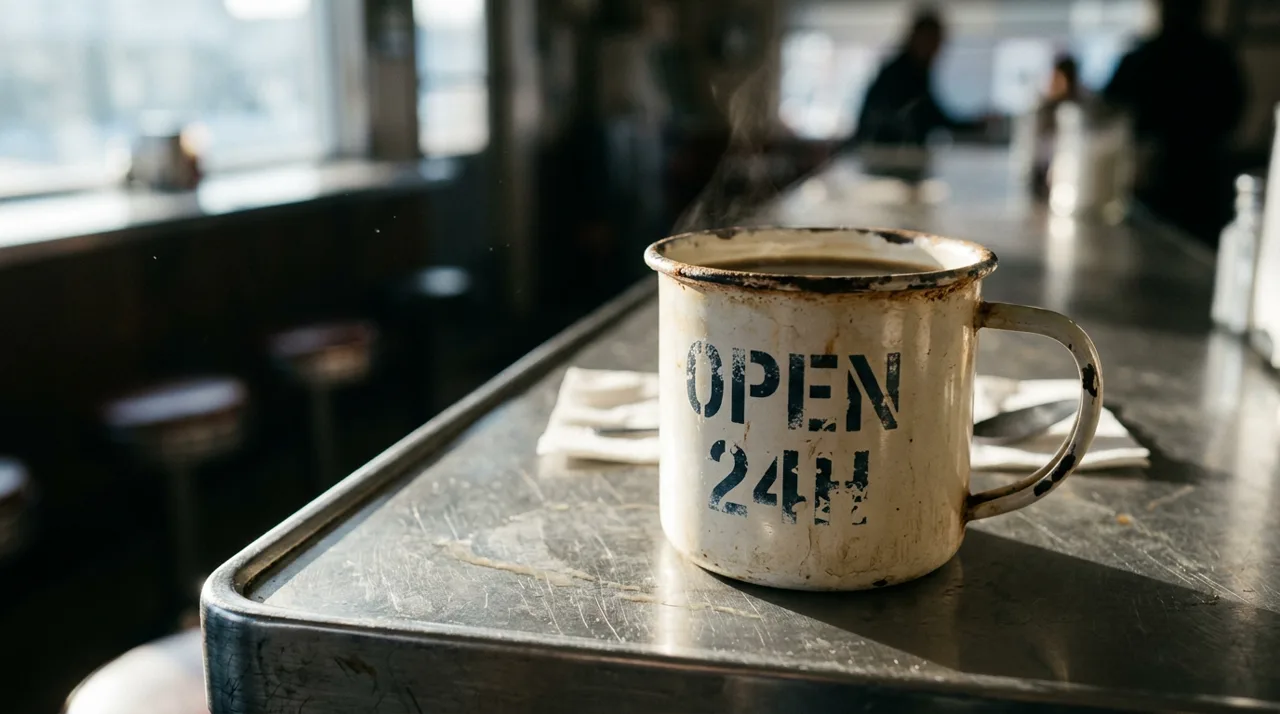
Un prompt, une requête par modèle, sans nouvel essai ni tri des résultats : c'est le premier résultat renvoyé par chaque modèle. Ni la taille ni la durée n'ont été imposées. Chaque modèle a utilisé sa valeur par défaut, car une requête calibrée pour convenir à tous n'en mettrait aucun en valeur. Les fichiers sont réencodés pour le web : jugez la composition et le respect du prompt, pas la compression.
Passez de l'un à l'autre en changeant une seule ligne
Les deux identifiants figurent dans chaque onglet ci-dessous : les deux lignes surlignées sont le seul changement. Même endpoint, même clé, même format de requête.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-image",
    # model="gemini-nano-banana-2.1",  # décommentez cette ligne, commentez celle du dessus
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-image",
// model: "gemini-nano-banana-2.1", // décommentez cette ligne, commentez celle du dessus
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-image",
# "model": "gemini-nano-banana-2.1", # décommentez cette ligne, commentez celle du dessus
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-image",
// Model: "gemini-nano-banana-2.1", // décommentez cette ligne, commentez celle du dessus
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-image")
// .model("gemini-nano-banana-2.1") // décommentez cette ligne, commentez celle du dessus
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Lequel est le moins cher, Gemini 3.1 Flash Image ou Gemini Nano Banana 2.1 ?
Gemini 3.1 Flash Image est moins cher sur la ligne « Entrée / 1M de tokens » ($0.5 contre $1.5, soit un écart de 3.0×). D'autres lignes peuvent dire l'inverse : le tableau ci-dessus donne la grille tarifaire complète, et le coût réel dépend de la composition de votre trafic.
Puis-je faire un test A/B entre Gemini 3.1 Flash Image et Gemini Nano Banana 2.1 sans deux intégrations ?
Oui. Les deux passent par le même endpoint compatible OpenAI, avec une seule clé API. Pour passer de l'un à l'autre, il suffit de changer l'identifiant du modèle, soit une ligne : vous pouvez donc envoyer une part du trafic à chacun et comparer directement les factures.
Le prix change-t-il avec la taille de l'image ?
Cela dépend du mode de facturation du modèle. Un modèle facturé à l'image coûte le même prix quelle que soit la taille du prompt ou de la sortie. Un modèle facturé au token coûte plus cher à mesure que la résolution générée augmente : une image 4K revient à plusieurs fois le prix d'une petite. Le tableau ci-dessus indique le cas de chacun.