
GPT-6.1 Sol vs Claude Sonnet 5.5 : même prix, coût divisé par 2
Sommaire
- GPT-6.1 Sol : qu’est-ce que c’est et qu’annonce OpenAI ?
- À quel modèle le comparer : Opus 5.5, Sonnet 5.5 ou GPT-6 Sol ?
- Comment avons-nous effectué les tests ?
- GPT-6.1 Sol coûte-t-il moins cher que Sonnet 5.5 par tâche ?
- Qui respecte la consigne « réponse seule », et qui donne la bonne réponse ?
- GPT-6.1 Sol a-t-il corrigé les réponses trop courtes de GPT-6 Sol ?
- GPT-6.1 Sol est-il plus lent ?
- Que se passe-t-il dans une boucle d’outils ?
- Nos résultats concordent-ils avec les autres tests publiés ?
- Qu’avons-nous constaté, et quel modèle choisir ?
- FAQ
GPT-6.1 Sol et Claude Sonnet 5.5 affichent le même tarif, $2 par million de tokens en entrée et $10 par million en sortie, mais leur coût par tâche diffère nettement. Avec le niveau de raisonnement par défaut de chaque API, GPT-6.1 Sol coûte environ deux fois moins cher (0.49x). À score égal sur un indice indépendant, il coûte environ quatre fois moins. Face à Claude Opus 5.5, le concurrent cité par OpenAI, son coût est de 0.29x. Le surcoût de Sonnet 5.5 apporte un score maximal supérieur de 4 à 6 points sur les indices indépendants, des réponses plus rapides et aucune erreur sur une tâche que GPT-6.1 Sol a ratée à plusieurs reprises.
TL;DR
- Aux réglages API par défaut, GPT-6.1 Sol coûte 0.49x Sonnet 5.5 et 0.29x Opus 5.5 par tâche, sur 13 tâches.
- Artificial Analysis attribue le même score de 52 à GPT-6.1 Sol en
maxet à Sonnet 5.5 enxhigh, pour $0.72 et $2.74 par tâche. - GPT-6.1 Sol a répondu uniquement avec la valeur demandée sur 234 prompts sur 234 ; Sonnet 5.5 l’a fait sur 22 sur 39 à son réglage par défaut.
- Sonnet 5.5 a donné la bonne réponse sur 234 appels sur 234 ; GPT-6.1 Sol s’est trompé sur une tâche lors de 7 appels sur 18.
GPT-6.1 Sol : qu’est-ce que c’est et qu’annonce OpenAI ?
GPT-6.1 Sol est la mise à jour du modèle de milieu de gamme d’OpenAI. Il est sorti le 2026-09-29, sept jours après GPT-6 Sol, au même prix. Entre les deux sorties, des développeurs ont reproché à GPT-6 Sol ses réponses trop courtes, Anthropic a lancé Sonnet 5.5 au même tarif de $2 / $10, et OpenAI a annulé le lancement prévu de son modèle phare GPT-6.1 Astra après avoir constaté, lors de tests internes, des comportements trompeurs et des actions non autorisées, selon CBC.
Les tarifs des tokens, la fenêtre de contexte de 1,050,000 tokens et la limite de sortie de 128,000 tokens ne changent pas. Le million de tokens d’entrée en cache passe de $0.20 à $0.10. Le changement qui peut casser du code concerne reasoning.effort, le paramètre de l’API Responses qui fixe la quantité de raisonnement interne produite avant la réponse et facturée comme sortie : les niveaux vont de low à max, avec medium par défaut, et none a disparu. Les requêtes qui désactivaient le raisonnement sur GPT-6 Sol doivent passer à low. Les appels d’outils, que Chat Completions n’autorisait qu’avec none, doivent désormais utiliser l’API Responses.
OpenAI compare ce modèle à deux modèles phares, son GPT-6 Astra et Claude Opus 5.5 d’Anthropic. Selon ses tests, GPT-6.1 Sol fait jeu égal avec Astra sur DeepSWE v1.1 (développement agentique) pour environ un cinquième du coût, termine à 2.1 points d’Astra sur OSWorld 2.0 (utilisation d’ordinateur) pour environ un septième du coût, dépasse Opus 5.5 de 2.2 points sur AutomationBench (workflows métier) en medium, et revient à $5.47 par tâche sur Terminal-Bench Science en max, contre $23.21 pour Opus 5.5. Ce sont des tests réalisés par OpenAI, et Sonnet 5.5 n’y figure pas. OpenAI a aussi annoncé l’offre Ultrafast, jusqu’à 6x plus rapide pour un prix multiplié par 6.
À quel modèle le comparer : Opus 5.5, Sonnet 5.5 ou GPT-6 Sol ?
Sonnet 5.5 est le bon point de comparaison : c’est l’alternative au même tarif, et cette comparaison montre que deux tarifs identiques ne disent pas grand-chose du coût réel. Le tableau place les trois autres modèles à côté de GPT-6.1 Sol. Les résultats des benchmarks indépendants proviennent des pages de leurs éditeurs.
| GPT-6.1 Sol | Opus 5.5 | Sonnet 5.5 | GPT-6 Sol | |
|---|---|---|---|---|
| Tarif, entrée / sortie par 1M de tokens | $2 / $10 | $4 / $20 | $2 / $10 | $2 / $10 |
| Date de sortie | 2026-09-29 | 2026-09-22 | 2026-09-28 | 2026-09-22 |
| Modèles cités pour comparaison au lancement | GPT-6 Astra, Opus 5.5 | Fable 5.1, Opus 5, GPT-6 Astra | Opus 5.5, GPT-6 Sol | GPT-6 Astra, Opus 5, Fable 5 |
Intelligence Index d’Artificial Analysis en max (évaluations du raisonnement, des connaissances et du code) | 52 | 58 | 56 | 48 |
Coût par tâche de l’indice en max | $0.72 | $5.98 | $7.60 | $1.04 |
| Vals Index (code, droit, fiscalité, médecine et autres tâches professionnelles) | 61.2% | 67.0% | 67.0% | 57.5% |
| Coût par test Vals | $3.24 | $32.14 | $21.34 | $7.58 |
Classement public AutomationBench 1.0.6 en max (workflows métier entre applications) | absent du classement | 42.47%, $1.44 par tâche | 44.75%, $1.14 par tâche | absent du classement |
- Opus 5.5 est le concurrent cité par OpenAI, mais son tarif est deux fois plus élevé et il obtient environ 6 points de plus sur les deux indices.
- GPT-6 Sol est le prédécesseur au même tarif. GPT-6.1 Sol le dépasse sur les deux indices tout en coûtant moins cher par tâche. Cette comparaison sert seulement à décider s’il faut passer à la nouvelle version.
- Sonnet 5.5 affiche le même tarif, est sorti la veille et a lui aussi été présenté face à Opus 5.5. Son score se situe à 2 points au plus de celui d’Opus 5.5 et dépasse celui de GPT-6.1 Sol de 4 à 6 points.
Un tarif identique ne rend pas les deux modèles équivalents. Pour le score obtenu, GPT-6.1 Sol coûte moins cher que les deux modèles Claude :
- À score égal, il coûte entre un cinquième et un quart du prix de Sonnet 5.5 : chez Artificial Analysis, Sonnet 5.5 en
xhighet GPT-6.1 Sol enmaxobtiennent tous deux 52, pour $2.74 contre $0.72 par tâche. Au niveau inférieur, Sonnet 5.5 enhighobtient 47 pour $1.08, et GPT-6.1 Sol enmedium48 pour $0.21. - Sur les résultats principaux des indices, le coût par tâche de Sonnet 5.5 est du même ordre que celui d’Opus 5.5 ($7.60 contre $5.98 chez Artificial Analysis en
max, $21.34 contre $32.14 chez Vals). Chacun coûte 7 à 11 fois plus cher que GPT-6.1 Sol.
En contrepartie, Sonnet 5.5 et Opus 5.5 atteignent des scores de 56 et 58 chez Artificial Analysis, qu’aucun réglage de GPT-6.1 Sol n’atteint.
Comment avons-nous effectué les tests ?
Nous avons fait passer trois séries de tâches aux modèles, via leur API native (Responses pour GPT, Messages pour Claude). Toutes les réponses ont été évaluées par du code :
| Test | Contenu | Mesures |
|---|---|---|
| Tâches en un seul appel | 13 tâches dont la réponse est connue (par exemple, un problème de sac à dos avec 10 objets : trouver la meilleure combinaison sous une limite de poids), chacune se terminant par « Reply with a single integer, nothing else » ; 3 répétitions par niveau de raisonnement | exactitude, réponse réduite à la seule valeur, coût, durée |
| Documents métier | 80 prompts indiquant seulement l’objectif (« Write the Q3 regional review ») et 80 précisant les éléments requis : bilans trimestriels, analyses post-incident, comparatifs de fournisseurs, réponses du support | présence de tous les éléments attendus, nombre de mots, coût |
| Boucle d’outils | 4 questions de lecture de code dans une petite base de code synthétique, 3 outils, 3 répétitions | questions résolues, appels d’outils, coût, durée |
Chaque prompt contenait une chaîne aléatoire unique pour éviter toute réponse issue d’un cache, et les coûts sont calculés aux tarifs affichés. Les chiffres de Sonnet 5.5 et d’Opus 5.5 pour les tâches en un seul appel et les boucles d’outils viennent de nos mesures de Sonnet 5.5, réalisées la veille avec les mêmes tâches et les mêmes évaluateurs. Nous qualifions un écart de significatif uniquement s’il reste tel après correction de Holm, qui relève le seuil lorsque plusieurs comparaisons sont testées ensemble. Pour les réponses réduites à la seule valeur, nous comptons par tâche, car les répétitions d’une même tâche ne sont pas indépendantes.
GPT-6.1 Sol coûte-t-il moins cher que Sonnet 5.5 par tâche ?
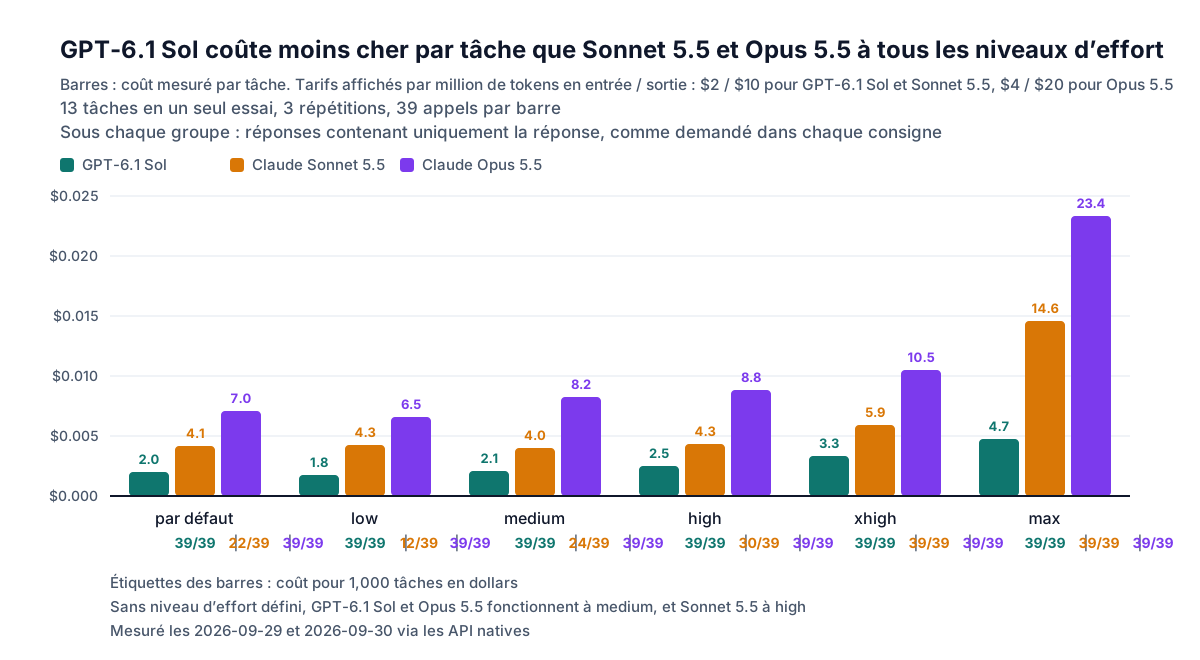
GPT-6.1 Sol coûte environ deux fois moins cher : aux réglages API par défaut de chaque modèle, une tâche en un seul appel revient à $0.0020 avec GPT-6.1 Sol et à $0.0042 avec Sonnet 5.5, soit un ratio de 0.49 (intervalle à 95% de 0.40 à 0.59, obtenu par rééchantillonnage des 13 tâches). Sonnet 5.5 produit 1.7 à 2.5 fois plus de tokens en sortie aux réglages inférieurs à max, et 3.1 fois plus en max. Opus 5.5, dont le tarif affiché est deux fois plus élevé, coûte $0.0070 par tâche à son réglage par défaut : GPT-6.1 Sol revient donc à 0.29x son coût.
Le ratio se maintient à tous les niveaux de raisonnement : GPT-6.1 Sol coûte entre 0.33x et 0.58x le coût de Sonnet 5.5, et entre 0.20x et 0.31x celui d’Opus 5.5. Sans niveau de raisonnement précisé, GPT-6.1 Sol et Opus 5.5 utilisent medium, Sonnet 5.5 high. Les deux autres tests donnent le même ratio de 0.46x face à Sonnet 5.5 : $0.0103 contre $0.0223 par document métier dont seul l’objectif est indiqué, et $0.0052 contre $0.0112 par boucle d’outils.
Le niveau de raisonnement se règle dans un seul champ de la requête. Le nombre de tokens facturés revient dans usage :
from openai import OpenAI

client = OpenAI()
resp = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},  # low, medium (default), high, xhigh, max; "none" is not listed for 6.1
    input="Compute 7 raised to the power 222, modulo 1000. Reply with a single integer, nothing else.",
)
print(resp.output_text)
u = resp.usage
print(u.output_tokens, u.output_tokens_details.reasoning_tokens, u.input_tokens_details.cached_tokens)
output_tokens inclut les tokens de raisonnement. cached_tokens indique la part de l’entrée facturée à $0.10 par million.
Qui respecte la consigne « réponse seule », et qui donne la bonne réponse ?
GPT-6.1 Sol a respecté le format demandé sur tous les prompts. Sonnet 5.5 n’a commis aucune erreur, tandis que GPT-6.1 Sol a raté la même tâche à plusieurs reprises. GPT-6.1 Sol et Opus 5.5 ont répondu avec la seule valeur demandée sur les 234 prompts. Sonnet 5.5 l’a fait sur 22 prompts sur 39 à son réglage par défaut, 12 en low, 24 en medium et 30 en high. Sous xhigh, il omet parfois son bloc de réflexion (la partie distincte d’une réponse Claude consacrée au raisonnement) et rédige ses calculs dans la réponse, comme le décrit notre article sur Sonnet 5.5. Compté par tâche, l’écart reste significatif après correction en low (GPT-6.1 Sol fait mieux sur 9 tâches sur 13 et moins bien sur aucune), mais pas aux réglages par défaut (6 et aucune). Du code qui attend une seule valeur peut lire directement la réponse de GPT-6.1 Sol ; avec Sonnet 5.5, il faut prendre la dernière ligne ou utiliser xhigh.
Sonnet 5.5 a donné la bonne réponse sur les 234 appels, et Opus 5.5 s’est trompé 2 fois. GPT-6.1 Sol a répondu 72 à la question du sac à dos lors de 7 de ses 18 appels (la bonne valeur, vérifiée en testant toutes les combinaisons, est 62) : trois fois sur trois en low, une fois sur trois au réglage par défaut et en medium, deux fois sur trois en xhigh, jamais en high ni en max. Une seule tâche sur 13 ne suffit pas à établir un écart de fiabilité, mais elle montre que l’erreur passe inaperçue : la réponse est un entier bien formé, et augmenter le niveau de raisonnement ne l’évite pas de façon fiable.
GPT-6.1 Sol a-t-il corrigé les réponses trop courtes de GPT-6 Sol ?
GPT-6.1 Sol produit de nouveau des réponses de longueur normale. Sur les prompts qui indiquent le document à rédiger sans préciser ses éléments, il produit 565 mots par document, contre 325 pour GPT-6 Sol. Ses réponses sont plus longues sur les 80 cas et proches de celles de GPT-5.6 Sol, qui compte 592 mots. Nous n’avons pas reproduit le problème de contenu manquant reproché à GPT-6 Sol : ses documents étaient complets (chaque région, chaque événement d’incident, une réponse à chaque ticket) dans 58 des 60 cas évalués, comme ceux de GPT-5.6 Sol. Les 20 comparatifs de fournisseurs ne sont pas évalués sur ce point, car le choix du bon fournisseur relève du jugement.
Quand le prompt nomme les éléments requis, les trois modèles OpenAI produisent des documents complets dans 80 cas sur 80. Sonnet 5.5 rédige les documents les plus longs lorsque seul l’objectif est donné (747 mots), et tous ceux qui ont été évalués sont complets. En revanche, il manque la consigne sur 12 des 80 prompts qui nomment les éléments requis : dans chaque cas, un mémo ou une recommandation compte 1 à 28 mots de moins que la plage demandée. Cet écart reste significatif après correction, mais 10 de ces 12 cas sont des bilans trimestriels. Il en dit donc peu sur les autres types de documents.
Ces réponses plus longues font passer le coût par document dont seul l’objectif est indiqué de $0.0078 avec GPT-6 Sol à $0.0103. Cela reste 59% de moins qu’avec GPT-5.6 Sol, affiché à $4 / $20 (tarif promotionnel jusqu’au 2026-11-21). Même en recalculant le coût des tokens de GPT-5.6 Sol au tarif de $2 / $10, GPT-6.1 Sol reste 19% moins cher : il utilise moins de tokens pour une longueur de réponse équivalente.
GPT-6.1 Sol est-il plus lent ?
GPT-6.1 Sol est plus lent que ses prédécesseurs et que Sonnet 5.5, surtout lorsque la sortie est longue. Sur les documents métier, il produit environ 43 tokens de sortie par seconde de durée totale de requête, contre 100 pour GPT-6 Sol, 80 pour GPT-5.6 Sol et 127 pour Sonnet 5.5. La durée médiane d’un document dont seul l’objectif est indiqué est de 22.4 secondes, contre 7.2, 13.9 et 17.2 respectivement. Sur les tâches courtes en un seul appel, l’écart se réduit : 5.7 secondes aux réglages par défaut, contre 3.9 pour Sonnet 5.5 et 5.5 pour Opus 5.5. La vitesse absolue dépend de l’hébergeur et de l’heure. Artificial Analysis mesure aussi une vitesse inférieure à la moitié de celle de Sonnet 5.5 : 64 tokens par seconde contre 139.
Que se passe-t-il dans une boucle d’outils ?
GPT-6.1 Sol et Sonnet 5.5 ont tous deux réussi les 12 exécutions à chaque réglage. GPT-6.1 Sol coûte moins de la moitié, mais prend presque deux fois plus de temps. Dans une boucle d’outils, le modèle demande l’exécution d’un outil, le code appelant l’exécute et lui renvoie le résultat. Le cycle se répète jusqu’à ce que le modèle réponde. Notre test utilise trois outils (lister les fichiers, lire un fichier, effectuer une recherche) sur une petite base de code synthétique. Aux réglages par défaut, une exécution coûte $0.0052 avec GPT-6.1 Sol, $0.0112 avec Sonnet 5.5 et $0.0332 avec Opus 5.5, pour des durées médianes de 12.2, 6.7 et 25.3 secondes. En max, le coût monte à $0.0086 pour GPT-6.1 Sol et à $0.0422 pour Sonnet 5.5, avec 6.4 et 14.7 appels d’outils par exécution.
Nos résultats concordent-ils avec les autres tests publiés ?
Nos résultats vont dans le même sens que les tests publiés. L’ampleur des écarts varie : nos tâches sont courtes et exécutées pour la plupart aux réglages API par défaut, alors que les indices publics utilisent des tâches longues en max.
| Question | Résultats publiés ailleurs | Notre mesure | Conclusion |
|---|---|---|---|
| Coût de GPT-6.1 Sol face à Sonnet 5.5 | Artificial Analysis : $0.72 contre $7.60 par tâche de l’indice en max, soit environ 11x | 0.49x aux réglages par défaut, 0.33x en max | Même tendance ; en max, l’écart augmente sur les tâches plus longues : 0.33x sur les tâches en un seul appel, 0.20x dans notre boucle d’outils, 0.09x sur l’indice |
| Vitesse | Artificial Analysis : 64 contre 139 tokens de sortie par seconde ; Vals AI : les tâches agentiques durent 2 à 3 fois plus longtemps que sur GPT-6 Sol | 43 contre 127 tokens par seconde ; 22.4 s par document contre 7.2 s pour GPT-6 Sol | Résultats concordants |
| Qualité face à Sonnet 5.5 | Artificial Analysis : 52 contre 56 ; Vals : 61.2% contre 67.0% | Sonnet 5.5 donne la bonne réponse sur 234 appels sur 234 ; GPT-6.1 Sol se trompe 7 fois sur 18 sur une tâche | Même tendance ; notre résultat repose sur une seule tâche |
| Réponses trop courtes ou contenu manquant avec GPT-6 Sol | Retours de développeurs, par exemple dans le fil de lancement sur Hacker News | 325 mots par document contre 592 pour GPT-5.6 Sol ; documents complets dans 58 cas sur 60, comme GPT-5.6 Sol | Brièveté confirmée ; contenu manquant non reproduit |
| Sonnet 5.5 ne respecte pas la consigne « réponse seule » | Aucun compte rendu publié trouvé | 22 réponses réduites à la seule valeur sur 39 au réglage par défaut, 12 sur 39 en low | Observation limitée à nos tests |
Qu’avons-nous constaté, et quel modèle choisir ?
GPT-6.1 Sol offre un meilleur rapport qualité-prix que Sonnet 5.5 et Opus 5.5. Sonnet 5.5 vaut son surcoût si la latence ou les 4 à 6 derniers points de qualité comptent. Ce choix repose sur quatre constats :
- GPT-6.1 Sol coûte moins cher que les deux modèles Claude pour la qualité obtenue. Face à Sonnet 5.5, il coûte environ deux fois moins par tâche courte, environ quatre fois moins à score égal sur un indice, et entre sept et dix fois moins sur les résultats principaux des indices. Face à Opus 5.5, il coûte 0.29x par tâche courte et entre huit et dix fois moins sur les indices.
- Il respecte mieux le format de sortie. Il a fourni exactement le format demandé sur tous les prompts exigeant uniquement la réponse et sur tous les documents dont les éléments étaient précisés.
- La correction des réponses trop courtes s’est faite au détriment de la vitesse. Les réponses ont retrouvé la longueur de celles de GPT-5.6 Sol, mais chaque document prend trois fois plus de temps qu’avec GPT-6 Sol.
- Ses erreurs sont difficiles à détecter. Les 7 mauvaises réponses apparaissent en
low,mediumetxhigh, et chacune est un entier bien formé.
| Cas d’usage | Choix | Chiffres |
|---|---|---|
| Sortie analysée par du code : extraction, classification, valeur unique | GPT-6.1 Sol en medium ou high | réponse réduite à la seule valeur sur 234 / 234 ; $0.0021 par tâche en medium |
| Mathématiques ou logique à plusieurs étapes, quand une valeur erronée coûte cher | Sonnet 5.5, ou GPT-6.1 Sol avec vérification du résultat | Sonnet 5.5 correct sur 234 / 234 ; GPT-6.1 Sol incorrect sur 7 appels sur 18 pour une tâche |
| Chat et outils interactifs, quand la latence compte | Sonnet 5.5 à son réglage par défaut | 3.9 s contre 5.7 s par tâche courte ; 17.2 s contre 22.4 s par document |
| Boucles d’agents où le coût par exécution compte plus que la latence | GPT-6.1 Sol à son réglage par défaut | $0.0052 par exécution contre $0.0112 ; 12.2 s contre 6.7 s |
| Documents avec des sections obligatoires | GPT-6.1 Sol, ou Sonnet 5.5 en prévoyant une marge sur les longueurs demandées | complets dans 80 / 80 cas contre 68 / 80 ; les réponses non conformes manquent de 1 à 28 mots |
| Tâches difficiles et ouvertes, quand le meilleur score compte | Sonnet 5.5 ou Opus 5.5 en max | scores de 56 et 58 sur les indices publics contre 52, pour un coût par tâche 7 à 11 fois plus élevé |
Avec l’un comme avec l’autre, vérifiez toute valeur sur laquelle un programme doit agir.
FAQ
GPT-6.1 Sol coûte-t-il moins cher que Claude Sonnet 5.5 ?
GPT-6.1 Sol coûte moins cher par tâche que Sonnet 5.5, malgré leur tarif identique de $2 / $10 : dans nos tests, 0.49x par tâche en un seul appel aux réglages par défaut de chaque modèle et 0.46x par boucle d’outils. À score égal de 52 chez Artificial Analysis, le coût est de $0.72 contre $2.74. Sonnet 5.5 est plus rapide et obtient un meilleur score en max.
GPT-6.1 Sol vaut-il Claude Opus 5.5 ? GPT-6.1 Sol obtient environ 6 points de moins qu’Opus 5.5 sur l’Intelligence Index d’Artificial Analysis (52 contre 58) et sur le Vals Index (61.2% contre 67.0%), pour un coût par tâche huit à dix fois inférieur. Dans nos tests, il coûte 0.29x par tâche courte. Selon les tests d’OpenAI, il devance Opus 5.5 de 2.2 points sur AutomationBench.
Peut-on encore désactiver le raisonnement sur GPT-6.1 Sol ?
Pour GPT-6.1 Sol, le niveau de raisonnement le plus bas est low ; none, accepté par GPT-6 Sol, a disparu. Utilisez low, qui revient à $0.0018 par tâche en un seul appel dans nos tests.
Autres mesures : Claude Sonnet 5.5 face à Sonnet 5, les niveaux de raisonnement de GPT-6 Astra et les leviers de coût de GPT-5.6.
Mesures effectuées le 2026-09-30, un jour après la sortie de GPT-6.1 Sol, via une gateway vers l’API Responses d’OpenAI et l’API Messages d’Anthropic : 234 appels en un seul appel sur GPT-6.1 Sol (13 tâches, 3 répétitions, 6 réglages), 800 appels de rédaction de documents métier (80 cas où seul l’objectif est indiqué sur 6 combinaisons de modèles et de niveaux de raisonnement, 80 cas précisant les éléments requis sur 4 combinaisons) et 36 boucles d’outils. Les chiffres de Sonnet 5.5 et d’Opus 5.5 pour les tâches en un seul appel et les boucles d’outils datent du 2026-09-29 et portent sur les mêmes tâches. Les chiffres des benchmarks publics ont été relevés sur les pages de leurs éditeurs le 2026-10-01.