
GPT-6.1 Terra vs GPT-5.6 Terra et Sol : 192 appels API
Sommaire
- Où se situe GPT-6.1 Terra dans la gamme OpenAI ?
- Que montrent les benchmarks officiels ?
- Comment avons-nous testé les réglages de raisonnement ?
- Que se passe-t-il quand on désactive le raisonnement ?
- Comment les trois modèles se comparent-ils sur nos tâches ?
- Faut-il passer de GPT-5.6 Terra à GPT-6.1 Terra ?
- Faut-il choisir GPT-6.1 Terra ou GPT-6.1 Sol ?
- Comment régler l’effort de raisonnement dans l’API ?
- Comment valider les montants des factures en production ?
- FAQ
- La migration de GPT-5.6 Terra vers GPT-6.1 Terra vaut-elle le coup ?
- Faut-il choisir GPT-6.1 Terra ou GPT-6.1 Sol ?
- Peut-on désactiver le raisonnement pour le traitement des factures ?
GPT-6.1 Terra est le modèle économique d’OpenAI pour les traitements visuels. Il coûte $1 par million de tokens en entrée et $5 par million de tokens en sortie, soit la moitié des tarifs de GPT-6.1 Sol. L’effort de raisonnement détermine le raisonnement interne effectué avant de répondre. Le réglage none le désactive ; avec les autres réglages, les tokens de raisonnement sont facturés dans les tokens de sortie. Dans notre test, sans raisonnement, le modèle a réussi les 16 tâches sur tableaux et de sélection de boutons, mais seulement 3/8 calculs sur des images de factures et 0/8 calculs équivalents en texte.
TL;DR
- GPT-6.1 Terra
nonea réussi 16/16 tâches sur tableaux et captures d’écran, mais 3/8 calculs sur images de factures dans notre test synthétique. - GPT-6.1 Terra
lowa réussi 24/24 tâches sur image et 7/8 tâches équivalentes sur factures en texte ;mediuma obtenu 24/24 et 8/8. - GPT-6.1 Terra
mediuma coûté $0.028290 pour 24 images ; GPT-6.1 Sollowa coûté $0.055012. - Dans une série distincte à conditions identiques, GPT-6.1 Terra
mediuma coûté $0.028269 pour 24 images, contre $0.072094 pour GPT-5.6 Terra.
Où se situe GPT-6.1 Terra dans la gamme OpenAI ?
GPT-6.1 Terra vise le raisonnement visuel, les actions à l’écran et la rédaction concise, à un prix inférieur à celui de GPT-6.1 Sol. OpenAI a lancé Terra le 26 octobre 2026. Son guide de choix des modèles le recommande pour des tâches bien délimitées dont les résultats sont vérifiables, notamment les opérations à l’écran et les corrections de code ciblées. Sol reste l’option la plus généraliste pour les projets complexes.
GPT-5.6 Terra sert de référence de génération précédente pour décider d’une migration. Sol est l’alternative actuelle plus chère pour choisir une gamme de modèles. Ces trois modèles permettent donc de trancher deux questions :
| Caractéristique | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Rôle dans cette comparaison | Référence de génération précédente | Nouveau modèle pour les traitements visuels | Option plus chère pour les tâches complexes |
| Prix standard en entrée par 1M de tokens | $2 | $1 | $2 |
| Prix standard en sortie par 1M de tokens | $12 | $5 | $10 |
| Prix de lecture du cache d’entrée par 1M de tokens | $0.20 | $0.05 | $0.10 |
| Fenêtre de contexte | 1,050,000 tokens | 1,050,000 tokens | 1,050,000 tokens |
| Sortie maximale | 128,000 tokens | 128,000 tokens | 128,000 tokens |
| Réglages du raisonnement | none, low, medium, high, xhigh, max | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Raisonnement par défaut | medium | medium | medium |
| Modalités en entrée / sortie | Texte et image / texte | Texte et image / texte | Texte et image / texte |
| Endpoint utilisé dans nos tests | Responses API | Responses API | Responses API |
Sources : documentation officielle de GPT-5.6 Terra, de GPT-6.1 Terra, de Sol et journal des versions. Les prix ci-dessus s’appliquent aux requêtes Standard contenant au plus 272,000 tokens en entrée. Au-delà, le tarif des entrées non mises en cache double et celui des sorties augmente de 50% pour l’ensemble de la requête. Les écritures en cache ont des tarifs distincts ; aucune de nos requêtes principales mesurées n’a signalé de lecture ni d’écriture en cache.
Le nouveau Terra conserve la fenêtre de contexte, la limite de sortie et les noms des réglages de raisonnement de la génération précédente. Son prix affiché baisse de 50% en entrée et de 58.3% en sortie. Plus loin, notre test de migration à conditions identiques distingue ces baisses tarifaires des changements de consommation de tokens et d’exactitude des résultats.
Que montrent les benchmarks officiels ?
Lors du lancement, OpenAI a comparé GPT-6.1 Terra à GPT-5.6 Terra et à GPT-6.1 Sol. Voici les résultats effectivement publiés :
| Évaluation | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Agents’ Last Exam : tâches visuelles professionnelles | Référence ; score absolu non précisé | À medium, +15 points de pourcentage par rapport au prédécesseur, pour environ un tiers du coût par tâche | Score absolu non précisé |
| MMMU-Pro : raisonnement visuel | Derrière le nouveau Terra à tous les réglages publiés ; scores non précisés | Presque au niveau de Sol ; scores non précisés | Présenté comme presque égalé par le nouveau Terra ; score non précisé |
| Terminal-Bench 4.0 : tâches de programmation dans le terminal | Score publié de 21.5% ; effort non précisé | 50.3% à max | Score non précisé |
| Test interne de factualité : un taux d’erreur plus faible est préférable | 53.6% d’erreurs à low | 16.7% d’erreurs à low | Taux d’erreur à low non précisé |
Source : évaluations publiées par OpenAI au lancement. Les scores manquants n’ont pas été publiés ; l’évaluation de factualité est interne. Nos tests API ci-dessous examinent la migration et le choix de gamme sur les mêmes tâches synthétiques.
Comment avons-nous testé les réglages de raisonnement ?
Nous avons testé GPT-6.1 Terra à none, low et medium, ainsi que GPT-6.1 Sol à low, avec 32 entrées par configuration : 24 images et huit témoins textuels équivalents. L’étude principale compte donc 128 appels. Une comparaison de migration distincte a alterné les réponses de GPT-5.6 Terra et de nouvelles réponses de GPT-6.1 Terra à medium sur les mêmes 32 entrées, soit 64 appels supplémentaires et 192 au total. Le tableau de migration utilise uniquement ce lot distinct.
| Famille de tâches | Entrées par configuration | Résultat attendu |
|---|---|---|
| Images de factures | 8 | Multiplier les lignes, soustraire une remise, calculer et arrondir la taxe, soustraire un acompte |
| Tableaux à filtrer | 8 | Agréger les données de la région et du trimestre demandés, puis calculer un taux de retour |
| Captures d’écran d’application | 8 | Identifier le bon ID de contrôle et un point à l’intérieur de son bouton parmi des cartes similaires |
| Témoins textuels de factures | 8 | Calculer les mêmes montants à partir d’une transcription exacte |
Nous avons généré des documents fictifs aux réponses connues, à partir de trois modèles de documents dont les valeurs ou la mise en page variaient. Chaque image mesurait 960 sur 640 pixels et était envoyée avec detail: "high". Les versions image et texte d’une facture utilisaient les mêmes consignes, le même schéma et les mêmes règles métier. Chaque entrée a reçu une réponse par configuration.
Les tests ont utilisé des requêtes Responses en streaming via Synthorai le 29 octobre 2026, avec une limite commune de 4,096 tokens en sortie et une alternance des configurations. Les 128 réponses principales se sont terminées et ont renvoyé un JSON conforme au schéma. Une tâche n’était considérée comme réussie que si toutes les valeurs demandées étaient exactes ; les coordonnées sur les captures d’écran devaient se trouver dans le bon bouton. Nous avons évalué les réponses par du code, avec des centimes entiers et des arrondis décimaux, sans modèle évaluateur.
Ces 24 images représentent trois modèles de tâches, et non 24 types de travail différents. Les seize comparaisons appariées des études principale et de migration, corrigées ensemble par la méthode de Holm pour tenir compte des comparaisons multiples, n’ont produit aucune valeur p corrigée inférieure à 0.05. Les résultats ci-dessous décrivent cette exécution ; ils n’établissent ni classement général de qualité ni équivalence entre les modèles.
Que se passe-t-il quand on désactive le raisonnement ?
À none, GPT-6.1 Terra a échoué sur cinq des huit calculs sur images de factures et sur les huit calculs sur factures en texte. Dans la même série de tests par niveau d’effort, low a obtenu 8/8 sur les images de factures et 7/8 sur les témoins textuels ; medium a obtenu 8/8 dans les deux cas. Les résultats des trois modèles sont regroupés dans le tableau plus bas.
Les erreurs sur les entrées purement textuelles montrent que la lecture des images ne peut pas expliquer tous les échecs. Les huit paires d’entrées ne suffisent pas à établir un avantage du format image.
Une facture illustre concrètement le problème :
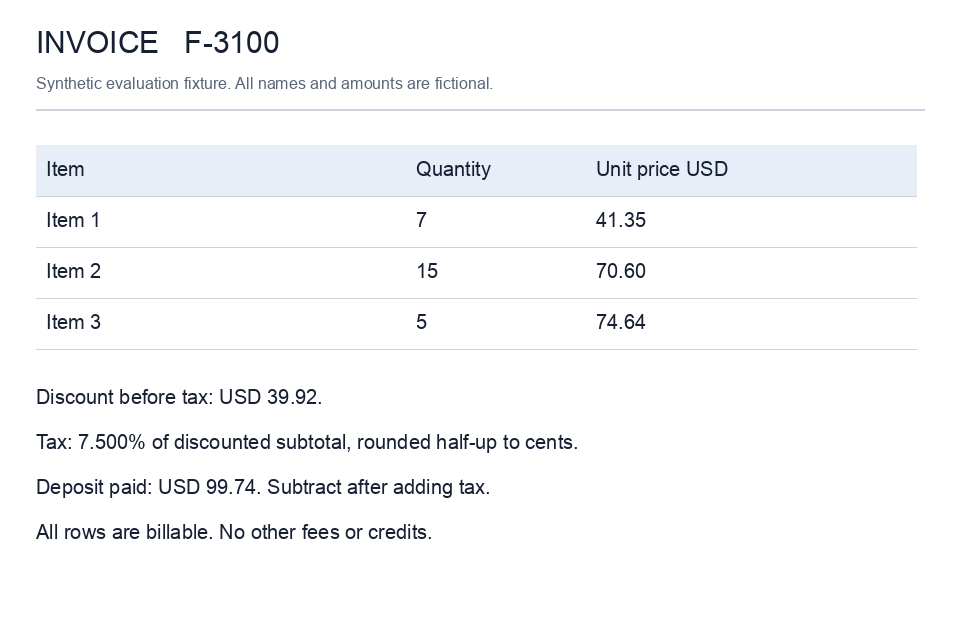
Les lignes sont 7 × $41.35, 15 × $70.60 et 5 × $74.64. Leur sous-total est de $1,721.65. Après la remise de $39.92, la taxe de 7.5%, arrondie au plus proche avec les demis vers le haut, vaut $126.13 ; une fois l’acompte de $99.74 déduit, le solde dû est de $1,708.12.
Sur la version texte, Terra low a renvoyé un sous-total de $1,711.65, une taxe de $125.38 et un solde dû de $1,697.37. Le JSON respectait le schéma, mais les calculs étaient faux. Augmenter l’effort est une piste à évaluer ; une sortie typée ne suffit pas à valider un montant.
Dans la série principale initiale, les quatre configurations ont réussi les huit tâches sur tableaux filtrés et les huit tâches de sélection de boutons. Ces modèles de tâches n’ont pas permis de différencier leur qualité dans cette série ; les erreurs sur les factures expliquent les écarts de réussite.
Comment les trois modèles se comparent-ils sur nos tâches ?
GPT-5.6 Terra et GPT-6.1 Terra ont été comparés à medium ; GPT-6.1 Sol a été testé à low pour la comparaison pratique entre gammes. Nous retenons Terra medium pour notre recommandation principale de gamme, car il a obtenu 8/8 sur les factures en texte contre 7/8 à low ; Sol conserve le réglage low testé. Nous comparons donc des configurations candidates à des efforts différents, et non leur qualité à effort de raisonnement égal. L’écart d’une tâche ne prouve pas que medium soit généralement plus exact.
La série principale est le test initial des niveaux d’effort. La série de migration est la nouvelle comparaison entre l’ancien et le nouveau Terra. Lorsque les mesures diffèrent, la colonne du nouveau Terra indique une valeur pour chaque série. Les recommandations de migration utilisent les valeurs de cette série ; celles qui opposent Terra à Sol utilisent les valeurs de la série principale. Aucun ratio de coût ou de latence ci-dessous ne mélange les lots.
| Mesure | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Configuration | medium, série de migration | medium, séries principale et de migration | low, série principale |
| Images de factures correctes | 8/8 | 8/8 dans chaque série | 8/8 |
| Factures textuelles équivalentes correctes | 8/8 | 8/8 dans chaque série | 8/8 |
| Tableaux filtrés corrects | 8/8 | 8/8 dans chaque série | 8/8 |
| Tâches sur captures d’écran entièrement correctes | 2/8 | 8/8 dans chaque série | 8/8 |
| Ensemble des tâches sur image correctes | 18/24 | 24/24 dans chaque série | 24/24 |
| Coût pour 24 images | $0.072094 | Principale : $0.028290 ; migration : $0.028269 | $0.055012 |
| Même consommation sur image à $1 en entrée / $5 en sortie par 1M de tokens | $0.033500 | Principale : $0.028290 ; migration : $0.028269 | $0.027506 |
| Coût par tâche sur image correcte | $0.004005 | Principale : $0.001179 ; migration : $0.001178 | $0.002292 |
| Temps de réponse médian sur image | 2.57 s | Principale : 5.75 s ; migration : 6.43 s | 4.51 s |
Le coût par tâche correcte est le coût total divisé par le nombre de réponses entièrement correctes. Il inclut le coût des réponses incorrectes, sans simulation de nouvelles tentatives. Nous utilisons la consommation renvoyée par l’API aux tarifs Standard fixes, en comptant le raisonnement dans les tokens de sortie. Le test distinct d’appel de fonction est exclu. Les temps de réponse sont mesurés de bout en bout via la passerelle ; l’infrastructure de service n’a pas été maintenue constante de façon indépendante.
Dans ses six échecs, l’ancien Terra a renvoyé des coordonnées situées dans le bon bouton, mais a inventé des ID comme cobalt-edit au lieu de lire l’ID du contrôle affiché. Il s’agit d’erreurs sur des champs exacts. Les deux générations ont calculé correctement toutes les factures à medium dans la série de migration.
Dans la série principale par niveau d’effort, le nouveau Terra none a coûté $0.024275 pour les 24 images avec 19/24 réponses correctes, contre $0.027835 et 24/24 pour low. Le coût observé par tâche sur image correcte est donc de $0.001278 à none et de $0.001160 à low. Sur cet ensemble, la dépense totale plus faible à none n’a pas donné le coût par résultat correct le plus bas.
Faut-il passer de GPT-5.6 Terra à GPT-6.1 Terra ?
GPT-6.1 Terra mérite d’être évalué pour remplacer GPT-5.6 Terra lorsque le coût d’inférence ou l’extraction exacte de champs visuels compte. Dans la série à conditions identiques à medium, le coût des tâches sur image a baissé de 60.8%, avec 24/24 réponses entièrement correctes contre 18/24. Les six résultats qui ont changé concernent des ID de contrôles affichés ; après correction statistique, cet échantillon ne permet pas de conclure à une supériorité générale de qualité.
Le tarif actuel de l’ancien modèle est de $2 en entrée et $12 en sortie par million de tokens. Le nouveau Terra réduit ces prix de 50% et de 58.3%. Au tarif commun de $1/$5, sa consommation sur les tâches sur image coûte encore 15.6% de moins. Les volumes d’entrée étaient proches, 20,765 contre 20,789 tokens ; la sortie est passée de 2,547 à 1,496 tokens.
Pour le traitement de documents internes ou l’extraction de champs avec validation, testez le nouveau modèle au niveau d’effort existant et vérifiez les ID et les montants exacts avant de migrer. Pour une interaction sensible à la latence, gardez l’ancien modèle comme point de comparaison jusqu’à ce que le nouveau respecte l’objectif de temps de réponse de l’application : dans cette série, la latence médiane sur image était de 2.57 secondes pour l’ancien modèle et de 6.43 pour le nouveau. Pour les factures susceptibles de déclencher un paiement, conservez des calculs déterministes et des contrôles d’approbation avec les deux générations.
Faut-il choisir GPT-6.1 Terra ou GPT-6.1 Sol ?
GPT-6.1 Terra medium est le candidat le moins cher pour ces tâches visuelles délimitées ; GPT-6.1 Sol low reste à comparer lorsque le temps de réponse ou des tâches plus complexes comptent. Dans la série principale, les deux ont réussi 24/24 tâches sur image, pour $0.028290 contre $0.055012. L’économie observée de 48.6% s’explique entièrement par les tarifs d’entrée et de sortie de Terra, inférieurs de 50% : au tarif de $1/$5, la consommation de Sol coûterait $0.027506, soit un peu moins que les $0.028290 de Terra.
Pour l’extraction par lots avec validation, évaluez d’abord Terra sur vos propres exemples et comparez les types d’erreurs. Pour un parcours interactif, confrontez la médiane observée de Sol, 4.51 secondes, et celle de Terra, 5.75 secondes, à l’objectif réel de latence du produit. Les projets de programmation complexes et les agents aux tâches ouvertes nécessitent une évaluation représentative au-delà de ces trois modèles de tâches ; le guide de choix d’OpenAI positionne Sol sur les travaux complexes. Les nombres de réussites identiques ici ne prouvent pas une équivalence générale.
Comment régler l’effort de raisonnement dans l’API ?
Pour GPT-6.1 Terra, définissez explicitement reasoning.effort et examinez à la fois la réponse et la consommation renvoyée. Le guide GPT-6 indique medium comme valeur par défaut et impose Responses pour les appels d’outils. Les tokens de raisonnement consomment le budget de sortie et sont facturés dans les tokens de sortie, sans être ajoutés une seconde fois.
Cet exemple Python illustre une méthode d’extraction pour la production, sans reproduire le benchmark de calcul. Installez openai, définissez OPENAI_API_KEY et enregistrez la facture illustrée sous invoice.png. Demandez les lignes et les règles imprimées, en laissant les champs absents à null. La règle prise en charge ici applique la remise avant la taxe, arrondit au centime au plus proche avec les demis vers le haut, puis déduit l’acompte après la taxe.
import base64
import json
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
encoded = base64.b64encode(Path("invoice.png").read_bytes()).decode()
nullable_int = {"type": ["integer", "null"]}
rule = "discount_then_tax_half_up_then_deposit"
item_fields = {"quantity": nullable_int, "unit_price_cents": nullable_int}
properties = {
    "currency": {"type": ["string", "null"]},
    "items": {"type": "array", "items": {
        "type": "object", "properties": item_fields,
        "required": list(item_fields), "additionalProperties": False,
    }},
    "discount_cents": nullable_int,
    "tax_rate": {"type": ["string", "null"]},
    "deposit_cents": nullable_int,
    "calculation_rule": {"type": ["string", "null"],
                         "enum": [rule, "other", None]},
}
response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "medium"},
    max_output_tokens=4096,
    store=False,
    input=[{"role": "user", "content": [
        {"type": "input_text", "text": (
            "Extract the printed invoice fields, not calculated totals. "
            "Use integer cents for prices, discount, and deposit, and an "
            "ISO currency code. Express the tax rate as a decimal string "
            "(7.5% becomes 0.075). Use null for missing or ambiguous fields. "
            f"Set calculation_rule to {rule} only when the printed rules "
            "explicitly match; use other for a different rule and null "
            "if unclear. Do not invent rules or default amounts to zero."
        )},
        {"type": "input_image", "detail": "high",
         "image_url": "data:image/png;base64," + encoded},
    ]}],
    text={"format": {
        "type": "json_schema", "name": "invoice_fields", "strict": True,
        "schema": {"type": "object", "properties": properties,
                   "required": list(properties), "additionalProperties": False},
    }},
)
if response.status != "completed":
    raise RuntimeError(f"Incomplete response: {response.status}")
if not response.output_text:
    raise RuntimeError("No invoice JSON returned; inspect refusal/error output")
extracted = json.loads(response.output_text)
print(extracted)
usage = response.usage
if usage is not None:
    reasoning = getattr(usage.output_tokens_details, "reasoning_tokens", None)
    print({"input_tokens": usage.input_tokens,
           "output_tokens": usage.output_tokens,
           "reasoning_tokens": reasoning})
Nous avons aussi exécuté un test local distinct d’appel de fonction pour les quatre configurations principales d’origine (nouveau Terra à none/low/medium et GPT-6.1 Sol à low) : sélectionner un contrôle sur une capture d’écran, lire la sélection effectivement enregistrée, puis renvoyer un résultat vérifié. Les quatre ont correctement terminé la séquence imposée de trois tours, soit 12 tours d’API. Les résultats de fonction utilisaient les ID d’appel correspondants et réinjectaient les éléments de sortie. Il s’agit d’un test local de compatibilité, pas d’un benchmark d’utilisation autonome d’un bureau.
Comment valider les montants des factures en production ?
Pour la comptabilisation des factures et les paiements, extrayez des opérandes typés et calculez les totaux dans du code déterministe. Validez les champs sources et exigez une approbation avant tout mouvement de fonds, quel que soit le modèle retenu pour son coût ou sa latence.
Exécutez ce bloc après l’exemple d’extraction. Il rejette les entrées manquantes ou non prises en charge et calcule les totaux de la facture illustrée. Les centimes entiers évitent les erreurs liées aux nombres flottants binaires ; Decimal applique la règle d’arrondi de taxe indiquée.
from decimal import Decimal, InvalidOperation, ROUND_HALF_UP


def invoice_totals(data):
    if data.get("currency") != "USD" or data.get("calculation_rule") != rule:
        raise ValueError("Missing or unsupported currency/calculation rule")
    items = data.get("items")
    if not isinstance(items, list) or not items:
        raise ValueError("Missing line items")
    for item in items:
        if (not isinstance(item, dict)
                or type(item.get("quantity")) is not int
                or item["quantity"] <= 0
                or type(item.get("unit_price_cents")) is not int
                or item["unit_price_cents"] < 0):
            raise ValueError("Invalid or missing line-item values")
    for key in ("discount_cents", "deposit_cents"):
        if type(data.get(key)) is not int or data[key] < 0:
            raise ValueError(f"Invalid or missing {key}")
    if not isinstance(data.get("tax_rate"), str):
        raise ValueError("Missing tax rate")
    try:
        rate = Decimal(data["tax_rate"])
    except InvalidOperation as exc:
        raise ValueError("Invalid tax rate") from exc
    if not rate.is_finite() or not Decimal(0) <= rate <= Decimal(1):
        raise ValueError("Unsupported tax rate")
    subtotal = sum(i["quantity"] * i["unit_price_cents"] for i in items)
    taxable = subtotal - data["discount_cents"]
    if taxable < 0:
        raise ValueError("Discount exceeds subtotal")
    tax = int((Decimal(taxable) * rate).quantize(
        Decimal("1"), rounding=ROUND_HALF_UP
    ))
    return {"subtotal_cents": subtotal, "tax_cents": tax,
            "balance_due_cents": taxable + tax - data["deposit_cents"]}


calculated = invoice_totals(extracted)
print({"source_fields": extracted, "calculated_totals": calculated})
La sortie est prête à être contrôlée, pas à être comptabilisée automatiquement. Les vérifications de types et de règles ne prouvent pas qu’un prix a été lu correctement : rapprochez les champs extraits du document source et examinez les conditions ambiguës avant d’approuver un paiement. L’exemple d’extraction propose une méthode d’implémentation ; nos 192 appels mesurés portaient sur les prompts de calcul décrits plus haut.
Pour d’autres mesures, consultez notre guide de facturation des images en entrée, nos tests de coût des différentes représentations de PDF et notre comparaison de modèles au même prix.
FAQ
La migration de GPT-5.6 Terra vers GPT-6.1 Terra vaut-elle le coup ?
GPT-6.1 Terra a réduit le coût des tâches sur image de 60.8% par rapport à GPT-5.6 Terra à medium dans notre série à conditions identiques, ou de 15.6% en appliquant aux deux un tarif de $1 en entrée / $5 en sortie par million de tokens. Les deux ont réussi tous les calculs de factures ; l’ancien modèle a échoué sur six ID de contrôles affichés. La latence médiane observée étant plus élevée pour le nouveau modèle, la décision de migration doit inclure une validation des temps de réponse.
Faut-il choisir GPT-6.1 Terra ou GPT-6.1 Sol ?
GPT-6.1 Terra medium a coûté $0.028290 pour 24 tâches sur image, contre $0.055012 pour GPT-6.1 Sol low, avec un score de 24/24 pour les deux dans la série principale. Évaluez Terra pour les traitements par lots avec validation et comparez Sol pour les usages interactifs : leurs temps de réponse médians étaient respectivement de 5.75 et de 4.51 secondes. Ces tâches synthétiques ne permettent pas d’établir une équivalence générale de qualité.
Peut-on désactiver le raisonnement pour le traitement des factures ?
À none, GPT-6.1 Terra n’a correctement résolu que 3/8 images de factures et 0/8 calculs textuels équivalents dans notre série principale. Gardez les calculs monétaires exacts dans le code et validez les opérandes extraits. Pour des tâches délimitées sur tableaux ou de sélection de boutons, none a réussi 16/16 ici et mérite une évaluation sur votre charge de travail.