
Sonnet 5.5 face à Sonnet 5 : même prix, 80% moins cher par tâche
Sommaire
- Qu’est-ce qui change avec Claude Sonnet 5.5 ?
- Que montrent les benchmarks de lancement ?
- Comment avons-nous effectué les mesures ?
- Sonnet 5.5 coûte-t-il moins cher par tâche que Sonnet 5 ?
- Combien coûte chaque niveau d’effort ?
- Pourquoi Sonnet 5.5 détaille-t-il ses calculs dans la réponse ?
- Que se passe-t-il dans une boucle d’outils ?
- Sonnet 5.5 est-il plus rapide ?
- Les budgets de tokens de Sonnet 5 restent-ils valables ?
- Lequel choisir ?
- FAQ
Claude Sonnet 5.5 affiche les mêmes tarifs par token que Claude Sonnet 5 : $2 par million de tokens en entrée et $10 par million en sortie. Toute économie vient donc d’une réduction du nombre de tokens. Sur 13 tâches single-shot avec les réglages par défaut de l’API, il coûtait $0.0041 par tâche contre $0.021 pour Sonnet 5, soit 80% de moins, avec 100% de bonnes réponses pour les deux modèles. Le problème concerne le format de sortie : en dessous du niveau d’effort xhigh, Sonnet 5.5 ignore parfois son raisonnement masqué et détaille ses calculs directement dans la réponse, même si le prompt demande uniquement le résultat.
TL;DR
- Avec les réglages par défaut de l’API, Sonnet 5.5 coûtait $0.0041 par tâche contre $0.021 pour Sonnet 5, avec des réponses correctes sur les 39 appels pour les deux modèles.
- Sonnet 5.5 coûtait à peu près autant avec les niveaux d’effort
low,mediumethigh;maxcoûtait 3.5x plus cher que le réglage par défaut. - En dessous de
xhigh, Sonnet 5.5 a détaillé ses calculs dans 68 réponses sur 156 prompts qui ne demandaient que le résultat ; un prompt système n’a rien corrigé. - Dans une boucle d’outils à quatre questions, Sonnet 5.5 avec
maxcoûtait $0.042 par exécution, plus que Opus 5.5 avec son réglage par défaut ($0.033).
Anthropic a lancé Sonnet 5.5 le 2026-09-28 en annonçant un modèle 30% plus rapide et « jusqu’à 30% moins cher par tâche » que Sonnet 5. Nous l’avons mesuré le lendemain.
Qu’est-ce qui change avec Claude Sonnet 5.5 ?
Le tarif reste identique, mais les réglages de raisonnement et plusieurs paramètres de requête ont changé. Sonnet 5.5 utilise le raisonnement adaptatif : le modèle détermine lui-même la quantité de raisonnement masqué nécessaire avant de répondre, et ces tokens sont facturés comme des tokens de sortie. Le paramètre effort (output_config.effort dans la Messages API) permet de le piloter sur cinq niveaux, de low à max. Le réglage par défaut de l’API est high.
| Sonnet 5.5 | Sonnet 5 | Opus 5.5 | |
|---|---|---|---|
| Date de sortie | 2026-09-28 | 2026-06-30 | 2026-09-22 |
| Entrée / sortie, par million de tokens | $2 / $10 | $2 / $10 | $4 / $20 |
| Lecture du cache, par million de tokens | $0.20 | $0.20 | $0.20 |
| Fenêtre de contexte / sortie maximale | 1M / 128K | 1M / 128K | 1M / 128K |
| Date limite des connaissances (seul le mois est publié) | Juin 2026 | Janvier 2026 | Juin 2026 |
| Niveau d’effort par défaut dans l’API | high | high | medium |
| Réglage de raisonnement minimal | between_tools (avec high ou moins) | disabled | aucune désactivation possible ; le raisonnement est toujours actif |
| Taille minimale d’un prompt pouvant être mis en cache | 512 tokens | 1,024 tokens | 512 tokens |
Le tarif de $2 / $10 de Sonnet 5 avait été lancé comme prix de lancement, mais la page tarifaire d’Anthropic le présente désormais comme le tarif standard. Le passage prévu à $3 / $15 n’a pas eu lieu.
D’après le guide de migration, les requêtes suivantes fonctionnaient avec Sonnet 5, mais renvoient une erreur HTTP 400 avec Sonnet 5.5 :
thinking: {"type": "disabled"}. Utilisezthinking: {"type": "between_tools"}, qui désactive le raisonnement avant la première réponse et n’est accepté qu’avec un niveau d’efforthighou inférieur.- L’appel forcé d’un outil (
tool_choicedéfini suranyou sur un outil nommé). Conservezautoet indiquez dans le prompt quand l’outil doit être utilisé. - Un budget de raisonnement manuel (
budget_tokens), une valeur non standard detemperature,top_poutop_k, ainsi qu’un tour assistant prérempli, où le début de la réponse est fourni au modèle. - Le renvoi d’un bloc de raisonnement Sonnet 5.5 après modification du prompt système, des outils ou d’un message précédent, pour les comptes créés à partir du 2026-08-31.
- L’ancien outil de computer use
computer_20251124dans l’API Claude et Google Cloud.
Un changement ne déclenche aucune erreur : les notes courtes produites par le modèle entre deux appels d’outils arrivent désormais sous forme de blocs de raisonnement. Avec le réglage d’affichage par défaut, ces blocs sont vides, si bien qu’une interface qui les diffuse en streaming n’affiche plus rien.
Que montrent les benchmarks de lancement ?
Dans le tableau d’Anthropic, Sonnet 5.5 se situe à quelques points de Opus 5.5 pour un tarif par token divisé par deux, et devance largement Sonnet 5.
| Benchmark (ce qu’il mesure) | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (développement agentique dans un terminal) | 70.6% | 10.3% | 66.4% (xhigh) | non publié |
| CursorBench 4.0 (développement dans un éditeur) | 55.5% | 34.1% | 57.8% | non publié |
| GDPval-AA v2.1 (documents de travail intellectuel, score Elo, le plus élevé est le meilleur) | 1844 | 1449 | 1846 | 1487 |
| OSWorld 2.1 (utilisation d’un ordinateur, crédit partiel) | 80.1% | 57.0% | 81.8% | non publié |
| Humanity’s Last Exam, avec outils | 64.5% | 54.9% | 67.7% | non publié |
Artificial Analysis signale un risque côté coûts : avec un effort max, Sonnet 5.5 a obtenu 56 sur son Intelligence Index, deux points derrière Opus 5.5 avec max, mais a consommé environ 193K tokens de sortie par tâche. C’est le niveau le plus élevé jamais mesuré par Artificial Analysis, environ 60% de plus que Opus 5.5 ou Sonnet 5 avec max, pour un coût d’environ $7.60 par tâche de l’index.
Comment avons-nous effectué les mesures ?
Nous avons envoyé aux trois modèles 13 tâches single-shot dont les réponses étaient connues, avec un prompt, une réponse et aucun outil : huit tâches courtes, comme additionner les nombres premiers inférieurs à 60 ou compter le chiffre 7 de 1 à 500, et cinq tâches nécessitant plusieurs vraies étapes, comme un problème de sac à dos à 10 éléments, les chemins dans une grille 8x8 contenant des cases bloquées ou 13 à la puissance 1,001 modulo 10,007. Chaque réponse de référence a été calculée localement par force brute, et chaque prompt se terminait par « Répondez avec un seul entier, sans rien ajouter. » Chaque tâche a été exécutée 3 fois avec le réglage par défaut de l’API, puis avec chacun des cinq niveaux d’effort, soit 702 appels au total via la Messages API native. Chaque prompt contenait une chaîne aléatoire unique pour éviter toute réponse issue du cache, et les coûts ont été calculés à partir des tarifs publics d’Anthropic. Nous avons vérifié si la réponse finale était correcte et si elle ne contenait rien d’autre que le résultat.
La précision ne permettait pas de départager les modèles. Sonnet 5.5 a répondu correctement aux 234 appels, et Sonnet 5 aux 233 appels ayant abouti, un appel ayant rencontré une erreur serveur. Opus 5.5 a échoué sur une tâche avec low et une autre avec le réglage par défaut.
Sonnet 5.5 coûte-t-il moins cher par tâche que Sonnet 5 ?
Sonnet 5.5 coûtait 80% de moins que Sonnet 5 avec le réglage par défaut, et 77% à 78% de moins avec low, medium et high, car il produisait environ cinq fois moins de tokens de sortie. Les tarifs publics sont identiques, toute l’économie vient donc de l’efficacité en tokens. Sonnet 5 produisait environ 1,800 à 2,100 tokens par tâche à tous les niveaux d’effort ; Sonnet 5.5 restait autour de 400 jusqu’à xhigh.
| Ensemble des 13 tâches, par tâche | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Réglage par défaut de l’API | $0.0041 (396 tokens) | $0.0212 (2,105) | $0.0070 (334) |
low | $0.0043 (409) | $0.0184 (1,817) | $0.0065 (309) |
medium | $0.0040 (383) | $0.0180 (1,780) | $0.0082 (393) |
high | $0.0043 (416) | $0.0188 (1,858) | $0.0088 (421) |
xhigh | $0.0059 (574) | $0.0202 (2,001) | $0.0105 (507) |
max | $0.0146 (1,438) | $0.0193 (1,909) | $0.0234 (1,149) |
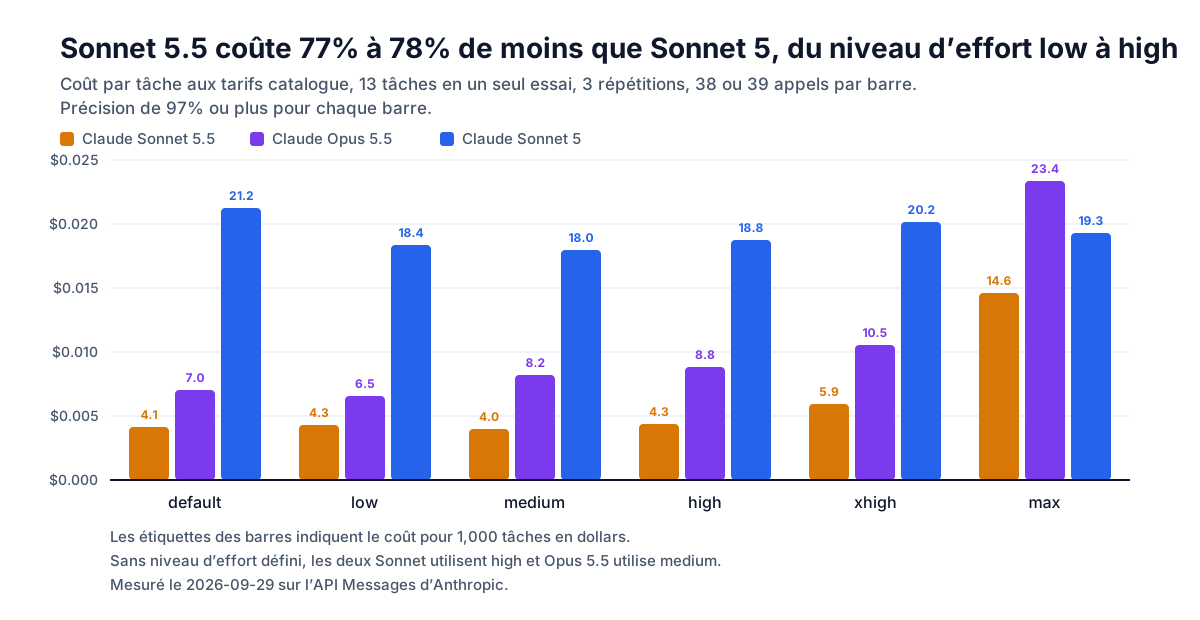
Les nombres de tokens correspondent à la moyenne des tokens de sortie par appel, raisonnement compris. Sur les cinq tâches difficiles, l’économie avec le réglage par défaut atteint 84% ($0.0057 contre $0.0348). Dans notre boucle d’outils, où l’intégralité de la conversation est renvoyée à chaque tour et où les tokens d’entrée dominent, elle n’est que de 8%. L’affirmation d’Anthropic, « jusqu’à 30% », est donc prudente pour des prompts uniques comme les nôtres, mais généreuse pour une boucle courte comme celle de notre test.
Avec seulement 13 tâches, l’économie de 80% avec le réglage par défaut reste imprécise : un rééchantillonnage des tâches donne un intervalle à 95% de 66% à 85% de moins, et la borne basse reste au-dessus de 50% à chaque niveau de low à xhigh.
Combien coûte chaque niveau d’effort ?
Avec Sonnet 5.5, low, medium et high coûtaient tous environ $0.0042 par tâche. Le réglage par défaut high n’entraînait donc aucun surcoût dans notre test. xhigh coûtait environ 40% de plus et max 3.5x plus que le réglage par défaut. Avec max, Sonnet 5.5 coûtait deux fois plus cher par tâche que Opus 5.5 avec son réglage par défaut ($0.0146 contre $0.0070), sans gain de précision.
Cette stabilité ne se retrouvera pas partout : sur une tâche DevOps plus longue, un autre testeur a constaté que high utilisait environ deux fois plus de tokens de sortie que medium. Si le niveau d’effort peut avoir un impact sur votre workload, testez toute la plage.
Pourquoi Sonnet 5.5 détaille-t-il ses calculs dans la réponse ?
En dessous de xhigh, Sonnet 5.5 n’utilise pas systématiquement un bloc de raisonnement. Lorsqu’il n’en produit pas, il raisonne directement dans la réponse. Un bloc de raisonnement est la partie distincte de la réponse qui contient le raisonnement du modèle. Son contenu est vide par défaut, puis la réponse proprement dite arrive dans un bloc text.
Sur les 234 réponses de Sonnet 5.5, les 166 qui contenaient un bloc de raisonnement ne comprenaient que le résultat. Les 68 autres détaillaient d’abord les calculs, par exemple « 09:47 + 3:46 = 13:33 … + 1:39 = 15:40 », puis affichaient « 15:40 ». La réponse finale était correcte à chaque fois, mais son format ne respectait pas le prompt.
| Réponses contenant uniquement le résultat | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Réglage par défaut de l’API | 22 / 39 | 38 / 39 | 38 / 39 |
low | 12 / 39 | 37 / 39 | 38 / 39 |
medium | 24 / 39 | 37 / 39 | 39 / 39 |
high | 30 / 39 | 38 / 39 | 39 / 39 |
xhigh | 39 / 39 | 35 / 38 | 39 / 39 |
max | 39 / 39 | 37 / 39 | 39 / 39 |
Le comportement dépend de la tâche : là où il est apparu, Sonnet 5.5 a détaillé ses calculs lors des trois répétitions, sauf pour une tâche avec le réglage par défaut, où il l’a fait deux fois. Cela s’est produit sur 9 des 13 tâches avec low, 6 avec le réglage par défaut, 5 avec medium et 3 avec high (toutes de courts calculs arithmétiques). Comptés par tâche, avec seulement 13 tâches, aucun de ces écarts ne passe une correction de Holm : lisez ces chiffres comme des observations, pas comme un taux sur lequel planifier. Les écarts de Sonnet 5 sont différents : le modèle fournit une réponse correcte en gras, suivie d’une courte explication. La ligne xhigh ne comporte que 38 appels, car l’un d’eux a rencontré une erreur serveur.
Un prompt système demandant « uniquement le résultat final » et précisant que tous les calculs devaient être effectués silencieusement n’a rien changé : Sonnet 5.5 n’a donné que le résultat sur 8 des 24 tâches courtes avec low et sur 9 des 24 tâches avec medium, contre 6 et 9 sans ce prompt système. xhigh a corrigé le problème : chaque réponse contenait un bloc de raisonnement et uniquement le résultat demandé, pour un coût environ 40% supérieur à celui de low à high. Pour du code qui parse la sortie du modèle :
- Utilisez
xhighsi la réponse doit tenir sur une seule ligne. - Sinon, récupérez la réponse sur la dernière ligne non vide, qui était correcte dans les 68 cas observés ici.
- Les sorties structurées d’Anthropic peuvent aussi contraindre la réponse à respecter un schéma ; nous n’avons pas testé cette option.
import anthropic

client = anthropic.Anthropic()
prompt = "Compute 7 raised to the power 222, modulo 1000. Reply with a single integer, nothing else."
resp = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    output_config={"effort": "xhigh"},  # low, medium, high (API default), xhigh, max
    messages=[{"role": "user", "content": prompt}],
)
text = "".join(block.text for block in resp.content if block.type == "text")
lines = text.strip().splitlines()
answer = lines[-1] if lines else None  # below xhigh, working can precede the answer
print(answer, resp.usage.output_tokens)  # output_tokens includes the reasoning
Que se passe-t-il dans une boucle d’outils ?
Avec le réglage par défaut, low et medium, Sonnet 5.5 a réussi toutes les exécutions d’une boucle de lecture de code à quatre questions pour environ $0.011, soit un tiers du coût de Opus 5.5. Avec max, il effectuait trois fois plus d’appels d’outils et coûtait plus cher que Opus 5.5. Chaque modèle dispose de trois outils, lister les fichiers, lire un fichier et effectuer une recherche, sur une petite base de code synthétique. Chaque réponse nécessite 3 à 6 recherches dans plusieurs fichiers.
| Boucle d’outils, 12 exécutions chacune | Réussites | Nombre médian de tours | Appels d’outils par exécution | Coût par exécution | Temps écoulé médian |
|---|---|---|---|---|---|
| Sonnet 5.5, par défaut | 12 / 12 | 3 | 4.8 | $0.0112 | 6.7 s |
Sonnet 5.5, low | 12 / 12 | 3 | 4.9 | $0.0112 | 7.4 s |
Sonnet 5.5, medium | 12 / 12 | 3 | 5.1 | $0.0113 | 6.8 s |
Sonnet 5.5, max | 12 / 12 | 4 | 14.7 | $0.0422 | 20.1 s |
| Opus 5.5, par défaut | 12 / 12 | 4 | 5.3 | $0.0332 | 25.3 s |
| Sonnet 5, par défaut | 11 / 12 | 3.5 | 4.2 | $0.0122 | 15.8 s |
Des témoignages de clients publiés par VentureBeat font état de moins d’appels d’outils qu’avec Sonnet 5, avec un tiers d’appels en moins chez Lovable. Notre boucle est trop courte pour reproduire ce résultat : Sonnet 5.5 effectuait 4.8 appels par exécution contre 4.2 pour Sonnet 5, tout en coûtant 8% de moins et en terminant plus de deux fois plus vite.
Sonnet 5.5 est-il plus rapide ?
Il terminait plus vite principalement parce qu’il produisait moins de texte. Avec le réglage par défaut, le temps médian écoulé entre l’envoi de la requête et la réception de la réponse complète était de 3.9 secondes par tâche single-shot pour Sonnet 5.5, de 8.1 secondes pour Sonnet 5 et de 5.5 secondes pour Opus 5.5. Le nombre de tokens de sortie par seconde écoulée était presque identique pour les deux Sonnet, 88 contre 91. Le temps d’attente était divisé par deux parce que Sonnet 5.5 produisait cinq fois moins de tokens, pas parce qu’il les générait plus vite. Sur les tâches difficiles, l’écart est de 5.8 secondes contre 21.0.
Les budgets de tokens de Sonnet 5 restent-ils valables ?
Les budgets de contexte et les limites max_tokens prévus pour Sonnet 5 devraient toujours convenir. Selon le guide de migration d’Anthropic, Sonnet 5.5 utilise le même tokenizer, et les quatre textes fixes que nous avons testés (prose anglaise, code Python, arguments d’outil JSON, prose chinoise) ont donné exactement le même nombre de tokens sur les deux modèles et sur Opus 5.5, par exemple 1,270 tokens pour l’anglais et 493 pour le chinois ; Sonnet 5.5 et Opus 5.5 ajoutent 2 tokens fixes par requête. Les requêtes avec outils coûtent un peu moins en entrée : la page de tarifs d’Anthropic indique 286 tokens pour le prompt système caché d’utilisation des outils sur Sonnet 5.5, contre 354 sur Sonnet 5.
Lequel choisir ?
Pour la plupart des workloads utilisant Sonnet 5, migrez. Il reste ensuite à choisir le niveau d’effort.
| Workload | Point à surveiller | Recommandation | Chiffres |
|---|---|---|---|
| Sortie parsée par du code : extraction, classification, valeurs uniques | Calculs détaillés dans la réponse en dessous de xhigh | Sonnet 5.5 avec xhigh, ou medium en parsant la dernière ligne | résultat seul dans 39 / 39 cas avec xhigh, 24 / 39 avec medium ; xhigh coûte environ 40% de plus |
| Chat et texte destiné aux utilisateurs | Latence et coût | Sonnet 5.5 avec medium | $0.0040 par tâche, médiane de 3.9 s |
| Boucles agentiques avec outils | Multiplication des appels d’outils avec max | Sonnet 5.5 avec le réglage par défaut ou medium ; passez à Opus 5.5 avant d’utiliser Sonnet 5.5 avec max | $0.011 par exécution avec le réglage par défaut, $0.042 avec max, $0.033 avec Opus 5.5 |
| Code Sonnet 5 qui désactive le raisonnement ou force un outil | Erreur HTTP 400 après le changement de modèle | between_tools (avec high ou moins) et tool_choice: auto | Guide de migration d’Anthropic |
Quel que soit le niveau d’effort, conservez deux contrôles dans votre code : vérifiez que la réponse respecte le format attendu par votre parseur et imposez une limite de tokens de sortie par requête. Avec max, le coût par tâche a été multiplié par 3.5x sur les prompts uniques et le nombre d’appels d’outils par 3x dans la boucle.
FAQ
Sonnet 5.5 coûte-t-il moins cher que Opus 5.5 ?
Avec leurs réglages par défaut, Sonnet 5.5 coûtait 41% de moins que Opus 5.5 par tâche single-shot et trois fois moins par exécution de la boucle d’outils. Avec max, l’ordre s’inverse : Sonnet 5.5 coûtait deux fois plus cher que Opus 5.5 avec son réglage par défaut sur les tâches single-shot, et 27% de plus par exécution de la boucle d’outils.
Quel niveau d’effort utiliser avec Sonnet 5.5 ?
Sonnet 5.5 coûtait à peu près autant avec low, medium et high sur nos tâches ($0.0040 à $0.0043). medium constitue donc un bon point de départ pour le chat et les boucles d’outils. Utilisez xhigh si du code parse la réponse comme une valeur brute ; max coûtait 3.5x plus que le réglage par défaut.
Peut-on encore désactiver le raisonnement avec Sonnet 5.5 ?
Sonnet 5.5 rejette thinking: {"type": "disabled"} avec une erreur HTTP 400. Envoyez plutôt thinking: {"type": "between_tools"}, accepté avec un niveau d’effort low, medium ou high.
Mesures associées : Claude Opus 5.5 face à Opus 5, le tokenizer de Claude Sonnet 5 et les réglages de raisonnement selon les fournisseurs.
Mesures effectuées le 2026-09-29, un jour après le lancement, via une gateway vers la Messages API d’Anthropic. 702 appels single-shot évalués, avec 13 tâches dont les réponses de référence avaient été calculées par force brute, 3 répétitions, 6 niveaux d’effort et 3 modèles ; 48 appels pour tester une instruction système sur le format de sortie ; 72 exécutions de boucles d’outils, avec 4 questions multi-étapes, 3 répétitions et 6 réglages ; ainsi que le comptage des tokens de quatre textes fixes par modèle. Prompts salés avec une valeur unique ; coûts calculés à partir des tarifs publics d’Anthropic.