
Compression du contexte : en combien de tours est-elle amortie ?
Sommaire
- Quel problème cherchez-vous à résoudre avec la compression ?
- Scénario 1 : que faire quand le modèle manque de contexte ?
- Scénario 2 : faut-il compresser avant un palier tarifaire supérieur ?
- Scénario 3 : combien de tours supplémentaires pour amortir une compression ?
- La compression gaspille-t-elle le surcoût d’écriture en cache ?
- Que donne la formule d’amortissement face aux mesures ?
- Qu’est-ce qui change avec le cache implicite de DeepSeek ?
- Comment la croissance influence-t-elle le moment de la compression ?
- Quel intervalle le modèle suggère-t-il pour une tâche qui se poursuit ?
- Comment mesurer le coût complet ?
- Quelle politique déployer ?
- FAQ
- La compression du contexte réduit-elle toujours le coût API ?
- Faut-il compresser exactement au seuil tarifaire ?
- Peut-on attendre que la fenêtre de contexte soit pleine ?
- Une croissance plus rapide du contexte amortit-elle toujours un résumé plus vite ?
- Avec un cache implicite, faut-il attendre la limite de contexte ?
Sur Claude Sonnet 5.5, la compression du contexte a été amortie après 4-6 requêtes supplémentaires lors de six essais avec cache chaud, démarrant autour de 14k tokens. Cette plage mesurée est propre à la charge testée. Une politique de compression doit intégrer la génération du résumé, la facturation réelle du cache et le volume de travail restant pour amortir l’opération.
TL;DR
- Quand la fenêtre de contexte approche de sa limite, réduire le contexte actif devient une contrainte de capacité. Nos tests n’ont pas mesuré la fenêtre maximale d’un modèle.
- Après un résumé facturé au tarif supérieur, une requête atteignait presque l’équilibre ($0.0560882 contre $0.0560655 en conservant l’historique). Deux requêtes suffisaient nettement à amortir le résumé dans cet exemple.
- Une vérification rétrospective de la formule estimait l’amortissement à 4-5 tours, contre 4-6 tours mesurés. Il ne s’agissait pas d’un test prédictif.
- Une tâche de consultation d’archives en six questions a coûté $0.0156941 avec compression, contre $0.0059911 sans compression, avec 6/6 réponses correctes.
Quel problème cherchez-vous à résoudre avec la compression ?
Définissez pourquoi vous voulez réduire le contexte avant de choisir un seuil de tokens. Une limite stricte de contexte, un palier tarifaire supérieur et une conversation simplement longue appellent des décisions différentes.
La compression du contexte remplace les anciens échanges par une représentation plus courte, utilisée dans les requêtes suivantes. Nos expériences reposaient sur des résumés textuels côté client : un appel ordinaire au modèle produisait un résumé, puis l’application remplaçait l’historique précédent par ce texte. Les fonctions natives de compression avec signature ou chiffrement ont d’autres contrats de requête et de comptabilisation de l’usage.
| Situation | Objectif principal | Quand intervenir ? | Éléments présentés dans cet article |
|---|---|---|---|
| La fenêtre de contexte du modèle approche de sa limite | Permettre à la tâche de continuer | Garder assez de marge pour la prochaine entrée, le résultat d’outil et la sortie | Limites documentées du modèle et règle d’exploitation, sans test de la fenêtre maximale |
| Un palier tarifaire supérieur approche | Réduire le coût de la charge complète | Les économies tarifaires attendues dépassent le coût du résumé et de la poursuite | Une petite expérience sans cache sur les paliers tarifaires |
| La fenêtre et le palier tarifaire laissent de la marge | Améliorer une charge donnée | Il reste assez de travail utile pour amortir le résumé sans perdre l’état nécessaire | Des essais appariés de conservation d’état avec cache et une courte tâche sur des archives |
Scénario 1 : que faire quand le modèle manque de contexte ?
Réduisez ou réorganisez le contexte actif avant qu’une requête puisse dépasser la fenêtre prise en charge. À ce stade, conserver l’intégralité des échanges peut ne plus être une option viable.
Les spécifications de Claude Haiku 5.5 annoncent une fenêtre de 1M tokens et une sortie maximale de 128K pour Claude Haiku 5.5. Ce sont les limites publiées. Nous n’avons pas testé le contexte maximal accepté sur notre route de gateway, et l’expérience tarifaire ci-dessous ne permet pas de l’établir.
Réservez de la place pour la prochaine entrée, le résultat d’outil et la sortie requise par le service. Déclenchez la compression tant que la requête de résumé tient encore dans la fenêtre. Conservez l’état essentiel dans un résumé ou dans une source récupérable, puis évaluez la réussite de la suite de la tâche. Un rejet pour dépassement de fenêtre n’est pas une exécution réussie moins chère à prendre comme référence.
Scénario 2 : faut-il compresser avant un palier tarifaire supérieur ?
Compressez si le travail restant permet d’amortir le résumé aux tarifs réellement appliqués. Le franchissement d’un seuil tarifaire peut rendre la compression intéressante, mais le résumé lui-même peut être facturé au tarif supérieur.
Les tarifs de Claude Haiku 5.5 changent au-delà de 100,000 tokens d’entrée. Les tarifs standard d’entrée et de sortie, vérifiés le 4 novembre 2026, sont de $0.10/$0.50 par million de tokens jusqu’à cette limite, puis de $0.50/$2.50 au-delà.
Nous avons envoyé différents registres de bibliothèque fictifs via la gateway Synthorai. Une requête de 94,350 tokens d’entrée a coûté $0.009437 ; une autre de 111,999 tokens a coûté $0.0560095. Les deux ont généré quatre tokens de sortie. L’écart de coût tient à la fois à la longueur de l’entrée et au palier tarifaire.
Nous avons ensuite résumé l’historique le plus long. Cet appel a traité 112,028 tokens d’entrée, sans cache hit signalé, pour un coût de $0.0560715 au tarif supérieur. Les deux approches ont répondu correctement aux questions sur les quantités et leurs sources.
| Requêtes restantes | Historique conservé | Résumé puis requêtes à contexte réduit | Historique conservé, recalculé au tarif inférieur | Compression, recalculée au tarif inférieur |
|---|---|---|---|---|
| 1 | $0.0560655 | $0.0560882 | $0.0112131 | $0.0112310 |
| 2 | $0.1120760 | $0.0560944 | $0.0224152 | $0.0112372 |
Avec une requête, les deux approches étaient presque à l’équilibre : l’écart était de $0.0000227. Avec deux requêtes, le résumé était nettement amorti dans cet exemple. Recalculer tous les tokens au tarif inférieur permet de distinguer l’effet du volume de celui du tarif.
Ces requêtes sans cache décrivent une seule tâche synthétique. Un historique déjà en cache se comporte autrement. Vérifiez la marge sous le seuil après le résumé, puis le moment où les nouvelles entrées le franchiront à nouveau ; voir les paliers tarifaires des longs contextes.
Scénario 3 : combien de tours supplémentaires pour amortir une compression ?
Nous avons mesuré 4-6 tours supplémentaires sur Claude Sonnet 5.5, lors de six essais avec cache démarrant avec environ 13.5k-14.2k tokens d’entrée. Un tour désigne ici une requête ultérieure au modèle. L’expérience comptabilisait la génération du résumé et les écritures en cache suivantes, puis cherchait le premier point d’amortissement parmi les douze requêtes suivant la mise en cache initiale commune. Dans les six essais, une fois ce point atteint, la compression n’est jamais redevenue plus chère jusqu’à la requête 12. Ce résultat ne couvre ni une expiration ultérieure du cache, ni un autre résumé, ni un changement de tâche.
La compression gaspille-t-elle le surcoût d’écriture en cache ?
Les écritures déjà payées sont des coûts irrécupérables au moment de la décision. Il faut déterminer si la réduction des lectures futures couvre la requête de résumé et les nouvelles écritures. Ces expériences utilisaient une mise en cache explicite de cinq minutes. Les caches implicites ont des tarifs propres à chaque fournisseur et n’appliquent pas nécessairement le même surcoût d’écriture.
Un essai à croissance moyenne montre la différence entre une première intervention et un autre résumé plus tard dans la session :
| Intervention | Coût des lectures futures évité | Écritures supplémentaires pendant la suite | Coût de génération du résumé | Bilan au tour 12 |
|---|---|---|---|---|
| Premier résumé, par rapport à la conservation de l’historique | $0.0159875 | $0.0010175 | $0.0049761 | $0.0099939 de moins |
| Deuxième résumé, par rapport à un seul résumé | $0.0037283 | $0.0013925 | $0.0065302 | $0.0041844 de plus |
La deuxième ligne inclut une baisse de $0.0000100 sur les autres tokens. Le coût des résumés comprend leurs propres catégories de facturation du cache : ne les comptez pas deux fois. Les catégories de tokens ne permettent pas d’identifier les entrées individuelles qui n’ont jamais été réutilisées.
Que donne la formule d’amortissement face aux mesures ?
Un modèle simple avec cache chaud estime le nombre de tours nécessaires. Soit H le nombre de tokens d’historique remplacés, S le nombre de tokens d’entrée du résumé de remplacement, A le coût total de la requête de résumé, r le prix par token lu en cache et w le prix par token écrit en cache. Conservez les instructions inchangées avant l’historique remplacé.
Sur n requêtes futures, conserver l’historique coûte n*r*H. Le remplacer coûte A + w*S + (n-1)*r*S. La différence de coût est :
compact cost minus retain cost
= A + (w-r)*S - n*r*(H-S)

payback turns
= ceil((A + (w-r)*S) / (r*(H-S)))
La formule suppose H > S, une éligibilité immédiate au cache, des tarifs inchangés et les mêmes ajouts, sorties et appels d’outils par la suite. Elle ne couvre pas l’expiration du cache, les réécritures supplémentaires du préfixe conservé ni les coûts de correction d’une perte de qualité. Si ces paramètres changent, calculez les coûts par segments.
Nous avons appliqué la formule rétrospectivement, après les expériences. Le calcul utilise les relevés de mise en cache initiale et de résumé, et non les coûts des requêtes suivantes, mais les résultats étaient déjà connus. C’est une vérification a posteriori, pas une validation sur des données réservées ou sur des essais futurs. L’analyse approxime H par l’entrée totale de la mise en cache initiale et S par les tokens de sortie du résumé. Ces valeurs diffèrent de l’historique exactement remplaçable et de l’entrée de remplacement à cause des instructions stables, de l’habillage des requêtes et des conditions d’éligibilité au cache.
| Croissance des entrées | Essai | Estimation rétrospective | Amortissement mesuré |
|---|---|---|---|
| Environ 96 tokens/tour | 1 | 5 tours | 6 tours |
| Environ 96 tokens/tour | 2 | 5 tours | 6 tours |
| Environ 1.4k tokens/tour | 1 | 5 tours | 5 tours |
| Environ 1.4k tokens/tour | 2 | 4 tours | 4 tours |
| Environ 5.2k-5.5k tokens/tour | 1 | 5 tours | 5 tours |
| Environ 5.2k-5.5k tokens/tour | 2 | 4 tours | 5 tours |
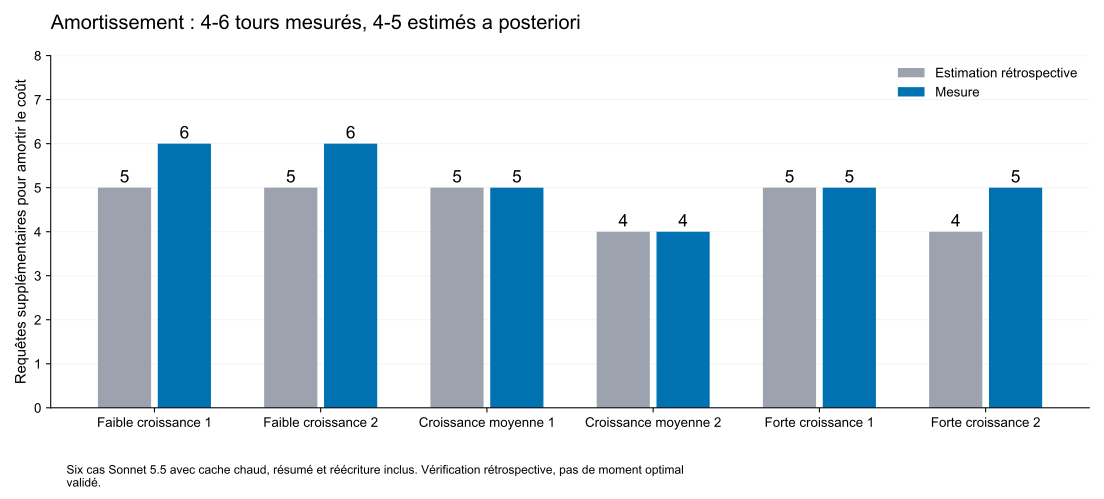
L’erreur de cette vérification ne dépassait pas un tour sur ces six essais. Pour prendre une décision future, il faut estimer A et S à partir de résumés précédents et valider sur de nouvelles tâches. Cette comparaison n’apporte aucune garantie générale sur l’erreur.
Qu’est-ce qui change avec le cache implicite de DeepSeek ?
L’absence de frais d’écriture distincts ne rend pas l’entrée gratuite après compression. DeepSeek V4.1 Flash 1017 utilise une mise en cache automatique, avec des tarifs d’entrée différents selon que les tokens sont présents ou absents du cache. Sa page de tarifs ne mentionne pas de frais d’écriture distincts. Un nouveau préfixe de résumé est tout de même facturé au tarif des entrées hors cache tant qu’il n’est pas en cache.
La documentation du cache exige une correspondance avec les unités de préfixe persistées. La construction prend quelques secondes et les hits ne sont pas garantis : le remplacement peut donc provoquer des miss sur plusieurs requêtes. Suivez prompt_cache_hit_tokens et prompt_cache_miss_tokens. Ne supposez ni un seul appel à froid, ni un hit systématique sur un préfixe système inchangé.
Soit p le prix par token d’entrée hors cache et m le nombre de requêtes à froid sur le préfixe de remplacement parmi les n requêtes futures. Si l’historique de référence reste en cache et que les coûts communs ultérieurs s’annulent :
compact cost minus retain cost
= A + m*(p-r)*S - n*r*(H-S)
Pour une requête à froid, remplacez w par p, pas par zéro. Si m est inconnu, calculez plusieurs scénarios ou utilisez les catégories de hits et de miss effectivement facturées, en incluant les miss du préfixe stable et de l’appel de résumé.
Ce qui suit est un calcul à partir de la formule, pas une expérience sur DeepSeek. Prenons les tarifs officiels Flash en heures creuses : $0.003/M pour les entrées en cache, $0.15/M pour les entrées hors cache et $0.60/M pour les sorties. Supposons un résumé de 1k tokens, un historique initial déjà en cache, une seule requête de remplacement à froid et un coût de résumé A = r*H + output_price*S. Ignorons l’habillage, le raisonnement et les outils.
| Historique initial | Coût supposé de l’appel de résumé | Amortissement calculé |
|---|---|---|
| 10k tokens | $0.000630 | 29 requêtes |
| 100k tokens | $0.000900 | 4 requêtes |
Des lectures peu coûteuses peuvent favoriser la conservation d’un historique court en cache, tandis qu’une tâche plus longue peut amortir la compression. La qualité et l’amortissement sur DeepSeek n’ont pas été mesurés. Refaites le calcul pour les tarifs de pointe ou les sessions mêlant plusieurs tarifs.
Comment la croissance influence-t-elle le moment de la compression ?
La croissance modifie la taille de l’historique au moment de la décision. Si j tours s’écoulent avant l’intervention et que chacun ajoute g tokens, utilisez H_j = H_0 + g*j dans la formule d’amortissement, avec la taille et le coût actuels du résumé.
Une croissance identique après l’intervention ajoute des coûts communs aux deux approches. À tarifs et comportement du cache constants, ces termes s’annulent. Une croissance plus rapide fait atteindre plus tôt les contraintes de capacité ou de tarif, mais ne détermine pas à elle seule le nombre de tours d’amortissement.
Dans nos tests de croissance, l’état essentiel restait petit tandis que les données d’archive s’accumulaient. Sur les deux essais de douze tours, répéter la compression coûtait plus cher qu’un seul résumé à croissance moyenne, mais moins cher à forte croissance. Toutes les politiques ont répondu correctement à 96/96 questions sur l’état, extension comprise. Cela ne teste pas une croissance illimitée de l’état essentiel.
Quel intervalle le modèle suggère-t-il pour une tâche qui se poursuit ?
Pour une tâche longue dont la croissance, la taille du résumé, les tarifs et le comportement du cache restent à peu près constants, soit F le coût fixe par cycle de compression, incluant la sortie du résumé et la réécriture du remplacement. Excluez les coûts linéaires en fonction de l’intervalle : leur contribution amortie par tour est constante. Si le modèle chargé du résumé lit l’historique depuis le cache, estimez F par A - r*H + w*S. Une autre tarification exige une décomposition adaptée. Si g est la croissance par tour et k l’intervalle entre les résumés, le coût moyen dépendant de l’intervalle est :
average interval-dependent cost = F/k + r*g*(k-1)/2
candidate interval k = sqrt(2*F/(r*g))
candidate history threshold = S + g*k
Ce modèle exige des valeurs positives pour F, r et g, de petits résumés conservés et une qualité comparable sur la tâche. Sans croissance, il n’y a pas de déclenchement périodique lié à l’accumulation ; avec des lectures gratuites, ce modèle ne fournit aucun amortissement par les économies de lecture. Avec nos tarifs de cache explicite et nos tailles de résumé, il propose des intervalles proches de 30, 7-8 et 4 tours pour les croissances faible, moyenne et forte. Testez les entiers voisins, avec au moins une requête et assez de marge dans la fenêtre. Aucun balayage des intervalles n’a établi que ces valeurs étaient optimales. Un cache facturé selon les miss exige sa propre décomposition des coûts fixes.
Un exemple chiffré précise les unités. Un essai enregistré à croissance moyenne donnait A = $0.0049761, H = 13,712, S ≈ 341 et g ≈ 1,396 tokens/turn. Avec r = $0.10/M et w = $2.50/M, on obtient :
F ≈ 0.0049761 - (0.10/1,000,000)*13,712
    + (2.50/1,000,000)*341
  = $0.0044574 per cycle

k ≈ sqrt(2*0.0044574 / ((0.10/1,000,000)*1,396))
  ≈ 8 requests
Ce calcul propose un intervalle à partir de valeurs enregistrées. Il ne démontre pas qu’une politique de huit requêtes est optimale. La vérification sur un horizon fini reste distincte : si une intervention doit être amortie après cinq requêtes et qu’il n’en reste que trois, évitez cette intervention facultative, même si le déclencheur périodique indique qu’elle est due.
Lorsqu’une tâche approche de sa fin, évitez un résumé facultatif supplémentaire s’il ne peut pas être amorti sur les requêtes restantes. La capacité, les paliers tarifaires et la conservation des informations nécessaires priment sur ce modèle monétaire simplifié.
Une courte tâche sur des archives illustre ce filtre. Les deux stratégies ont répondu correctement aux six questions de quantité, mais conserver l’historique a coûté $0.0059911, contre $0.0156941 avec un résumé. Six requêtes n’ont pas amorti cette intervention. Le résumé avait conservé assez de détails ; aucune recherche supplémentaire n’a été nécessaire. Le délai d’amortissement dépend du résumé et de la charge réels, pas d’une règle universelle de quatre à six tours.
Comment mesurer le coût complet ?
Incluez le résumé, la première requête réécrite et toutes les requêtes suivantes. La réduction des tokens du prompt et le pourcentage de cache hits ne suffisent pas à établir une économie.
Pour Claude Sonnet 5.5, nos calculs utilisaient $2/M pour les nouvelles entrées, $2.50/M pour les écritures en cache de cinq minutes, $0.10/M pour les lectures en cache et $10/M pour les sorties. Les lectures en cache sont peu chères, mais pas gratuites. Remplacer un historique déjà en cache peut provoquer une nouvelle écriture, tandis qu’un résumé très court peut ne pas être éligible au cache. Nos points de coupure explicites dans les blocs de contenu ont produit des écritures et des lectures mesurables ; certains préfixes courts après compression ne signalaient initialement ni l’une ni l’autre.
Cette fonction suppose un nombre donné de requêtes dont le préfixe est à froid. Passez le prix d’écriture explicite ou le prix d’entrée hors cache implicite dans cold_input_per_million :
import math


def payback_turns(summary_cost, history_tokens, summary_tokens,
                  read_per_million=0.10, cold_input_per_million=2.50,
                  cold_requests=1):
    if cold_requests < 0 or int(cold_requests) != cold_requests:
        raise ValueError("cold_requests must be a nonnegative integer")
    r = read_per_million / 1_000_000
    p = cold_input_per_million / 1_000_000
    if summary_cost < 0 or p < r:
        raise ValueError("Unsupported cost assumptions")
    if history_tokens <= summary_tokens or r <= 0:
        return None
    upfront = summary_cost + cold_requests * (p - r) * summary_tokens
    saving_per_turn = r * (history_tokens - summary_tokens)
    return max(1, cold_requests, math.ceil(upfront / saving_per_turn))
Pour décider avant la compression, estimez le coût du résumé à partir d’appels précédents. Validez avec les relevés d’usage complets, échecs et corrections compris. Un relevé manquant ne signifie pas une requête gratuite.
Les mesures ont été effectuées le 4 novembre 2026 via l’interface Messages de la gateway, avec le mode thinking désactivé et sans outils hébergés. Les réponses ordinaires étaient limitées à 128 tokens de sortie et les résumés à 2,048. Les coûts ont été reconstitués à partir de l’usage retourné aux tarifs standard, puis vérifiés par rapport aux coûts signalés par la gateway. Il ne s’agit pas d’un rapprochement avec les factures du fournisseur. Les charges ordinaires utilisaient des résumés côté client, pas une implémentation native de compression.
Quelle politique déployer ?
Appliquez d’abord les contraintes de capacité et de tarif, en gardant de la marge pour les entrées, les outils et les sorties. Pour les charges avec cache explicite sur Claude Sonnet 5.5, comptez les surcoûts d’écriture et les frais de résumé. Évitez les interventions facultatives qui ont peu de chances d’être amorties avant la fin. Validez les intervalles entiers proches de la valeur analytique sur les mêmes arrivées de tâches et les mêmes tours de fin.
Pour le cache implicite de DeepSeek V4.1 Flash 1017, conservez un préfixe utile si les hits sont stables et qu’il reste peu de travail. Un déclenchement préventif plus tardif peut être raisonnable ; l’absence de frais d’écriture distincts ne justifie pas d’attendre la limite stricte. Pour les tâches plus longues, estimez les coûts réels des hits et des miss, puis surveillez les requêtes après réécriture jusqu’à l’apparition de hits.
Refaites les calculs quand les tarifs, l’état du cache, le modèle ou la taille de l’état essentiel changent. Gardez des sources récupérables et validez les valeurs modifiées dans les tâches où les détails comptent. Enregistrez le résumé et l’usage qui suit dans une même session d’agent, avec les bonnes catégories de tokens.
FAQ
La compression du contexte réduit-elle toujours le coût API ?
Les économies doivent dépasser les coûts du résumé, de reconstruction du cache et de correction. Notre tâche d’archives en six questions a coûté $0.0156941 avec un résumé, contre $0.0059911 en conservant l’historique, avec 6/6 réponses correctes dans les deux cas.
Faut-il compresser exactement au seuil tarifaire ?
Un seuil tarifaire est un point où évaluer l’ensemble du travail restant, pas un ordre automatique de résumer. Dans notre exemple sur Claude Haiku 5.5, le résumé lui-même a été facturé au-delà de 100,000 tokens. Une requête ultérieure atteignait presque l’équilibre ; deux l’amortissaient nettement.
Peut-on attendre que la fenêtre de contexte soit pleine ?
Gardez de la place pour la requête de résumé, la prochaine entrée ou le résultat d’outil, et la sortie. Un historique déjà trop volumineux peut ne plus tenir dans une requête de résumé. Nous n’avons pas mesuré la limite exacte de rejet à la taille maximale de fenêtre.
Une croissance plus rapide du contexte amortit-elle toujours un résumé plus vite ?
Une croissance plus rapide commune aux deux stratégies augmente leurs coûts sans accroître automatiquement les économies d’un résumé. Répéter la compression peut limiter l’accumulation, mais ajoute des coûts de résumé et de réécriture. Dans nos essais à croissance moyenne, répéter la compression coûtait plus cher qu’un seul résumé sur douze tours ; les essais à forte croissance favorisaient la répétition. Choisissez une politique en fonction de la croissance, de l’horizon restant et de l’état à conserver.
Avec un cache implicite, faut-il attendre la limite de contexte ?
Sur une tâche courte, le cache implicite peut favoriser la conservation d’un historique déjà en cache et peu coûteux. DeepSeek V4.1 Flash 1017 facture toujours au tarif hors cache un préfixe de résumé non mis en cache, et sa persistance n’est pas garantie. Estimez le bénéfice restant, puis gardez une marge pour les outils, les entrées et les sorties avant la limite de la fenêtre prise en charge. Les valeurs DeepSeek ci-dessus sont des calculs, pas des seuils mesurés.