
Cache de prompts : cinq vérifications avant le routage
Sommaire
- Que vérifier en premier quand le cache ne répond plus ?
- Quels paramètres applicatifs et quels délais vérifier ?
- Que peut modifier un gateway entre le client et le fournisseur ?
- Comment examiner une régression du cache dans Synthorai ?
- Une session mesurée : repérer la régression, puis examiner ses spans
- Comment les diagnostics natifs repèrent-ils une requête modifiée ?
- Quand examiner le service d’inférence lui-même ?
- Comment prouver qu’une correction a fonctionné ?
- FAQ
- Ajouter cache_control garantit-il une lecture en cache ?
- Le routage peut-il provoquer un défaut de cache si le nom du modèle ne change pas ?
- Pourquoi les diagnostics signalent-ils une modification alors que des tokens ont été lus en cache ?
Pour diagnostiquer un défaut de cache de prompts, vérifiez d’abord les données d’usage, puis le préfixe réutilisable, son éligibilité, les délais et la destination amont réelle. Comparez chaque point à une requête de référence dont le cache était bien chaud.
TL;DR
- L’absence de données d’usage du cache ne permet pas de conclure. Un nombre de tokens lus égal à zéro n’en indique pas la cause.
- Le taux de requêtes avec réutilisation compte les requêtes qui réutilisent au moins un token. Le taux de réutilisation des tokens mesure la part de l’entrée réutilisée.
- Chaque état de diagnostic natif appelle une action différente : corriger une divergence, remplacer une référence introuvable ou approfondir une comparaison non concluante.
- DeepSeek exige une correspondance avec des unités de préfixe persistées. Un préfixe textuel commun ne suffit pas toujours.
Que vérifier en premier quand le cache ne répond plus ?
Commencez par vérifier que la réponse brute contient bien les données d’usage du cache. Si le fournisseur signale des lectures mais que le client ou le tableau de bord n’en affiche pas, examinez d’abord la remontée des métriques. Sinon, conservez la dernière requête dont le cache était confirmé comme chaud et comparez-la à la requête en échec.
| Première vérification | Éléments à recueillir | Action minimale utile |
|---|---|---|
| Le défaut de cache est-il réel ? | Usage brut du fournisseur, réponse reçue par le client et enregistrement du tableau de bord | Vérifier les champs manquants et l’agrégation du streaming avant de modifier les prompts |
| Le préfixe a-t-il changé ? | Outils dans leur ordre d’envoi, texte système et messages précédents | Comparer les composants ; déplacer tout horodatage ou ID de requête variable après le contenu réutilisable |
| Le préfixe était-il éligible et a-t-il été écrit ? | Minimum requis par le modèle, paramètres de contrôle, usage en lecture et en écriture | Vérifier le modèle et l’API exacts ; examiner le point de coupure prévu |
| La requête est-elle arrivée trop tôt ou trop tard ? | Heure de début de réponse, intervalle entre requêtes, durée de vie du cache | Envoyer une requête de suivi séquentielle avant de tester du trafic parallèle |
| La destination a-t-elle changé ? | Modèle effectif, service, périmètre du compte et tentatives de repli | Demander à l’opérateur du gateway de comparer les tentatives amont réelles |
Calculez deux métriques explicitement nommées sur les requêtes dont les données d’usage d’entrée et de cache sont complètes :
- Taux de requêtes avec réutilisation = requêtes ayant lu plus de zéro token en cache / requêtes dont les données d’usage sont complètes.
- Taux de réutilisation des tokens = somme des tokens lus en cache / somme de tous les tokens d’entrée, y compris ceux servis depuis le cache et ceux écrits en cache.
Comptabilisez séparément les requêtes sans données d’usage et incluez les tentatives échouées dans le coût de l’incident. Une entrée qui grossit peut faire baisser le taux de réutilisation des tokens sans modifier le taux de requêtes avec réutilisation.
| API native | Champ des tokens lus en cache | Total d’entrée utilisé au dénominateur du taux de réutilisation |
|---|---|---|
| OpenAI Responses | usage.input_tokens_details.cached_tokens | usage.input_tokens, qui inclut déjà l’entrée servie depuis le cache |
| Anthropic Messages | usage.cache_read_input_tokens | input_tokens + cache_read_input_tokens + cache_creation_input_tokens dans usage |
| DeepSeek | usage.prompt_cache_hit_tokens | prompt_cache_hit_tokens + prompt_cache_miss_tokens dans usage |
Si les champs natifs ont été convertis, utilisez le schéma normalisé du gateway. La formule pour Synthorai figure plus bas.
Quels paramètres applicatifs et quels délais vérifier ?
Cherchez ce qui a pu changer avant la fin du préfixe censé être réutilisable : horodatages système, ordre des outils et historique réécrit sont de bons points de départ.
Modification du préfixe. Relevez des empreintes distinctes (des hachages servant à détecter les changements) pour les définitions d’outils ordonnées, le texte système stable et les blocs de messages précédents. Placez les marqueurs propres à chaque requête à la fin. Le hachage de la requête entière change dès qu’une conversation s’allonge par simple ajout de messages ; il ne permet pas de localiser la première différence. Les espaces du JSON hors des champs texte sont aussi à distinguer des espaces présents dans une chaîne visible par le modèle.
Examinez l’emplacement du contenu récupéré, les changements de mode, la compaction et la requête finale produite par le framework. Pour les entrées multimodales, comparez le prétraitement et les références de fichiers.
Éligibilité et paramètres de contrôle. Un point de coupure marque la fin d’un préfixe pour lequel une mise en cache est demandée. Le TTL est la durée de vie configurée de l’entrée de cache.
Une requête longue ne garantit pas que le préfixe réutilisable choisi atteint le minimum requis par le modèle. Avec des points de coupure explicites, vérifiez le contenu qui les précède. Ajouter cache_control ne rend pas réutilisable un préfixe qui ne remplit pas les critères. Chez Anthropic, examinez les contrôles automatiques et ceux définis au niveau des blocs, les conflits de TTL et les limites de points de coupure. Une combinaison invalide peut provoquer une erreur HTTP 400, donc un rejet de la requête, plutôt qu’une réponse réussie avec zéro lecture en cache. Mise en cache de prompts chez Anthropic.
Disponibilité et expiration. Une rafale de requêtes identiques envoyée avant que la première écriture soit disponible peut produire plusieurs requêtes à froid. Anthropic indique que le cache devient disponible après le début de la première réponse. Envoyez une requête de suivi après ce début de réponse pour établir une référence à chaud, puis comparez les requêtes parallèles à partir de leurs heures de début de réponse. Pour une conversation inactive, comparez l’intervalle écoulé à la durée de vie configurée du cache et au comportement de rafraîchissement documenté. Disponibilité du cache Anthropic.
Unités persistées de DeepSeek. DeepSeek recherche une correspondance avec des unités de préfixe persistées complètes, c’est-à-dire des portions de contexte antérieur enregistrées. L’exemple de sa documentation commence par A+B, suivi de A+C : la deuxième requête ne peut pas réutiliser l’unité complète A+B. Une fois que le service a détecté et persisté le préfixe commun A, une troisième requête A+D peut réutiliser cette unité. Ici, A représente le contexte stable, tandis que B, C et D sont des suffixes différents. Ce mécanisme est décrit par le fournisseur ; il ne s’agit pas d’une mesure de notre part.
Pour tester ce schéma, conservez A à l’identique, terminez les deux premières requêtes séquentielles, prévoyez quelques secondes pour la persistance, puis examinez les champs de tokens servis ou non depuis le cache dans la troisième requête. Attendre ne suffit pas à garantir la création de l’unité de préfixe commun souhaitée, et la mise en cache reste sans garantie. Règles de persistance de DeepSeek.
Que peut modifier un gateway entre le client et le fournisseur ?
Un gateway peut modifier à la fois la requête effective et les informations renvoyées au client. Vérifiez ces deux aspects séparément avant d’attribuer une régression au routage.
Vérifiez les alias de modèles, le périmètre des identifiants d’accès, les surcharges de politique et les tentatives de repli. En cas de conversion de protocole, examinez les paramètres de contrôle sortants et les champs natifs renvoyés. Pour le streaming, comparez les événements d’usage amont à l’usage final reçu par le client.
Changement de fournisseur d’inférence. La répartition de charge ou le basculement peut faire passer un même modèle public d’un fournisseur d’inférence à un autre, chacun disposant de son propre cache. Un préfixe chargé chez le fournisseur A n’est alors pas disponible chez le fournisseur B. Notre étude des changements de fournisseur a observé neuf destinations amont et 4/20 requêtes avec réutilisation, contre 19/20 dans la comparaison sur un seul backend. Ces résultats décrivent cette configuration passée.
Regroupez les tentatives par fournisseur, modèle et périmètre de compte. Dans chaque groupe, comparez les lectures en cache avec des préfixes et des intervalles stables, en incluant les échecs et les destinations de repli. Demandez à l’opérateur de vérifier l’affinité (le routage cohérent des requêtes liées) et le basculement. Répétez l’essai après un ajustement approuvé. Un changement de fournisseur établit une dérive de destination ; chaque défaut de cache exige encore de vérifier les délais et l’éligibilité.
Les requêtes Synthorai ne proposent pas de sélecteur de fournisseur ou de canal.
Comment examiner une régression du cache dans Synthorai ?
Utilisez Analytics pour les tendances de la charge de travail et Logs pour les requêtes. Les libellés ont été vérifiés dans l’interface le 6 novembre 2026.
- Délimitez la charge de travail. Dans Analytics, sélectionnez
Time rangeetAll keys · all models. Dans Logs, utilisezAdd filteravecmodeloukey. Gardez les mêmes sélections pour les périodes normales et affectées.CACHE HITest un taux de réutilisation des tokens, pas un taux de requêtes avec réutilisation. - Examinez la requête. Dans
Overview, comparez les valeurs d’entrée, de lecture en cache, de sortie et les écritures applicables dansCost at your rate. Des lectures stables avec une entrée croissante suggèrent un contexte qui s’allonge ; des lectures en baisse et des écritures en hausse invitent à vérifier le préfixe et les délais.Rawcontient les champs stockés, pas la réponse originale du fournisseur. - Suivez la trace et la session. Depuis la requête affectée dans Logs, sélectionnez
Open trace, puisOpen session. DansTraces in this session, comparez les tâches et ouvrez la trace sans réutilisation. Cliquez sur chaque span (une opération individuelle) pour examiner les lectures et écritures en cache ainsi que les frais ; le diagramme en cascade seul ne montre pas la réutilisation du cache. Utilisez les filtressessionoutracede Logs pour retrouver les enregistrements sous-jacents. Conservez les liens, les horodatages et les ID de réponse natifs pour l’escalade.
Envoyez un X-Session-Id par conversation, un X-Trace-Id par tâche et un X-Span-Id par opération. Regroupez les requêtes par modèle et par préfixe censé être partagé avant d’interpréter les tendances du cache.
La corrélation et le routage sont distincts : X-Session-Id est aussi prioritaire sur la clé de cache du corps de requête pour l’affinité du gateway ; X-Trace-Id sert uniquement à regrouper les observations. Gardez une identité de session stable pendant les comparaisons. Aucun des deux ne garantit un cache partagé ou une destination fixe ; ne regroupez pas des conversations sans rapport pour chercher à obtenir des lectures en cache.
Pour les enregistrements Synthorai complets, calculez la réutilisation des tokens ainsi :
cache reads = cached_tokens + explicit_cached_tokens
input total = prompt_tokens + explicit_cached_tokens + cache_write_tokens
reuse ratio = sum(cache reads) / sum(input total)
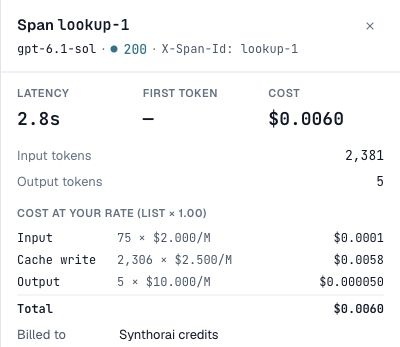
Ici, cached_tokens est déjà inclus dans prompt_tokens ; l’ajouter à nouveau compterait deux fois une partie de l’entrée. Les écritures en cache appartiennent au dénominateur, pas au numérateur. Excluez les enregistrements sans données d’usage et indiquez leur nombre séparément. Un zéro stocké ne prouve pas à lui seul que le fournisseur amont a mesuré et renvoyé zéro.
Une session mesurée : repérer la régression, puis examiner ses spans
À la suite de notre analyse des coûts d’un agent, nous avons envoyé six requêtes Responses séquentielles via Synthorai le 6 novembre 2026, avec GPT-6.1 Sol. Une session contenait trois traces, chacune avec deux appels nommés lookup-1 et lookup-2. Ces noms désignent des appels synthétiques au modèle ; aucun outil de recherche n’a été exécuté. Le modèle, les outils et l’ID de session sont restés fixes. Pour provoquer la régression, chaque requête recevait en tête une nouvelle valeur de type horodatage ; la correction rétablissait le préfixe original. Les marqueurs de requête sont restés à la fin.
| Trace | Tokens d’entrée | Tokens lus en cache | Réutilisation | Coût déclaré |
|---|---|---|---|---|
| référence | 4,729 | 2,273 | 48.1% | $0.0063923 |
| régression | 4,764 | 0 | 0% | $0.0119350 |
| correction | 4,732 | 4,546 | 96.1% | $0.0009446 |
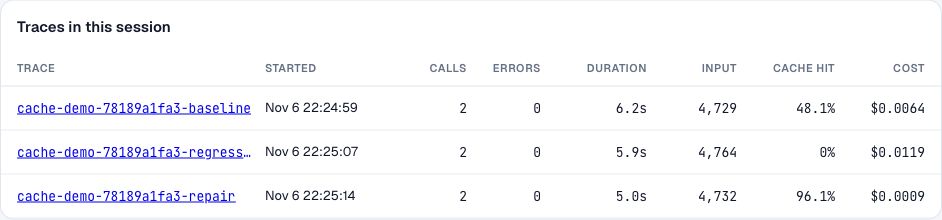
Dans Traces in this session, ouvrez la ligne de régression sans réutilisation. La référence inclut un premier appel à froid ; la correction réutilise un préfixe déjà chaud. Cette démonstration en six appels montre la panne injectée et le rétablissement, pas un taux d’économies attendu en production. La réutilisation sur toute la session est de 6,819 / 14,225 = 47.9% ; cette moyenne masque la régression.
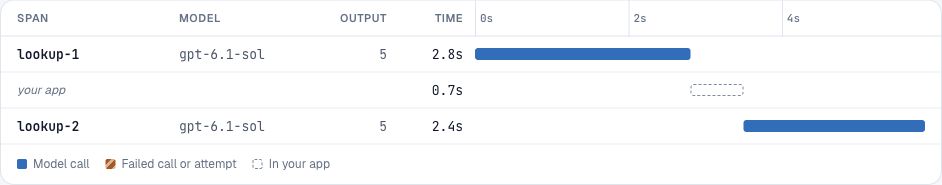
Sélectionnez lookup-1 dans le diagramme en cascade. Son détail affiche 2,306 tokens écrits en cache sur 2,381 tokens d’entrée, ce qui correspond à la reconstruction du préfixe modifié. Les requêtes synthétiques stockées établissent la différence injectée ; la chronologie seule ne permet pas de l’identifier. Utilisez Open in Logs pour accéder à l’enregistrement de la requête et comparez les empreintes de préfixe côté application.
Cette démonstration n’a pas demandé de comparaisons diagnostiques natives. La modification injectée dans le préfixe et l’usage déclaré établissent la régression observée et le rétablissement ; la continuité du fournisseur réel n’a pas été vérifiée indépendamment. L’identité de session est restée fixe : l’expérience ne mesure donc pas le bénéfice de l’affinité.
Pour le BYOK, distinguez le coût déclaré par le fournisseur du coût estimé avant de rapprocher les factures. Demandez à l’opérateur les éléments manquants sur les destinations et les replis.
Comment les diagnostics natifs repèrent-ils une requête modifiée ?
Les diagnostics natifs identifient les différences entre requêtes ; les données d’usage mesurent la réutilisation déclarée. Lisez-les ensemble. Le chemin choisi dans le gateway doit prendre en charge les champs natifs et les préserver. Notre précédent test de comparaison via Synthorai n’a renvoyé aucun diagnostic : la documentation du fournisseur ne suffit donc pas à établir leur disponibilité via le gateway.
OpenAI Responses accepte prompt_cache_options.comparison_response_id sur les modèles compatibles. Conservez l’ID de la réponse de référence terminée et envoyez le contenu réel de la requête suivante ; la référence de comparaison ne charge pas l’historique de conversation. Les résultats apparaissent dans prompt_cache_diagnostics, y compris dans l’événement response.completed en streaming. Utilisez les états ci-dessous pour choisir l’action suivante. Les estimations de tokens du diagnostic sont distinctes de l’usage facturé. Diagnostics du cache OpenAI.
Anthropic Messages utilise diagnostics: {"previous_message_id": null} pour activer les diagnostics sur la première requête, puis l’ID natif du message précédent sur les requêtes suivantes où ils sont activés. En streaming, le résultat apparaît dans message_start. N’interprétez un résultat nul qu’après avoir vérifié que les deux requêtes avaient activé les diagnostics et que la suivante fournissait une référence réelle. Anthropic documente les diagnostics pour l’API Claude, à l’exclusion d’Amazon Bedrock et de Claude géré par Google. Diagnostics du cache Anthropic.
| API et état renvoyé | Signification | Action suivante |
|---|---|---|
OpenAI cache_hit | Aucun défaut de cache détecté par la comparaison | Lire les données d’usage pour quantifier la réutilisation ; les nouveaux tokens du suffixe peuvent encore nécessiter un traitement |
OpenAI cache_miss | Une différence classifiée a affecté la réutilisation attendue | Examiner reason, corriger le composant concerné, puis comparer à nouveau |
OpenAI comparison_response_not_found | Enregistrement de référence absent ou expiré | Choisir une réponse récente et terminée dans la même organisation |
OpenAI unavailable | Comparaison non prise en charge ou non concluante | Vérifier la compatibilité du modèle ; essayer une référence récente, puis passer aux vérifications manuelles si le problème persiste |
Anthropic diagnostics: null | Absence de divergence seulement si une comparaison valide avec diagnostics activés a eu lieu ; également renvoyé sans activation ou au premier tour | Vérifier d’abord l’activation et la référence ; si la correspondance est valide mais les lectures faibles, vérifier la disponibilité du cache |
Anthropic cache_miss_reason: null dans un objet de diagnostic | Comparaison en attente | Vérifier le tour suivant avec diagnostics activés ; ne pas classer ce résultat en attente comme un défaut de cache |
Anthropic, type de motif *_changed | Premier composant divergent identifié | Corriger ce composant et comparer à nouveau ; d’autres différences peuvent subsister plus loin |
Anthropic previous_message_not_found | Aucune empreinte de référence conservée | Vérifier l’activation sur la requête précédente, l’organisation ou l’espace de travail et le temps écoulé ; établir une nouvelle référence |
Anthropic unavailable | Aucune comparaison concluante, notamment pour certains autres changements de paramètres ou en raison des limites de comparaison | Comparer le tool_choice effectif, les paramètres de raisonnement et de sortie ainsi que les en-têtes bêta ; passer aux vérifications manuelles si le problème persiste |
| Champ de diagnostic absent sur l’une ou l’autre API | Informations manquantes | Vérifier la prise en charge par l’API et le modèle, les options de requête, la conversion et la capture des événements de streaming |
Le motif prompt_cache_key_changed d’OpenAI demande une attention particulière : les données d’usage peuvent signaler un défaut de cache sans défaut de cache physique. Vérifiez si la clé a été modifiée volontairement pour séparer les comptabilités avant d’attribuer le résultat à la disponibilité du cache. Gardez la clé stable au sein du groupe de comptabilisation prévu, tout en vérifiant son rôle dans l’affinité du gateway. Motifs de diagnostic OpenAI.
Quand examiner le service d’inférence lui-même ?
Examinez la disponibilité du cache après avoir confirmé l’éligibilité du contenu, la validité des délais, un périmètre de destination comparable et la fiabilité des données d’usage. Même dans ces conditions, une entrée inchangée ne garantit pas la présence d’une entrée de cache réutilisable.
Les causes possibles incluent l’expiration, une persistance incomplète, une pression sur la capacité et l’ordonnancement côté service. OpenAI documente les contraintes de routage et de disponibilité du cache ; un identifiant de session ne garantit pas l’accès à un worker donné. Une réutilisation partielle peut aussi signifier qu’un préfixe antérieur reste réutilisable alors que le contenu suivant doit être traité. Mise en cache de prompts chez OpenAI.
Un premier token lent ou zéro lecture en cache ne prouve pas un changement de cluster. Transmettez les ID de réponse natifs, les horodatages, les intervalles et les libellés de destination lors de l’escalade ; sans éléments fournis par le fournisseur, ne concluez pas sur le mécanisme en cause.
Les ressources de cache explicites demandent une vérification supplémentaire : contrôlez l’existence, l’expiration et le périmètre de l’objet référencé. Ne diagnostiquez pas un ID de ressource explicite périmé avec les mêmes hypothèses que pour la mise en cache automatique des préfixes.
Comment prouver qu’une correction a fonctionné ?
Comparez le trafic normal, affecté et corrigé à partir des données d’usage, des diagnostics et des destinations.
Incluez les nouvelles tentatives dans le coût. Une correction de remontée des métriques doit réconcilier l’usage natif et celui du client. Une correction du préfixe doit supprimer la différence et rétablir une réutilisation comparable. Une correction du routage doit confirmer la destination prévue et le rétablissement dans ce périmètre. Si la condition correspondante n’est pas remplie, gardez le diagnostic non résolu et poursuivez l’analyse avec les éléments restants.
FAQ
Ajouter cache_control garantit-il une lecture en cache ?
Les contrôles de cache restent soumis aux contraintes de longueur et de placement du préfixe, de disponibilité et de durée de vie. Vérifiez les exigences du modèle et les données d’usage brutes.
Le routage peut-il provoquer un défaut de cache si le nom du modèle ne change pas ?
Un nom de modèle stable côté client peut pointer vers différents fournisseurs, modèles ou périmètres de compte. Comparez les tentatives réelles avec l’opérateur du gateway à l’aide de la procédure d’analyse des changements de fournisseur.
Pourquoi les diagnostics signalent-ils une modification alors que des tokens ont été lus en cache ?
Une modification en fin de requête peut laisser un préfixe antérieur réutilisable. Examinez le composant modifié en regard du nombre absolu de tokens lus en cache. La comparaison diagnostique et la comptabilisation du cache décrivent des aspects différents de la requête.
Pour poursuivre l’analyse, consultez l’audit du cache du gateway, l’analyse des coûts d’écriture en cache et le choix du moment de la compaction.