
Prueba A/B de prompts: un despliegue al 10% detectó un coste de 1.9x
Envía el 10% del tráfico de producción a un nuevo prompt, por sesión. En la prueba recibió el 8.0% de 200 sesiones, sin cambios de versión, y costó 1.94x por llamada.
Nuestra selección
precios en vivo| Modelo | Veredicto | Precio |
|---|---|---|
| GPT-6 Luna v1 de support-answer costó $0.000110 por llamada en las 1,272 llamadas del despliegue, con una latencia mediana de 4.9 s. Con reasoning_effort none costó $0.000034. | Versión de producción en la demo | desde $0.1/M |
| DeepSeek V4.1 Flash v3, el mismo prompt en este modelo, respondió más rápido (mediana de 3.1 s), pero costó $0.000213 por llamada, 1.94 veces el coste de v1, porque generó 1.6 veces la cantidad de tokens de salida a un precio por token más alto. | Versión candidata en la demo | desde $0.3/M |
Contenido
- ¿Cómo se envía el 10% del tráfico de producción a una nueva versión?
- ¿Qué llamadas recibe la candidata?
- ¿Cómo se comparan las dos versiones?
- ¿Cambia el resultado al desactivar el razonamiento?
- ¿Las ejecuciones de prueba distorsionan la comparación?
- ¿Qué queda fuera?
- Preguntas frecuentes
- ¿Cómo hago una prueba A/B de un prompt en producción?
- ¿El despliegue gradual mantiene cada conversación en una sola versión?
- ¿Puede subir el coste de un prompt sin cambiar su texto?
- Lecturas relacionadas
Un despliegue gradual de un prompt envía parte de las llamadas de un mismo identificador a una versión candidata y mantiene el resto en producción. Así puedes comparar ambas con tráfico real antes de migrar a todos los usuarios. En la biblioteca de prompts de Synthorai se configura en la etiqueta production («v1, con v3 al 10%»). El gateway elige la versión de cada llamada según el identificador de sesión, de modo que una conversación nunca cambia de versión a mitad. En nuestra prueba, con el porcentaje al 10%, la candidata recibió 16 de 200 sesiones (8.0%) y todas mantuvieron la misma versión. La candidata usaba otro modelo, un cambio cuyo coste nadie había medido. Solo con ese 10% de tráfico, los totales por versión ya mostraban un coste por llamada 1.92 veces mayor.
TL;DR
- Con un despliegue al 10%, la candidata recibió 16 de 200 sesiones (8.0%, intervalo del 95% de 5.0 a 12.6%); al 50%, recibió 111 de 200 (55.5%).
- Las 400 sesiones de tres turnos mantuvieron una única versión del prompt, al igual que todos los usuarios finales identificados mediante
_user, el campouserdel cuerpo osafety_identifier. - La candidata, con el mismo prompt en DeepSeek V4.1 Flash en lugar de GPT-6 Luna, costó $0.000213 por llamada frente a $0.000110, con una mediana de latencia de 3.1 s frente a 4.9 s.
- Ninguna llamada fijada a
prompt_version=1llegó a la candidata: 0 de 40.
Esta guía parte de Control de versiones de prompts, donde se configuran los dos prompts y sus versiones. Desde el mismo directorio de github.com/synthorai-io/use-cases:
cd use-cases/prompt-library
python rollout.py       # 10%, then 50%, then stops the rollout
python effort.py        # each version with and without a caller-sent reasoning_effort
El despliegue se ejecutó el 19 de octubre de 2026 e hizo 1,840 llamadas; las comprobaciones del reparto por usuario final se ejecutaron el 20 de octubre. La versión en producción es v1 de support-answer, con GPT-6 Luna. La candidata es v3: el mismo texto de sistema y los mismos mensajes con DeepSeek V4.1 Flash. Solo cambia el modelo.
¿Cómo se envía el 10% del tráfico de producción a una nueva versión?
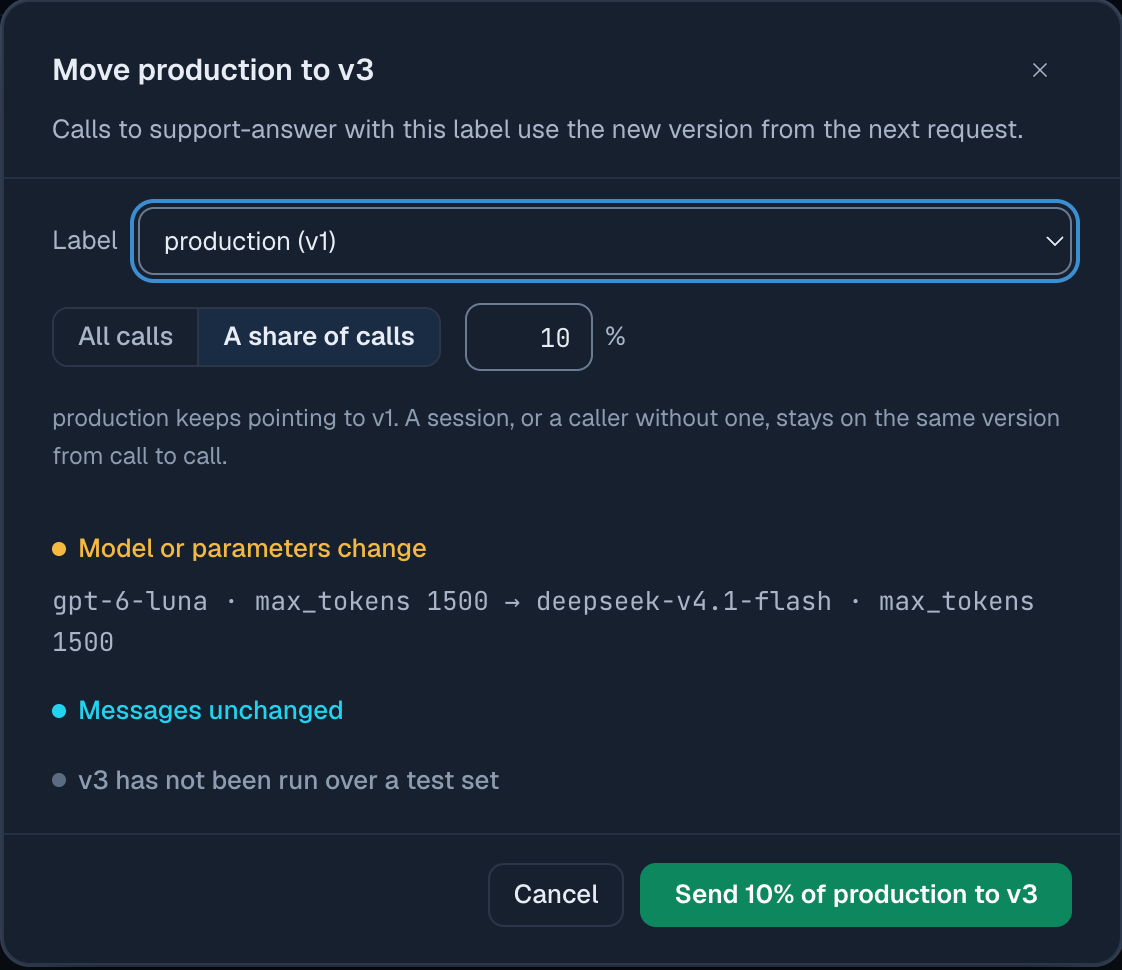
Se añade una segunda versión y un porcentaje a la etiqueta production. Con una clave de administrador basta una llamada para activarlo y otra para detenerlo:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})

admin.put("/prompts/support-answer/labels/production/rollout", json={"version": 3, "percent": 10})
# ... compare the two versions ...
admin.delete("/prompts/support-answer/labels/production/rollout")   # production is v1 only again
Para los clientes no cambia nada: siguen llamando a support-answer sin indicar versión. La cabecera de respuesta X-Synthorai-Prompt-Version indica qué versión respondió a cada llamada. Para pasar la candidata a producción, se mueve la etiqueta production a esa versión, lo que termina el despliegue gradual. En la consola, esta opción aparece como «Desplegar gradualmente» en la página de la candidata. La lista de prompts muestra entonces la etiqueta como «production v1 · v3 10%».
¿Qué llamadas recibe la candidata?
El gateway elige una versión a partir de una clave estable para cada llamada. Mientras no cambie el porcentaje, la misma clave siempre recibe la misma versión. Se utiliza el primer dato disponible de esta lista:
- El identificador de sesión (
X-Session-Id, la cabecera de Trazas de un agente LLM). - El usuario final: la etiqueta
_userdeX-Synthorai-Metadatao, si no existe,user,safety_identifierometadata.user_idde Anthropic en el cuerpo. - Si no existe ninguno: la propia solicitud, de modo que cada llamada se asigna de forma independiente.
rollout.py comprobó cada caso con porcentajes del 10% y del 50%. Cada sesión tenía 3 turnos y cada usuario final hacía 2 llamadas:
| Llamadas | Al 10%: en v3 | Al 50%: en v3 | Mantuvieron una sola versión |
|---|---|---|---|
200 sesiones, X-Session-Id | 16 = 8.0% (5.0 a 12.6%) | 111 = 55.5% (48.6 a 62.2%) | 400 de 400 sesiones |
50 usuarios finales, etiqueta _user | 6 | 27 | 100 de 100 usuarios |
| 100 llamadas sin ninguno de los dos | 11 = 11.0% (6.3 a 18.6%) | 49 = 49.0% (39.4 a 58.7%) | No procede |
20 llamadas fijadas a prompt_version=1 | 0 | 0 |
Los rangos entre paréntesis son intervalos de confianza del 95%: indican dónde es probable que se encuentre la proporción real dado ese número de ensayos. Todos incluyen el porcentaje configurado. Otra ejecución al 50% comprobó los dos campos del cuerpo: 50 usuarios identificados solo por user y 20 solo por safety_identifier, con 2 llamadas cada uno. Los 70 mantuvieron una única versión; 25 de los 50 y 8 de los 20 recibieron v3.
Esto tiene dos consecuencias para tu despliegue. El identificador de sesión mantiene la coherencia de una conversación de varios turnos, así que debes enviarlo en todas sus llamadas. Sin ninguna clave, el mismo usuario puede recibir v1 en una llamada y v3 en la siguiente. Además, una llamada que fija una versión mediante prompt_version queda fuera del despliegue gradual: una prueba o un proceso por lotes que fija una versión sigue recibiendo exactamente esa versión.
¿Cómo se comparan las dos versiones?
La página Prompts agrega llamadas, errores, gasto, tokens y latencia por versión. La API de Requests devuelve las mismas cifras con los filtros prompt_id y prompt_version. La demo las consultó tras el despliegue:
| Versión | Solicitudes | Gasto | Gasto por llamada | Mediana de latencia | Tokens de salida por llamada, media | Tokens de razonamiento por llamada, media |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | 1,272 | $0.1405 | $0.000110 | 4.9 s | 198 | 149 |
| v3, DeepSeek V4.1 Flash | 568 | $0.1208 | $0.000213 | 3.1 s | 321 | 256 |
Los tokens de razonamiento son los que genera el modelo para razonar antes de responder. Se facturan como salida y no aparecen en la respuesta.
La pestaña Llamadas del prompt muestra el mismo tipo de totales. El periodo de 7 días incluye todas las llamadas de la demo a cada versión, no solo las del despliegue, por lo que sus cifras son mayores que las de la tabla.
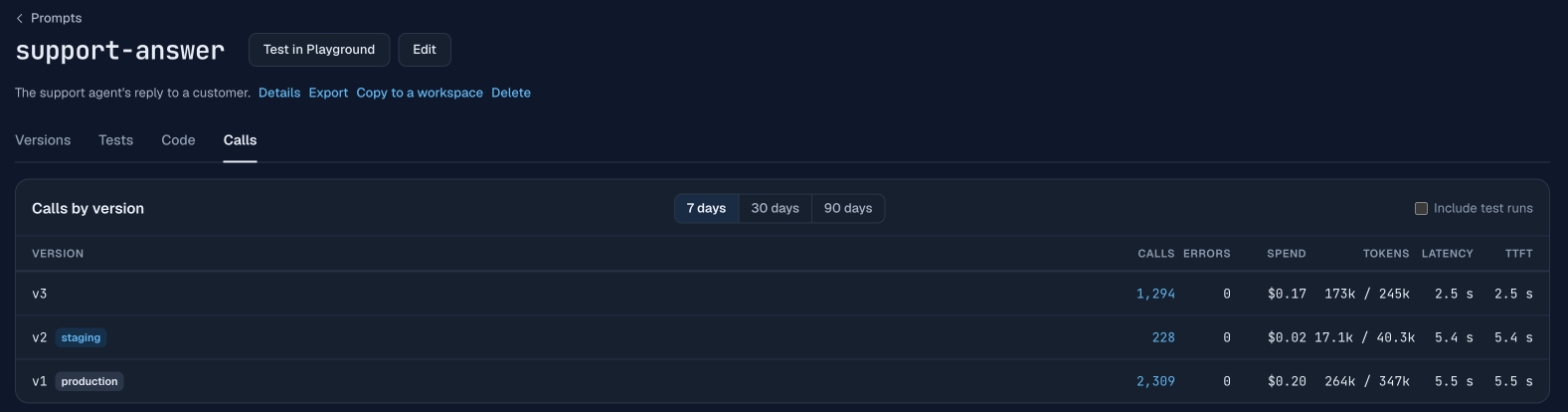
v3 es más rápida y cuesta 1.94 veces más por llamada en el conjunto de la ejecución. Hay dos causas. En este gateway, DeepSeek V4.1 Flash cuesta más por token que GPT-6 Luna: $0.15 de entrada y $0.60 de salida por millón de tokens en horario valle, frente a $0.10 y $0.50. Además, v3 generó 1.6 veces más tokens de salida. Casi toda la diferencia corresponde al razonamiento: 256 tokens por llamada frente a 149, mientras que las respuestas tenían 65 y 48 tokens, respectivamente, como medianas. Ninguna de estas cifras aparece en el texto del prompt. La diferencia ya se veía con el porcentaje al 10%: las 71 llamadas que respondió v3 costaron $0.000212 cada una, frente a $0.000111 en las 749 que respondió v1, 1.92 veces más.
El precio también depende de la hora. Todas las llamadas a DeepSeek durante el despliegue se ejecutaron en el horario valle que aplica el gateway a este modelo (de 22:00 a 08:00, hora de Pekín). Se facturaron a la mitad de la tarifa de hora punta de $0.30 y $1.20. La ejecución de 140 llamadas del 20 de octubre se hizo en hora punta. En ella, v3 costó $0.000394 por llamada frente a $0.000107 de v1, 3.7 veces más, con 66 y 74 llamadas respectivamente.
De las 1,840 llamadas, 1,839 devolvieron 200. Una agotó el tiempo de espera del cliente tras 300 s y se contabiliza como error; su sesión recibió los demás turnos.
¿Cambia el resultado al desactivar el razonamiento?
El coste de ambas versiones baja dos tercios o más, pero v3 no pasa a ser la más barata. effort.py llamó a cada versión 50 veces sin reasoning_effort y 50 veces enviando reasoning_effort: "none" desde el cliente. Usó los mensajes de clientes del conjunto de pruebas de Prueba un prompt antes de pasarlo a producción, todos con un número de pedido (40 mensajes, 10 de ellos repetidos):
| Versión | reasoning_effort | Coste por llamada | Tokens de salida, media | Mediana de latencia | La respuesta incluye el número de pedido | Se consideró que respondía a la pregunta |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | Predeterminado | $0.000107 | 192 | 4.8 s | 50/50 | 37/50 |
| v1, GPT-6 Luna | none | $0.000034 | 45 | 1.8 s | 50/50 | 35/50 |
| v3, DeepSeek V4.1 Flash | Predeterminado | $0.000200 | 300 | 3.2 s | 50/50 | 43/50 |
| v3, DeepSeek V4.1 Flash | none | $0.000049 | 55 | 1.7 s | 50/50 | 39/50 |
«none» eliminó por completo el razonamiento en ambos modelos y redujo el coste por llamada un 68% en v1 y un 75% en v3. La calidad de las respuestas se mantuvo dentro de lo que permiten observar 50 llamadas: todas siguieron incluyendo el número de pedido. La evaluación con un juez (una llamada a Claude Sonnet 5.5 que valora si la respuesta resuelve la pregunta del cliente) varió en 2 y 4 casos de 50, con valores p de 0.82 y 0.44 en la prueba exacta de Fisher. Esta prueba calcula la probabilidad de una diferencia al menos así de grande si «none» no tuviera ningún efecto; valores tan altos indican que el cambio es compatible con el azar. Con «none» en ambos modelos, v3 seguía costando 1.44 veces más por llamada que v1 ($0.000049 frente a $0.000034). Estas llamadas también se ejecutaron en el horario valle de DeepSeek en el gateway.
Durante un despliegue gradual, el cliente no sabe qué versión responderá, por lo que el reasoning_effort que envíe se aplica a ambas. También se puede guardar reasoning_effort en la propia versión. El gateway lo añade a las solicitudes de Chat Completions y Responses cuando la llamada no define el razonamiento. Una candidata guardada así usa su propia configuración durante el despliegue, y los totales por versión permiten compararlas tal como pasarían a producción.
¿Las ejecuciones de prueba distorsionan la comparación?
Por defecto, no. Los totales por versión de la página Prompts excluyen el tráfico de pruebas: las llamadas de Playground, incluidas las pruebas de la consola, y las llamadas etiquetadas con source: prompt-test o source: eval en X-Synthorai-Metadata. El interruptor «Incluir ejecuciones de prueba» permite contarlas. En support-answer, al activarlo se añadieron 150 llamadas tanto a v1 como a v2: 110 por versión de una evaluación etiquetada y 40 por versión de una prueba de consola. v3 no cambió. Los registros y la API de Requests siguen mostrando todas las llamadas, así que filtra por la etiqueta si se ejecutó una evaluación durante el despliegue:
X-Synthorai-Metadata: {"source":"eval"}¿Qué queda fuera?
- Pruebas estadísticas de coste y latencia. La tabla por versión compara totales y medias; no comprobamos estadísticamente las diferencias. Antes de tomar decisiones por una diferencia, compruébala, sobre todo si es pequeña.
- Calidad de las respuestas con tráfico real. Un despliegue gradual muestra cuánto cuesta una versión y lo rápido que responde. Es más fácil comprobar si sus respuestas son correctas con un conjunto fijo de entradas antes del despliegue; Prueba un prompt antes de pasarlo a producción lo hace con v2.
- Paradas automáticas. Nada en la demo detiene el despliegue cuando la tasa de errores o el coste de la candidata supera un límite. Un administrador cambia el porcentaje, mueve la etiqueta a la candidata o detiene el despliegue.
Preguntas frecuentes
¿Cómo hago una prueba A/B de un prompt en producción?
Añade una versión candidata y un porcentaje a la etiqueta de producción, sigue llamando al identificador del prompt como antes y compara los totales de ambas versiones. En la demo, un porcentaje del 10% envió 16 de 200 sesiones a la candidata. Tras unos cientos de llamadas, los totales ya mostraban su coste.
¿El despliegue gradual mantiene cada conversación en una sola versión?
Sí, si sus llamadas llevan un identificador de sesión. Las 400 sesiones de la demo mantuvieron una única versión durante sus tres turnos. Sin identificador de sesión se usa el identificador del usuario final; si tampoco existe, cada llamada se asigna de forma independiente.
¿Puede subir el coste de un prompt sin cambiar su texto?
Sí, al cambiar de modelo con el mismo texto, como ocurrió en la demo. La candidata con DeepSeek V4.1 Flash costó 1.94 veces más por llamada que la versión con GPT-6 Luna. En este gateway tenía un precio por token mayor y consumió más tokens de razonamiento. Compara el coste por llamada de la versión completa, no el precio del modelo.
Lecturas relacionadas
- Control de versiones de prompts: llamar a un prompt por su identificador y mover una etiqueta.
- Prueba un prompt antes de pasarlo a producción: conjuntos de pruebas y comprobaciones, con v2 frente a v1.
- ¿Por qué cuesta tanto mi agente LLM?: otras cuatro causas de una factura elevada, detectadas en las trazas.
- Guía de la biblioteca de prompts: despliegue gradual, estadísticas por versión y todos los campos.