
Versionado de prompts: cambios en menos de 10 s sin redesplegar
Guarda los prompts en una biblioteca, llámalos por prompt_id y publica moviendo una etiqueta. Medido: 8 a 9 s hasta las llamadas reales y los mismos 114.5 tokens de prompt que al enviarlo en la petición.
Nuestra selección
precios en vivo| Modelo | Veredicto | Precio |
|---|---|---|
| GPT-6 Luna Se sirvieron v1 y v2 de support-answer. Una llamada por id de prompt envió los mismos 114.5 tokens de prompt (mediana de 20 pares) que la solicitud renderizada enviada directamente. | Modelo del prompt de respuesta de la demo | desde $0.1/M |
| DeepSeek V4.1 Flash Se ejecutó policy-check v1 con un esquema de salida almacenado en la versión: una respuesta JSON de 18 tokens de salida por $0.000033, con reasoning_effort establecido en none. | Modelo de la comprobación de JSON de la demo | desde $0.3/M |
Contenido
- ¿Cómo se llama a un prompt por id?
- ¿Cuesta más llamar por id que escribir el prompt en el código?
- ¿Cuánto tarda un cambio de etiqueta en llegar a las llamadas?
- ¿Qué ocurre si no se puede atender una llamada?
- ¿Qué puede guardar una versión además del texto?
- ¿Dónde se ve qué versión respondió a una llamada?
- ¿Qué queda fuera?
- Preguntas frecuentes
- ¿Qué es el versionado de prompts?
- ¿Llamar a un prompt por id añade latencia o tokens?
- ¿Cuánto tarda un cambio de prompt en llegar a producción?
- ¿Puedo seguir usando el SDK de OpenAI o el de Anthropic?
- Lecturas relacionadas
El versionado de prompts consiste en guardar cada prompt fuera del código, en versiones numeradas e inmutables, llamarlo por su id y elegir qué versión usa producción mediante una etiqueta. Una etiqueta es un puntero con nombre, como production o staging, que apunta a una sola versión en cada momento. En la biblioteca de prompts de Synthorai, la petición identifica el prompt con prompt_id y el gateway incorpora los mensajes, el modelo y los parámetros de esa versión. Mover la etiqueta production cambia lo que reciben las siguientes llamadas. En nuestras pruebas, el cambio llegó a las llamadas reales en 8 a 9 segundos con tráfico continuo, y en la primera llamada tras un periodo sin tráfico. Además, una llamada por id envió exactamente los mismos tokens de prompt que la petición equivalente escrita en el código.
TL;DR
- Una llamada por
prompt_idal gateway de Synthorai envió una mediana de 114.5 tokens de prompt en 20 pares, lo mismo que al incluir el prompt en la petición. - Con tráfico continuo, el cambio de la etiqueta
productionllegó a las llamadas entre 8.0 y 8.5 s después de moverla (mediana). Tras 15 s sin llamadas, fue inmediato. - En 20 cambios de etiqueta, ninguna llamada recibió la versión anterior después de que la primera recibiera la nueva.
- Las llamadas que no se podían atender fallaron con 400 o 404 antes de ejecutar ningún modelo y no se facturaron.
Esta guía lleva a la biblioteca los prompts del agente de soporte de Trazar un agente LLM y los llama de todas las formas que acepta el gateway. El código está en github.com/synthorai-io/use-cases, dentro de prompt-library/. Necesitas Python 3.10 o posterior, una clave de inferencia y una clave de administración con el permiso prompts.write, disponible en la consola.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put both keys in it
cd prompt-library
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python setup.py         # saves the prompts and their versions; safe to run again
python call.py          # every way to call a prompt
python ship.py          # moves production and times it
python errors.py        # what a call that cannot be served answers
Las pruebas de esta página se ejecutaron el 19 de octubre de 2026. setup.py guarda dos prompts. support-answer corresponde al paso de respuesta del agente y tiene cuatro versiones, cada una con un cambio realista. policy-check es una comprobación de un subagente que responde en JSON:
| Prompt | Versión | Qué cambia | Modelo |
|---|---|---|---|
support-answer | v1 | versión base: indicar el número de pedido y no prometer nunca una fecha de reembolso | GPT-6 Luna |
support-answer | v2 | texto de sistema más corto, sin la regla del número de pedido | GPT-6 Luna |
support-answer | v3 | texto de v1 con otro modelo | DeepSeek V4.1 Flash |
support-answer | v4 | v1 con una variable {{tone}} sin valor predeterminado | GPT-6 Luna |
policy-check | v1 | temas y nivel de riesgo en un JSON que cumple un esquema | DeepSeek V4.1 Flash |
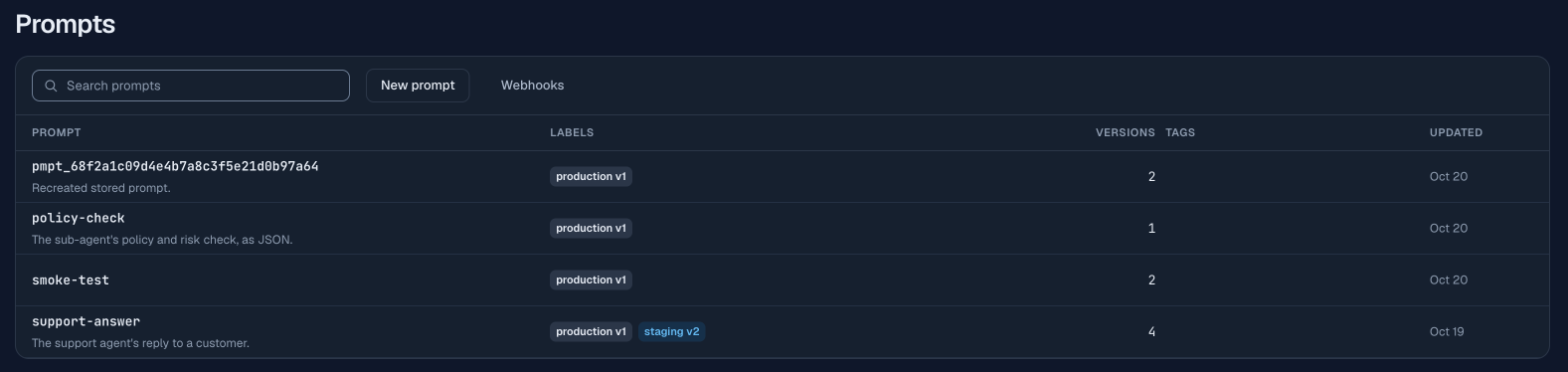
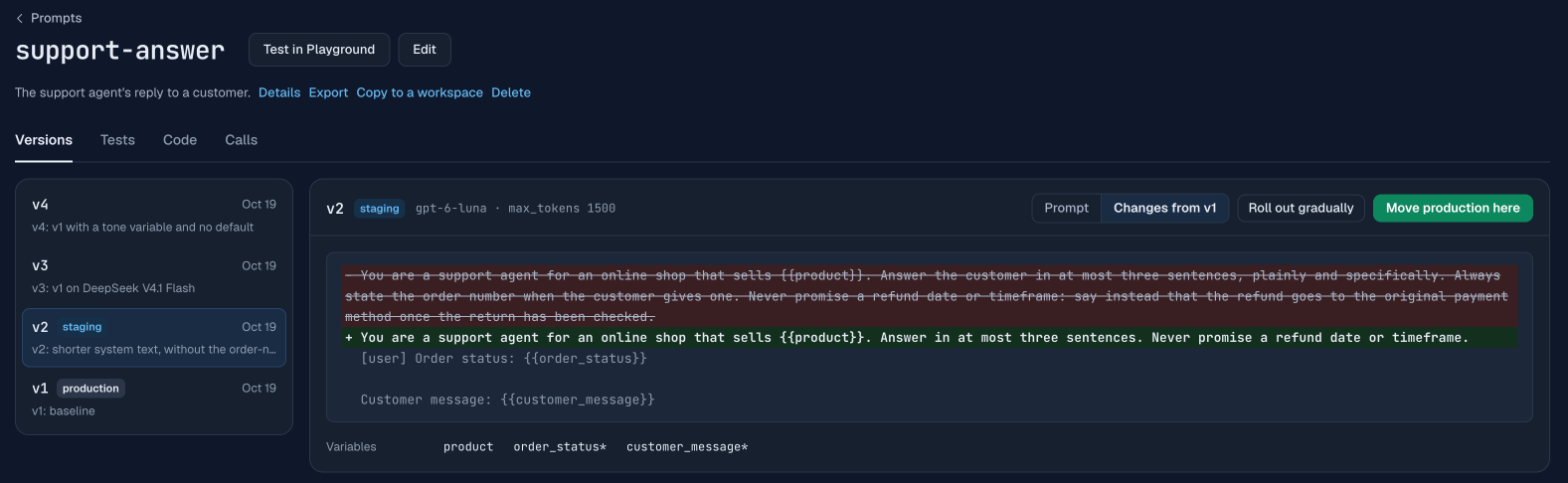
production apunta a v1 y staging a v2. Las dos guías siguientes usan v2 y v3 para probar una versión antes de publicarla y desplegarla para una parte del tráfico de producción. La consola compara cada versión con la anterior:
¿Cómo se llama a un prompt por id?
Envía una petición normal a /v1/chat/completions, /v1/responses o /v1/messages y añade prompt_id y prompt_variables al cuerpo. Las variables son marcadores {{name}} en el texto de la versión; prompt_variables asigna a cada una su valor para esa llamada. Los SDK exigen un modelo y un mensaje, así que envía cualquier nombre de modelo y un mensaje de usuario vacío: el gateway usa el modelo de la versión y descarta el mensaje vacío. Con el SDK de Python de OpenAI, los campos adicionales van en extra_body:
import os
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key=os.environ["SYNTHORAI_API_KEY"])

raw = client.chat.completions.with_raw_response.create(
    model="any",                                   # the version's model is used
    messages=[{"role": "user", "content": ""}],    # required by the SDK; dropped
    extra_body={
        "prompt_id": "support-answer",
        "prompt_variables": {
            "customer_message": "Where is order A-50977? It has been a week.",
            "order_status": "in transit, shipped on 2026-10-01",
        },
    },
)
print(raw.headers["x-synthorai-prompt-version"])   # which version answered
print(raw.parse().choices[0].message.content)
La llamada no incluye product porque la versión le asigna un valor predeterminado (“electrónica para el hogar”). La cabecera de respuesta X-Synthorai-Prompt-Version indica qué versión respondió. Cuando se llama por etiqueta, es la única forma que tiene el cliente de saberlo.
Si no se especifica una versión, la llamada usa la que señala production. Hay dos campos para elegir otra; una llamada puede enviar uno u otro, pero no ambos:
| Campo | Ejemplo | Versión usada en la demo |
|---|---|---|
| ninguno | v1 (production) | |
prompt_label | "staging" | v2 |
prompt_version | 1 | v1 |
La misma llamada por id funcionó en los tres endpoints: Chat Completions y Responses mediante el SDK de OpenAI, y Messages mediante el SDK de Anthropic, con el mismo extra_body. Los tres usaron v1 con GPT-6 Luna. En Responses, los mensajes de la versión se incluyen en input; la guía de la biblioteca de prompts detalla cómo se asigna cada campo en cada endpoint.
¿Cuesta más llamar por id que escribir el prompt en el código?
Llamar por id cuesta lo mismo que escribir la petición completa en el código, porque el gateway envía una petición normal al proveedor. Lo comprobamos con 20 pares de llamadas. En cada par se renderizó el prompt, se envió la petición resultante directamente y se enviaron los mismos valores por id. Alternamos el orden y usamos el mismo salt en ambas llamadas: una etiqueta aleatoria corta añadida al mensaje para que ningún par repitiera la misma petición.
| Tokens de prompt, mediana | Latencia del cliente, mediana | |
|---|---|---|
Por prompt_id | 114.5 | 4.1 s |
| Incluido en la petición | 114.5 | 4.6 s |
El número de tokens es idéntico. La llamada por id fue la más rápida de las dos, algo que no puede explicar una sobrecarga adicional. Atribuimos la diferencia a la variación entre llamadas de GPT-6 Luna y concluimos que llamar por id no añadió un tiempo medible. No sometimos la diferencia de latencia a una prueba estadística.
Para ver qué enviaría una llamada sin invocar un modelo, renderízala. POST /v1/prompts/{id}/render acepta las mismas variables y devuelve la petición junto con la versión resuelta:
curl https://synthorai.io/v1/prompts/support-answer/render \
  -H "Authorization: Bearer $SYNTHORAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"format": "chat", "prompt_variables": {"customer_message": "Where is order A-50977?", "order_status": "in transit"}}'
El renderizado no se factura ni aparece en Logs: tras el renderizado de la demo, no había ninguna petición con su id de sesión en Logs. Sí cuenta para el límite de peticiones de la clave.
¿Cuánto tarda un cambio de etiqueta en llegar a las llamadas?
Menos de 10 segundos: en nuestras pruebas, entre 8 y 9 s con llamadas continuas, e inmediatamente tras un periodo sin tráfico. Publicar una versión requiere una sola llamada con una clave de administración, que apunta una etiqueta a un número de versión:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})
admin.put("/prompts/support-answer/labels/production", json={"version": 3}).raise_for_status()
Para revertir el cambio se hace la misma llamada con el número de la versión anterior. El código sigue llamando al mismo id y no hay que redesplegar nada. Solo un administrador o el propietario del espacio de trabajo puede mover una etiqueta, y cada cambio queda registrado en el log de auditoría del espacio de trabajo.
ship.py midió los tiempos. Envió una llamada cada 0.5 s, movió production mediante la API y siguió enviando llamadas hasta que la cabecera mostró la nueva versión y durante otros 10 s. Repitió el proceso 5 veces de v1 a v3 y 5 veces en sentido contrario. Después repitió los 10 cambios tras 15 s sin llamadas:
| Caso | Momento de envío de la última llamada atendida por la versión anterior | Momento de envío de la primera llamada atendida por la nueva versión |
|---|---|---|
| Llamadas cada 0.5 s, de v1 a v3 | mediana de 8.02 s tras el cambio (7.53 a 8.53) | mediana de 8.52 s (8.03 a 9.03) |
| Llamadas cada 0.5 s, de v3 a v1 | mediana de 7.52 s (7.52 a 8.52) | mediana de 8.02 s (8.02 a 9.02) |
| Tras 15 s sin llamadas, en ambos sentidos | ninguna | 0.0 s en los 10 cambios |
Los tiempos se cuentan desde que respondió la llamada a la API que movió la etiqueta. La documentación indica que un cambio llega a las llamadas en “unos 10 segundos”. Ambos casos encajan con un gateway que conserva lo leído de una etiqueta durante unos segundos desde la última lectura: con tráfico continuo, el cambio se ve cuando caduca esa copia; tras una pausa, la primera llamada vuelve a leer la etiqueta. En ninguno de los 20 cambios hubo llamadas que recibieran la versión anterior después de que una hubiera recibido la nueva. Por tanto, durante la propagación no se alternó entre versiones.
¿Qué ocurre si no se puede atender una llamada?
Falla antes de llamar a ningún modelo, con un 400 o 404 en el formato de error del endpoint utilizado, y no se factura nada. errors.py envió cinco llamadas de este tipo:
| Llamada | Estado | Código | Mensaje |
|---|---|---|---|
v4 sin tone | 400 | prompt_variable_missing | ”prompt_variables: falta tone (sin valor ni valor predeterminado)“ |
| una versión y una etiqueta | 400 | prompt_invalid | ”envía prompt_version o prompt_label, no ambos” |
| un id que no existe | 404 | prompt_not_found | ”prompt_id: no existe el prompt “support-answer-missing” en este espacio de trabajo” |
| versión 99 | 404 | prompt_not_found | ”el prompt “support-answer” no tiene una versión 99” |
| una etiqueta sin versión asignada | 404 | prompt_not_found | ”la etiqueta “development” del prompt “support-answer” todavía no apunta a ninguna versión” |
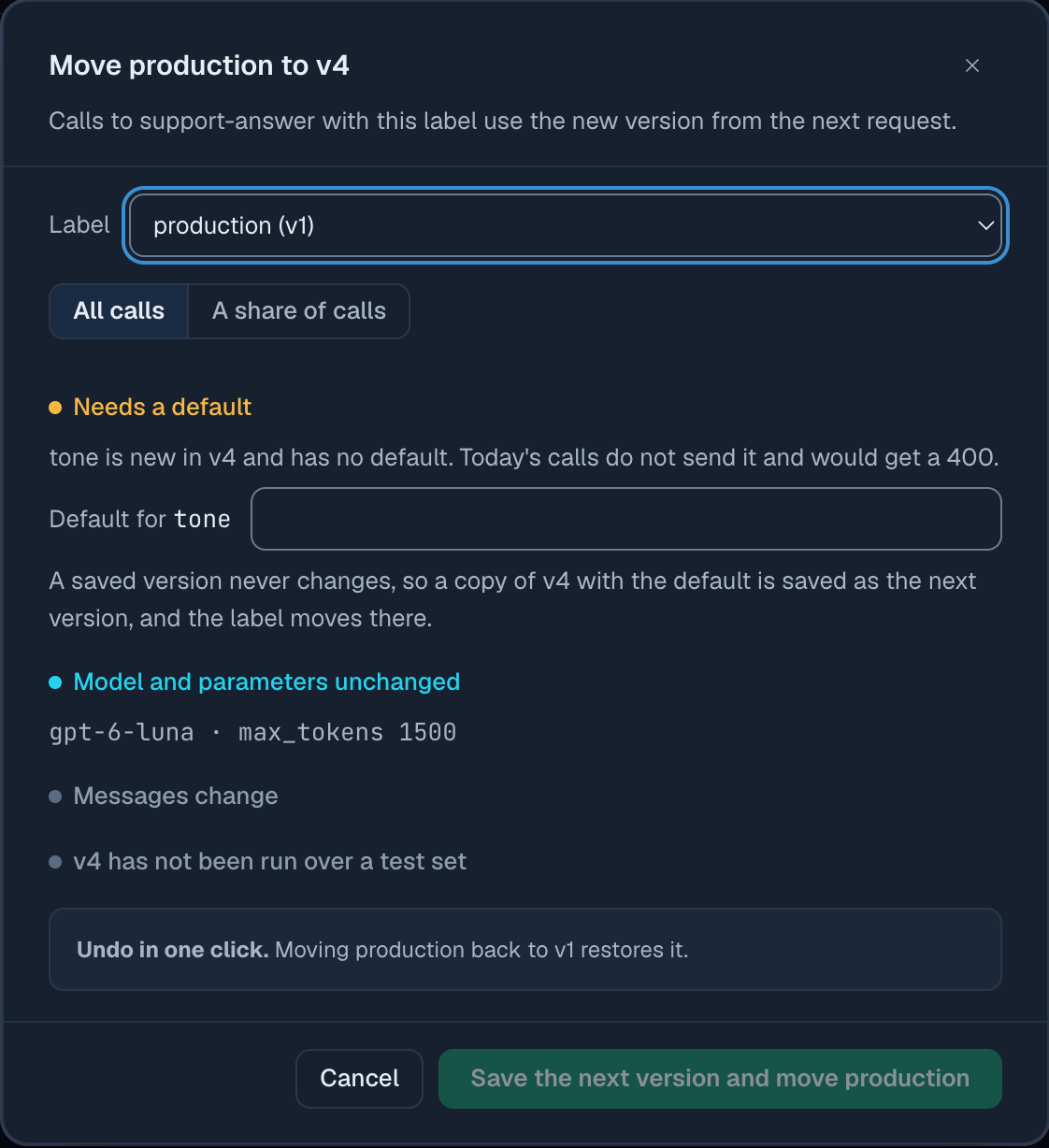
Ninguna de las cinco tiene un registro de facturación. La primera fila muestra un cambio incompatible con los clientes actuales: v4 añade una variable sin valor predeterminado, así que fallan todas las llamadas que no envían tone. La consola lo detecta antes de publicar. Al mover production a v4, se abre un diálogo que comprueba qué cambia para los clientes actuales y pide un valor predeterminado, que guarda en la siguiente versión.
Si la biblioteca no se puede leer temporalmente, el gateway responde con la última copia que leyó, durante un máximo de 24 horas, y añade X-Synthorai-Prompt-Stale: 1 a la respuesta. Si no tiene una copia reciente del prompt, devuelve 503 prompt_unavailable; en ese caso, reintenta la llamada. No observamos ninguno de los dos casos en la demo.
¿Qué puede guardar una versión además del texto?
Una versión guarda el texto de sistema, los mensajes, el modelo, cinco parámetros, un esquema de salida y herramientas de tipo función. Para los parámetros, prevalecen los de tu petición: los valores de temperature, max_tokens, top_p, response_format y reasoning_effort de la versión solo se aplican si la petición no define ese mismo campo.
policy-check guarda el esquema JSON en la versión, de modo que los clientes reciben un JSON que lo cumple sin tener que enviar un formato. Al guardar la versión mediante la API, el formato se indica en params y el esquema se almacena en schema:
version = {
    "model": "deepseek-v4.1-flash",
    "system": "You review messages to an online electronics shop's support desk. ...",
    "messages": [{"role": "user", "content": "{{customer_message}}"}],
    "params": {"max_tokens": 300, "response_format": "json_schema"},
    "schema": {"name": "policy_check", "strict": True, "schema": {
        "type": "object",
        "properties": {"topics": {"type": "array", "items": {"type": "string"}},
                       "risk": {"type": "string", "enum": ["low", "medium", "high"]}},
        "required": ["topics", "risk"], "additionalProperties": False}},
}
admin.post("/prompts/policy-check/versions", json={"body": version, "note": "v1: JSON check"}).raise_for_status()
Si se intenta guardar un esquema sin response_format: "json_schema", la API lo rechaza con un 400 que indica el motivo. Una llamada de policy-check con DeepSeek V4.1 Flash devolvió {"topics": ["shipping", "refunds"], "risk": "medium"} con 151 tokens de entrada y 18 de salida, por $0.000033. Esa llamada envió reasoning_effort: "none" desde el cliente, porque las versiones de la demo se habían guardado antes de que ese campo pudiera almacenarse en una versión. Ahora puede guardarse en params: guardamos una versión de prueba con reasoning_effort: "none" y la renderizamos. La petición incluía reasoning_effort en Chat Completions y reasoning.effort en Responses. En Messages se omite el valor de la versión, porque los modelos Claude usan otro formato para configurar el razonamiento; en ese endpoint, envía la configuración desde el cliente.
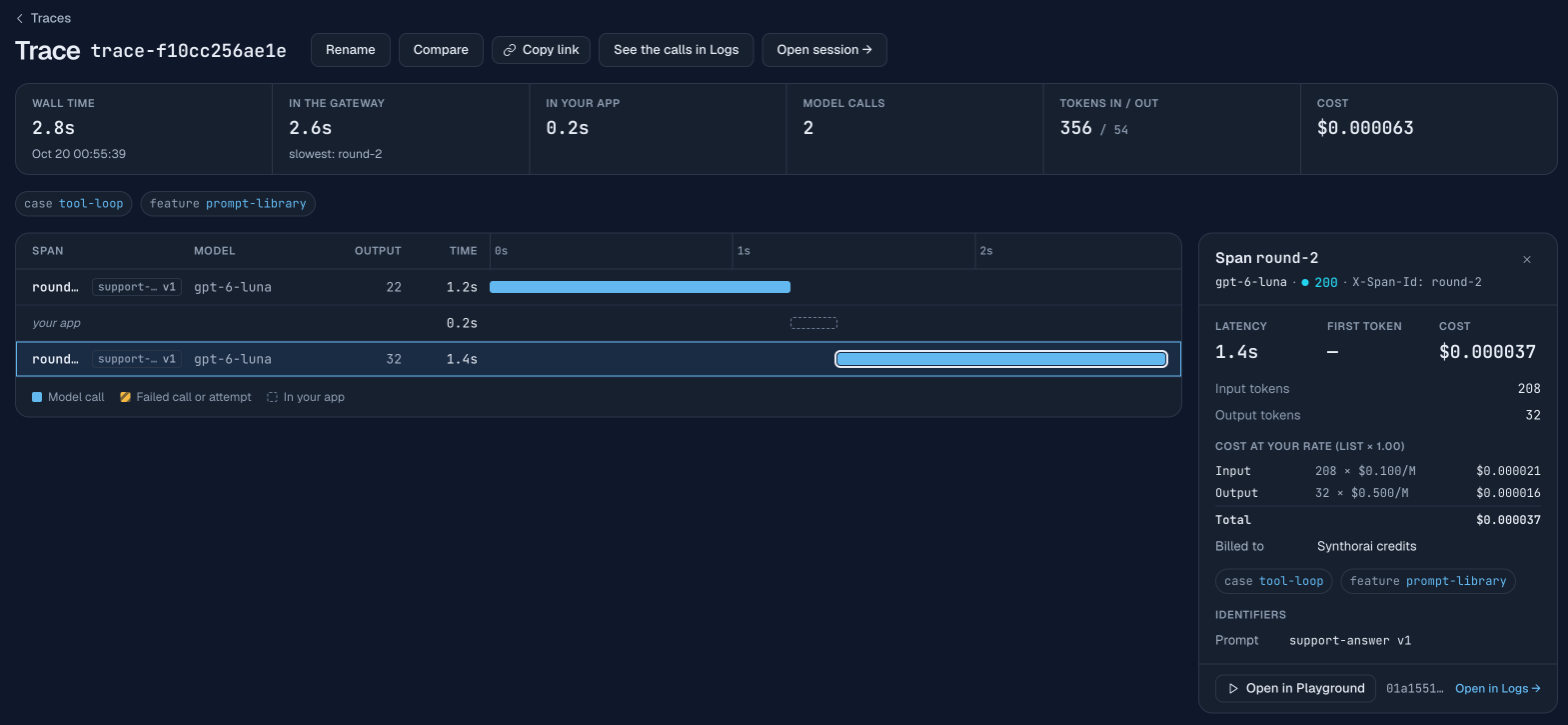
Las llamadas a herramientas y las conversaciones de varios turnos funcionan igual que sin un prompt de biblioteca. Primero van los mensajes de la versión y después la conversación que envías. En la ronda 1 del bucle de herramientas de la demo, el modelo solicitó lookup_order({"order_id": "A-50977"}). En la ronda 2 se enviaron la llamada a la herramienta del modelo y su resultado como mensajes normales, usando el mismo id, y v1 respondió a partir del resultado.
¿Dónde se ve qué versión respondió a una llamada?
Cada llamada se registra con su prompt y su versión. Puedes consultarlos de tres formas:
- En la respuesta: la cabecera
X-Synthorai-Prompt-Version, que la demo escribe junto a cada llamada en sus resultados. - En Logs: el filtro
prompt = support-answerjunto conprompt_version = 3muestra las llamadas de esa versión. El detalle de cada petición indica el prompt y la versión.GET /api/v1/requestsacepta los mismos filtrosprompt_idyprompt_version. - En una traza: cada fila de llamada a un modelo en la vista de cascada lleva una etiqueta “prompt vN”, y el panel de la llamada muestra el prompt y la versión. Las cabeceras de trazabilidad de Trazar un agente LLM funcionan sin cambios con las llamadas por id.
La página de prompts muestra por versión los totales de llamadas, errores, gasto y tokens, además de la latencia, para periodos de 7, 30 o 90 días. La guía de despliegue gradual usa esa vista para comparar dos versiones con tráfico real.
¿Qué queda fuera?
- Despliegues graduales y pruebas. Prueba A/B de un cambio de prompt explica cómo enviar una parte del tráfico de producción a una versión candidata. Probar un prompt antes de publicarlo cubre las pruebas con un conjunto fijo de entradas.
- Fragmentos reutilizables. Un bloque de texto que se guarda una sola vez y se incluye en varios prompts con
{{>id}}; cada versión guardada fija la versión del fragmento que incluye. - Webhooks de cambios. Un POST firmado cuando se añade una versión a un prompt o se mueve una etiqueta, para sincronizar los prompts con git o con un canal de chat. El archivo
webhook.pyde la demo verifica una firma, pero no recibimos ninguna entrega real. - Idempotencia al crear. La cabecera
Idempotency-Keypermite reintentar una petición con seguridad: durante 24 horas, la API responde a una clave repetida con la respuesta original en lugar de crear el prompt dos veces. Esto se mantiene incluso después de borrar el prompt, así que, para recrearlo, envía una clave nueva.
Preguntas frecuentes
¿Qué es el versionado de prompts?
El versionado de prompts consiste en guardar cada prompt en versiones numeradas que no cambian una vez guardadas y elegir con una etiqueta qué versión usa producción, sin modificar el código. Para revertir un cambio, se apunta la etiqueta a la versión anterior.
¿Llamar a un prompt por id añade latencia o tokens?
En nuestros 20 pares no añadió ni latencia ni tokens: la mediana fue de 114.5 tokens de prompt en ambos casos y la llamada por id no fue más lenta. El gateway resuelve la versión y envía una petición normal al proveedor.
¿Cuánto tarda un cambio de prompt en llegar a producción?
Unos 10 segundos como máximo. En nuestras pruebas con tráfico continuo, la primera llamada atendida por la nueva versión se envió entre 8.0 y 8.5 s después de mover la etiqueta (mediana). Si el tráfico llevaba 15 s en pausa, el cambio fue inmediato.
¿Puedo seguir usando el SDK de OpenAI o el de Anthropic?
Ambos SDK funcionan sin cambios: envían los campos del prompt mediante extra_body, con cualquier nombre de modelo y un mensaje de usuario vacío para cumplir los argumentos obligatorios.
Lecturas relacionadas
- Guía de la biblioteca de prompts: todos los campos, errores y cabeceras de respuesta de esta página.
- Prompts en la consola: el editor, la comparación de versiones y el diálogo para mover etiquetas.
- Prueba A/B de un cambio de prompt: un despliegue al 10% y la comparación por versión.
- Probar un prompt antes de publicarlo: conjuntos de prueba, comprobaciones y qué se puede y qué no se puede concluir de una ejecución.
- Trazar un agente LLM: las cabeceras de sesión y trazabilidad que la demo sigue enviando.