
Por qué tu agente LLM sale caro: cuatro causas en una traza
Cuatro causas de una factura elevada, reproducidas y corregidas: un timestamp que rompe la caché (de 0% a 73% de aciertos), contexto creciente, reintentos y un modelo inadecuado.
Nuestra selección
precios en vivo| Modelo | Veredicto | Precio |
|---|---|---|
| GPT-6 Luna Al mover la marca de tiempo fuera de la primera línea del prompt, 4,157 de 5,729 tokens de entrada a lo largo de cuatro turnos se leyeron de la caché en un arranque en frío. Con la marca de tiempo al principio, no se leyó de la caché ninguno de los 5,579. | Agente principal de la demo | desde $0.1/M |
| DeepSeek V4.1 Flash Tres comprobaciones de una frase costaron $0.0010 con GPT-6.1 Sol y $0.0001 con este modelo. | Subagente de la demo | desde $0.3/M |
Contenido
- ¿Por dónde empezar cuando la factura supera lo esperado?
- ¿Por qué la tasa de aciertos de caché es cero?
- ¿Por qué cada turno envía más que el anterior?
- ¿Cómo se ve un bucle de reintentos?
- ¿Cómo detectar un modelo caro haciendo una tarea sencilla?
- Preguntas frecuentes
- ¿Cómo averiguo qué parte de mi agente LLM cuesta más?
- ¿Por qué la tasa de aciertos de mi caché de prompts es del 0%?
- ¿Por qué el primer turno de una conversación no encuentra nada en la caché?
- ¿La caché de prompts hace que un historial largo salga gratis?
- ¿Cuánto se ahorra con la caché de prompts?
- ¿Un bucle de reintentos aparece como errores?
- Lecturas relacionadas
La factura de un agente puede crecer por motivos que no se ven en una petición aislada: un prompt que nunca aprovecha la caché, una conversación que reenvía más datos en cada turno, un bucle que repite el mismo trabajo o un modelo caro haciendo una tarea que podría resolver uno barato. Todos estos problemas se ven con claridad al agrupar las llamadas en sesiones y trazas. Esta guía reproduce los cuatro en un pequeño agente de soporte, muestra dónde aparece cada uno en la consola de Synthorai, lo corrige y compara el coste antes y después.
TL;DR
- Un timestamp en la primera línea del prompt mantenía la tasa de aciertos de caché en 0%. Moverlo al final la elevó al 73% y redujo el coste de entrada un 66% en GPT-6 Luna.
- Un historial que reenviaba todos los resultados de herramientas consumió el triple de tokens de entrada por solo un 21% más de coste de entrada, porque el 71% se leyó de la caché.
- Un bucle de reintentos hizo 10 llamadas al modelo donde bastaban 2, todas con estado 200.
- Tres llamadas de un subagente a GPT-6.1 Sol supusieron el 81% del coste de una sesión.
Esta guía parte de Cómo trazar un agente LLM, que explica las cabeceras de petición usadas para agrupar llamadas en sesiones y trazas. Prepara la demo como se indica allí (Python 3.10 o posterior, con el virtualenv activo). Después ejecuta los cuatro casos, junto con replay-mismatch (otra forma de perder la caché), desde el mismo directorio de github.com/synthorai-io/use-cases:
cd use-cases/agent-tracing
python incidents.py cache-miss context-growth replay-mismatch retry-loop wrong-model
Cada caso se ejecuta dos veces, primero con el problema y luego con la corrección, y etiqueta sus llamadas con case y variant. Las cifras corresponden a una ejecución de cada caso el 11 de octubre de 2026. Son fracciones de céntimo porque la demo es muy pequeña. Lo que se traslada a una carga de trabajo real son las proporciones.
| Caso | Dónde se ve | Antes | Después |
|---|---|---|---|
cache-miss | Aciertos de caché por turno en la página de la sesión | 0% en caché, $0.0015 | 73% en caché partiendo de una caché vacía, $0.0011 |
context-growth | La entrada por turno aumenta a medida que se avanza por la página de la sesión | 24,546 tokens de entrada, $0.0011 de coste de entrada | 8,053 tokens de entrada, $0.0009 de coste de entrada |
replay-mismatch | Los aciertos de caché se mantienen en 0% en la página de la sesión | 0% en caché, $0.0038 | 76% en caché, $0.0015 |
retry-loop | Una traza con muchas más llamadas de las que necesita un turno | 10 llamadas, $0.0004 | 2 llamadas, $0.0001 |
wrong-model | Tabla de agentes en la página de la sesión | $0.0012 | $0.0003 |
¿Por dónde empezar cuando la factura supera lo esperado?
Empieza por la lista Traces, ordenada por coste. Cada fila muestra una sesión o una traza con su número de llamadas, duración y coste. Así, las conversaciones más caras quedan arriba. Al abrir una, podrás ver cuáles de los patrones siguientes presenta.
Si etiquetas las peticiones con X-Synthorai-Metadata, filtra primero la lista. El buscador de Traces admite etiquetas: metadata.feature = support-agent deja solo las sesiones y trazas de una funcionalidad, y metadata.case = cache-miss encuentra las dos ejecuciones de ese caso de esta guía. Para consultar los totales, la pestaña Breakdown de Analytics incluye una tarjeta Cost by metadata: elige una clave y verás las peticiones, los tokens de entrada y el coste de cada valor.
¿Por qué la tasa de aciertos de caché es cero?
La tasa de aciertos es cero cuando algo cerca del principio del prompt cambia en cada petición. La caché de prompts permite al proveedor cobrar la parte inicial repetida a una fracción del precio de entrada, pero solo hasta el primer token que difiere de la petición anterior. La versión con el problema coloca la hora actual en la primera línea de un prompt de sistema de unos 1,300 tokens:
# The clock is the first line, so the prompt differs from its first token on every turn.
system = f"Current time: {now}\n\n{SYSTEM}\n\n{MANUAL}"
En una conversación de cuatro turnos con GPT-6 Luna, la página de la sesión muestra Cache hit 0%: 0 de 5,579 tokens de entrada. La corrección mueve la parte variable al final:
# Stable text first, the part that changes last.
system, user = f"{SYSTEM}\n\n{MANUAL}", f"{text}\n\n(Current time: {now})"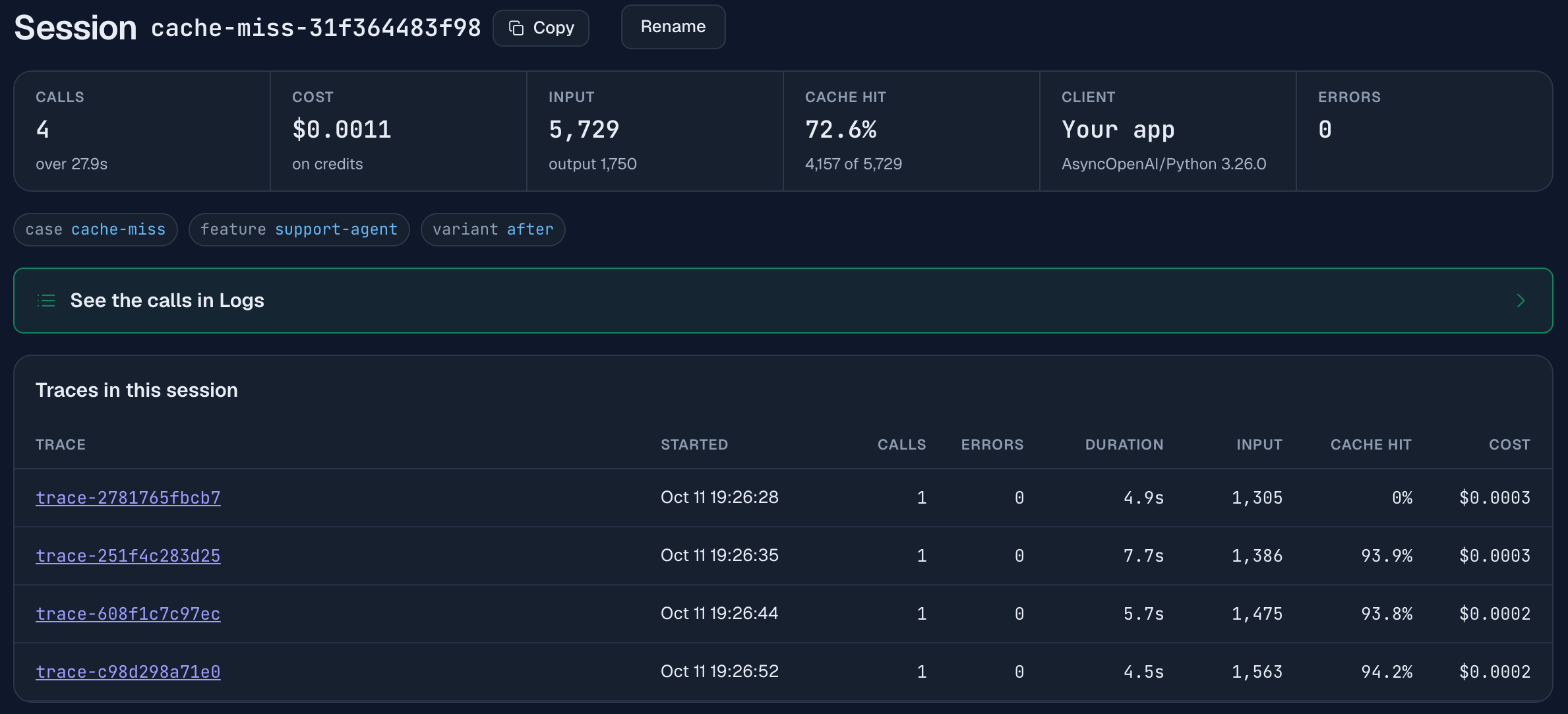
La página de la sesión muestra la entrada y los aciertos de caché de cada turno; la primera fila marca 0%. El primer turno no puede leer una entrada que ninguna petición ha escrito aún: la escribe, pero no lee nada. Los tres turnos siguientes leen 1,302, 1,383 y 1,472 tokens de la caché, casi todo lo que envió el turno anterior. Por eso, cada uno lee de la caché alrededor del 94% de su entrada. En toda la conversación son 4,157 de 5,729 tokens de entrada, el 73%.
El ahorro está en la entrada. Este modelo cobra $0.10 por millón de tokens de entrada, $0.125 por los tokens que escribe en la caché y $0.01 por los que lee de ella. En un prompt largo, casi todos los tokens se escriben o se leen de la caché.
La ejecución con el problema escribió 5,567 tokens en la caché y no leyó ninguno. La corregida escribió 1,560 y leyó 4,157, por lo que el coste de entrada bajó de $0.00070 a $0.00024, un 66% menos. El coste de la sesión pasó de $0.0015 a $0.0011. La caída fue menor que la del coste de entrada porque la salida representa la mayor parte de esta factura y, en esta ejecución, la versión corregida generó más tokens (1,750 frente a 1,599).
El ahorro depende de lo que ya haya en la caché cuando empieza la conversación. Esta ejecución partió de una caché vacía, así que el primer turno no leyó nada. Un agente con tráfico constante debería superar el 73%: todas las conversaciones empiezan con el mismo prompt de sistema y la entrada de la conversación anterior sigue disponible, siempre que las peticiones lleguen antes de que caduque. Un prompt que solo se envía en una conversación paga el precio de escritura en su primer turno.
El timestamp es la causa clásica. Un identificador de petición, un saludo aleatorio, un nombre de usuario insertado en el primer párrafo o unas definiciones de herramientas en distinto orden provocan lo mismo. Para obtener un acierto deben cumplirse otras dos condiciones: el prefijo estable (el inicio del prompt que no cambia) debe superar el mínimo del proveedor (1,024 tokens en la mayoría; consulta caché de prompts), y las llamadas de una conversación deben llevar el mismo X-Session-Id, que el gateway usa para mantener la coherencia de los aciertos de caché de esa conversación.
¿Por qué cada turno envía más que el anterior?
Cada turno envía más porque la conversación reenvía todo su historial. Cierto crecimiento es normal, ya que el historial se alarga. En la versión con el problema, crece mucho más rápido: cada turno consulta los datos del cliente, recibe unos 1,100 tokens de historial de pedidos en JSON y conserva el resultado en el historial. Así, el sexto turno lleva seis copias de datos casi idénticos.
if variant == "before":
    history += [lookup_result]               # every old lookup is sent again on every later turn
history += [{"role": "user", "content": text}, {"role": "assistant", "content": reply}]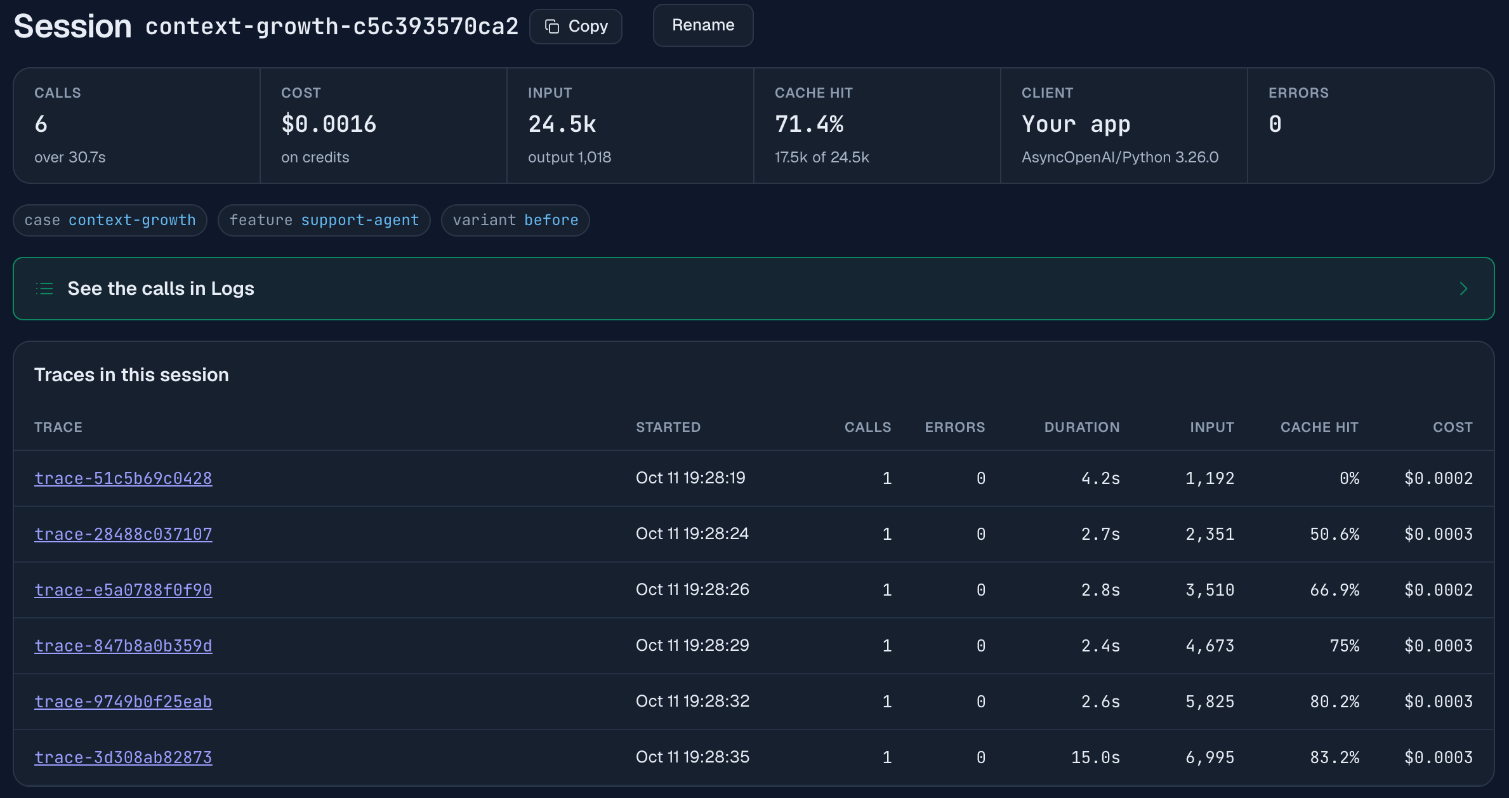
La señal está en la columna Input de la tabla “Traces in this session”: aumenta unos 1,160 tokens por turno, de 1,192 en el primero a 6,995 en el sexto, mientras las respuestas siguen teniendo dos frases. Los seis turnos consumieron 24,546 tokens de entrada. En la versión corregida, el turno actual sigue recibiendo una consulta nueva, pero las anteriores no se conservan: la respuesta del asistente ya recogió lo relevante. Los seis turnos pasan a consumir 8,053 tokens de entrada, un tercio.
Las dos columnas junto a Input explican por qué el problema pasa desapercibido. Los aciertos de caché aumentan con la entrada y el coste por turno se mantiene entre $0.0002 y $0.0003. Cada turno empieza con todo el prompt del anterior, así que el proveedor lee esa parte de la caché: 17,536 de los 24,546 tokens de entrada, el 71%. La entrada de la sesión con el problema costó $0.0011, frente a $0.0009 en la corregida: el triple de tokens de entrada por un 21% más de coste de entrada.
En esta comparación, los totales de las sesiones no reflejan la corrección. La sesión con el problema costó $0.0016 y la corregida $0.0017 porque esta última generó más salida (1,756 tokens frente a 1,018). La salida adicional añadió unos $0.0004, más que los $0.0002 ahorrados en la entrada. Compara las columnas Input y Cache hit, que son las que cambia la corrección, no el total de una sola sesión.
La caché de prompts puede absorber gran parte del coste de un historial creciente. Pero hay tres cosas que no hace:
- No reduce el contexto. El sexto turno sigue enviando 6,995 tokens. Una sesión larga alcanza igualmente el límite de contexto del modelo, y los tokens en caché se siguen cobrando, aunque a la tarifa de caché.
- Solo funciona si el historial se reenvía exactamente como se envió antes. La demo incluye el caso
replay-mismatch: al enviar cada mensaje de usuario se le añade una instrucción, pero se guarda sin ella. Cada turno reconstruye entonces un prompt que el turno anterior nunca envió. Esa conversación leyó 0 de 24,557 tokens de entrada de la caché y costó $0.0038. Al guardar el mensaje tal como se envió, pasó a leer 18,844 de 24,702, el 76%, y a costar $0.0015. - No está disponible en todos los modelos. A la tarifa completa de entrada de GPT-6 Luna, el modelo de este caso, 24,546 tokens cuestan $0.0025, frente a los aproximadamente $0.0011 cobrados con caché. Comprueba la columna Cache hit antes de contar con ese ahorro.
En tu agente, los resultados de herramientas suelen ser la parte más grande del historial y la menos útil de reenviar. Conserva la respuesta que los utilizó, o un resumen de una línea, y elimina los datos en bruto. Así ahorrarás con cualquier modelo, tenga caché o no. Nuestra guía de chatbots explica la versión general de esta técnica: comprimir los turnos antiguos en un resumen.
¿Cómo se ve un bucle de reintentos?
Se ve como una traza con muchas más llamadas de las que debería necesitar un turno, con nombres de spans repetidos. En este caso, la API de seguimiento del transportista está caída. El agente llama a la herramienta, recibe un timeout y responde que no puede consultar el paquete. El código comprueba después si la respuesta indica dónde está el paquete. Como no lo indica, vuelve a ejecutar el turno completo, hasta cinco veces:
if "sorting" in reply or "out for delivery" in reply:
    break                                    # the reply names a parcel location
if variant == "after" and (tool_failed or not results):
    break                                    # a retry cannot help while the tool is down or unused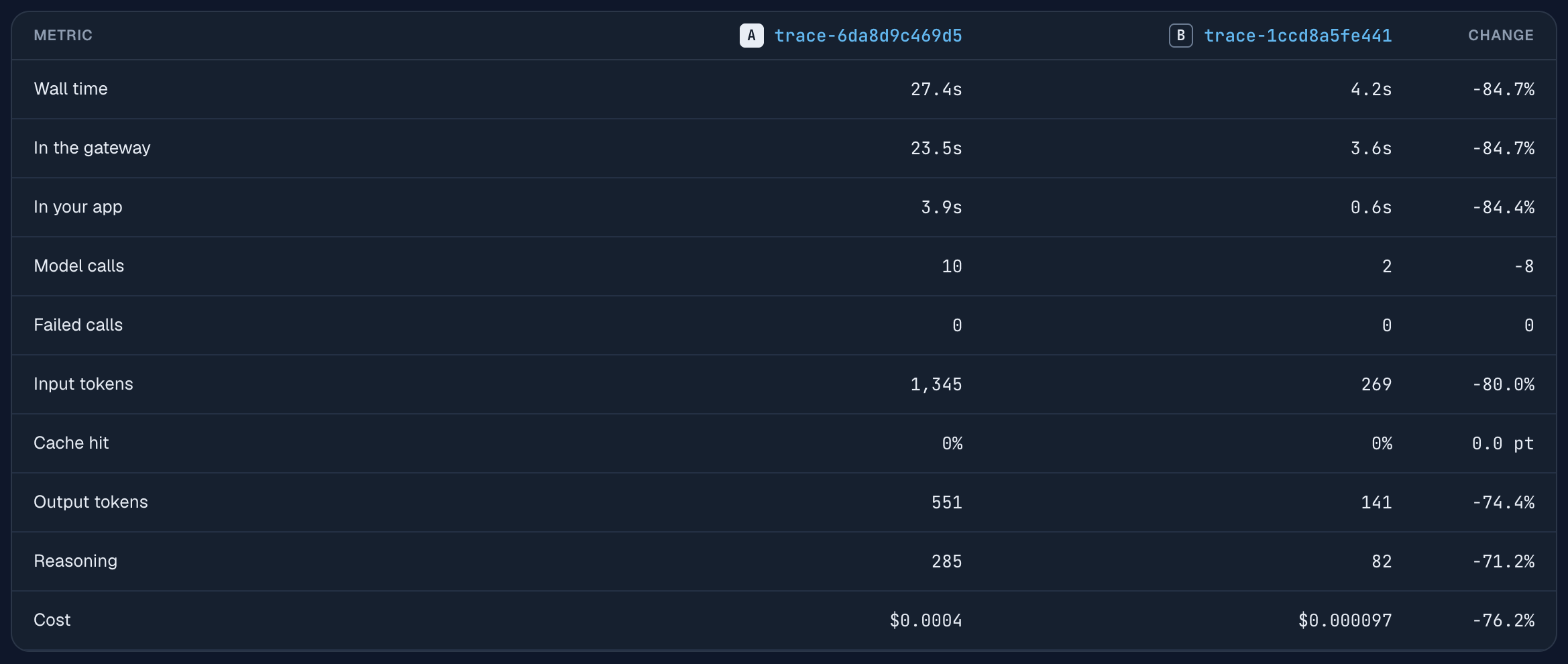
Esta es la vista Compare de las dos ejecuciones: abre una traza, selecciona Compare y elige la otra. La ejecución con el problema hizo 10 llamadas al modelo en 27.4 s por $0.0004, y el cliente terminó recibiendo la misma respuesta. “Failed calls” marca 0 en ambos casos. Todas las llamadas del bucle terminaron con estado 200, así que nada aparece como error. La versión corregida distingue un fallo de la herramienta de una mala respuesta y no reintenta si el problema está en la herramienta: 2 llamadas, 4.2 s, $0.0001.
En el diagrama de cascada de la ejecución con el problema, las llamadas se llaman plan-1, answer-1, plan-2, answer-2, etc. Si nombras los spans por paso e intento, como aquí, el bucle se reconoce a simple vista. Para encontrar bucles que aún no conoces, ordena la lista Traces por número de llamadas.
¿Cómo detectar un modelo caro haciendo una tarea sencilla?
Mira la tabla “Agents in this session”, que desglosa las llamadas y el coste de la sesión por agente. La versión con el problema ejecuta las tres comprobaciones de una frase del subagente en GPT-6.1 Sol, un modelo que cuesta $2 por millón de tokens de entrada y $10 por millón de tokens de salida. El agente principal responde con GPT-6 Luna:
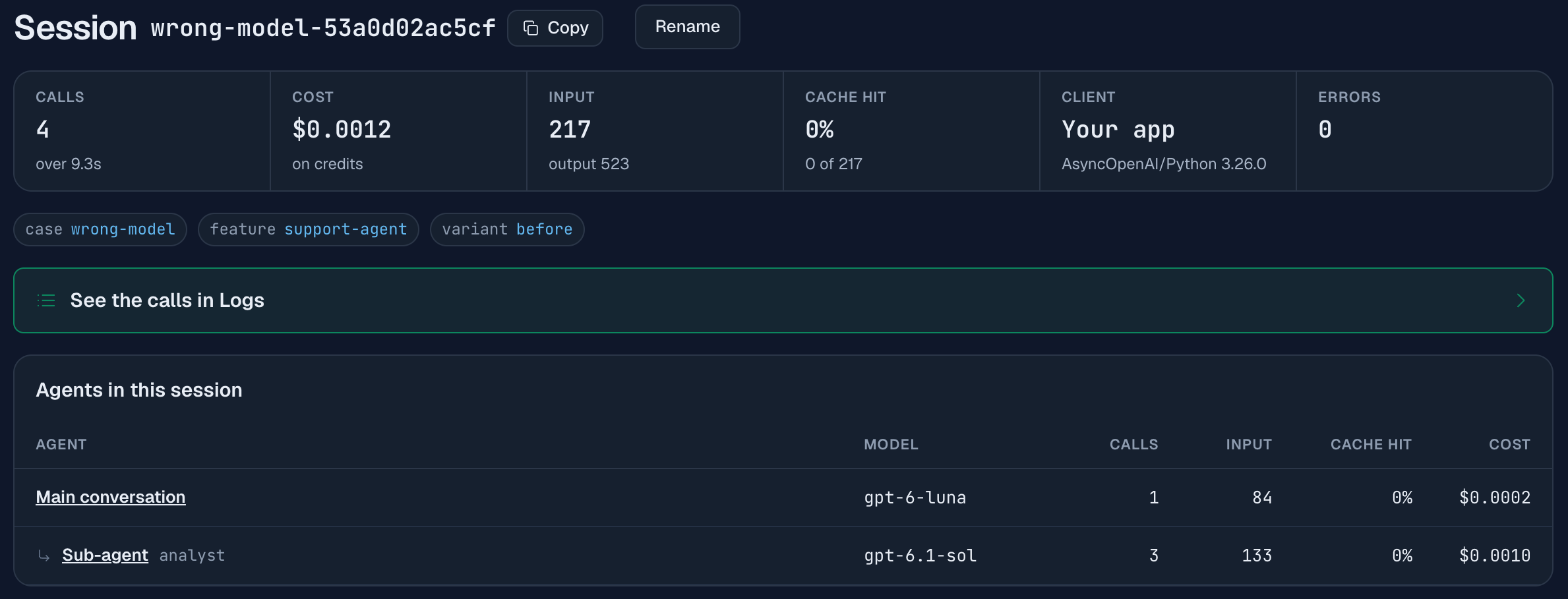
Las tres llamadas del subagente costaron $0.0010 de los $0.0012 de la sesión: el 81% de la factura correspondió al trabajo menos exigente de la ejecución. Las mismas tres comprobaciones en DeepSeek V4.1 Flash costaron $0.0001, y la sesión completa, $0.0003. Ambas versiones ejecutan las comprobaciones con el razonamiento desactivado, así que la diferencia está en el precio del modelo.
Este caso solo mide el coste. No evaluamos las comprobaciones, y un modelo más barato solo es adecuado si sus respuestas son suficientemente buenas para ese paso. La tabla muestra dónde se gasta el dinero para que sepas en qué paso merece la pena probar un modelo más barato.
El desglose aparece cuando las llamadas de los subagentes llevan X-Agent-Id. Sin esa cabecera, la tabla “Models in this session” muestra el desglose por modelo, que solo coincide con el de agentes si cada agente usa su propio modelo. Para consultar un agente en todas las sesiones, la pestaña Breakdown de Analytics incluye la tarjeta Cost by agent.
Preguntas frecuentes
¿Cómo averiguo qué parte de mi agente LLM cuesta más?
Agrupa sus llamadas en sesiones y trazas mediante cabeceras de petición. Después ordena la lista Traces por coste y abre la primera entrada. La página de la sesión desglosa el coste por agente, modelo y turno, lo que permite distinguir un problema de caché de uno de contexto o de elección de modelo.
¿Por qué la tasa de aciertos de mi caché de prompts es del 0%?
La causa más habitual es un valor que cambia cerca del principio del prompt, como un timestamp. La caché solo cubre el prompt hasta el primer token distinto. En la demo, mover el timestamp de la primera línea del prompt de sistema al final del mensaje de usuario elevó la tasa de aciertos del 0% al 73% partiendo de una caché vacía.
¿Por qué el primer turno de una conversación no encuentra nada en la caché?
Porque una petición tiene que escribir la entrada de caché, y el primer turno es esa petición. En la demo, los cuatro turnos leyeron de la caché el 0%, 93.9%, 93.8% y 94.2% de su entrada. El primer turno solo lee de la caché si una conversación anterior envió el mismo prefijo hace poco y su entrada aún no ha caducado.
¿La caché de prompts hace que un historial largo salga gratis?
No, pero puede ocultar gran parte del coste. En la demo, la conversación que reenviaba todos los resultados antiguos de herramientas consumió el triple de tokens de entrada que la versión recortada (24,546 frente a 8,053), pero su entrada solo costó un 21% más porque el 71% se leyó de la caché. Los tokens siguen ocupando la ventana de contexto, y el descuento desaparece en cuanto el historial reenviado difiere de lo que se envió antes: en el caso replay-mismatch de la demo, guardar un mensaje de forma distinta a como se envió dejó la conversación con un 0% en caché y más del doble de coste.
¿Cuánto se ahorra con la caché de prompts?
Depende de la tarifa de entrada en caché del modelo y de qué parte de la factura corresponda a la entrada. En la demo con GPT-6 Luna, leer de la caché el 73% de la entrada de una conversación redujo el coste de entrada un 66%. La sesión costó $0.0011 frente a $0.0015 sin caché. Los tokens de salida representaron la mayor parte de la factura, y la caché no los modifica.
¿Un bucle de reintentos aparece como errores?
No necesariamente. En la demo, todas las llamadas del bucle devolvieron estado 200. El bucle se veía como una traza con 10 llamadas donde bastaban 2. Revisa el número de llamadas por traza, no solo la tasa de errores.
Lecturas relacionadas
- Cómo trazar un agente LLM: las cabeceras, sesiones y etiquetas en las que se basa esta guía.
- ¿Por qué va lento mi agente LLM?: el mismo método aplicado a la latencia.
- Cómo depurar un agente LLM: de la queja de un usuario a la llamada que falló.
- Coste de Claude Code por subagente: la misma vista de sesión para un agente de programación, donde las escrituras en caché suponen el 77% de una ejecución.
- Consulta a Claude sobre tus logs de LLM: cómo encontrar las sesiones más caras mediante MCP.
- Dale a tu agente herramientas para consultar logs: cómo leer el mismo log desde tu propio programa y cuánto cuestan los tokens del modelo.
- Caché de prompts: longitudes mínimas de prefijo y precios por proveedor.
- El mejor LLM para cada caso de uso: costes según el patrón de carga de trabajo, para elegir el modelo de cada paso.