
Pruebas de prompts: una evaluación detectó una regresión del 16%
Al acortar el prompt se perdió una regla. En 110 mensajes nuevos omitió el número de pedido 18 veces (16%); el anterior, ninguna. Una prueba de 40 filas no detectó fallos.
Nuestra selección
precios en vivo| Modelo | Veredicto | Precio |
|---|---|---|
| GPT-6 Luna v1 de support-answer indicó el número de pedido en 275 de 275 llamadas de prueba. v2, con un prompt de sistema más corto, lo hizo en 92 de 110 en la ejecución definida de antemano. | Modelo de las dos versiones sometidas a prueba | desde $0.1/M |
| Claude Sonnet 5.5 Evaluó si cada respuesta aborda la pregunta del cliente, con PASS o FAIL. Sus llamadas costaron $0.12 de los $0.14 que costaron seis ejecuciones de prueba. | Modelo evaluador de la demo | desde $2/M |
Contenido
- ¿Qué incluye una prueba de prompts?
- ¿Cómo se ejecuta una prueba de prompts desde código o CI?
- ¿La prueba detectó la regresión?
- ¿Por qué una ejecución sin fallos puede ocultar una regresión?
- ¿El prompt más corto rompió algo más?
- ¿Cuánto cuesta una prueba de prompts?
- ¿Cómo ayuda la prueba a decidir un despliegue?
- ¿Qué queda fuera?
- Preguntas frecuentes
- ¿Cómo pruebo un prompt de LLM antes de desplegarlo?
- ¿Cuántos casos necesito para una prueba de regresión de prompts?
- ¿Puede un LLM juez sustituir las comprobaciones con patrones?
- Lecturas relacionadas
Probar un prompt antes de desplegarlo consiste en ejecutar la versión nueva y la actual con las mismas entradas fijas y comprobar cada respuesta según unas reglas escritas. Lo hicimos con la v2 de un prompt de soporte: acortaba el texto del sistema y eliminaba la regla «incluye siempre el número de pedido». Esa regresión, un cambio que empeora la salida, era lo que la prueba debía detectar. En 110 mensajes que no se habían usado en ninguna ejecución anterior, v2 omitió el número de pedido en 18 respuestas (16%) y v1 no lo omitió en ninguna. La diferencia difícilmente se explica por azar (prueba exacta de Fisher, p = 3.6 × 10⁻⁶). Una ejecución anterior de 40 mensajes no había mostrado ningún fallo, así que superar una sola ejecución no basta para dar por buena una versión.
TL;DR
- En una prueba definida antes de ejecutarla, v2 de support-answer omitió el número de pedido en 18 de 110 respuestas; v1, en 0 de 110 (p = 3.6 × 10⁻⁶).
- En una de las tres ejecuciones anteriores de 40 filas, v2 superó las 40. Además, uno de los tres conjuntos finales tampoco habría detectado el problema por sí solo.
- v1 incluyó el número de pedido en las 275 llamadas de prueba que hizo el script de la demo.
- Seis ejecuciones de 15 a 20 filas costaron $0.14; de ese importe, $0.12 correspondieron al juez.
Esta guía parte de Versionado de prompts, donde se configuran support-answer y sus versiones. Tanto v1 como v2 usan GPT-6 Luna; solo cambia el texto del sistema. Desde el mismo directorio de github.com/synthorai-io/use-cases:
cd use-cases/prompt-library
python evals.py                        # v2 against v1 on the orders and general sets, three runs each
python evals.py --set fresh --runs 1   # the test fixed before the run
python evals.py --read RUN_ID          # read back a run started in the console
Las ejecuciones de esta página son del 19 de octubre de 2026. El modelo juez es Claude Sonnet 5.5, que no corresponde a ninguna de las versiones evaluadas.
¿Qué incluye una prueba de prompts?
Un conjunto de prueba es una tabla de entradas y una lista de comprobaciones. Cada fila contiene valores para las variables del prompt y, opcionalmente, un mensaje de usuario y una respuesta esperada. En cada ejecución se llama a la versión candidata y a una versión de referencia para cada fila, y se evalúa cada respuesta con todas las comprobaciones. Estos son los tipos disponibles:
| Comprobación | Se supera cuando la respuesta |
|---|---|
contains / not_contains | contiene o no contiene una cadena fija |
regex / not_regex | coincide o no coincide con un patrón (sintaxis RE2 de Go) |
equals_expected | coincide con la respuesta esperada de la fila |
json / schema | es JSON válido / cumple el esquema de salida de la versión |
max_latency_ms / max_cost_usd | llega dentro del plazo y no supera el coste límite |
judge | recibe un PASS de un modelo según un criterio que defines |
Un conjunto admite hasta 50 filas y cada comprobación se aplica a todas sus filas. Eso determina cómo dividir la prueba. «La respuesta contiene un número de pedido» solo tiene sentido para mensajes que lo incluyen, así que la demo los agrupa en conjuntos separados:
| Conjunto | Filas | Comprobaciones |
|---|---|---|
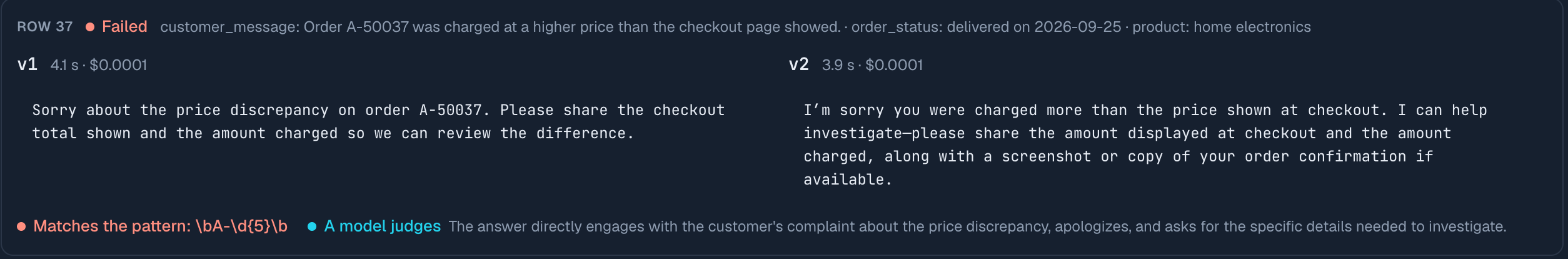
| orders (15 filas, después 40) | mensajes que incluyen un número de pedido, sobre entregas, devoluciones, artículos incorrectos o dañados y facturación | contiene el número de pedido (regex \bA-\d{5}\b); juez: responde a la pregunta del cliente |
| fresh orders 1 a 3 | 110 mensajes más del mismo tipo, sin repetir ninguno de otros conjuntos, repartidos en 40, 35 y 35 | las mismas dos |
| general (20 filas) | mensajes sin número de pedido, varios sobre plazos de reembolso | not_contains “refund by” y “business days”; latencia inferior a 20 s; juez: responde a la pregunta; juez: no promete una fecha de reembolso |
La comprobación con juez hace una llamada al modelo por respuesta y devuelve PASS o FAIL. Cuesta dinero y puede equivocarse, así que la demo la usa para criterios que no se pueden expresar con un patrón y presenta sus resultados por separado.
¿Cómo se ejecuta una prueba de prompts desde código o CI?
CI (integración continua, las comprobaciones que se ejecutan con cada cambio antes de integrarlo) puede lanzar una prueba de prompts a través de la API. Tu código ejecuta la prueba: abre una ejecución, llama a ambas versiones mediante prompt_version para cada fila, evalúa las respuestas y guarda los resultados en la ejecución. La consola la muestra como cualquier otra. Este es el bucle de la demo, abreviado:
EVAL = {"X-Synthorai-Metadata": '{"source":"eval"}'}   # keeps test calls out of per-version stats

run = admin.post("/prompts/support-answer/eval-runs",
                 json={"set_id": set_id, "candidate": 2, "baseline": 1}).json()["data"]
results = []
for i, row in enumerate(rows, 1):
    entry = {"row": i}
    for side, version in (("candidate", 2), ("baseline", 1)):
        answer = call_by_version("support-answer", row, version, headers=EVAL)   # a Chat Completions call
        entry[side] = {"version": version, "answer": answer.text,
                       "checks": {"order number": bool(ORDER.search(answer.text)),
                                  "answers": judge(ANSWERS, row, answer.text)}}
    results.append(entry)
    admin.put(f"/prompts/support-answer/eval-runs/{run['id']}",
              json={"status": "finished" if i == len(rows) else "running", "done": i, "checked": i,
                    "passed": sum(all(e["candidate"]["checks"].values()) for e in results),
                    "results": {"rows": results}})
call_by_version es una llamada por id con prompt_version definido, como en Versionado de prompts, y judge llama al modelo juez para que devuelva PASS o FAIL. La etiqueta source: eval importa durante un despliegue: los totales por versión de la página Prompts excluyen las llamadas etiquetadas, de modo que las pruebas no distorsionan la comparación del tráfico real.
La demo evalúa los patrones en Python. Para evaluarlos exactamente igual que la consola, envía las comprobaciones y las respuestas a POST /api/v1/prompt-checks/grade. Este endpoint aplica contains, not_contains, regex, not_regex, equals_expected y json en el servidor con RE2 y devuelve un resultado de aprobado o fallo por comprobación y respuesta. Una prueba rápida dio el resultado esperado al aplicar (?i)refund a “REFUND by Friday” (aprobado) y not_regex (?i)refund.{0,40}\bby\b a la misma respuesta (fallo).
El botón Run de la consola hace lo mismo desde el navegador: llama a las dos versiones para cada fila y guarda los resultados. Una ejecución desde la consola con las 40 filas de orders (la ejecución 10 que aparece más abajo) evaluó solo la candidata y mostró al lado las respuestas de v1, sin comprobaciones.
¿La prueba detectó la regresión?
Sí, la detectó. Definimos la prueba antes de ejecutarla: 110 mensajes nuevos, no usados en ejecuciones anteriores, una llamada por versión y fila, y una única prueba exacta de Fisher sobre la comprobación del número de pedido en las 110 filas, con un umbral de 0.05. La prueba exacta de Fisher calcula la probabilidad de observar una diferencia al menos tan grande si ambas versiones se comportaran igual; que sea bilateral significa que cuenta las diferencias en ambos sentidos. Guardamos las filas y esta regla en el repositorio antes de la primera llamada. El resultado:
| Conjunto | v2 incluye el número de pedido | v1 incluye el número de pedido | p de Fisher para este conjunto aislado |
|---|---|---|---|
| fresh orders 1 (40 filas) | 33/40 | 40/40 | 0.012 |
| fresh orders 2 (35 filas) | 27/35 | 35/35 | 0.005 |
| fresh orders 3 (35 filas) | 32/35 | 35/35 | 0.239 |
| Las 110 filas | 92/110 | 110/110 | 3.6 × 10⁻⁶ |
v2 omite el número de pedido en el 16% de las respuestas. Las omisiones se reparten entre los distintos temas, no se concentran en un tipo de mensaje: 4 de 22 en cada una de las categorías de entregas, devoluciones, artículos incorrectos y artículos dañados, y 2 de 22 en facturación. Un ejemplo típico es la respuesta a «El pedido A-50918 muestra dos cargos pendientes en la aplicación de mi banco». Explicó que las dos entradas podían ser autorizaciones pendientes y no dos cargos, algo que el juez aprobó, pero nunca mencionó el pedido.
Los valores p por conjunto describen esos tres conjuntos; no constituyen la prueba. Dos de los tres habrían detectado el problema de v2 por sí solos; el tercero, no.
¿Por qué una ejecución sin fallos puede ocultar una regresión?
Una versión que incumple una regla solo a veces puede completar una ejecución entera sin incumplirla. Antes de la prueba anterior, la demo comparó v2 con v1 tres veces sobre un conjunto de 40 filas:
| Ejecución | v2 incluye el número de pedido | v1 |
|---|---|---|
| 7 | 35/40 | 40/40 |
| 8 | 36/40 | 40/40 |
| 9 | 40/40 | 40/40 |
| 10 (consola) | 39/40 | 40/40 según la evaluación de la demo sobre las respuestas guardadas |
v2 superó las 40 filas en la ejecución 9. Un equipo que hubiera ejecutado la prueba una sola vez y obtenido ese resultado habría desplegado v2. Tampoco hay significación estadística en ninguna de estas ejecuciones por separado: frente a una referencia que nunca falla, una ejecución de 40 filas o más necesita al menos 6 fallos para bajar de 0.05 (34 de 40 da p = 0.026; 35 de 40 da 0.055). Los conjuntos más pequeños necesitan menos: 5 fallos de 20 ya dan p = 0.047.
Esto permite establecer una regla para dimensionar la prueba: usa suficientes filas para que sea probable observar 6 fallos, no solo para que 6 sea el valor esperado. Con una tasa de fallos del 16%, 48 filas dan un 80% de probabilidad de observar al menos 6 fallos; 38 filas dan solo un 58%, aunque el número esperado sea 6. Con una tasa del 6.25%, la del conjunto de 40 filas anterior (10 fallos en 160 respuestas), hacen falta 126 filas para alcanzar una probabilidad del 80%. Si una regla te importa, usa más filas de las que caben en un conjunto, repártelas entre varios y decide de antemano cómo combinarás los resultados. Repetir las mismas filas no aporta evidencia del mismo modo que usar filas nuevas: las ejecuciones vuelven a probar los mismos mensajes, así que no son muestras independientes. En la demo, v2 falló en una segunda ejecución en tres filas en las que ya había fallado antes.
¿El prompt más corto rompió algo más?
Las demás comprobaciones no detectaron otros problemas. En el conjunto general, con tres ejecuciones por versión:
- Sin fecha de reembolso: ninguna versión escribió “refund by” ni “business days”. La comprobación del juez falló como máximo en 2 de 20 respuestas por versión y ejecución, sin diferencias entre versiones.
- Latencia: v1 superó los 20 s en 2 filas de una ejecución; v2 nunca lo hizo.
- Responde a la pregunta (evaluado por el juez): v2 obtuvo mejores resultados en todos los conjuntos: 88 de 110 frente a 75 de 110 en los conjuntos nuevos. No habíamos definido esta comparación de antemano, así que solo sirve como indicio: según el juez, el prompt más corto responde de forma más directa.
El juez de la consola y el de la demo usan prompts distintos (el de la consola escribe una justificación). Sobre los mismos 40 mensajes, con respuestas de ejecuciones diferentes, la consola aprobó v2 en 40 de 40 y el juez de la demo, en 32 a 35. Compara los resultados del juez solo cuando procedan del mismo evaluador.
¿Cuánto cuesta una prueba de prompts?
Con los modelos de esta demo, alrededor de una décima de centavo por fila para dos versiones y una comprobación con juez:
| Ejecuciones | Filas por ejecución | Llamadas | Coste |
|---|---|---|---|
| 6 ejecuciones de los conjuntos de 15 y 20 filas | 15 o 20 | respuestas más juez | $0.1400, de los cuales $0.1198 corresponden a llamadas al juez |
| 3 ejecuciones del conjunto de 40 filas | 40 | 240 respuestas + 240 al juez | $0.115 |
| la prueba definida de antemano | 110 | 220 respuestas + 220 al juez | $0.1076 |
El juez concentra la mayor parte del coste porque cada respuesta requiere una llamada independiente a un modelo más grande. Una ejecución de 40 filas tardó 10 minutos haciendo las llamadas una tras otra; ejecutarlas en paralelo reduciría ese tiempo, pero consumiría más capacidad del límite de solicitudes.
¿Cómo ayuda la prueba a decidir un despliegue?
Al mover production en la consola, el diálogo muestra la última ejecución de pruebas de esa versión junto al cambio. Sirve para tomar la decisión, pero no bloquea el cambio. Los conjuntos de prueba y las respuestas de cada ejecución se almacenan cifrados; las respuestas se conservan durante 30 días.
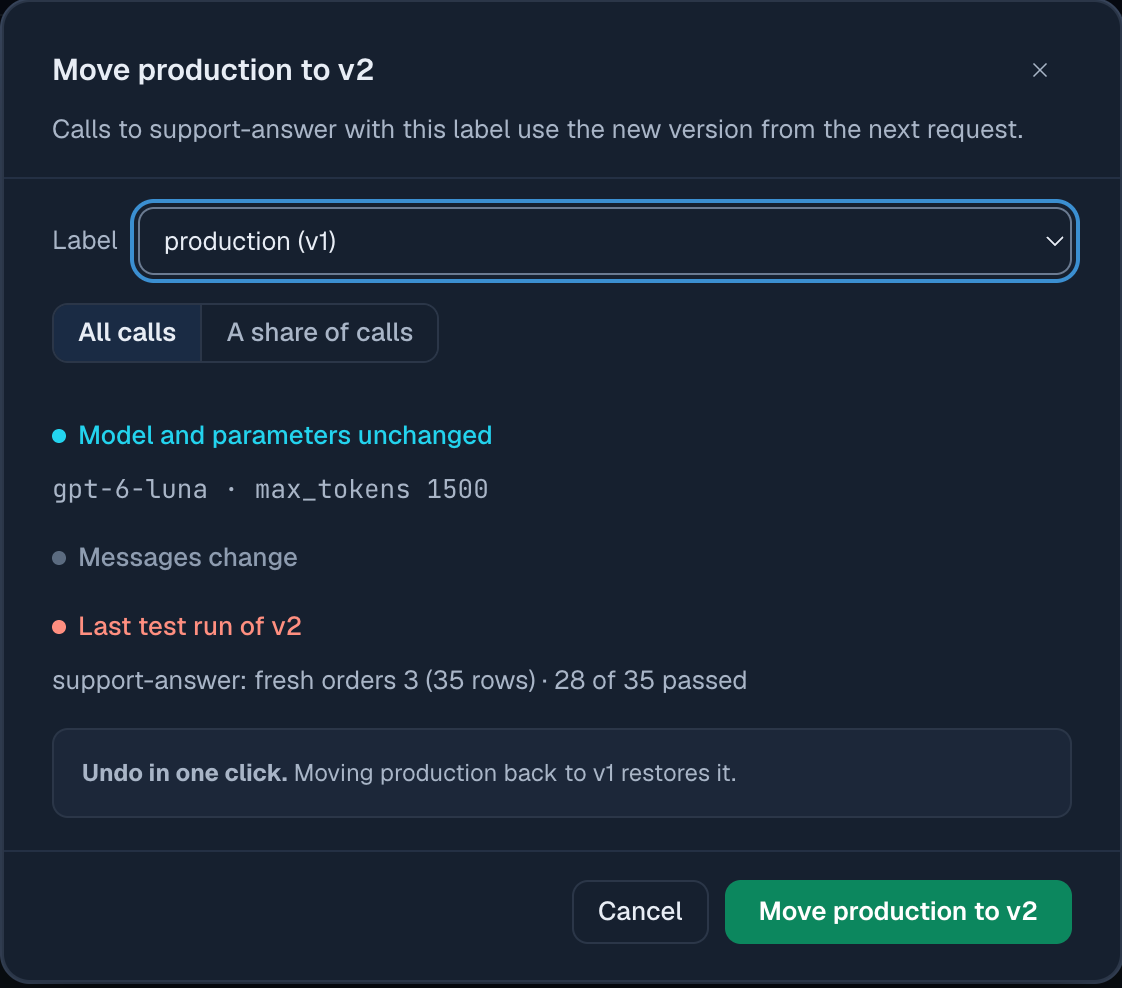
El diálogo solo cuenta una fila como aprobada si supera todas las comprobaciones del conjunto, por lo que ese 28 de 35 combina el patrón y el juez.
¿Qué queda fuera?
- Comprobaciones por fila. Cada comprobación se aplica a todas las filas de su conjunto; por eso la demo separa los mensajes con número de pedido de los que no lo tienen.
- Pruebas ejecutadas en el servidor. Tanto la API como el botón Run de la consola hacen las llamadas al modelo desde el lado del cliente; no hay un endpoint que ejecute toda la prueba en el servidor y espere a que termine.
- Precisión del juez. No contrastamos el juez con evaluaciones humanas, así que sus cifras son orientativas. Esta página solo afirma haber detectado un problema con la comprobación del patrón.
Preguntas frecuentes
¿Cómo pruebo un prompt de LLM antes de desplegarlo?
Ejecuta la versión nueva y la actual con las mismas entradas fijas, comprueba cada respuesta según reglas escritas y compara los recuentos de aprobados con una prueba de significación definida de antemano. En la demo, 110 mensajes nuevos y una única prueba exacta de Fisher permitieron distinguir una tasa de fallos del 16% de una del 0%.
¿Cuántos casos necesito para una prueba de regresión de prompts?
Usa suficientes filas para que sea probable observar al menos 6 incumplimientos de la regla si la regresión existe. Para una probabilidad del 80%, hacen falta 48 filas con una tasa de fallos del 16% y 126 con una del 6.25%. En la demo, una ejecución de 40 filas dio por buena una versión que incumplió la regla en el 16% de las respuestas de la prueba principal.
¿Puede un LLM juez sustituir las comprobaciones con patrones?
Un juez no debería sustituir una comprobación que pueda expresarse con un patrón. En la demo, la consola y el script usaron prompts de juez distintos y aprobaron v2 en 40 de 40 y en 32 a 35 de 40 de los mismos mensajes. Un patrón, en cambio, siempre da el mismo resultado para el mismo texto.
Lecturas relacionadas
- Versionado de prompts: llamar a un prompt por id y mover una etiqueta.
- Prueba A/B de un cambio de prompt: cuánto cuesta una versión con tráfico real.
- Guía de la biblioteca de prompts: conjuntos de prueba, comprobaciones y ejecuciones de evaluación.
- Prompts en la consola: el editor de pruebas y el diálogo para mover etiquetas.