
Traza un agente LLM con 3 cabeceras HTTP, sin SDK de trazado
Añade tres cabeceras a las llamadas del agente al modelo y obtén una cascada de cada ejecución: llamadas paralelas, tiempo en tu código, fallos y coste.
Nuestra selección
precios en vivo| Modelo | Veredicto | Precio |
|---|---|---|
| GPT-6 Luna Gestiona el bucle de llamadas a funciones de la demo. Sus dos llamadas por turno (planificación y respuesta) cuestan $0.0002 en total en la ejecución mostrada en esta página. | Agente principal de la demo | desde $0.1/M |
| DeepSeek V4.1 Flash Ejecuta las tres comprobaciones de una frase en paralelo con el razonamiento desactivado. Sus seis llamadas en la sesión mostrada en esta página cuestan $0.0004, y una séptima llamada al subagente falló con un coste de $0. | Subagente de la demo | desde $0.3/M |
Contenido
- ¿Qué hay que enviar para obtener una traza?
- ¿Qué hace el agente de la demo?
- ¿Cómo se interpreta la cascada?
- ¿Qué aporta una sesión respecto a una traza?
- ¿Cómo se desglosa el coste por funcionalidad o por usuario?
- ¿Qué ocurre cuando falla una llamada?
- ¿Cómo se obtiene el coste de cada llamada desde el código?
- ¿Y si tu agente ya envía cabeceras de trazado?
- ¿Qué puedes hacer con una traza?
- ¿Qué queda fuera?
- Preguntas frecuentes
- ¿Necesito OpenTelemetry para trazar un agente LLM?
- ¿Qué diferencia hay entre una traza y una sesión?
- ¿Las cabeceras de trazado cambian el enrutamiento, la facturación o lo que ve el modelo?
- ¿Cuánto tiempo se conservan las trazas?
- ¿Una llamada fallida tiene algún coste?
- Lecturas relacionadas
Si un agente hace cinco llamadas al modelo para responder a un mensaje, depurarlo con un simple registro de peticiones resulta difícil. No puedes saber qué llamadas pertenecen a la misma ejecución, cuáles se hicieron en paralelo ni cuánto tiempo se dedicó a ejecutar tu propio código. En esta guía añadimos tres cabeceras de petición a un pequeño agente de soporte y consultamos el resultado en la consola de Synthorai: una traza (una ejecución representada en una línea temporal) y una sesión (una conversación con su coste). No hay que instalar ningún SDK de trazado ni ejecutar un collector (un servicio aparte que recibe las trazas). El código está en github.com/synthorai-io/use-cases, dentro de agent-tracing/. Necesita Python 3.10 o posterior y una API key de la consola.
TL;DR
- Tres cabeceras de petición (
X-Trace-Id,X-Span-Id,X-Session-Id) en cada llamada al modelo convierten el registro de peticiones en trazas y sesiones en la consola de Synthorai, sin SDK de trazado. - En la traza de la demo, los 8.5 s de tiempo total se reparten en unos 7.0 s de llamadas al modelo y 1.6 s fuera de ellas, entre el código del agente y la red.
- Una llamada fallida, con un 404, quedó registrada en la traza y costó $0.
- La ejecución de la demo, con 21 llamadas al modelo, costó $0.0017.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put your API key in it
cd agent-tracing
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python run.py --fail
La ejecución hizo 21 llamadas al modelo en menos de un minuto y costó $0.0017 cuando la probamos el 11 de octubre de 2026. Imprime dos ids de sesión y cuatro ids de traza. Abre Trazas en la consola y encontrarás esos mismos ids. La consola muestra las horas en la zona horaria del navegador, por eso las capturas de estas páginas muestran las 19:24 para las 11:24 UTC.
¿Qué hay que enviar para obtener una traza?
Envía tres cabeceras en cada llamada al modelo, con los valores de texto que elijas. El gateway ya registra todas las peticiones. Las cabeceras solo le indican cuáles están relacionadas.
| Cabecera | Usa el mismo valor en | Qué obtienes |
|---|---|---|
X-Trace-Id | todas las llamadas de una ejecución (el procesamiento de un mensaje de usuario de principio a fin) | las llamadas representadas en una sola cascada |
X-Span-Id | una sola llamada | el nombre de la fila de esa llamada en la cascada |
X-Session-Id | todas las llamadas de una conversación | las ejecuciones agrupadas, con los totales de la conversación |
Un span es un paso dentro de una traza. En esta guía, cada span corresponde a una llamada al modelo. Cada id admite hasta 128 caracteres ASCII imprimibles. El gateway devuelve los ids en la respuesta y no los reenvía al proveedor del modelo.
Hay otras tres cabeceras opcionales. X-Agent-Id indica qué subagente hizo la llamada, X-Parent-Agent-Id indica qué agente inició ese subagente y X-Synthorai-Metadata lleva etiquetas, como la funcionalidad o el usuario final. Todas están documentadas en la referencia de cabeceras de petición. La demo envía X-Agent-Id y etiquetas, pero no X-Parent-Agent-Id: el agente principal inicia el único subagente, así que no hay niveles de anidamiento que describir.
En la demo, una función construye las cabeceras de cada llamada. Esa función es toda la capa de trazado:
@dataclass
class Run:
    """One agent run, which the gateway shows as one trace."""
    session_id: str
    labels: dict = field(default_factory=dict)
    trace_id: str = field(default_factory=lambda: new_id("trace"))

    def headers(self, span: str, agent: str | None = None, parent: str | None = None) -> dict:
        h = {
            "X-Session-Id": self.session_id,
            "X-Trace-Id": self.trace_id,
            "X-Span-Id": span,
        }
        if agent:
            # Only sub-agents need an id. Calls without one belong to the main agent.
            h["X-Agent-Id"] = agent
        if parent:
            h["X-Parent-Agent-Id"] = parent
        if self.labels:
            h["X-Synthorai-Metadata"] = json.dumps(self.labels, separators=(",", ":"))
        return h
Todas las llamadas al modelo del agente pasan por un wrapper que añade esas cabeceras. En el SDK de OpenAI para Python, las cabeceras de cada petición se pasan en extra_headers:
raw = await client.chat.completions.with_raw_response.create(
    model=model, messages=messages,
    extra_headers=run.headers(span, agent, parent), **kwargs)
resp = raw.parse()
request_id = raw.headers.get("x-request-id")   # the gateway's id for this call
with_raw_response solo se usa para leer las cabeceras de respuesta. Si no necesitas el id de la petición, basta con create(..., extra_headers=...).
¿Qué hace el agente de la demo?
Responde a un mensaje de un cliente en cuatro etapas y con cinco llamadas al modelo. Este flujo se ha elegido para que haya algo que analizar en la traza. El agente principal usa GPT-6 Luna y el subagente, DeepSeek V4.1 Flash; ambos se configuran mediante variables de entorno. Las llamadas del subagente usan reasoning_effort="none", porque una comprobación de una frase no necesita que el modelo razone antes. Si configuras el subagente con un modelo que rechaza ese valor, cambia o vacía ANALYST_REASONING.
| Span | Quién | Qué ocurre |
|---|---|---|
plan | agente principal | lee el mensaje y solicita herramientas (function calling: el modelo devuelve el nombre de una función y sus argumentos para que tu código la ejecute) |
| ninguno | tu código | ejecuta las dos herramientas locales en paralelo: una consulta de pedidos (1.2 s) y una búsqueda de políticas (0.6 s) |
sentiment, policy-check, risk | subagente analyst | tres comprobaciones de una frase, enviadas a la vez |
answer | agente principal | redacta la respuesta a partir de los resultados de las herramientas y las tres comprobaciones |
Las herramientas son funciones de Python con un sleep que simulan una base de datos y un índice de búsqueda. Con --fail, una llamada policy-check pide primero un modelo que no existe, recibe un 404 y se reintenta con el nombre de span policy-check.retry.
run.py reproduce dos conversaciones de dos turnos cada una. Cada conversación recibe un id de sesión y cada turno, un nuevo id de traza:
session_id, history = new_id("support"), []
for text in turns:
    run = Run(session_id, labels={"feature": "support-agent", "release": "v2", "_user": user})
    reply = await handle(run, history, text)
¿Cómo se interpreta la cascada?
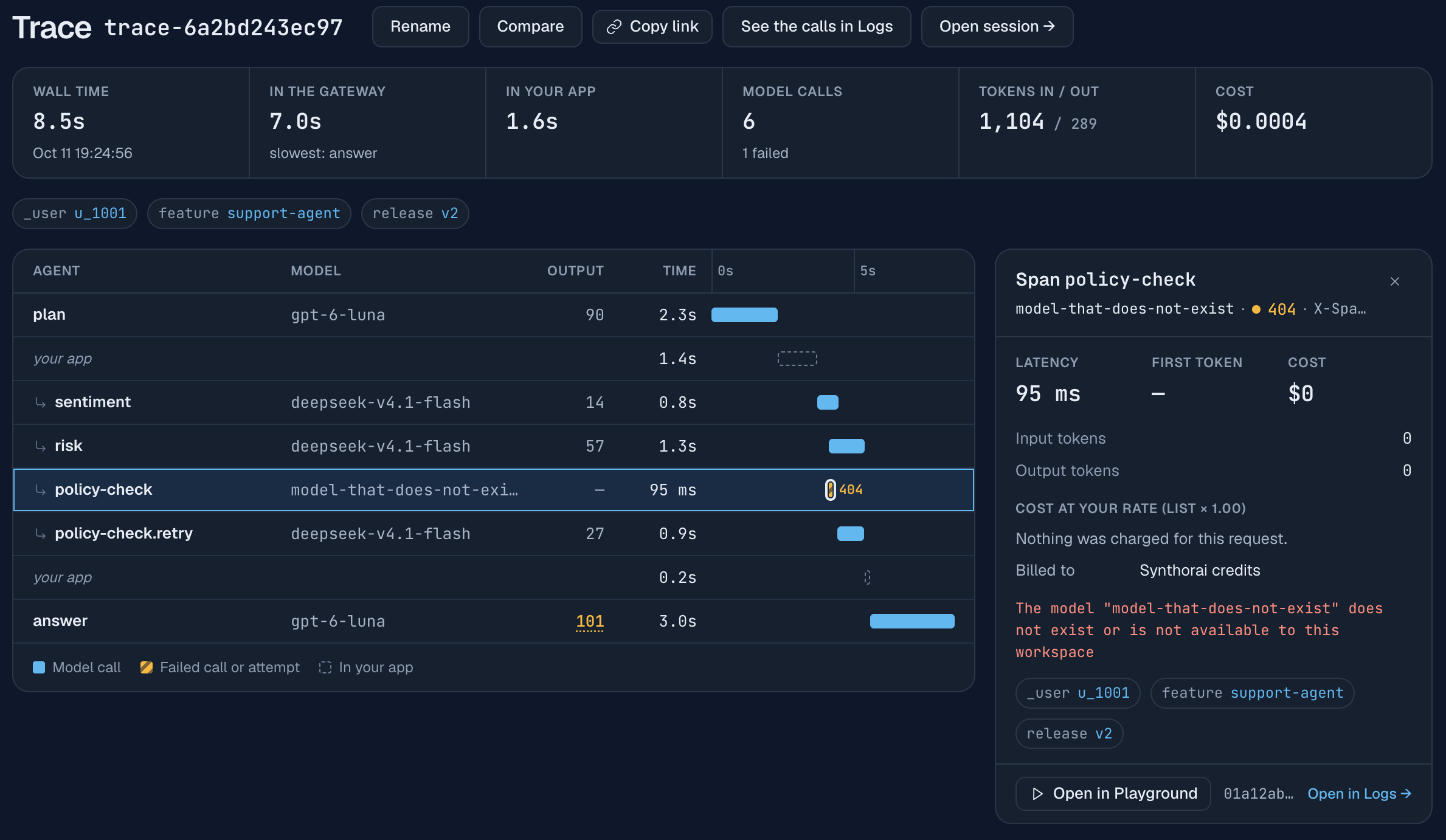
Cada fila representa una llamada al modelo o un intervalo dedicado a tu código. Las filas se sitúan sobre un eje temporal que comienza cuando la primera llamada de la ejecución llega al gateway. La captura anterior corresponde al segundo turno de la primera conversación. De arriba abajo:
plantardó 2.3 s. Su barra muestra el tiempo que el gateway dedicó a esa petición, desde que la recibió hasta que terminó de enviar la respuesta.your apptardó 1.4 s. No había ninguna petición abierta durante ese intervalo, así que el tiempo se consumió fuera del gateway: en tu código y en la red entre tu código y el gateway. Aquí corresponde a las dos herramientas locales; la más lenta tiene unsleepde 1.2 s. En un agente real, esta fila permite detectar una consulta lenta a la base de datos o una búsqueda vectorial lenta.sentiment,riskypolicy-check.retryse solapan. El agente envió las tres comprobaciones conasyncio.gather. Las barras solapadas indican llamadas en paralelo. La flecha delante de sus nombres identifica las llamadas de un subagente.policy-checkaparece como una marca rayada de 95 ms con404. Las llamadas fallidas permanecen en la traza con el código de estado que recibió tu código.answertardó 3.0 s y es la llamada más lenta, como también indica el resumen situado encima de la cascada.- La columna Salida muestra los tokens de salida de cada llamada. Una llamada dedica su tiempo a generar la salida, así que esta columna suele explicar la longitud de la barra que tiene al lado:
answergeneró 101 tokens y las tres comprobaciones, entre 14 y 57 cada una. La consola subraya el recuento cuando la mayor parte de una salida más larga corresponde al razonamiento, como ocurre aquí con los 101.
El resumen reparte los 8.5 s de tiempo total entre 7.0 s en el gateway y 1.6 s en tu aplicación. Ese desglose responde a la primera pregunta de la mayoría de las investigaciones de latencia: si hay que revisar las llamadas al modelo o tu propio código. En esta ejecución, el 82% de la espera correspondió al modelo. Las dos llamadas del agente principal, plan y answer, suman 5.3 s de ese tiempo, así que usar un modelo más rápido para el agente principal ayudaría más que acelerar las tres comprobaciones.
El gateway no puede ver qué ocurre dentro de tu código. Deduce las filas your app a partir de los intervalos entre peticiones: un intervalo indica cuánto tiempo estuvo ejecutándose tu código, pero no qué hizo. Si necesitas spans para tus propias funciones, usa un SDK de OpenTelemetry, el estándar abierto de trazado. Ambos pueden compartir ids: cuando no envías X-Trace-Id, el gateway lee traceparent, la cabecera estándar que contiene un id de traza.
¿Qué aporta una sesión respecto a una traza?
Una sesión agrupa las ejecuciones de una conversación y calcula sus totales. Puedes abrirla desde la lista de Trazas o usar «Abrir sesión» en cualquier traza.
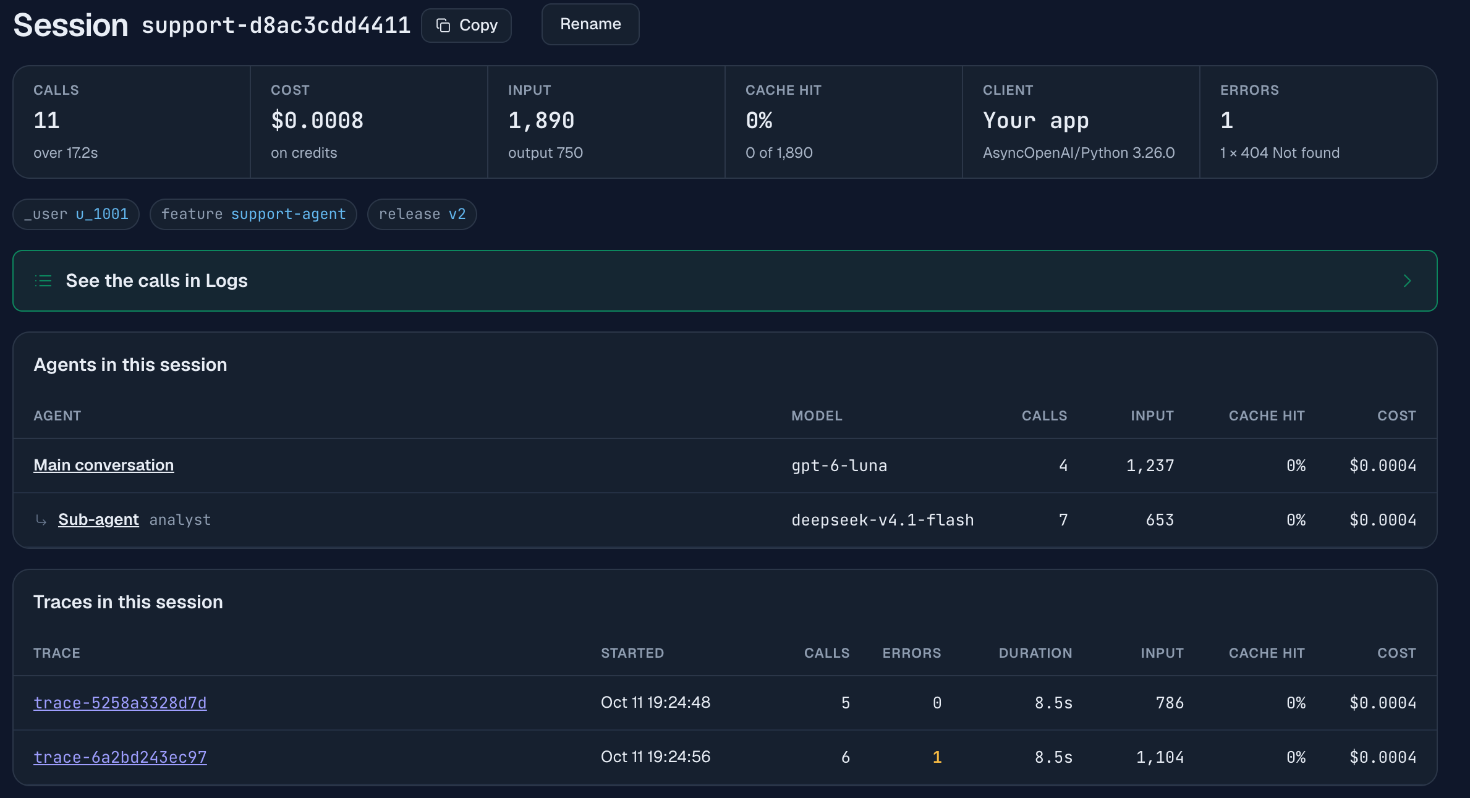
La sesión anterior corresponde a una conversación de dos turnos con un cliente: 11 llamadas, 1,890 tokens de entrada y 750 de salida, $0.0008 y un error. La página tiene tres partes:
- Agentes de esta sesión desglosa las llamadas y el coste por agente. El agente principal hizo 4 llamadas a GPT-6 Luna por $0.0004 y el subagente
analysthizo 7 llamadas por $0.0004: seis a DeepSeek V4.1 Flash y una fallida. Esta tabla aparece porque las llamadas del subagente llevabanX-Agent-Id: analyst. Las llamadas sin esa cabecera se contabilizan como parte de la conversación principal. - Trazas de esta sesión enumera cada turno con sus errores, duración, tokens de entrada, aciertos de caché y coste. Así puedes localizar el turno lento, fallido o caro de una conversación larga sin recorrer un registro.
- Aciertos de caché es la proporción de tokens de entrada leídos de la caché de prompts del proveedor. Aquí es del 0% porque los prompts solo tienen unos cientos de tokens y los proveedores solo almacenan prefijos que superan una longitud mínima (1,024 tokens en la mayoría de ellos; consulta la caché de prompts).
El id de sesión tiene otra función cuando los prompts ya son lo bastante largos para almacenarse en caché. Envía el mismo X-Session-Id en todas las llamadas de una conversación: el gateway lo usa para mantener la continuidad de los aciertos de caché de prompts, de modo que el segundo turno lea la caché que escribió el primero. En /v1/chat/completions y /v1/responses puedes incluir el valor en el cuerpo de la petición como session_id si tu framework dificulta configurar cabeceras.
¿Cómo se desglosa el coste por funcionalidad o por usuario?
Envía X-Synthorai-Metadata con un objeto JSON plano cuyos valores sean cadenas de texto y úsalo para agrupar o filtrar. La demo etiqueta cada llamada con una funcionalidad, una versión y el usuario final:
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}Las etiquetas aparecen como pequeñas marcas en la traza y la sesión. Para ver los totales, abre Analítica, selecciona la pestaña Desglose y busca la tarjeta Coste por metadatos. Elige una clave y aparecerán todos sus valores con sus peticiones, errores, tokens de entrada y coste:
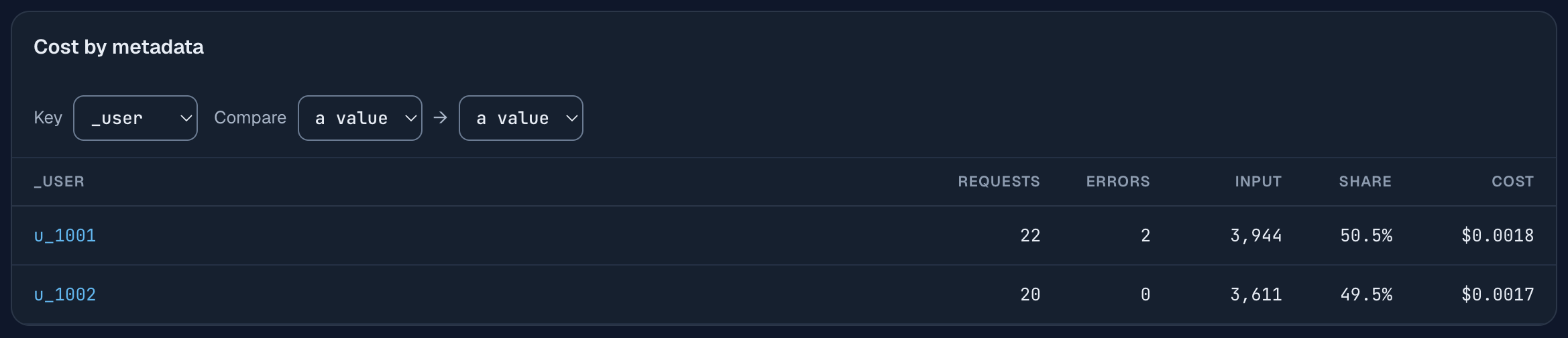
La tarjeta anterior abarca una hora en la que la demo se ejecutó dos veces: 22 peticiones y $0.0018 para u_1001, cuyas ejecuciones incluyen las dos llamadas fallidas, y 20 peticiones y $0.0017 para u_1002. Tras una sola ejecución verás 11 y 10. Elige feature como clave para ver el gasto de cada funcionalidad, o release para comprobar cómo afectó un cambio de prompt al coste. La tarjeta también permite comparar dos valores de una clave. En la misma pestaña, la tarjeta Coste por agente suma cada X-Agent-Id entre sesiones.
Las etiquetas también sirven para buscar las ejecuciones que hay detrás de una cifra. Escribe metadata._user = u_1002 en el cuadro de búsqueda de la lista de Trazas y pulsa Intro: solo quedarán las sesiones y trazas de ese usuario. El cuadro de filtros de Registros acepta la misma expresión para las peticiones individuales.
Las reglas de las etiquetas son sencillas:
- Como máximo, 10 etiquetas por petición. Una clave tiene entre 1 y 32 caracteres de
a-z,0-9,_,.y-. El valor es una cadena de hasta 128 bytes. _useres la etiqueta del usuario final para el que se hizo la petición. Las demás claves que empiezan por guion bajo están reservadas.- Si una etiqueta incumple una regla, se descarta y la petición sigue ejecutándose. La cabecera de respuesta
X-Synthorai-Metadata-Droppedindica las claves descartadas, así que regístrala mientras configuras las etiquetas. Enviamos una clave llamadaBad?Keypara comprobarlo y la cabecera devolvióBad?Key. - No incluyas texto del prompt, datos personales ni secretos en las etiquetas. Para
_user, usa tu id interno de usuario, no una dirección de correo.
¿Qué ocurre cuando falla una llamada?
Permanece en la traza como una marca rayada con su código de estado y no cuesta nada. En la demo, la llamada fallida policy-check solicitó un id de modelo que no existe. Al seleccionarla en la cascada se abre el panel de la derecha de la captura anterior, con el error que recibió el código: The model "model-that-does-not-exist" does not exist or is not available to this workspace, una latencia de 95 ms, un coste de $0 y la indicación de que no se cobró nada.
La demo asigna al reintento su propio nombre de span:
try:
    await call(run, span, model=BROKEN_MODEL, messages=messages, agent="analyst")
except APIStatusError:
    span = f"{span}.retry"      # the retry is its own span, so both show in the waterfall
resp = await call(run, span, model=ANALYST_MODEL, messages=messages, agent="analyst", max_tokens=400,
                  **analyst_options())   # reasoning_effort="none" unless ANALYST_REASONING says otherwise
Mantener el id de traza y cambiar el nombre del span permite ver el fallo y su reintento juntos en una misma vista. Si la lógica de reintentos está en una biblioteca que reutiliza las mismas cabeceras, ambos intentos siguen apareciendo, en dos filas con el mismo nombre.
Los errores también se agregan. El resumen de la traza indica «6 llamadas al modelo, 1 fallida», la sesión enumera sus errores por código de estado (1 × 404 Not found) y la lista de Trazas tiene una columna Errores por la que puedes ordenar para encontrar las ejecuciones que requieren atención.
¿Cómo se obtiene el coste de cada llamada desde el código?
Pide al gateway el registro de facturación de la petición usando el id que devolvió en la respuesta. GET /v1/generation?id=<request id> devuelve el coste, los recuentos de tokens, la latencia y el estado de una petición.
async def cost_of(http: httpx.AsyncClient, request_id: str) -> float | None:
    """The billing record of one request. It is written a moment after the call returns."""
    if not request_id:
        return None                                  # a call that got no response has no record
    for _ in range(6):
        try:
            r = await http.get(f"{BASE_URL}/generation", params={"id": request_id})
            if r.status_code == 200:
                return r.json()["data"]["total_cost"]
        except (httpx.HTTPError, KeyError, TypeError, ValueError):
            pass                                     # a dropped connection or a half-written record: try again
        await asyncio.sleep(2)
    return None
El registro se escribe poco después de terminar la respuesta, así que la función reintenta la consulta hasta recibir un 200. Recibe un httpx.AsyncClient que el código que la llama crea una sola vez, con la cabecera Authorization configurada, y pasa a cada consulta. Consultar veinte llamadas con un solo cliente reutiliza unas pocas conexiones. Crear un cliente nuevo para cada consulta abre veinte conexiones a la vez y, en nuestras pruebas, una o dos se interrumpieron. La demo imprime una línea por llamada a partir de sus propias mediciones de tiempo y de estos registros. Este es el primer turno de la sesión de las capturas:
trace trace-5258a3328d7d  session support-d8ac3cdd4411
  plan                 main     gpt-6-luna                 200   1878 ms    153 in   22 out  $0.000026
  sentiment            analyst  deepseek-v4.1-flash        200   1431 ms     91 in   28 out  $0.000061
  risk                 analyst  deepseek-v4.1-flash        200   1877 ms     96 in   33 out  $0.000068
  policy-check         analyst  deepseek-v4.1-flash        200   1885 ms     96 in   39 out  $0.000076
  answer               main     gpt-6-luna                 200   4142 ms    350 in  339 out  $0.000205
Estos tiempos se miden en el cliente e incluyen la red, por lo que son mayores que los de las barras de la consola, que miden la petición dentro del gateway. En el segundo turno, el de la cascada anterior, plan tardó 2,499 ms en el cliente y 2.3 s en el gateway; answer, 3,161 ms y 3.0 s. Las llamadas enviadas en paralelo pueden presentar diferencias mayores: la llamada fallida tardó 694 ms en el cliente y 95 ms en el gateway.
Copia esta función si quieres incluir el coste facturado de cada llamada en tus registros. No sirve para detener una ejecución que está gastando demasiado: cada registro llega un poco después de la llamada y la función puede esperar varios segundos hasta obtenerlo. Para controlar el presupuesto en tiempo real, calcula tú el coste del usage de cada respuesta durante la ejecución y usa estos registros después para comprobar las cuentas.
¿Y si tu agente ya envía cabeceras de trazado?
Puede que no tengas que añadir nada. Para cada uno de los tres ids que falte en una petición, el gateway lee la cabecera equivalente que ya envían las herramientas habituales:
| Qué ejecutas | Cabecera que envía | Se interpreta como |
|---|---|---|
| Instrumentación HTTP de OpenTelemetry | traceparent | traza, con su id padre como span |
| SDK de LiteLLM | X-Litellm-Trace-Id, X-Litellm-Session-Id | traza, sesión |
| SDK de Langfuse | baggage: langfuse_trace_id=…, langfuse_session_id=… | traza, sesión |
| Open WebUI | X-OpenWebUI-Chat-Id | sesión |
| Claude Code | X-Claude-Code-Session-Id | sesión |
| OpenAI Codex CLI | Session-Id | sesión |
Tus cabeceras X-Trace-Id, X-Span-Id y X-Session-Id tienen prioridad cuando ambas opciones están presentes. La lista completa está en la referencia de cabeceras de petición. Si tu framework de agentes no envía ninguna de ellas, tendrás que añadirlas mediante su configuración de cabeceras personalizadas.
¿Qué puedes hacer con una traza?
Lo más habitual es compararla con otra. Cada página de traza tiene un botón Comparar: elige una segunda traza y la consola muestra ambas en una sola página. Cada métrica aparece con A, B y la variación; cada llamada se empareja con la del mismo nombre, y las dos cascadas comparten un eje temporal. Así puedes comprobar cómo afecta a una ejecución un cambio en el prompt, el modelo o tu código.
Estas tres guías usan el mismo agente y las mismas cabeceras. En cada una se reproducen problemas, se corrigen y se comparan los resultados de esta forma:
- ¿Por qué es lento mi agente LLM? Llamadas secuenciales, una herramienta lenta en tu código y razonamiento para respuestas de una línea.
- ¿Por qué es caro mi agente LLM? Una marca de tiempo que invalida la caché, un contexto que crece, un bucle de reintentos y un modelo inadecuado.
- Depura un agente LLM De la queja de un usuario a la llamada que falló.
Otras tres analizan el mismo registro desde otras perspectivas:
- Coste de Claude Code por subagente Un agente de programación que no has escrito, analizado con las mismas vistas de sesiones y agentes.
- Pregunta a Claude sobre tus registros de LLM Preguntas sobre estas sesiones, respondidas en una ventana de chat mediante una conexión MCP de solo lectura.
- Dale a tu agente herramientas para consultar registros Las mismas herramientas en tu propio programa y el coste de los tokens del modelo.
¿Qué queda fuera?
La demo cubre las llamadas al modelo. Una configuración de producción suele añadir cuatro cosas:
- Spans para tu propio código. El gateway muestra los intervalos entre llamadas al modelo, pero no qué ocurrió durante ellos. Instrumenta las herramientas, la recuperación de información y las colas con OpenTelemetry y propaga
traceparentpara que un mismo id de traza conecte ambas vistas. - Cuerpos de los prompts y las respuestas. Esta guía usa el registro de tiempos, tokens y coste de cada llamada. No cubre la inspección del contenido enviado al modelo.
- Presupuestos.
cost_ofdevuelve el importe facturado a posteriori. Para detener una ejecución al llegar a un límite, hay que calcular el coste delusagede cada respuesta en cuanto llega. Son unas pocas líneas en el bucle del agente que la demo no incluye. - Muestreo. Se registra cada llamada porque la traza se construye a partir del registro de peticiones que el gateway ya mantiene. No hay nada que muestrear y el agente no tiene más sobrecarga que unas pocas cabeceras.
Preguntas frecuentes
¿Necesito OpenTelemetry para trazar un agente LLM?
No. Tres cabeceras de petición (X-Trace-Id, X-Span-Id, X-Session-Id) en cada llamada al modelo bastan para obtener una cascada de las llamadas, con el tiempo entre ellas atribuido a tu aplicación. OpenTelemetry resulta útil cuando también quieres spans para tus propias funciones.
¿Qué diferencia hay entre una traza y una sesión?
Una traza es una ejecución del agente: todo lo que hace para atender un mensaje de usuario o una tarea. Una sesión es una conversación compuesta por varias ejecuciones. En la demo, cada conversación con un cliente es una sesión con dos trazas, y cada traza tiene cinco o seis llamadas al modelo.
¿Las cabeceras de trazado cambian el enrutamiento, la facturación o lo que ve el modelo?
X-Trace-Id y X-Span-Id no cambian nada. X-Session-Id mantiene la continuidad de los aciertos de caché de prompts de una conversación. Ninguna de las cabeceras se reenvía al proveedor del modelo y la facturación usa el id de petición del propio gateway.
¿Cuánto tiempo se conservan las trazas?
Las trazas y sesiones se construyen a partir del registro de peticiones y abarcan los mismos 90 días. La lista de Trazas muestra los últimos 7 días al abrirse.
¿Una llamada fallida tiene algún coste?
La llamada fallida de la demo, un 404 por un id de modelo desconocido, quedó registrada con un coste de $0 y la indicación de que no se cobró nada.
Lecturas relacionadas
- Crea un chatbot con un LLM: el caso de un solo agente, con gestión del contexto, memoria y caché de prompts.
- Referencia de cabeceras de petición: todas las cabeceras de esta página, con los alias que se leen de otras herramientas.
- Trazas y sesiones en la consola: la lista, la cascada y la página de sesión.
- Anatomía del uso de tokens de un LLM: qué significan los recuentos de tokens de cada registro según el proveedor.