
¿Por qué va lento mi agente LLM? 3 causas visibles en una traza
Tres causas de lentitud reproducidas y corregidas: llamadas al modelo en serie (de 3.7 s a 1.8 s), una herramienta lenta en tu código y razonamiento para respuestas de una frase.
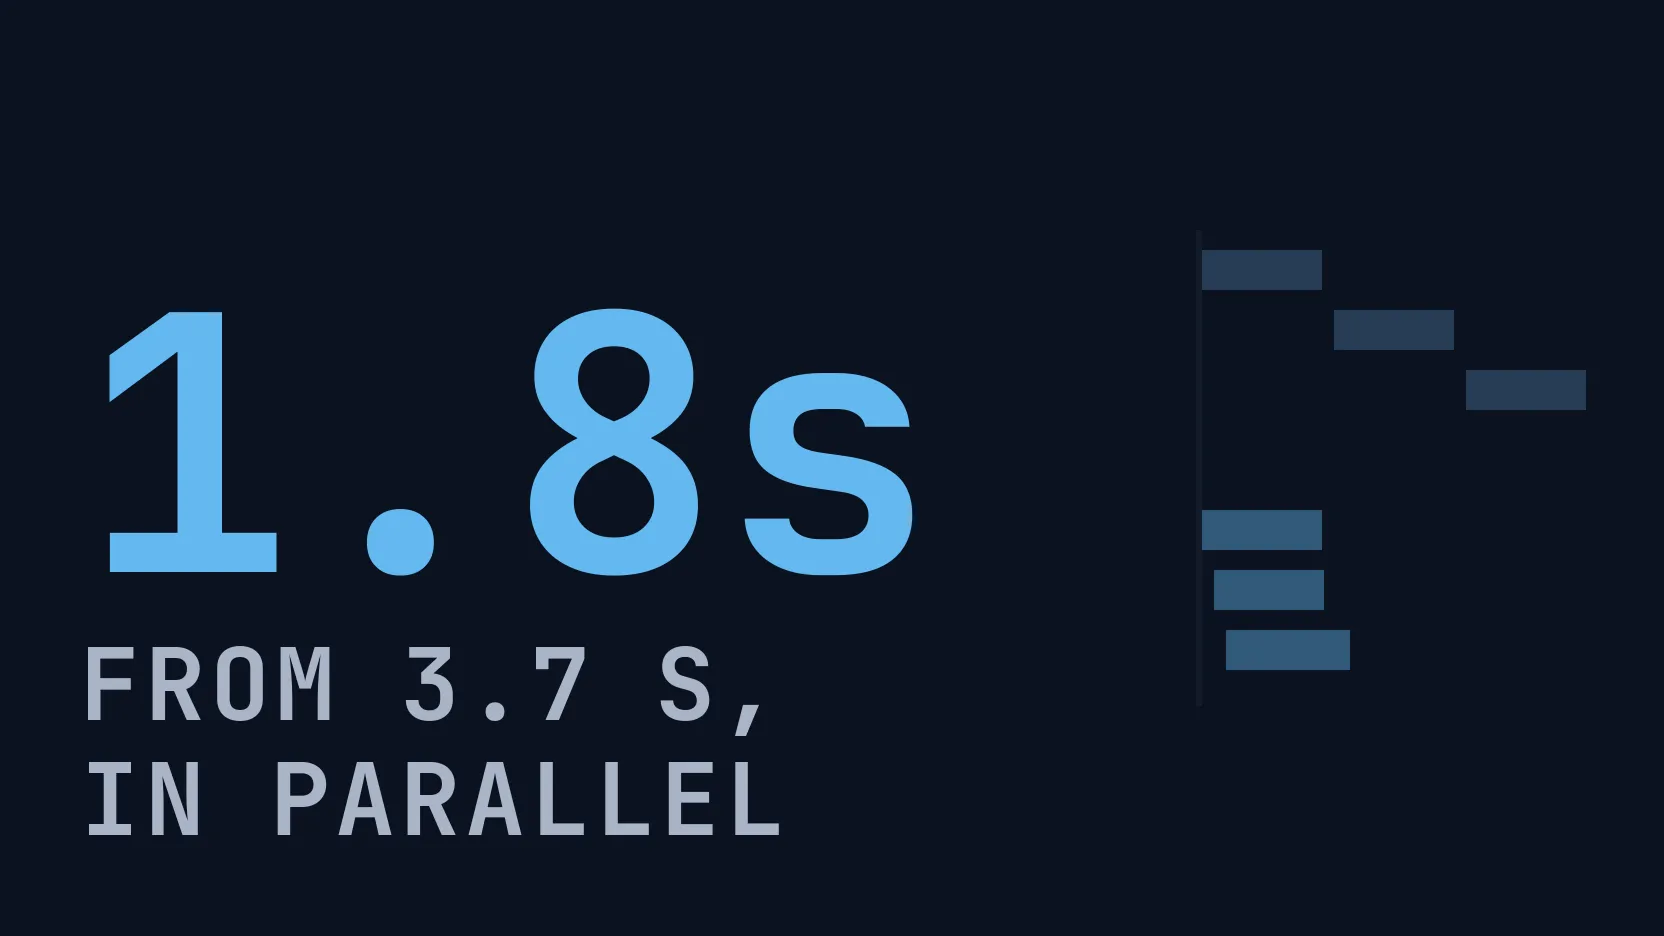
Nuestra selección
precios en vivo| Modelo | Veredicto | Precio |
|---|---|---|
| GPT-6 Luna Cinco respuestas de una frase tardaron una mediana de 25.6 s con el esfuerzo de razonamiento predeterminado y de 10.2 s con reasoning_effort establecido en none, con una reducción de los tokens de salida de 1,150 a 190. | Agente principal de la demo | desde $0.1/M |
| DeepSeek V4.1 Flash Tres comprobaciones de una frase tardaron una mediana de 3.7 s al enviarse una tras otra y de 1.8 s al enviarse juntas, con los mismos 127 tokens de entrada. | Subagente de la demo | desde $0.3/M |
Contenido
- ¿Por dónde empezar cuando un agente tarda demasiado?
- ¿Cómo se ven las llamadas que podrían ejecutarse a la vez pero se ejecutan en serie?
- ¿Cómo saber si la parte lenta está en tu propio código?
- ¿Y si la parte lenta es una sola llamada al modelo?
- ¿Qué queda fuera de esta página?
- Preguntas frecuentes
- ¿Cómo encuentro el paso más lento de un agente LLM?
- ¿Las llamadas LLM en paralelo cuestan más que las llamadas en serie?
- ¿Por qué tarda tanto una llamada al modelo si la respuesta es corta?
- ¿Cómo mido si una corrección ha hecho que mi agente vaya más rápido?
- ¿Puede el gateway mostrar qué hizo mi código entre dos llamadas al modelo?
- Lecturas relacionadas
Un agente lento suele tener uno de estos tres problemas: las llamadas al modelo se esperan entre sí sin necesidad, su propio código tarda demasiado entre llamadas o una llamada al modelo hace más trabajo del que requiere ese paso. Una traza permite distinguirlos en unos segundos: sitúa cada llamada en una línea de tiempo y muestra los intervalos entre ellas. En esta guía reproducimos cada problema en un pequeño agente de soporte, lo corregimos y comparamos ambas ejecuciones en la consola de Synthorai.
TL;DR
- Enviar tres llamadas independientes al modelo a la vez con
asyncio.gatherredujo la mediana de 3.7 s a 1.8 s con el mismo coste. - Ejecutar a la vez cuatro consultas simuladas a una base de datos, de 1.1 s cada una, redujo el tiempo en el código del agente de 4.6 s a 1.3 s. Cambiar de modelo no afecta a esa parte.
- Desactivar el razonamiento (
reasoning_effort="none") para cinco respuestas de una frase en GPT-6 Luna redujo el tiempo de 25.6 s a 10.2 s y los tokens de salida de 1,150 a 190.
Esta guía parte de Cómo trazar un agente LLM, que explica las tres cabeceras de petición necesarias para agrupar las llamadas al modelo en una traza. Prepara la demo siguiendo esa guía (Python 3.10 o posterior y el virtualenv activado) y ejecuta los tres casos desde el mismo directorio de github.com/synthorai-io/use-cases:
cd use-cases/agent-tracing
python incidents.py serial-checks slow-tool reasoning
Cada caso se ejecuta dos veces, primero con el problema y después con la corrección. Por cada ejecución se imprime una línea con el identificador de la traza:
serial-checks
  before   3.5 s   3 calls     127 in (     0 cached)     60 out  $0.000110   trace-d2bb96ebcf04
  after    1.5 s   3 calls     127 in (     0 cached)     62 out  $0.000112   trace-5f1e76a2de87
La latencia del modelo varía entre llamadas, así que ejecutamos cada caso cinco veces el 11 de octubre de 2026. La tabla muestra la mediana y, entre paréntesis, la ejecución más rápida y la más lenta. Una ejecución corregida del tercer caso falló, por lo que su mediana se calcula sobre cuatro ejecuciones. La salida de ejemplo anterior y los pares de las capturas corresponden a una ejecución adicional de cada caso, fuera de esas cinco. Los tiempos son duraciones totales (el tiempo transcurrido de principio a fin) medidas por el script.
| Caso | Qué muestra la traza | Corrección | Antes | Después |
|---|---|---|---|---|
serial-checks | barras escalonadas, sin solapamiento | enviar juntas las llamadas independientes | 3.7 s (3.5 a 4.5) | 1.8 s (1.7 a 2.0) |
slow-tool | una fila your app larga | corregir tu propio código | 11.0 s (9.5 a 12.2) | 9.2 s (6.7 a 11.0) |
reasoning | muchos más tokens de salida de los que contiene la respuesta | reducir el esfuerzo de razonamiento | 25.6 s para cinco respuestas (19.0 a 31.8) | 10.2 s (7.9 a 12.1) |
¿Por dónde empezar cuando un agente tarda demasiado?
Empieza por el resumen que aparece en la parte superior de la traza. Divide la duración total entre el tiempo en el gateway y el tiempo en tu aplicación. La duración total es lo que esperó el usuario. El tiempo en el gateway corresponde a los intervalos en los que había al menos una petición al modelo abierta. El tiempo en tu aplicación es el resto: los intervalos entre peticiones, cuando solo se ejecutaba tu código. También incluye el tiempo de red entre tu código y el gateway, unas décimas de segundo por llamada en las ejecuciones de esta página.
Ese reparto indica dónde seguir buscando:
- La mayor parte del tiempo en el gateway, con barras escalonadas: las llamadas se están esperando entre sí. Consulta el primer caso.
- Una parte importante del tiempo en tu aplicación: el problema no es el modelo. Consulta el segundo caso.
- La mayor parte del tiempo en el gateway, con una barra larga: una llamada concentra la mayor parte del tiempo. El resumen la identifica como «slowest». Consulta el tercer caso.
Para ver el efecto de un cambio, abre la traza anterior, selecciona Compare y elige la traza posterior. La consola muestra ambas ejecuciones en una sola página: cada métrica con los valores A, B y su variación, cada llamada junto a la que tiene el mismo nombre y los dos diagramas de cascada sobre la misma línea de tiempo. Todas las imágenes de esta página muestran esa vista.
¿Cómo se ven las llamadas que podrían ejecutarse a la vez pero se ejecutan en serie?
El diagrama de cascada muestra una escalera: cada barra empieza donde termina la anterior. El agente de la demo ejecuta tres comprobaciones sobre un mensaje de un cliente (sentimiento, políticas y riesgo) con DeepSeek V4.1 Flash, cada una con una respuesta de una frase. Ninguna necesita el resultado de las demás, pero la versión con el problema las espera en un bucle:
for span, question in CHECKS.items():        # each call waits for the one before it
    await check(run, span, question)
La corrección ocupa una línea:
await asyncio.gather(*(check(run, span, q) for span, q in CHECKS.items()))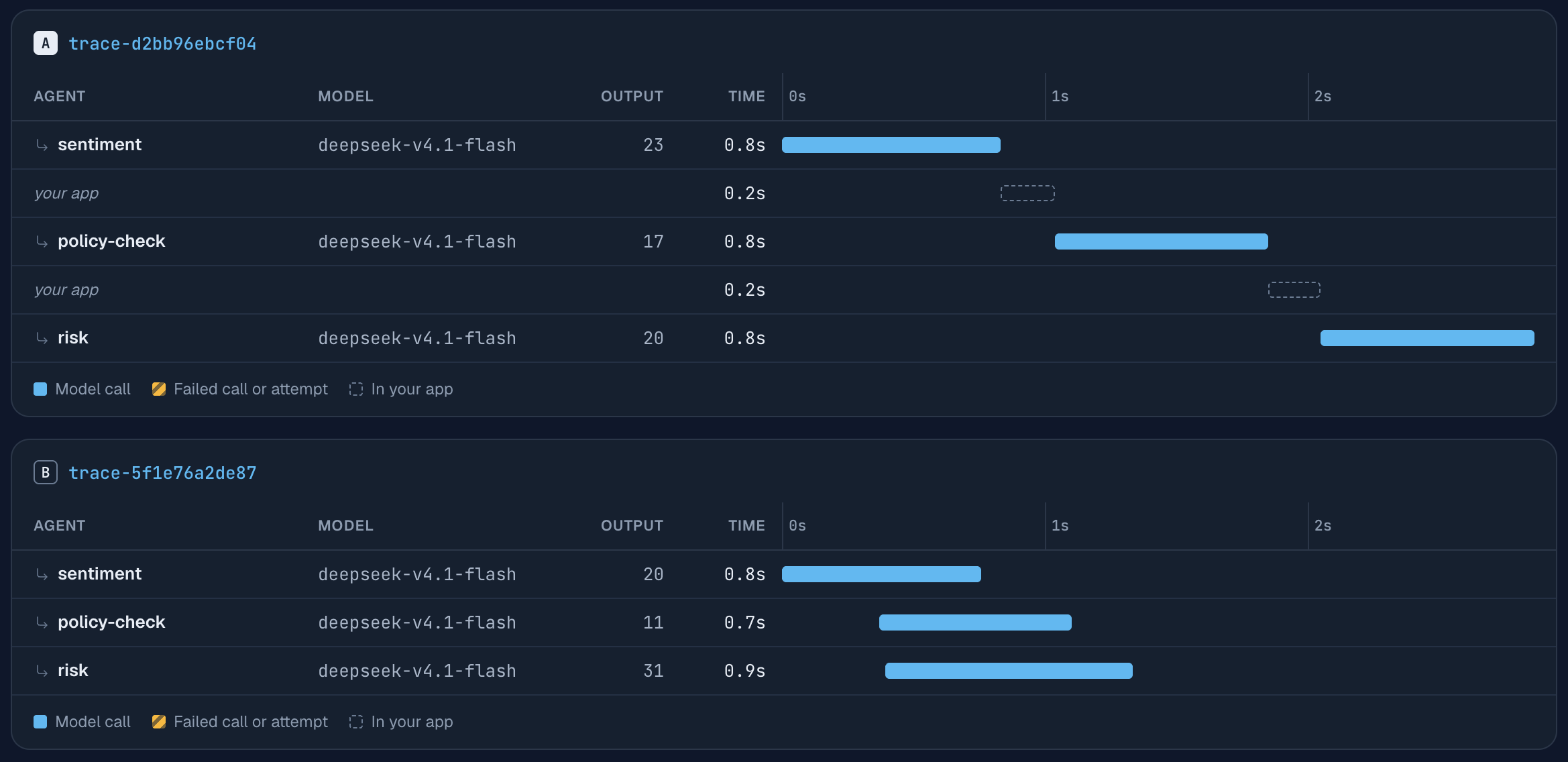
En la traza A, la duración total es de 2.9 s: las tres llamadas tardan 0.8 s cada una, una tras otra, con un intervalo de 0.2 s entre ellas. En la traza B, las barras se solapan y la duración total es de 1.3 s. La tabla comparativa de esa misma página de la consola, situada encima de la parte que muestra la captura, indica una reducción de 2.9 s a 1.3 s, un 53.4% menos (calculado con los tiempos sin redondear). El script midió 3.5 s y 1.5 s para ese mismo par porque también contabiliza la apertura de conexiones y el tiempo de red de cada llamada.
La entrada es la misma en ambas ejecuciones: 127 tokens. El coste varía con la salida, cuya longitud cambia un poco de una ejecución a otra. Este par costó $0.000110 y $0.000112; en cinco ejecuciones, la mediana fue de $0.000105 para la versión en serie y de $0.000109 para la versión en paralelo. Las llamadas en paralelo envían y reciben los mismos tokens, así que no cuestan más.
Para comprobarlo en tu propio agente, revisa cada par de barras consecutivas y pregunta si la segunda llamada utilizó la salida de la primera. Si no lo hizo, pueden solaparse. Las llamadas que dependen unas de otras (primero un plan y después el paso que ese plan define) deben seguir ejecutándose en secuencia.
¿Cómo saber si la parte lenta está en tu propio código?
La fila your app es larga. La versión con el problema responde a una pregunta después de buscar al cliente en cuatro tablas, con una consulta cada vez. Cada consulta es un sleep de 1.1 s que simula una llamada a la base de datos:
rows = [await lookup(t) for t in tables] # four queries, one at a timeEjecutar las cuatro consultas a la vez vuelve a requerir una sola línea:
rows = await asyncio.gather(*(lookup(t) for t in tables))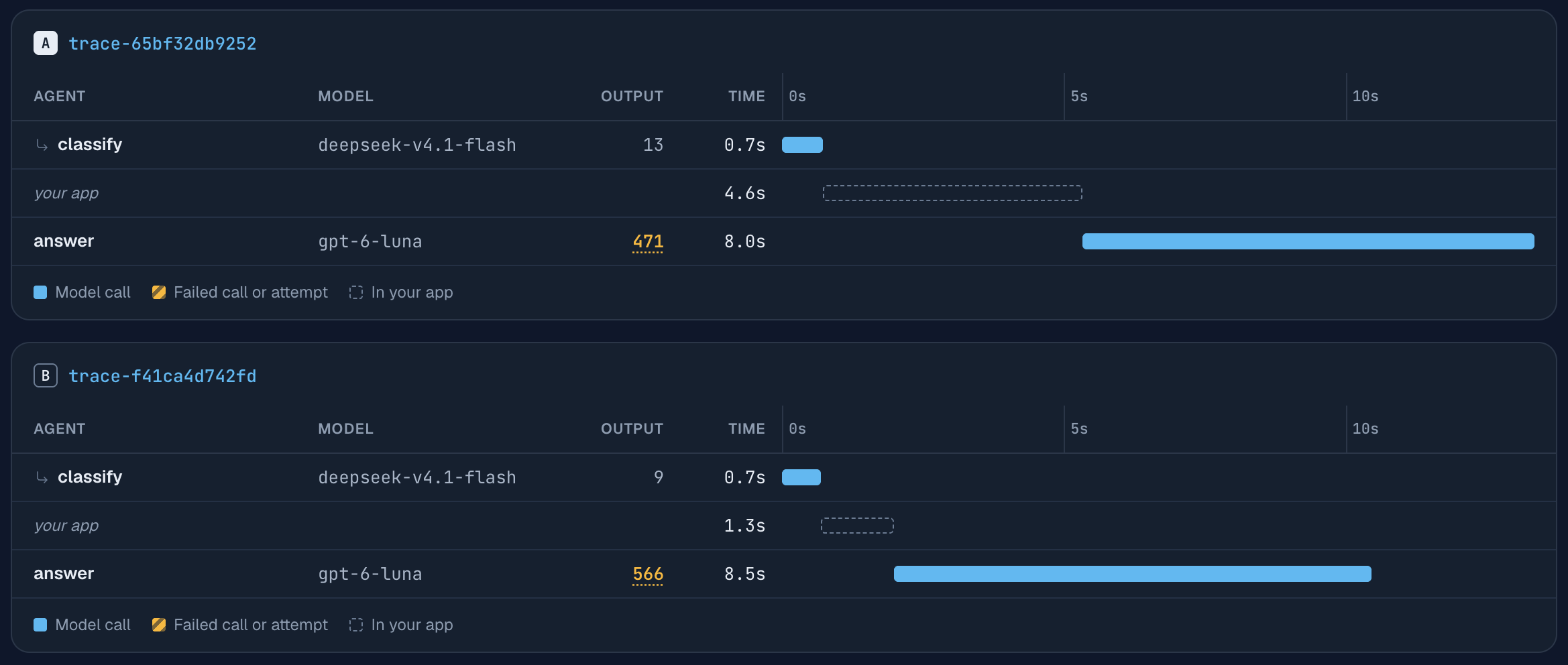
La fila corregida pasó de 4.6 s a 1.3 s. La tabla comparativa indica una reducción del 71.8% en «In your app», también calculada con los tiempos sin redondear. Cambiar de modelo o de prompt no habría afectado a esa parte: no había ninguna petición al modelo abierta y el agente estaba esperando sus propias consultas.
Los totales no reflejan la mejora con tanta claridad. En este par, la duración total pasó de 13.3 s a 10.5 s: un ahorro de 2.8 s para una corrección que ahorró 3.3 s. El medio segundo que falta corresponde a la llamada answer de GPT-6 Luna, que generó 471 tokens de salida en la primera ejecución y 566 en la segunda, y tardó 8.0 s y 8.5 s. En las cinco ejecuciones de la tabla, los intervalos de ambas versiones se solaparon: las corregidas tardaron de 6.7 a 11.0 s y las originales de 9.5 a 12.2 s. Por eso, una ejecución corregida puede ser más lenta que una sin corregir.
Compara la fila que cambiaste, no el total de una sola ejecución. La tabla de llamadas de la vista comparativa hace eso: empareja cada llamada con su equivalente y muestra el tiempo, la salida y el coste como A y B. Para afirmar que hay una mejora de principio a fin, compara la duración de muchas trazas de cada variante. La latencia p95 de Logs (el tiempo dentro del cual termina el 95% de las peticiones) no mostrará esta corrección. Mide peticiones individuales, y aquí el ahorro se produjo entre peticiones.
El gateway no puede ver qué hizo tu código durante ese intervalo, solo cuánto duró. Si el intervalo es largo y no sabes por qué, ese es el punto en el que conviene añadir spans de tus propias funciones con OpenTelemetry.
¿Y si la parte lenta es una sola llamada al modelo?
Mira cuántos tokens generó esa llamada, porque generar la salida lleva tiempo. Un modelo de razonamiento piensa antes de responder, y ese razonamiento se factura y se contabiliza en el tiempo como tokens de salida, aunque la respuesta visible tenga una sola frase. La versión con el problema plantea a GPT-6 Luna cinco preguntas breves sobre políticas con la instrucción «Responde en una frase» y mantiene el esfuerzo de razonamiento predeterminado. La versión corregida añade un parámetro:
await call(run, "answer", model=PLANNER_MODEL, messages=messages, reasoning_effort="none")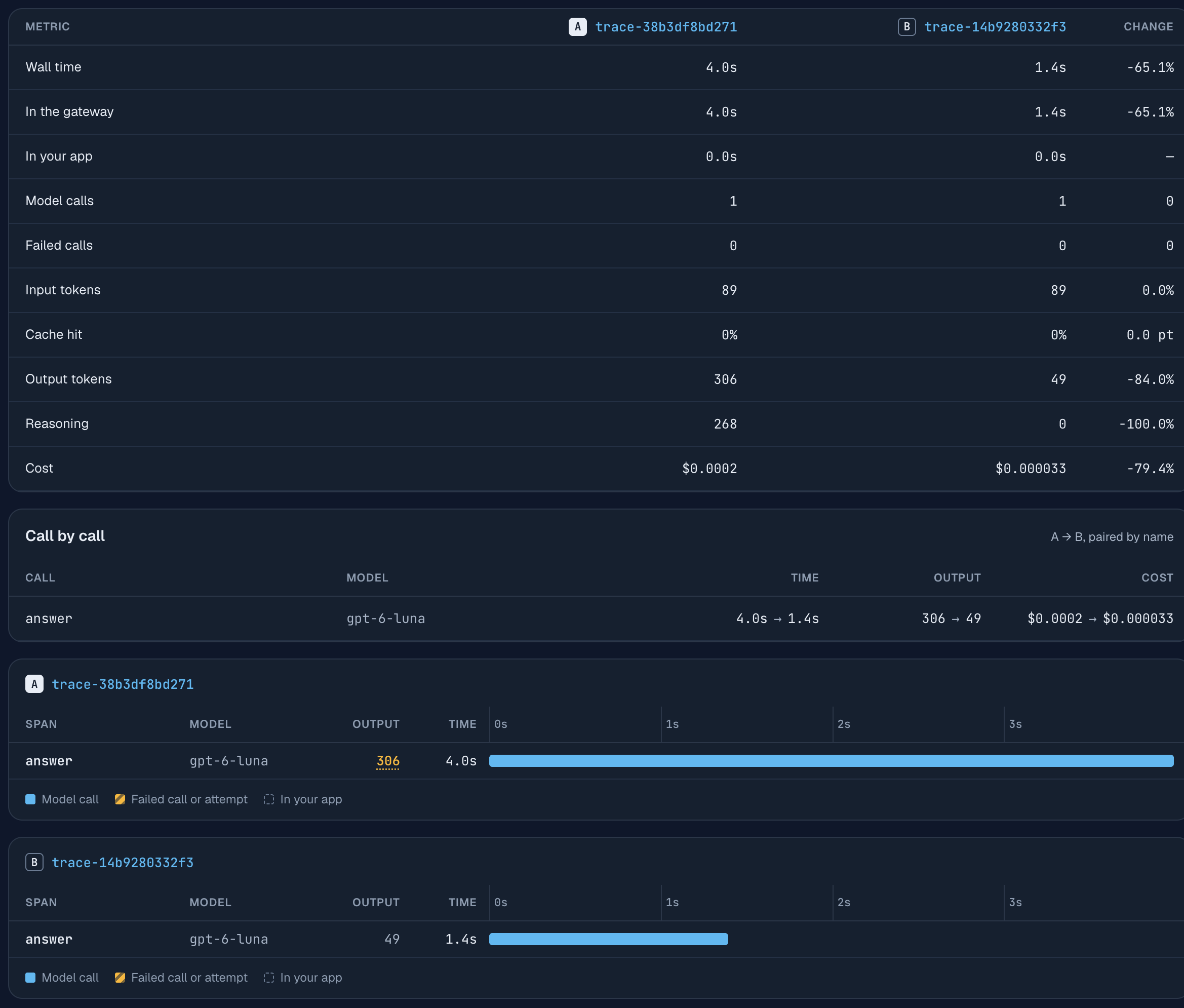
Esta es la primera de las cinco preguntas, antes y después. La respuesta tiene una sola frase en ambos casos. Con el esfuerzo predeterminado, el modelo generó 306 tokens de salida para producirla, de los que 268 fueron de razonamiento, y tardó 4.0 s. Sin razonamiento, generó 49 y tardó 1.4 s. El coste de la llamada bajó de $0.00016, que la consola redondea a $0.0002, a $0.000033.
| Cinco respuestas de una frase (mediana de cinco ejecuciones, cuatro en la segunda fila) | Tiempo | Tokens de salida | Coste |
|---|---|---|---|
| esfuerzo de razonamiento predeterminado | 25.6 s | 1,150 | $0.000614 |
reasoning_effort="none" | 10.2 s | 190 | $0.000134 |
No necesitas la comparación para detectar esto. El diagrama de cascada tiene una columna Output que subraya el número de tokens de una llamada cuando la mayor parte de una salida extensa corresponde a razonamiento, como ocurre con los 306 de arriba. Selecciona la llamada y el panel mostrará los tokens de razonamiento en una línea propia, debajo de los tokens de salida.
Desactivar el razonamiento es adecuado para pasos como estos: consultas, clasificación o reformulación del resultado de una herramienta. No lo es para tareas que requieren varios pasos de razonamiento, algo que esta demo no evalúa. Nuestras mediciones de GPT-6 Luna muestran los tokens de razonamiento y el coste por respuesta con cada ajuste, y la guía de esfuerzo de razonamiento enumera los valores que admite cada modelo. Ajusta el parámetro por paso y comprueba sus respuestas antes y después.
¿Qué queda fuera de esta página?
Quedan fuera dos cosas. La primera es la rapidez que percibe el usuario. El streaming no reduce la duración de una llamada, pero permite ver el texto antes, y en una respuesta de chat eso suele ser lo que importa. El panel de cada llamada tiene un campo First token para medirlo. Está vacío en estas trazas porque la demo no usa streaming.
La segunda son las causas externas al agente: un proveedor que va lento en ese momento o un límite de peticiones que obliga al cliente a esperar y reintentar. Aparecen como una barra larga o como una llamada fallida seguida de un reintento. Cambiar la estructura de tu código no las resuelve.
Preguntas frecuentes
¿Cómo encuentro el paso más lento de un agente LLM?
Abre la traza de la ejecución y consulta el resumen: identifica la llamada más lenta y divide la duración total entre el tiempo en el gateway y el tiempo en tu aplicación. El diagrama de cascada que aparece debajo representa cada llamada con una barra. La barra más larga o la fila your app más larga indica el paso que debes revisar.
¿Las llamadas LLM en paralelo cuestan más que las llamadas en serie?
No. En la demo, las tres comprobaciones costaron una mediana de $0.000105 en serie y de $0.000109 en paralelo, con los mismos 127 tokens de entrada. La diferencia se debe a que la longitud de la salida varía entre ejecuciones. El coste depende de los tokens, y las llamadas en paralelo envían y reciben los mismos tokens. Debes vigilar el límite de peticiones, porque las llamadas en paralelo llegan a la vez.
¿Por qué tarda tanto una llamada al modelo si la respuesta es corta?
Lo habitual es que el modelo haya razonado antes de responder. Ese razonamiento se genera como tokens de salida que no ves en la respuesta. Cinco respuestas de una frase en GPT-6 Luna consumieron una mediana de 1,150 tokens de salida con el esfuerzo de razonamiento predeterminado y de 190 con reasoning_effort="none".
¿Cómo mido si una corrección ha hecho que mi agente vaya más rápido?
Compara la parte que cambiaste, no un solo total. En la demo, ejecutar cuatro consultas a la vez redujo el tiempo en el código propio de 4.6 s a 1.3 s. Aun así, la duración total de las ejecuciones corregidas osciló entre 6.7 s y 11.0 s porque una llamada al modelo variaba. Compara muchas ejecuciones de cada versión usando la duración de las trazas.
¿Puede el gateway mostrar qué hizo mi código entre dos llamadas al modelo?
Muestra cuánto duró el intervalo mediante una fila your app, pero no qué ocurrió dentro. Para añadir spans dentro de tu código, usa un SDK de OpenTelemetry y propaga su cabecera traceparent para que ambas vistas compartan el identificador de traza.
Lecturas relacionadas
- Cómo trazar un agente LLM: las cabeceras y el diagrama de cascada que analizamos en esta página.
- ¿Por qué es caro mi agente LLM?: el mismo método aplicado a la factura.
- Cómo depurar un agente LLM: desde la queja de un usuario hasta la llamada que falló.
- Coste de Claude Code por subagente: las mismas vistas para un agente de programación que no has escrito tú.
- Pregunta a Claude sobre tus logs de LLM: preguntas sobre el registro de peticiones respondidas mediante MCP.
- Dale a tu agente herramientas para consultar logs: el mismo registro leído por un programa propio y el coste de los tokens del modelo.
- GPT-6 Luna frente a GPT-5.6 Luna: tokens de razonamiento y coste por respuesta con cada nivel de esfuerzo.