
Depurar un agente LLM: 3 fallos en una traza, uno con estado 200
Localiza la ejecución de un agente por la etiqueta del usuario y analiza tres fallos: un 404 con reintento, respuestas truncadas con estado 200 y un 400 en el segundo turno.
Nuestra selección
precios en vivo| Modelo | Veredicto | Precio |
|---|---|---|
| GPT-6 Luna Rechazó el segundo turno de una conversación con un 400 en 0.5 s sin cargo cuando el historial guardado había perdido una llamada a una herramienta. | Agente principal de la demo | desde $0.1/M |
| DeepSeek V4.1 Flash Con max_tokens en 40, tres llamadas seguidas devolvieron el estado 200 y exactamente 40 tokens de salida sin una respuesta utilizable. Con el límite aumentado y el razonamiento desactivado, una llamada respondió en 49 tokens. | Subagente de la demo | desde $0.3/M |
Contenido
- ¿Cómo localizas la ejecución de un usuario?
- ¿Cómo se ve una llamada fallida con un reintento?
- ¿Por qué el agente no devolvió nada si todas las llamadas tuvieron éxito?
- ¿Por qué falla el segundo turno si el primero funcionó?
- ¿Qué debe registrar cada agente para poder hacer esto?
- Preguntas frecuentes
- ¿Cómo depuro un agente LLM en producción?
- ¿Por qué mi LLM devuelve una respuesta vacía con estado 200?
- ¿Qué causa el error «No tool call found for function call output»?
- ¿Debo reintentar una llamada fallida a un LLM?
- Lecturas relacionadas
«El asistente me dio una respuesta inútil ayer por la tarde». Así suelen llegar los avisos de fallos de un agente: un usuario, una hora aproximada y ningún ID de solicitud. Para localizar la ejecución necesitas etiquetar las solicitudes; para entender qué pasó, necesitas una traza. El fallo suele estar en una sola llamada de las varias que se hicieron y muchas veces ni siquiera aparece como error. Esta guía recorre el camino desde la queja hasta la llamada que falló. Después reproduce tres fallos en un pequeño agente de soporte y muestra cómo se ve cada uno en la consola de Synthorai.
TL;DR
- Una etiqueta
_useren cada solicitud permite encontrar las ejecuciones del agente de un usuario con una sola búsqueda en la lista Traces. - Una llamada fallida y su reintento aparecen juntos si el reintento conserva el ID de traza. El 404 de la demo costó 95 ms y $0.
- Con
max_tokens=40en un modelo de razonamiento, tres llamadas devolvieron estado 200 con 40 tokens de salida y ninguna respuesta. - Un historial guardado que había perdido una llamada a una herramienta provocó un 400 en el segundo turno, sin coste.
Esta guía parte de Trazar un agente LLM, donde se explican las cabeceras de solicitud que usamos aquí. Prepara la demo como indica esa guía (Python 3.10 o posterior, con el virtualenv activo) y ejecuta estos comandos desde el mismo directorio de github.com/synthorai-io/use-cases:
cd use-cases/agent-tracing
python run.py --fail                    # a failed call with a retry
python incidents.py cut-off bad-history
Las cifras de esta página proceden de una ejecución de cada caso el 11 de octubre de 2026.
| Qué ves en la traza | Qué significa | Caso |
|---|---|---|
| una marca rayada con un código de estado, seguida de una llamada similar | una llamada falló y se reintentó | run.py --fail |
| el mismo span varias veces, todos con 200 y la columna Output igual al límite configurado | las respuestas se truncan antes de ser útiles | cut-off |
| un 400 en el segundo turno de una sesión, 0 tokens, $0 | la solicitud que ha construido tu código no es válida | bad-history |
¿Cómo localizas la ejecución de un usuario?
La localizas por la etiqueta que enviaste con ella. Si cada solicitud incluye X-Synthorai-Metadata con una clave _user, basta con un filtro para encontrar las solicitudes del usuario:
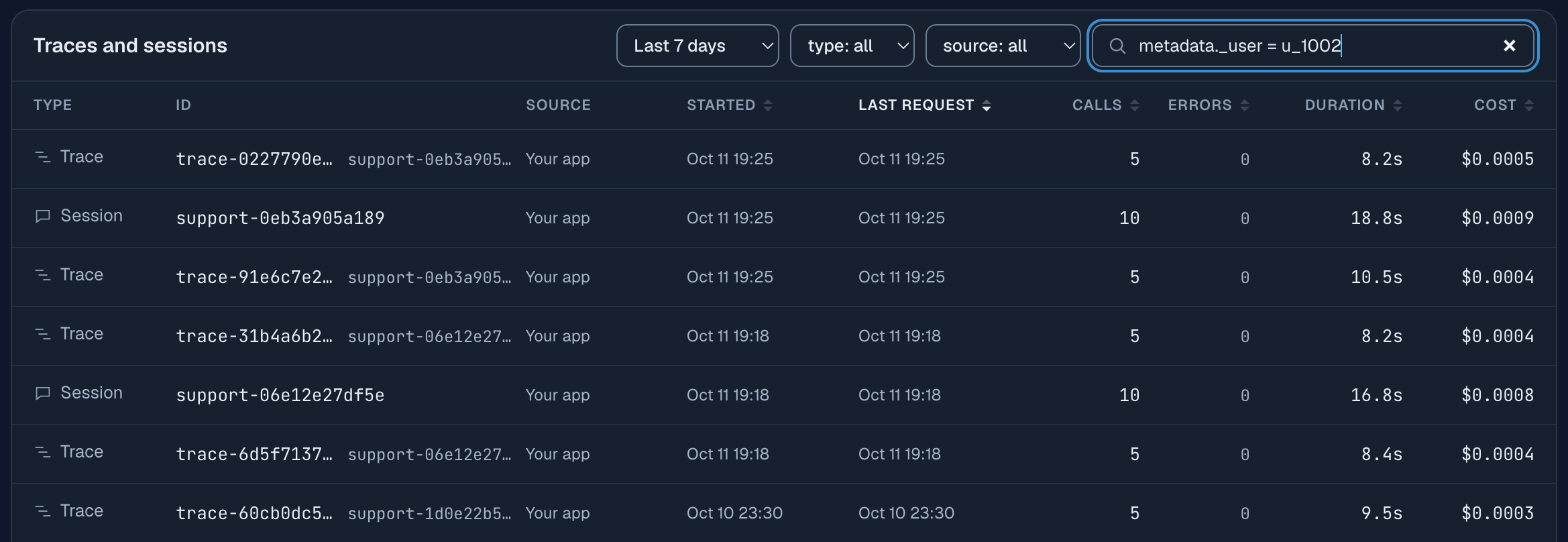
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}- Abre Traces, escribe
metadata._user = u_1002en el buscador y pulsa Enter. Ajusta el intervalo de tiempo para que incluya el momento de la queja. - Revisa la lista. Ahora solo contiene las sesiones de ese usuario y sus trazas, cada una con sus llamadas, errores, duración y coste. Las columnas Calls, Errors, Duration y Cost permiten ordenar los resultados. Empieza por las trazas con errores o con muchas más llamadas que las cercanas.
- Abre esa traza. Verás la ejecución completa; «Open session» muestra la conversación en la que se produjo y «See the calls in Logs» enumera sus solicitudes individuales.
Para buscar solicitudes individuales en lugar de ejecuciones, el filtro de Logs admite la misma etiqueta, además de status (error, success, 4xx, 5xx o un código), latency, cost, model, session y trace.
Sin etiquetas, la búsqueda parte de los datos que tengas: un ID de traza de tus propios logs se introduce en el buscador de Traces; un ID de solicitud de una cabecera de respuesta se introduce en el filtro de Logs como request_id. Por eso conviene registrar la cabecera de respuesta x-request-id junto con tus propios ID de usuario y conversación.
Usa un ID interno de usuario para _user, no una dirección de correo ni un nombre. Las etiquetas se guardan con la solicitud.
¿Cómo se ve una llamada fallida con un reintento?
Aparece como una marca rayada con el código de estado, junto a la llamada que la sustituyó. En la guía de trazas, una de las tres comprobaciones en paralelo solicita un ID de modelo que no existe. La traza muestra policy-check como una marca de 95 ms etiquetada con 404 y policy-check.retry como una barra normal a su lado. El resumen de la traza indica «6 model calls, 1 failed» y la página de la sesión muestra «1 × 404 Not found». La llamada fallida costó $0.
Hay dos decisiones en tu código que permiten leerlo así. El reintento conserva el ID de traza, de modo que el fallo y el reintento aparecen en la misma vista. Además, tiene su propio nombre de span para distinguir los intentos. Si el reintento inicia una traza nueva, verás dos ejecuciones sin relación aparente, una de ellas fallida sin una causa visible.
Un fallo en una traza no siempre supone un problema. Esta ejecución se recuperó y el cliente recibió una respuesta. La traza te dice cuánto costó el fallo: en este caso, 95 ms y nada en la factura. Esa información permite decidir si basta con reintentar o si hay que corregir la causa.
¿Por qué el agente no devolvió nada si todas las llamadas tuvieron éxito?
El agente no devolvió nada porque el estado 200 solo indica que la solicitud se completó. En este caso se pide al subagente basado en DeepSeek V4.1 Flash que identifique qué temas de las políticas aborda un mensaje. Sigue usando max_tokens=40, un valor heredado de un prompt anterior más sencillo. A diferencia de las demás llamadas a subagentes de la demo, la versión defectuosa de esta comprobación deja el razonamiento en el valor predeterminado del modelo (think en el fragmento). El modelo razona antes de responder, consume los 40 tokens en el razonamiento y devuelve una respuesta vacía con finish_reason igual a length. El código detecta la respuesta vacía y vuelve a intentarlo, hasta completar tres intentos:
for attempt in range(1, 4):
    resp = await check(run, f"policy-check-{attempt}", prompt, think=variant == "before", max_tokens=limit)
    choice = resp.choices[0]
    if choice.finish_reason != "length" and (choice.message.content or "").strip():
        break                                    # a usable reply; otherwise try again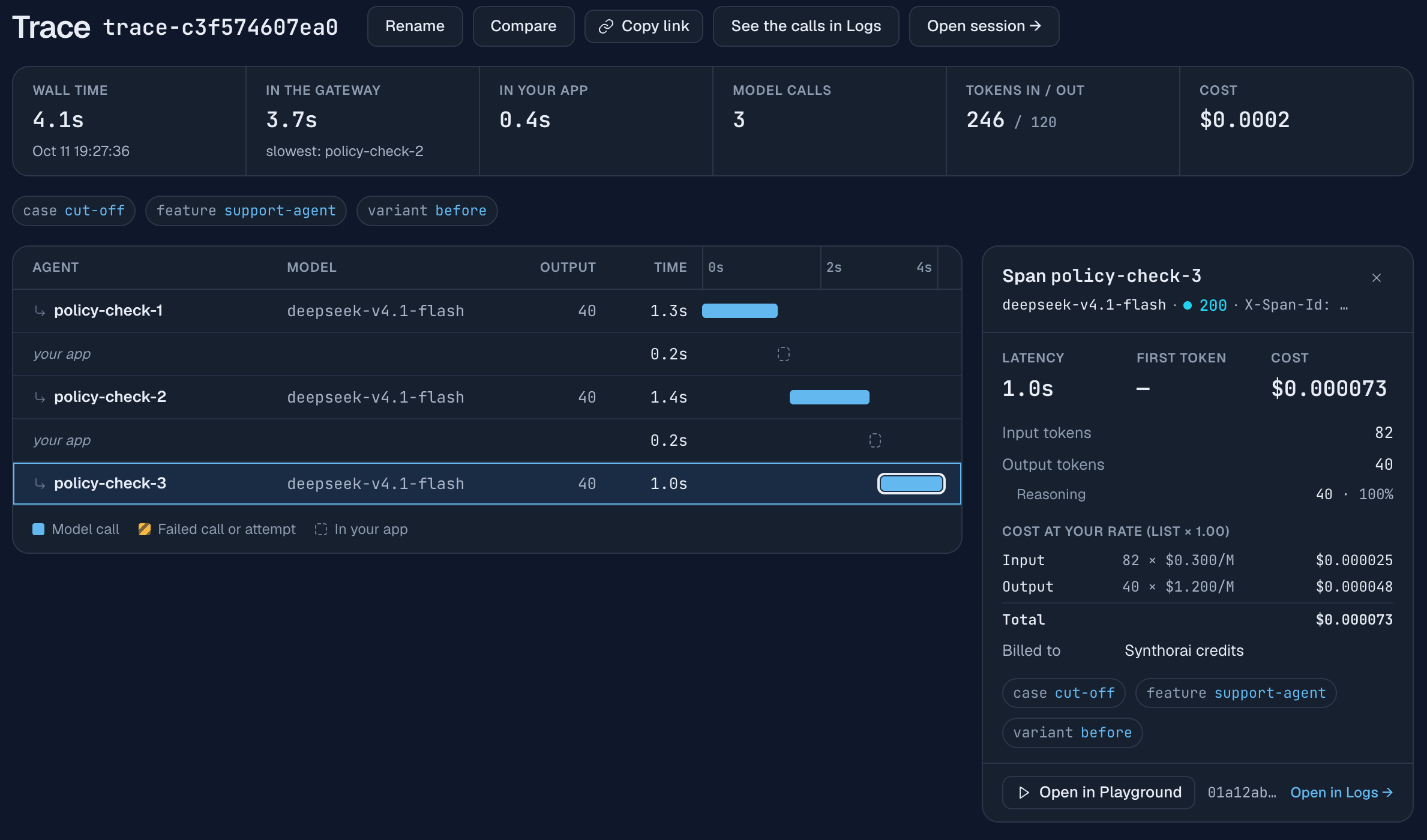
Nada aparece marcado como fallido en el diagrama de cascada. Las pistas son el span repetido y la columna Output: 40, 40 y 40, exactamente el límite. Al seleccionar una llamada se abre el panel de la derecha, que lo confirma: estado 200, 40 tokens de salida y, en la línea inferior, «Reasoning 40 · 100%».
Un recuento de tokens de salida igual al límite configurado es la señal de una respuesta truncada. La versión corregida sube el límite a 2,000 y desactiva el razonamiento para esta comprobación, que no lo necesita. Una sola llamada responde entonces con 49 tokens de salida, y la traza muestra una barra donde antes había tres. Subir solo el límite también eliminó los reintentos, pero esa única llamada consumió 1,876 tokens de salida en razonamiento y tardó 22 s.
Para tu propio agente:
- Comprueba
finish_reasonen cada llamada.lengthindica que la respuesta se truncó. Regístralo como un fallo en tus propios logs aunque el estado sea 200. - Dimensiona
max_tokenspara el razonamiento y la respuesta. En un modelo de razonamiento, el límite cubre ambos. Si lo ajustas solo al tamaño de la respuesta visible, puede que no quede espacio para ella. - No reintentes una respuesta truncada con el mismo límite. El segundo intento alcanzará el mismo tope. Sube el límite, reduce el esfuerzo de razonamiento o haz ambas cosas.
¿Por qué falla el segundo turno si el primero funcionó?
La causa habitual está en lo que tu código guardó entre turnos. Una solicitud al modelo incluye toda la conversación, así que un fallo al guardar o reconstruir el historial solo se manifiesta a partir del segundo turno. En este caso, el primer turno usa los mensajes en memoria: GPT-6 Luna llama a una herramienta, recibe el resultado y responde sin problemas. Después, el código guarda el turno. Guarda el mensaje del asistente solo como texto, por lo que pierde la llamada a la herramienta, y guarda junto a él el resultado de esa herramienta:
# What the app stores for the next turn.
saved = msg.model_dump(exclude_none=True)
if variant == "before":
    saved.pop("tool_calls", None)                # the bug: the assistant message is saved as text only
    saved["content"] = saved.get("content") or ""
history = [saved, *results, {"role": "assistant", "content": answer.choices[0].message.content or ""}]
Cuando el cliente vuelve a escribir, el segundo turno se construye a partir de ese historial guardado. La solicitud contiene el resultado de una herramienta cuya llamada ya no está en el historial, y se rechaza con este error («function call output» es el nombre que da el proveedor al resultado de una herramienta):
400 No tool call found for function call output with call_id call_Nqc1zUFvwLLuF5oGMEE9WheQ.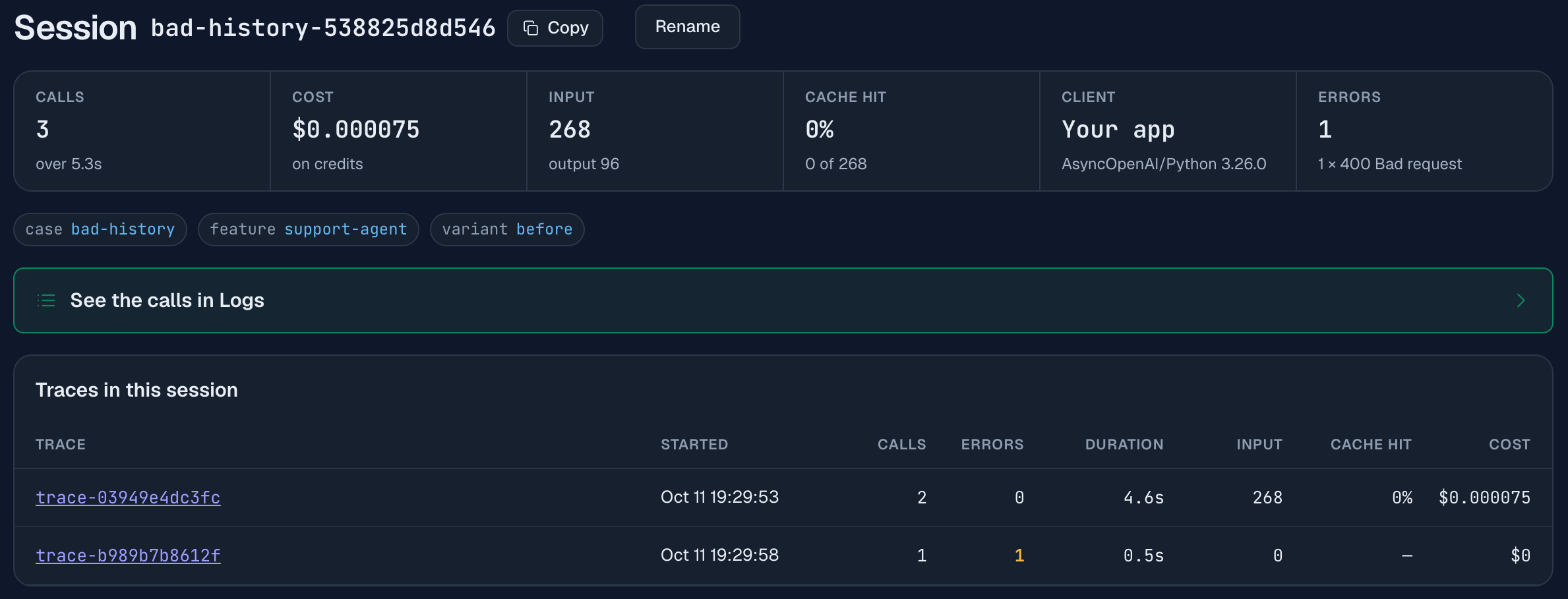
La página de la sesión muestra el patrón: dos trazas, la primera con 2 llamadas y ningún error, la segunda con 1 llamada y 1 error, y «1 × 400 Bad request» en la tarjeta de errores. La traza fallida muestra 0 tokens de entrada, una duración de 0.5 s y un coste de $0. Esos tres valores juntos indican que no llegó a ejecutarse ningún modelo: la solicitud se rechazó por no ser válida. Esto distingue este fallo de un problema del modelo o del proveedor, donde verías tokens, una duración mayor o un estado 5xx.
Un 400 indica un fallo en la solicitud, así que reintentar no sirve de nada. El mensaje de error indica qué hay que corregir. Si se guarda el mensaje completo del asistente, el segundo turno funciona.
Otros fallos en el historial producen el mismo patrón (el primer turno funciona y uno posterior se rechaza): guardar el resultado de una herramienta sin su ID de llamada, almacenar los mensajes en un orden incorrecto o recortar el historial en mitad de un intercambio con una herramienta, conservando el resultado y eliminando la llamada. Si recortas el historial para controlar el coste, haz el corte entre turnos, nunca dentro de uno.
¿Qué debe registrar cada agente para poder hacer esto?
Registra cinco cosas:
- Un ID de traza por ejecución y un ID de sesión por conversación, enviados como
X-Trace-IdyX-Session-Idy registrados también en tus propios logs. - Un nombre de span por llamada que indique el paso y el intento, como
plan-2opolicy-check.retry. - Etiquetas para el usuario, la funcionalidad y la versión, enviadas como
X-Synthorai-Metadata. - La cabecera de respuesta
x-request-idde cada llamada, junto a tus propios ID. finish_reasony el recuento de tokens de salida de cada llamada, tratandolengthcomo un fallo.
Configura también un timeout del cliente y un valor de max_tokens en cada llamada, ambos con margen suficiente. Sin ninguno de los dos, una llamada puede durar todo el tiempo que el modelo siga escribiendo, y tu código seguirá esperando. Pero un límite ajustado solo a la respuesta visible provoca el fallo del segundo caso. Un timeout más corto que una generación larga interrumpe llamadas que estaban funcionando: con un modelo de razonamiento, una llamada puede tardar minutos. La demo espera 300 s y limita cada llamada a 2,000 tokens de salida, salvo que la llamada configure su propio límite.
Preguntas frecuentes
¿Cómo depuro un agente LLM en producción?
Primero localiza la ejecución: filtra el log de solicitudes por una etiqueta de usuario o conversación y abre la traza de una solicitud que coincida. La traza muestra en orden todas las llamadas al modelo de esa ejecución y marca las fallidas. Así puedes identificar qué paso falló antes de leer el código.
¿Por qué mi LLM devuelve una respuesta vacía con estado 200?
La causa habitual es que se alcanzó el límite de salida antes de que el modelo escribiera la respuesta. En un modelo de razonamiento, max_tokens cubre tanto el razonamiento como la respuesta. Comprueba finish_reason: si es length y el recuento de tokens de salida coincide con el límite, la respuesta se truncó. En la demo, tres llamadas consecutivas devolvieron 200 con exactamente 40 tokens de salida y ninguna respuesta útil.
¿Qué causa el error «No tool call found for function call output»?
El historial de conversación contiene el resultado de una herramienta, pero falta la llamada correspondiente. Esto ocurre cuando el mensaje del asistente que hizo la llamada se guarda sin sus tool_calls, o cuando se recorta el historial entre una llamada y su resultado. Guarda el mensaje completo del asistente y recorta solo entre turnos.
¿Debo reintentar una llamada fallida a un LLM?
Depende del estado. Un 429 (límite de solicitudes alcanzado) o un 5xx (error del servidor) puede resolverse con un reintento. Un 400 es un problema de la solicitud y volverá a fallar igual. Una respuesta truncada por max_tokens volverá a truncarse si no cambia el límite. Cuando reintentes, conserva el ID de traza para que ambos intentos aparezcan en la misma traza.
Lecturas relacionadas
- Trazar un agente LLM: las cabeceras, el diagrama de cascada y el ejemplo de una llamada fallida.
- ¿Por qué es lento mi agente LLM?: cómo analizar la latencia en la misma traza.
- ¿Por qué cuesta tanto mi agente LLM?: cómo analizar el coste en las sesiones.
- Coste de Claude Code por subagente: las mismas vistas para un agente de programación que no has desarrollado tú.
- Pregunta a Claude sobre tus logs de LLM: «¿Ha fallado alguna solicitud de este usuario?», respondido a través de MCP.
- Dale a tu agente herramientas para consultar logs: cómo leer el mismo log con tu propio programa y cuánto cuestan los tokens del modelo.
- Referencia de cabeceras de solicitud: ID, etiquetas y sus límites.