
GPT-6 Luna vs GPT-5.6 Luna: mitad de precio y de palabras
Contenido
- ¿Cómo se comparan GPT-6 Luna y GPT-5.6 Luna en los benchmarks?
- ¿Qué cambió, además del precio?
- ¿Cómo lo probamos?
- ¿Escribe GPT-6 Luna menos que GPT-5.6 Luna?
- ¿Omite información GPT-6 Luna?
- ¿Cómo se recuperan la longitud y los detalles?
- ¿Cuánto se ahorra con GPT-6 Luna frente a GPT-5.6 Luna?
- ¿Coinciden nuestros resultados con otras pruebas publicadas?
- ¿Qué observamos y cuál conviene usar?
- Preguntas frecuentes
GPT-6 Luna está a la par de GPT-5.6 Luna en benchmarks públicos (38 frente a 37 en el Artificial Analysis Intelligence Index) y cuesta aproximadamente la mitad por tarea. La diferencia está en lo que escribe. Cuando el prompt solo indica un objetivo («escribe el informe del tercer trimestre»), GPT-6 Luna escribió 0.55x las palabras en 80 documentos de empresa. No omitió las partes que se le pidieron expresamente. Al especificarlas, ambos modelos entregaron documentos igual de completos. El dato que GPT-6 Luna omitió más a menudo en los prompts que solo indicaban el objetivo fue la duración de un incidente.
TL;DR
- Artificial Analysis da a GPT-6 Luna 38 puntos y a GPT-5.6 Luna 37 con esfuerzo
max, a $0.07 frente a $0.18 por tarea. - Con prompts que solo indicaban el objetivo, GPT-6 Luna escribió 384 palabras por documento frente a las 703 de GPT-5.6 Luna.
- GPT-6 Luna omitió la duración del incidente en 9 de 20 informes post mortem con prompts que solo indicaban el objetivo; GPT-5.6 Luna, en 2.
- Al especificar las partes necesarias, GPT-6 Luna entregó 74 de 80 documentos completos frente a 69, a $0.81 frente a $1.61 por cada 1,000.
¿Cómo se comparan GPT-6 Luna y GPT-5.6 Luna en los benchmarks?
GPT-6 Luna iguala a GPT-5.6 Luna en benchmarks generales con un coste por tarea entre un 48% y un 61% menor. La diferencia entre ambos aparece en los documentos evaluados con una rúbrica (una lista de criterios de puntuación). Las puntuaciones corresponden a un nivel de esfuerzo de razonamiento, el ajuste de la API que controla cuánto razona el modelo antes de responder (none a max, con medium por defecto). Consultamos las cifras en las páginas de sus editores el 2026-10-02.
| GPT-6 Luna | GPT-5.6 Luna | |
|---|---|---|
| Lanzamiento | 2026-09-22 | 2026-07-09 |
| Precio de lista, entrada / salida por 1M tokens | $0.10 / $0.50 | $0.20 / $1.20 |
| Artificial Analysis Intelligence Index v4.3.2 con esfuerzo max (10 evaluaciones: conocimientos, razonamiento, programación, tareas de agentes y documentos de empresa) | 38 | 37 |
| Coste por tarea del índice | $0.07 | $0.18 |
| Vals Index (programación, derecho, fiscalidad, finanzas y otras tareas profesionales) | 51.2% | 51.7% |
| Coste por prueba de Vals | $0.43 | $0.82 |
| GDPval-AA v2.1, puntuación Elo con esfuerzo max (documentos de empresa evaluados con una rúbrica oculta; Elo se calcula a partir de comparaciones directas y cuanto mayor, mejor) | 1438 | 1463 |
| Puntuación Elo de GDPval-AA v2.1 con esfuerzo medium | 1262 | 1133 |
| Velocidad de salida, tokens por segundo | 131 | 124 |
Las críticas a GPT-6 Luna empezaron con GDPval-AA. En su análisis del lanzamiento, Artificial Analysis situó a GPT-6 Luna unos 75 puntos Elo por debajo de GPT-5.6 Luna en GDPval-AA y unos 45 por debajo en AA-Briefcase v1.1, otro benchmark de documentos. Lo atribuyó a «una menor calidad de presentación y entregables que omiten elementos de la rúbrica»; los evaluadores lo llamaron «impuesto de formato». Ahora la clasificación muestra una diferencia de 25 puntos con esfuerzo max, mientras que con medium GPT-6 Luna aventaja al otro modelo por 129 puntos.
Frente a otros proveedores, GPT-6 Luna compite con los modelos de la gama flash, de bajo precio y alta velocidad. En el mismo índice, DeepSeek V4.1 Flash obtiene 39 puntos con esfuerzo max a $0.27 por tarea y Gemini 3.8 Flash obtiene 41 con esfuerzo high a $1.24. GPT-6 Luna queda entre 1 y 3 puntos por debajo, pero su coste por tarea es entre 4 y 18 veces menor. Los dos modelos generan más rápido: 209 y 249 tokens por segundo.
¿Qué cambió, además del precio?
GPT-6 Luna conserva los límites y ajustes de GPT-5.6 Luna; solo cambiaron el precio de la caché y la fecha límite de sus conocimientos. Ambos tienen una ventana de contexto de 1,050,000 tokens y un límite de salida de 128,000 tokens. En los dos, cuando el prompt supera los 272K tokens, se cobra 2x por la entrada y 1.5x por la salida de toda la solicitud. La entrada en caché cuesta $0.01 por millón de tokens, frente a $0.02 antes, y la fecha límite de conocimientos pasó del 16 de febrero al 18 de mayo de 2026. El esfuerzo se configura con reasoning.effort en la Responses API (none, low, medium, high, xhigh, max). El razonamiento no se muestra y se factura como tokens de salida.
Una semana después del lanzamiento, OpenAI publicó GPT-6.1 Sol como sucesor de GPT-6 Sol en la gama superior. En nuestras mediciones de GPT-6.1 Sol, las respuestas volvieron a la longitud anterior. Luna no recibió ninguna actualización, así que medimos qué acorta GPT-6 Luna, qué omite y cómo recuperar esos detalles.
¿Cómo lo probamos?
Preparamos tareas de redacción con requisitos verificables mediante código, sin usar un modelo como juez. En cada tarea, el modelo recibe un bloque de datos sintéticos y debe elaborar un documento a partir de ellos:
| Documento | Datos | Qué espera encontrar el lector |
|---|---|---|
| Informe trimestral | ingresos de 6 a 12 regiones | todas las regiones y cuál sufrió la mayor caída |
| Informe post mortem de un incidente | 7 a 10 eventos con marca de tiempo | todos los eventos y la duración del incidente |
| Comparativa de proveedores | 5 a 8 presupuestos de hosting | todos los proveedores |
| Respuestas a clientes | 6 a 14 tickets de soporte | una respuesta por ticket, dirigida al cliente por su nombre |
Cada tarea usa los mismos datos con dos tipos de prompt. El prompt que solo indica el objetivo dice qué documento se necesita, pero no detalla sus partes («Escribe el informe regional del tercer trimestre para el equipo directivo»). Solo se evalúan los elementos de la tabla. El prompt que especifica las partes enumera secciones, cantidades y rangos de palabras; se evalúa todo. Un documento está completo si no falta ningún elemento exigido, ninguna parte es demasiado corta y se cumplen todas las cantidades. En las comparativas de proveedores cuyo prompt solo indica el objetivo, evaluamos únicamente la longitud, porque elegir al proveedor adecuado requiere criterio.
El 2026-10-02 ejecutamos los 80 casos que solo indicaban el objetivo en ambos modelos con cinco niveles de esfuerzo, además de un ajuste de verbosidad en GPT-6 Luna. También ejecutamos los 80 casos con las partes especificadas en ambos modelos con el esfuerzo por defecto: 1,040 llamadas a la Responses API. Cada prompt incluía una cadena aleatoria única para evitar respuestas procedentes de la caché. Calculamos el coste con los precios de lista de OpenAI. Ambos modelos respondieron a los mismos casos, así que los comparamos con la prueba exacta de McNemar (una prueba pareada sobre los casos en que los modelos difieren) y una corrección de Holm, que hace más estricto el umbral cuando se prueban varias comparaciones a la vez. Solo consideramos diferencias las que superan esa corrección.
¿Escribe GPT-6 Luna menos que GPT-5.6 Luna?
GPT-6 Luna escribió 0.55x las palabras de GPT-5.6 Luna con prompts que solo indicaban el objetivo y el esfuerzo por defecto: 384 palabras por documento frente a 703. Fue más breve en los 80 casos y en todos los tipos de documento. La mayor diferencia se dio en los informes post mortem (441 frente a 981 palabras); la menor, en las respuestas a clientes (576 frente a 767).
Al especificar las partes, la diferencia desaparece: 738 palabras frente a 724.
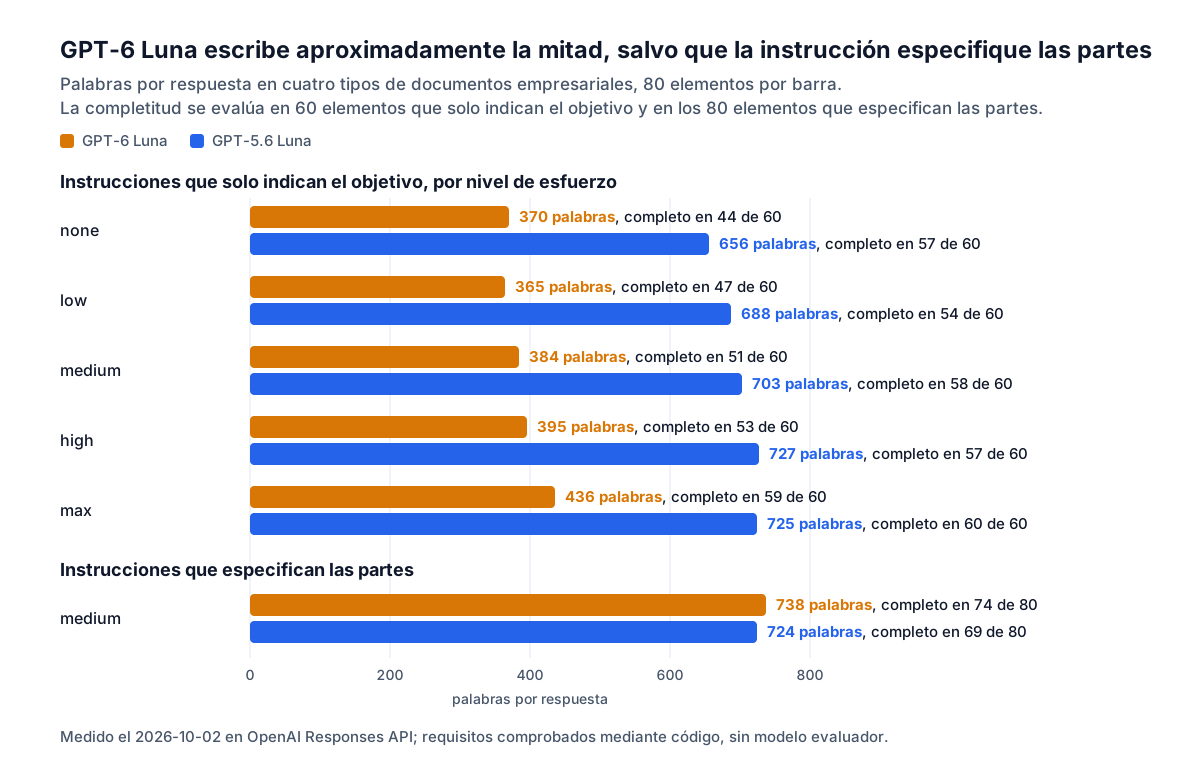
Esta tendencia a responder más brevemente por defecto no es exclusiva de Luna. Con los mismos casos, GPT-6 Sol escribió 325 palabras frente a las 592 de GPT-5.6 Sol, mientras que GPT-6.1 Sol vuelve a las 565.
¿Omite información GPT-6 Luna?
Con prompts que solo indicaban el objetivo, GPT-6 Luna omitió un dato más a menudo que GPT-5.6 Luna: la duración del incidente en los informes post mortem. Solía indicar el intervalo horario («Ventana del incidente: 18:00-18:39 UTC») y dejar al lector el cálculo de la duración. Todo lo demás aparecía con cualquier nivel de esfuerzo: todas las regiones y la de peor resultado, todos los eventos y una respuesta dirigida por su nombre al cliente de cada ticket, salvo una excepción con none.
| Prompts que solo indican el objetivo | GPT-6 Luna: completos | GPT-6 Luna: informes post mortem sin duración | GPT-5.6 Luna: completos | GPT-5.6 Luna: informes post mortem sin duración |
|---|---|---|---|---|
none | 44 / 60 | 15 / 20 | 57 / 60 | 3 / 20 |
low | 47 / 60 | 13 / 20 | 54 / 60 | 6 / 20 |
medium | 51 / 60 | 9 / 20 | 58 / 60 | 2 / 20 |
high | 53 / 60 | 7 / 20 | 57 / 60 | 3 / 20 |
max | 59 / 60 | 1 / 20 | 60 / 60 | 0 / 20 |
La diferencia con none (44 frente a 57) se mantiene tras la corrección. Con medium (51 frente a 58), solo es significativa antes de aplicarla, así que indica una tendencia. Con max, los dos modelos quedan empatados. Toda la diferencia procede de un solo tipo de documento: GPT-6 Luna omite un dato que hay que calcular en los informes post mortem, no contenidos en general.
Al especificar las partes, GPT-6 Luna entregó 74 de 80 documentos completos y GPT-5.6 Luna, 69: un empate. En ambos modelos, todos los documentos incompletos tenían un memorando o un párrafo sobre el impacto por debajo del rango de palabras solicitado: 6 en GPT-6 Luna y 11 en GPT-5.6 Luna.
¿Cómo se recuperan la longitud y los detalles?
Basta con especificar las partes en el prompt; los dos parámetros de la solicitud no consiguen lo mismo. Con el mismo esfuerzo, GPT-6 Luna pasó de 384 a 738 palabras e indicó la duración en todos los informes post mortem cuando el prompt la pidió. Una solicitud como esta es suficiente:
Write the postmortem with these sections: Timeline (a table with every event),
Impact (120-200 words, state the total duration in minutes), Root Cause,
Action Items (5, each ending "Owner: <team>"), Lessons Learned (at least 3 bullets).
text.verbosity es un parámetro de la Responses API (low, medium, high) que controla la longitud y el nivel de detalle de la respuesta visible. Con high, los documentos de GPT-6 Luna generados a partir de prompts que solo indicaban el objetivo fueron un 7% más largos (410 palabras), pero el número de documentos completos apenas cambió: 52 de 60 frente a 51.
Aumentar reasoning.effort cambia más cuánto razona el modelo que cuánto escribe. Al pasar de none a max, los documentos de GPT-6 Luna crecieron de 370 a 436 palabras, mientras que el razonamiento pasó de 0 a 4,192 tokens por respuesta. max sí recuperó la duración (solo faltó en 1 de 20), pero costó 4.5 veces más que medium.
Ambos parámetros con el SDK de Python de OpenAI:
from openai import OpenAI

client = OpenAI()
prompt = "Write the postmortem with these sections: ..."  # data and required parts
resp = client.responses.create(
    model="gpt-6-luna",
    reasoning={"effort": "medium"},   # none, low, medium (default), high, xhigh, max
    text={"verbosity": "high"},       # 7% longer in our runs; did not change completeness
    input=prompt,
)
print(resp.output_text)
usage = resp.usage
print(usage.output_tokens, usage.output_tokens_details.reasoning_tokens)
output_tokens incluye los tokens de razonamiento, así que la diferencia entre los dos números corresponde a la respuesta visible.
¿Cuánto se ahorra con GPT-6 Luna frente a GPT-5.6 Luna?
Para el mismo documento, GPT-6 Luna costó un 49% menos que GPT-5.6 Luna: $0.81 frente a $1.61 por cada 1,000 documentos con las partes especificadas. La rebaja de precio por sí sola habría supuesto un ahorro mayor. Si facturamos los tokens de GPT-5.6 Luna a las tarifas de GPT-6 Luna, el coste es de $0.68, un 58% menos. Las respuestas de GPT-6 Luna cuestan un 20% más que eso porque consumió el doble de tokens de razonamiento (537 por respuesta frente a 271) y su salida total pasó de 1,284 a 1,558 tokens.
Con prompts que solo indicaban el objetivo, la factura baja más: $0.54 frente a $1.66 por cada 1,000 documentos (un 68% menos). Pero gran parte del ahorro adicional se debe a que GPT-6 Luna escribe la mitad. Solo es un ahorro si la otra mitad no hacía falta.
La velocidad es casi igual. GPT-6 Luna generó 115 tokens de salida por segundo de tiempo total de solicitud, frente a 125. La mediana de tiempo por documento con un prompt que solo indicaba el objetivo fue de 8.1 segundos frente a 11.1, porque había menos que escribir.
¿Coinciden nuestros resultados con otras pruebas publicadas?
Nuestros resultados coinciden con los benchmarks públicos en los aspectos comparables. Además, muestran qué se acorta, qué falta y cómo corregirlo.
| Pregunta | Datos publicados por otros | Nuestra medición | Conclusión |
|---|---|---|---|
| Capacidad general, GPT-6 Luna frente a GPT-5.6 Luna | Artificial Analysis: 38 frente a 37; Vals: 51.2% frente a 51.7% | 74 frente a 69 documentos completos de 80 al especificar las partes, un empate | Coincide: a la par |
| Calidad de los documentos | Puntuación Elo de GDPval-AA v2.1: 25 puntos menos con max, 129 más con medium | con medium, 0.55x las palabras en prompts que solo indican el objetivo; falta la duración del incidente en 9 de 20 informes post mortem frente a 2 | Resultado mixto: ninguno muestra una pérdida clara con el esfuerzo por defecto; nuestra prueba identifica la menor longitud y el dato que se pierde |
| Tokens de salida | 51K frente a 41K por tarea del índice con max, un 24% más | 1,558 frente a 1,284 por documento con medium, un 21% más | Coincide |
| Coste | 61% menos por tarea del índice; 48% menos por prueba de Vals | 49% menos al especificar las partes; 68% menos con prompts que solo indican el objetivo | Coincide |
¿Qué observamos y cuál conviene usar?
Usa GPT-6 Luna cuando puedas controlar el prompt y especifica las partes que necesitas. Conserva GPT-5.6 Luna solo cuando no puedas cambiar los prompts y los lectores esperen documentos largos. Los datos apuntan a tres conclusiones:
- GPT-6 Luna se ajusta a lo que pide el prompt. Si solo recibe un objetivo, entrega un documento breve. Si recibe una lista de partes, entrega uno completo y tan largo como el de GPT-5.6 Luna.
- Lo que omite es concreto. En cuatro tipos de documento, el único elemento esperado que faltó más a menudo fue la duración del incidente.
- El ahorro viene de la rebaja de precio. Para el mismo documento consume un 21% más de tokens de salida, por lo que el ahorro del 49% queda por debajo del 58% que darían solo los precios de lista.
| Tipo de trabajo | Modelo recomendado | Datos |
|---|---|---|
| Salida procesada por programas: clasificación, extracción, enrutamiento | GPT-6 Luna con el menor esfuerzo que permita la precisión necesaria | precios de lista un 50% menores en entrada y un 58% menores en salida; la longitud de la respuesta no importa si la lee un programa |
| Documentos generados a partir de una plantilla o de un prompt que controlas | GPT-6 Luna, con secciones, cantidades y longitudes en el prompt | 74 documentos completos de 80 frente a 69; $0.81 frente a $1.61 por cada 1,000 |
| Documentos generados a partir de prompts de usuarios que no puedes editar | GPT-6 Luna si puedes añadir las partes esperadas a la solicitud; si no, GPT-5.6 Luna | con prompts que solo indican el objetivo: 384 frente a 703 palabras; falta la duración en 9 de 20 informes post mortem frente a 2 |
| Entregables evaluados con una rúbrica | Incluye la rúbrica en el prompt; no dependas de text.verbosity | verbosidad high: 52 frente a 51 documentos completos de 60, con un 7% más de palabras |
Si los documentos van a enviarse a clientes, comprueba mediante código que contienen todos los elementos obligatorios, independientemente del modelo que los haya escrito.
Preguntas frecuentes
¿Es GPT-6 Luna peor que GPT-5.6 Luna? GPT-6 Luna entregó tantos documentos completos como GPT-5.6 Luna cuando el prompt especificaba las partes necesarias (74 frente a 69 de 80, un empate), a la mitad de coste. Cuando el prompt solo indica un objetivo, escribe aproximadamente la mitad y omite la duración del incidente en los informes post mortem con más frecuencia.
¿Hace text.verbosity: "high" que GPT-6 Luna escriba tanto como GPT-5.6 Luna?
En nuestras pruebas, text.verbosity: "high" añadió un 7% de palabras a las respuestas de GPT-6 Luna, que quedaron en torno al 58% de la longitud de las de GPT-5.6 Luna. No cambió el número de documentos completos. Al especificar las partes en el prompt, ambos llegaron a la misma longitud.
¿Corrigió GPT-6.1 las respuestas breves de GPT-6 Luna? La actualización 6.1 de OpenAI solo afecta a la gama Sol: GPT-6.1 Sol vuelve a escribir respuestas tan largas como las de GPT-5.6 Sol, mientras que GPT-6 Luna no ha cambiado desde su lanzamiento el 2026-09-22.
Más mediciones: GPT-6.1 Sol frente a Claude Sonnet 5.5, comparativa de LLMs de la gama flash y cómo reducir costes con GPT-5.6.