
GPT-6.1 Sol vs Claude Sonnet 5.5: mismo $2/$10, mitad por tarea
Contenido
- ¿Qué es GPT-6.1 Sol y qué afirma OpenAI sobre el modelo?
- ¿Con qué modelo conviene compararlo: Opus 5.5, Sonnet 5.5 o GPT-6 Sol?
- ¿Cómo hicimos las pruebas?
- ¿Cuesta menos GPT-6.1 Sol que Sonnet 5.5 por tarea?
- ¿Cuál respeta «solo la respuesta» y cuál acierta?
- ¿Corrigió GPT-6.1 Sol las respuestas breves de GPT-6 Sol?
- ¿Es más lento GPT-6.1 Sol?
- ¿Qué ocurre en un bucle de herramientas?
- ¿Coinciden nuestros resultados con otras pruebas publicadas?
- ¿Qué observamos y cuál conviene usar?
- Preguntas frecuentes
GPT-6.1 Sol y Claude Sonnet 5.5 tienen el mismo precio de lista: $2 por millón de tokens de entrada y $10 por millón de salida. Pero el coste por tarea es muy distinto. Con el nivel de razonamiento predeterminado de cada API, GPT-6.1 Sol costó aproximadamente la mitad (0.49x); para una misma puntuación en un índice independiente, alrededor de una cuarta parte. Frente a Claude Opus 5.5, el rival que citó OpenAI, costó 0.29x. Por el coste adicional, Sonnet 5.5 ofrece una puntuación máxima entre 4 y 6 puntos superior en índices independientes, respuestas más rápidas y ninguna respuesta incorrecta en una tarea que GPT-6.1 Sol falló varias veces.
TL;DR
- Con los ajustes predeterminados de las API, GPT-6.1 Sol costó 0.49x frente a Sonnet 5.5 y 0.29x frente a Opus 5.5 por tarea en 13 tareas.
- Artificial Analysis da una puntuación de 52 tanto a GPT-6.1 Sol en
maxcomo a Sonnet 5.5 enxhigh, con costes de $0.72 y $2.74 por tarea. - GPT-6.1 Sol respondió solo con el valor solicitado en 234 de 234 prompts; Sonnet 5.5 lo hizo en 22 de 39 con su ajuste predeterminado.
- Sonnet 5.5 acertó en 234 de 234 llamadas; GPT-6.1 Sol falló una tarea en 7 de 18 llamadas.
¿Qué es GPT-6.1 Sol y qué afirma OpenAI sobre el modelo?
GPT-6.1 Sol es la actualización del modelo de gama media de OpenAI. Salió el 2026-09-29, siete días después de GPT-6 Sol, al mismo precio. Durante esa semana, los desarrolladores criticaron las respuestas breves de GPT-6 Sol, Anthropic lanzó Sonnet 5.5 al mismo precio de $2 / $10 y OpenAI canceló el lanzamiento previsto de su modelo insignia GPT-6.1 Astra tras detectar engaños y acciones no autorizadas en pruebas internas, según informó CBC.
Los precios por token, la ventana de contexto de 1,050,000 tokens y el límite de salida de 128,000 tokens no cambian. La entrada en caché ahora cuesta $0.10 por millón de tokens, frente a los $0.20 anteriores. El cambio que puede romper código está en reasoning.effort, el parámetro de Responses API que determina cuánto razonamiento interno hace el modelo antes de responder y que se factura como salida. Ahora va de low a max, con medium como valor predeterminado, y none ha desaparecido. Las solicitudes que desactivaban el razonamiento en GPT-6 Sol deben usar low. Para las llamadas a herramientas, que Chat Completions solo permitía con none, ahora hay que usar Responses API.
OpenAI compara el modelo con dos modelos insignia: su propio GPT-6 Astra y Claude Opus 5.5 de Anthropic. Según sus pruebas, iguala a Astra en DeepSWE v1.1 (programación agéntica) por cerca de una quinta parte del coste; queda a 2.1 puntos en OSWorld 2.0 (uso del ordenador) por cerca de una séptima parte; supera a Opus 5.5 por 2.2 puntos en AutomationBench (flujos de trabajo empresariales) con medium; y cuesta $5.47 por tarea de Terminal-Bench Science con max, frente a $23.21 de Opus 5.5. Son pruebas de OpenAI y no incluyen a Sonnet 5.5. El lanzamiento también anunció el nivel Ultrafast, hasta 6x más rápido a 6x el precio.
¿Con qué modelo conviene compararlo: Opus 5.5, Sonnet 5.5 o GPT-6 Sol?
Sonnet 5.5 es la comparación más útil: tiene el mismo precio de lista y deja claro que compartir tarifa no implica el mismo coste por tarea. La tabla sitúa a los tres candidatos junto a GPT-6.1 Sol. Los resultados de benchmarks independientes proceden de las páginas de sus responsables.
| GPT-6.1 Sol | Opus 5.5 | Sonnet 5.5 | GPT-6 Sol | |
|---|---|---|---|---|
| Precio de lista, entrada / salida por 1M tokens | $2 / $10 | $4 / $20 | $2 / $10 | $2 / $10 |
| Lanzamiento | 2026-09-29 | 2026-09-22 | 2026-09-28 | 2026-09-22 |
| Comparaciones en su lanzamiento | GPT-6 Astra, Opus 5.5 | Fable 5.1, Opus 5, GPT-6 Astra | Opus 5.5, GPT-6 Sol | GPT-6 Astra, Opus 5, Fable 5 |
Índice de inteligencia de Artificial Analysis en max (pruebas de razonamiento, conocimientos y programación) | 52 | 58 | 56 | 48 |
Coste por tarea del índice en max | $0.72 | $5.98 | $7.60 | $1.04 |
| Índice Vals (programación, derecho, fiscalidad, medicina y otras tareas profesionales) | 61.2% | 67.0% | 67.0% | 57.5% |
| Coste por prueba de Vals | $3.24 | $32.14 | $21.34 | $7.58 |
Clasificación pública de AutomationBench 1.0.6 en max (flujos de trabajo empresariales entre aplicaciones) | no figura | 42.47%, $1.44 por tarea | 44.75%, $1.14 por tarea | no figura |
- Opus 5.5 es el rival que citó OpenAI, pero su precio de lista es el doble y obtiene unos 6 puntos más en ambos índices.
- GPT-6 Sol es el predecesor al mismo precio. GPT-6.1 Sol lo supera en ambos índices y cuesta menos por tarea. Esa comparación solo sirve para decidir si conviene actualizar.
- Sonnet 5.5 tiene el mismo precio de lista, salió un día antes y también se presentó como alternativa a Opus 5.5. Queda a 2 puntos de Opus 5.5 y supera a GPT-6.1 Sol por entre 4 y 6 puntos.
El mismo precio de lista no los hace equivalentes. GPT-6.1 Sol ofrece su puntuación a menor coste que ambos modelos de Claude:
- Con una puntuación equivalente, cuesta entre una quinta y una cuarta parte que Sonnet 5.5: Artificial Analysis da 52 puntos tanto a Sonnet 5.5 en
xhighcomo a GPT-6.1 Sol enmax, con un coste de $2.74 frente a $0.72 por tarea. Un nivel por debajo, Sonnet 5.5 enhighalcanza 47 puntos por $1.08 y GPT-6.1 Sol enmedium, 48 por $0.21. - En los resultados principales de los índices, el coste por tarea de Sonnet 5.5 está en el rango de Opus 5.5 ($7.60 frente a $5.98 en Artificial Analysis con
max, $21.34 frente a $32.14 en Vals). Cada uno cuesta entre 7 y 11 veces más que GPT-6.1 Sol.
A cambio, Sonnet 5.5 y Opus 5.5 llegan a 56 y 58 puntos en Artificial Analysis, puntuaciones que GPT-6.1 Sol no alcanza con ningún ajuste.
¿Cómo hicimos las pruebas?
Ejecutamos tres conjuntos de tareas, todos evaluados mediante código, en la API nativa de cada modelo (Responses para GPT y Messages para Claude):
| Prueba | Contenido | Qué medimos |
|---|---|---|
| Tareas de una sola respuesta | 13 tareas con respuesta conocida (por ejemplo, un problema de mochila con 10 elementos: encontrar la mejor combinación sin superar un límite de peso), todas terminadas en “Reply with a single integer, nothing else”; 3 repeticiones por nivel de razonamiento | respuesta correcta, respuesta sin texto adicional (solo el valor), coste, tiempo |
| Documentos empresariales | 80 prompts que solo indican el objetivo (“Write the Q3 regional review”) y 80 que enumeran las partes obligatorias: informes trimestrales, análisis posteriores a incidentes, comparativas de proveedores, respuestas de soporte | presencia de todas las partes previstas, palabras, coste |
| Bucle de herramientas | 4 preguntas sobre código en un repositorio sintético pequeño, 3 herramientas, 3 repeticiones | preguntas resueltas, llamadas a herramientas, coste, tiempo |
Cada prompt incluía una cadena aleatoria única para evitar respuestas procedentes de caché, y calculamos el coste con precios de lista. Las cifras de tareas de una sola respuesta y bucles de herramientas de Sonnet 5.5 y Opus 5.5 vienen de nuestras mediciones de Sonnet 5.5 del día anterior, hechas con las mismas tareas y evaluadores. Solo consideramos significativa una diferencia si supera la corrección de Holm, que eleva el umbral al probar varias comparaciones a la vez. Las comparaciones de respuestas sin texto adicional se cuentan por tarea, porque las repeticiones de una misma tarea no son independientes.
¿Cuesta menos GPT-6.1 Sol que Sonnet 5.5 por tarea?
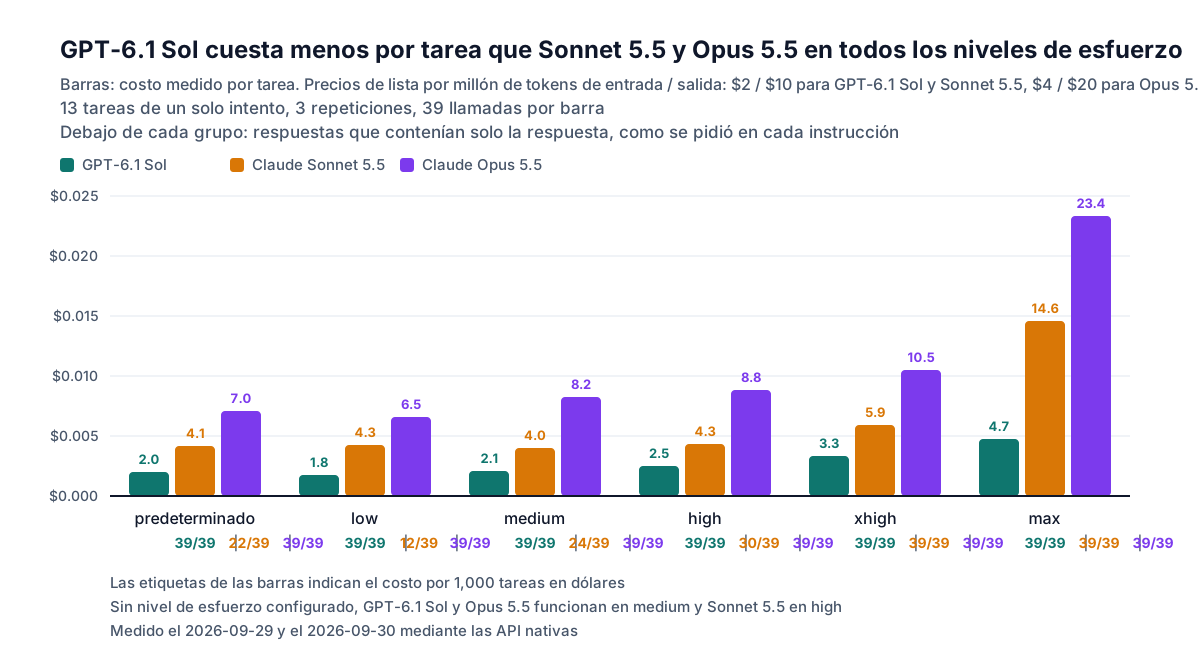
GPT-6.1 Sol costó cerca de la mitad. Con los ajustes predeterminados de cada API, cada tarea de una sola respuesta costó $0.0020 con este modelo y $0.0042 con Sonnet 5.5: una proporción de 0.49 (intervalo del 95% de 0.40 a 0.59, calculado mediante remuestreo de las 13 tareas). Sonnet 5.5 generó entre 1.7 y 2.5 veces más tokens de salida en los niveles inferiores a max, y 3.1 veces más en max. Opus 5.5, con el doble de precio de lista, costó $0.0070 con su ajuste predeterminado. Por tanto, GPT-6.1 Sol costó 0.29x frente a Opus.
La proporción se mantuvo en todos los niveles de razonamiento: entre 0.33x y 0.58x del coste de Sonnet 5.5 y entre 0.20x y 0.31x del de Opus 5.5. Si no se especifica el nivel, GPT-6.1 Sol y Opus 5.5 usan medium, mientras que Sonnet 5.5 usa high. Las otras dos pruebas dieron la misma proporción frente a Sonnet 5.5, 0.46x: $0.0103 frente a $0.0223 por documento empresarial cuyo prompt solo indicaba el objetivo, y $0.0052 frente a $0.0112 por ejecución del bucle de herramientas.
El nivel de razonamiento se configura con un campo de la solicitud; los tokens facturados aparecen en usage:
from openai import OpenAI

client = OpenAI()
resp = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},  # low, medium (default), high, xhigh, max; "none" is not listed for 6.1
    input="Compute 7 raised to the power 222, modulo 1000. Reply with a single integer, nothing else.",
)
print(resp.output_text)
u = resp.usage
print(u.output_tokens, u.output_tokens_details.reasoning_tokens, u.input_tokens_details.cached_tokens)
output_tokens incluye los tokens de razonamiento, y cached_tokens es la parte de la entrada que se factura a $0.10 por millón.
¿Cuál respeta «solo la respuesta» y cuál acierta?
GPT-6.1 Sol respetó el formato en todos los prompts. Sonnet 5.5 no cometió errores en la tarea que GPT-6.1 Sol falló varias veces. GPT-6.1 Sol respondió solo con el valor en los 234 prompts, igual que Opus 5.5. Sonnet 5.5 lo hizo en 22 de 39 con su ajuste predeterminado, 12 con low, 24 con medium y 30 con high. Por debajo de xhigh, a veces omite el bloque de pensamiento (la parte separada de razonamiento en una respuesta de Claude) y escribe el desarrollo en la respuesta, como explicamos en nuestro artículo sobre Sonnet 5.5. Contada por tarea, la diferencia supera la corrección con low (GPT-6.1 Sol fue mejor en 9 de 13 tareas y peor en ninguna), pero no con los ajustes predeterminados (6 y ninguna). El código que espera un único valor puede leer directamente la respuesta de GPT-6.1 Sol; con Sonnet 5.5, conviene tomar la última línea o usar xhigh.
Sonnet 5.5 acertó en las 234 llamadas y Opus 5.5 falló 2. GPT-6.1 Sol respondió 72 al problema de la mochila en 7 de sus 18 llamadas, cuando el valor correcto, comprobado probando todos los subconjuntos, es 62: tres de tres con low, una de tres con su ajuste predeterminado y con medium, dos de tres con xhigh, y ninguna con high ni max. Una tarea de 13 no basta para demostrar una diferencia de precisión, pero sí muestra que el error pasa inadvertido: la respuesta es un entero con el formato correcto y aumentar el nivel de razonamiento no lo evitó de forma fiable.
¿Corrigió GPT-6.1 Sol las respuestas breves de GPT-6 Sol?
GPT-6.1 Sol vuelve a dar respuestas extensas. En los prompts que solo indican qué documento hay que escribir, sin enumerar sus partes, produjo 565 palabras por documento frente a las 325 de GPT-6 Sol. Fue más largo en los 80 casos y quedó cerca de GPT-5.6 Sol, con 592. No pudimos reproducir la queja de que GPT-6 Sol omitía contenido: incluyó todo lo necesario (todas las regiones, todos los eventos de cada incidente y una respuesta a cada ticket) en 58 de 60 documentos evaluados, igual que GPT-5.6 Sol. Las 20 comparativas de proveedores no se evaluaron porque elegir al proveedor adecuado requiere un juicio subjetivo.
Cuando el prompt enumeraba las partes obligatorias, los tres modelos de OpenAI incluyeron todo en 80 de 80 casos. Sonnet 5.5 escribió los documentos más largos cuando solo se indicaba el objetivo (747 palabras) y también completó todos los documentos evaluados de ese grupo. En cambio, incumplió las condiciones en 12 de 80 prompts con partes especificadas: en cada caso, un memorando o una recomendación quedó entre 1 y 28 palabras por debajo del rango solicitado. La diferencia supera la corrección, pero 10 de los 12 casos son informes trimestrales, así que aporta poca información sobre otros tipos de documento.
Las respuestas más largas elevaron el coste por documento cuyo prompt solo indicaba el objetivo de $0.0078 con GPT-6 Sol a $0.0103. Aun así, sigue siendo un 59% inferior al de GPT-5.6 Sol, cuyo precio de lista es $4 / $20 (precio promocional hasta el 2026-11-21). Si se recalculan los tokens de GPT-5.6 Sol a $2 / $10, GPT-6.1 Sol sale un 19% más barato porque usa menos tokens para una extensión similar.
¿Es más lento GPT-6.1 Sol?
GPT-6.1 Sol es más lento que sus predecesores y que Sonnet 5.5, sobre todo con respuestas largas. En los documentos empresariales generó unos 43 tokens de salida por segundo de tiempo total de solicitud, frente a 100 de GPT-6 Sol, 80 de GPT-5.6 Sol y 127 de Sonnet 5.5. La mediana para un documento cuyo prompt solo indicaba el objetivo fue de 22.4 segundos, frente a 7.2, 13.9 y 17.2. En las tareas breves de una sola respuesta, la diferencia es menor: 5.7 segundos con los ajustes predeterminados, frente a 3.9 de Sonnet 5.5 y 5.5 de Opus 5.5. La velocidad absoluta depende del proveedor y de la hora. Artificial Analysis también sitúa a GPT-6.1 Sol por debajo de la mitad de la velocidad de Sonnet 5.5: 64 tokens por segundo frente a 139.
¿Qué ocurre en un bucle de herramientas?
GPT-6.1 Sol y Sonnet 5.5 resolvieron las 12 ejecuciones en todos los niveles. GPT-6.1 Sol lo hizo por menos de la mitad del coste, pero tardó casi el doble. En un bucle de herramientas, el modelo solicita una herramienta, el código que lo invoca la ejecuta y devuelve el resultado; el ciclo se repite hasta que el modelo responde. Nuestra prueba usa tres herramientas (listar archivos, leer un archivo y buscar) sobre un repositorio sintético pequeño. Con los ajustes predeterminados, cada ejecución costó $0.0052 con GPT-6.1 Sol, $0.0112 con Sonnet 5.5 y $0.0332 con Opus 5.5. Las medianas de tiempo fueron 12.2, 6.7 y 25.3 segundos. En max, GPT-6.1 Sol subió a $0.0086 y Sonnet 5.5 a $0.0422, con 6.4 y 14.7 llamadas a herramientas por ejecución.
¿Coinciden nuestros resultados con otras pruebas publicadas?
Nuestros resultados coinciden con las pruebas publicadas en la tendencia. Las magnitudes varían porque nuestras tareas son breves y se ejecutan principalmente con los ajustes predeterminados de las API, mientras que los índices públicos usan tareas largas en max.
| Pregunta | Datos publicados por otros | Nuestra medición | Conclusión |
|---|---|---|---|
| Coste de GPT-6.1 Sol frente a Sonnet 5.5 | Artificial Analysis: $0.72 frente a $7.60 por tarea del índice en max, unas 11 veces menos | 0.49x con los ajustes predeterminados, 0.33x en max | Misma tendencia; en max, la diferencia crece en tareas más largas: 0.33x en tareas de una sola respuesta, 0.20x en nuestro bucle de herramientas y 0.09x en el índice |
| Velocidad | Artificial Analysis: 64 frente a 139 tokens de salida por segundo; Vals AI: las tareas agénticas tardan entre 2 y 3 veces más que con GPT-6 Sol | 43 frente a 127 tokens por segundo; 22.4 s frente a los 7.2 s de GPT-6 Sol por documento | Coincide |
| Calidad frente a Sonnet 5.5 | Artificial Analysis: 52 frente a 56; Vals: 61.2% frente a 67.0% | Sonnet 5.5 acertó en 234 de 234; GPT-6.1 Sol falló una tarea 7 de 18 veces | Misma tendencia; nuestro resultado depende de una sola tarea |
| Respuestas de GPT-6 Sol demasiado breves o con contenido ausente | Quejas de desarrolladores, por ejemplo en el hilo del lanzamiento en Hacker News | 325 palabras por documento frente a 592 de GPT-5.6 Sol; incluyó todo lo necesario en 58 de 60, igual que GPT-5.6 Sol | Brevedad confirmada; no se reprodujo la omisión de contenido |
| Sonnet 5.5 ignora «solo la respuesta» | No encontramos informes publicados | 22 de 39 respuestas sin texto adicional con su ajuste predeterminado, 12 de 39 con low | Solo nuestras pruebas |
¿Qué observamos y cuál conviene usar?
GPT-6.1 Sol ofrece mejor relación entre calidad y coste que Sonnet 5.5 y Opus 5.5. Sonnet 5.5 merece el coste adicional cuando importan la latencia o esos últimos 4 a 6 puntos de calidad. Cuatro observaciones sustentan esta conclusión:
- GPT-6.1 Sol ofrece la calidad obtenida a menor coste que ambos modelos de Claude. Frente a Sonnet 5.5 cuesta cerca de la mitad por tarea breve, cerca de una cuarta parte para una puntuación equivalente en el índice y entre una séptima y una décima parte en los resultados principales de los índices. Frente a Opus 5.5 cuesta 0.29x por tarea breve y entre una octava y una décima parte en los índices.
- Respeta mejor el formato de salida. Entregó lo solicitado en todos los prompts que pedían solo la respuesta y en todos los documentos con partes especificadas.
- Corregir las respuestas breves redujo la velocidad. Las respuestas vuelven a tener una extensión similar a las de GPT-5.6 Sol, pero cada documento tarda tres veces más que con GPT-6 Sol.
- Sus errores son difíciles de detectar. Las 7 respuestas incorrectas aparecieron con
low,mediumyxhigh, y todas eran enteros con el formato correcto.
| Tipo de trabajo | Elección | Datos |
|---|---|---|
| Salida procesada por código: extracción, clasificación, valores únicos | GPT-6.1 Sol en medium o high | respuesta sin texto adicional en 234 / 234; $0.0021 por tarea en medium |
| Matemáticas o lógica de varios pasos donde un valor incorrecto sale caro | Sonnet 5.5, o GPT-6.1 Sol con verificación del resultado | Sonnet 5.5 acertó en 234 / 234; GPT-6.1 Sol falló en 7 de 18 llamadas para una tarea |
| Chat y herramientas interactivas, donde importa la latencia | Sonnet 5.5 con su ajuste predeterminado | 3.9 s frente a 5.7 s por tarea breve; 17.2 s frente a 22.4 s por documento |
| Bucles de agentes donde importa más el coste por ejecución que la latencia | GPT-6.1 Sol con su ajuste predeterminado | $0.0052 por ejecución frente a $0.0112; 12.2 s frente a 6.7 s |
| Documentos con secciones obligatorias | GPT-6.1 Sol, o Sonnet 5.5 con márgenes amplios de extensión | incluyó todo lo necesario en 80 / 80 frente a 68 / 80; los casos fallidos quedaron entre 1 y 28 palabras cortos |
| Trabajo difícil y abierto donde importa la puntuación máxima | Sonnet 5.5 u Opus 5.5 en max | puntuaciones de 56 y 58 frente a 52 en índices públicos, por un coste por tarea entre 7 y 11 veces mayor |
Con cualquiera de los modelos, valida los valores que vaya a utilizar un programa.
Preguntas frecuentes
¿Cuesta menos GPT-6.1 Sol que Claude Sonnet 5.5?
GPT-6.1 Sol cuesta menos por tarea que Sonnet 5.5 pese a compartir el precio de lista de $2 / $10: 0.49x por tarea de una sola respuesta con los ajustes predeterminados de cada modelo y 0.46x por ejecución del bucle de herramientas en nuestras pruebas. Con una puntuación equivalente de 52 en Artificial Analysis, cuesta $0.72 frente a $2.74. Sonnet 5.5 fue más rápido y puntúa más alto en max.
¿Es GPT-6.1 Sol tan bueno como Claude Opus 5.5? GPT-6.1 Sol queda unos 6 puntos por debajo de Opus 5.5 tanto en el índice de inteligencia de Artificial Analysis (52 frente a 58) como en el índice Vals (61.2% frente a 67.0%), con un coste por tarea de entre una octava y una décima parte. En nuestras pruebas costó 0.29x por tarea breve. En las pruebas de OpenAI lo supera por 2.2 puntos en AutomationBench.
¿Puedo seguir desactivando el razonamiento en GPT-6.1 Sol?
El nivel de razonamiento más bajo de GPT-6.1 Sol es low; none, que aceptaba GPT-6 Sol, ya no está disponible. Usa low, que en nuestras pruebas costó $0.0018 por tarea de una sola respuesta.
Mediciones relacionadas: Claude Sonnet 5.5 frente a Sonnet 5, los niveles de razonamiento de GPT-6 Astra y cómo reducir el coste de GPT-5.6.
Mediciones realizadas el 2026-09-30, un día después del lanzamiento de GPT-6.1 Sol, mediante un gateway hacia OpenAI Responses API y Anthropic Messages API: 234 llamadas de una sola respuesta a GPT-6.1 Sol (13 tareas, 3 repeticiones, 6 ajustes), 800 llamadas para documentos empresariales (80 prompts que solo indicaban el objetivo en 6 combinaciones de modelo y nivel de razonamiento, y 80 que especificaban las partes en 4) y 36 ejecuciones del bucle de herramientas. Las cifras de Sonnet 5.5 y Opus 5.5 para tareas de una sola respuesta y bucles de herramientas proceden del 2026-09-29, con las mismas tareas. Consultamos los resultados de los benchmarks públicos en las páginas de sus responsables el 2026-10-01.