
Sonnet 5.5 vs Sonnet 5: mismo precio, 80% menos por tarea
Contenido
- ¿Qué cambió en Claude Sonnet 5.5?
- ¿Qué dicen los benchmarks del lanzamiento?
- ¿Cómo lo medimos?
- ¿Sonnet 5.5 cuesta menos por tarea que Sonnet 5?
- ¿Cuánto cuesta cada nivel de esfuerzo?
- ¿Por qué Sonnet 5.5 incluye los cálculos en la respuesta?
- ¿Qué ocurre en un bucle de herramientas?
- ¿Sonnet 5.5 es más rápido?
- ¿Sirven los presupuestos de tokens de Sonnet 5?
- ¿Cuál deberías usar?
- FAQ
Claude Sonnet 5.5 tiene los mismos precios por token que Claude Sonnet 5: $2 por millón de tokens de entrada y $10 por millón de salida. Todo el ahorro procede, por tanto, de usar menos tokens. En 13 tareas de un solo turno, con la configuración predeterminada de la API, costó $0.0041 por tarea frente a $0.021 de Sonnet 5, un 80% menos. Ambos modelos resolvieron correctamente todas las tareas. El problema está en el formato de salida: por debajo del nivel de esfuerzo xhigh, Sonnet 5.5 a veces omite el razonamiento oculto y muestra los cálculos en la respuesta, aunque el prompt pida únicamente el resultado.
TL;DR
- Con la configuración predeterminada de la API, Sonnet 5.5 costó $0.0041 por tarea frente a $0.021 de Sonnet 5. Ambos acertaron en las 39 llamadas.
- Sonnet 5.5 costó prácticamente lo mismo con esfuerzo
low,mediumyhigh;maxcostó 3.5x más que la configuración predeterminada. - Por debajo de
xhigh, Sonnet 5.5 incluyó los cálculos en 68 de 156 respuestas que debían contener solo el resultado. Un system prompt no lo corrigió. - En un bucle de herramientas con cuatro preguntas, Sonnet 5.5 en
maxcostó $0.042 por ejecución, más que Opus 5.5 con su configuración predeterminada ($0.033).
Anthropic lanzó Sonnet 5.5 el 2026-09-28 y afirmó que era un 30% más rápido y costaba “hasta un 30% menos por tarea” que Sonnet 5. Lo medimos al día siguiente.
¿Qué cambió en Claude Sonnet 5.5?
El precio no cambió, pero sí los controles de thinking y varios parámetros de las peticiones. Sonnet 5.5 usa adaptive thinking: el modelo decide cuánto razonamiento oculto necesita antes de responder, y esos tokens de razonamiento se facturan como salida. Se controla mediante effort (output_config.effort en la Messages API), un parámetro de petición con cinco niveles, desde low hasta max. El valor predeterminado de la API es high.
| Sonnet 5.5 | Sonnet 5 | Opus 5.5 | |
|---|---|---|---|
| Lanzamiento | 2026-09-28 | 2026-06-30 | 2026-09-22 |
| Entrada / salida, por 1M de tokens | $2 / $10 | $2 / $10 | $4 / $20 |
| Lectura de caché, por 1M de tokens | $0.20 | $0.20 | $0.20 |
| Ventana de contexto / salida máxima | 1M / 128K | 1M / 128K | 1M / 128K |
| Corte de conocimiento (solo se publicó el mes) | junio de 2026 | enero de 2026 | junio de 2026 |
| Esfuerzo predeterminado en la API | high | high | medium |
| Ajuste mínimo de thinking | between_tools (con high o inferior) | disabled | no se puede desactivar; thinking siempre está activo |
| Prompt mínimo almacenable en caché | 512 tokens | 1,024 tokens | 512 tokens |
El precio de lanzamiento de Sonnet 5, $2 / $10, se presentó como una tarifa inicial, pero la página de precios de Anthropic ya lo muestra como precio estándar. La subida prevista a $3 / $15 no llegó a aplicarse.
Según la guía de migración, las siguientes peticiones funcionaban con Sonnet 5, pero devuelven HTTP 400 con Sonnet 5.5:
thinking: {"type": "disabled"}. Hay que usarthinking: {"type": "between_tools"}, que desactiva el razonamiento antes de la primera respuesta y solo se admite con esfuerzohigho inferior.- Uso forzado de herramientas (
tool_choiceconfigurado comoanyo con una herramienta concreta). Hay que mantenerautoe indicar en el prompt cuándo corresponde usar la herramienta. - Un presupuesto manual de thinking (
budget_tokens), valores no predeterminados detemperature,top_potop_k, y un turno de assistant precompletado para iniciar la respuesta del modelo. - Reenviar un bloque de thinking de Sonnet 5.5 después de cambiar el system prompt, las herramientas o un mensaje anterior, en cuentas creadas a partir de 2026-08-31.
- La antigua herramienta de uso del ordenador
computer_20251124en la Claude API y Google Cloud.
Hay un cambio que no genera errores: las notas breves que el modelo escribe entre llamadas a herramientas ahora llegan como bloques de thinking. Con la configuración de visualización predeterminada están vacíos, por lo que una interfaz que los transmita por streaming deja de mostrar actividad.
¿Qué dicen los benchmarks del lanzamiento?
La tabla de Anthropic sitúa a Sonnet 5.5 a pocos puntos de Opus 5.5 por la mitad del precio por token, y muy por delante de Sonnet 5.
| Benchmark (qué mide) | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (programación con agentes en una terminal) | 70.6% | 10.3% | 66.4% (xhigh) | no publicado |
| CursorBench 4.0 (programación en un editor) | 55.5% | 34.1% | 57.8% | no publicado |
| GDPval-AA v2.1 (documentos de trabajo del conocimiento, puntuación Elo, cuanto más alta mejor) | 1844 | 1449 | 1846 | 1487 |
| OSWorld 2.1 (uso del ordenador, con puntuación parcial) | 80.1% | 57.0% | 81.8% | no publicado |
| Humanity’s Last Exam, con herramientas | 64.5% | 54.9% | 67.7% | no publicado |
Artificial Analysis añade una advertencia sobre el coste: con esfuerzo max, Sonnet 5.5 obtuvo 56 puntos en su Intelligence Index, dos menos que Opus 5.5 en max, pero utilizó unos 193K tokens de salida por tarea. Es la cifra más alta que ha medido y supera en torno a un 60% a Opus 5.5 o Sonnet 5 en max, con un coste aproximado de $7.60 por tarea del índice.
¿Cómo lo medimos?
Enviamos 13 tareas de un solo turno, con un prompt, una respuesta y sin herramientas, a los tres modelos. Todas tenían respuestas conocidas: ocho eran cortas, como sumar los números primos inferiores a 60 o contar el dígito 7 entre 1 y 500, y cinco exigían varios pasos reales, como resolver una mochila de 10 elementos, calcular rutas en una cuadrícula 8x8 con casillas bloqueadas o elevar 13 a 1,001 módulo 10,007. Verificamos cada respuesta mediante fuerza bruta en local y terminamos todos los prompts con “Responde con un único entero y nada más”. Cada tarea se ejecutó 3 veces con la configuración predeterminada de la API y con cada uno de los cinco niveles de esfuerzo. En total fueron 702 llamadas a la Messages API nativa. Cada prompt incluía una cadena aleatoria única para evitar respuestas procedentes de caché, y calculamos el coste con los precios de lista de Anthropic. Evaluamos si el resultado final era correcto y si la respuesta contenía únicamente ese resultado.
La precisión no permitió distinguir entre los modelos. Sonnet 5.5 acertó en las 234 llamadas y Sonnet 5 en las 233 que devolvieron respuesta, ya que una terminó con un error del servidor. Opus 5.5 falló una tarea con low y otra con la configuración predeterminada.
¿Sonnet 5.5 cuesta menos por tarea que Sonnet 5?
Sonnet 5.5 costó un 80% menos que Sonnet 5 con la configuración predeterminada, y entre un 77% y un 78% menos con low, medium y high, porque generó alrededor de una quinta parte de los tokens de salida. Los precios de lista son idénticos, así que todo el ahorro se debe a la eficiencia en tokens. Sonnet 5 generó entre 1,800 y 2,100 tokens por tarea en todos los niveles de esfuerzo. Sonnet 5.5 se mantuvo cerca de 400 hasta xhigh.
| Las 13 tareas, por tarea | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Configuración predeterminada de la API | $0.0041 (396 tokens) | $0.0212 (2,105) | $0.0070 (334) |
low | $0.0043 (409) | $0.0184 (1,817) | $0.0065 (309) |
medium | $0.0040 (383) | $0.0180 (1,780) | $0.0082 (393) |
high | $0.0043 (416) | $0.0188 (1,858) | $0.0088 (421) |
xhigh | $0.0059 (574) | $0.0202 (2,001) | $0.0105 (507) |
max | $0.0146 (1,438) | $0.0193 (1,909) | $0.0234 (1,149) |
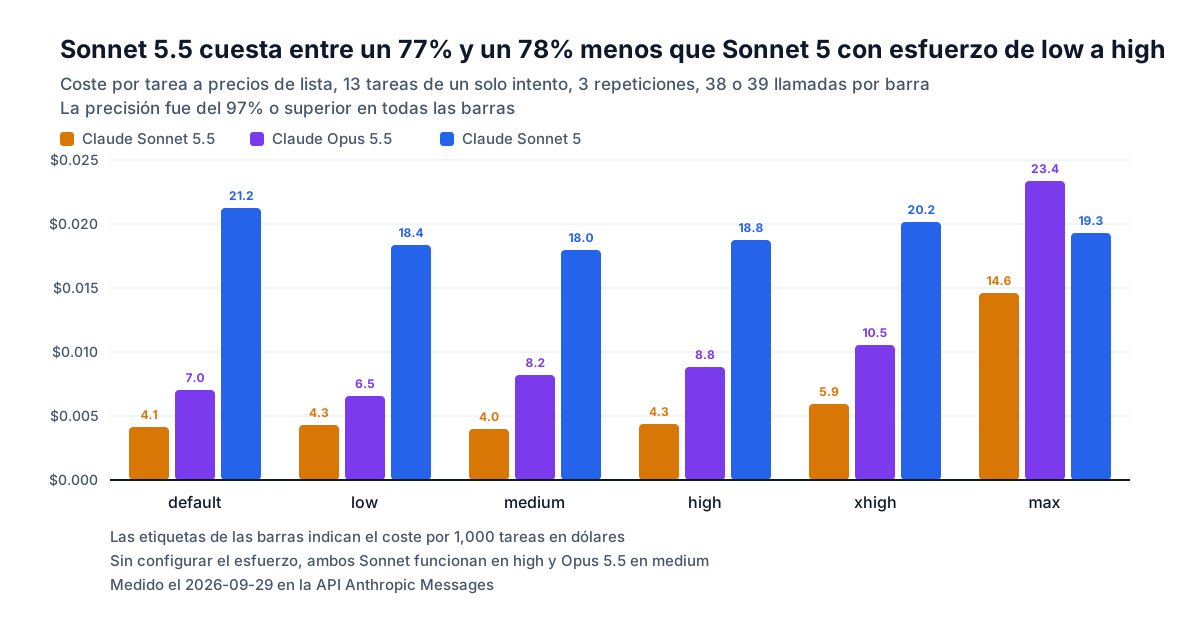
Los recuentos muestran la media de tokens de salida por llamada, incluido el razonamiento. En las cinco tareas difíciles, el ahorro con la configuración predeterminada es del 84% ($0.0057 frente a $0.0348). En nuestro bucle de herramientas, donde se vuelve a enviar toda la conversación en cada turno y predominan los tokens de entrada, el ahorro es del 8%. La afirmación de Anthropic de “hasta un 30%” resulta conservadora para prompts individuales como estos y generosa para un bucle corto como el nuestro.
Con solo 13 tareas, el ahorro del 80% con la configuración por defecto tiene un rango amplio: remuestrear las tareas da un intervalo del 95% de entre un 66% y un 85% menos, y el límite inferior se mantiene por encima del 50% en cada nivel de low a xhigh.
¿Cuánto cuesta cada nivel de esfuerzo?
En Sonnet 5.5, low, medium y high costaron alrededor de $0.0042 por tarea, así que usar high como valor predeterminado no añadió coste en estas pruebas. xhigh costó cerca de un 40% más y max, 3.5x más que la configuración predeterminada. En max, Sonnet 5.5 costó el doble por tarea que Opus 5.5 con su configuración predeterminada ($0.0146 frente a $0.0070), sin mejorar la precisión.
Este comportamiento plano no se repetirá en todas las cargas. En una tarea de DevOps más larga, otro evaluador observó que high utilizaba aproximadamente el doble de tokens de salida que medium. Si el nivel de esfuerzo afecta a una carga de trabajo, hay que probar todos los niveles.
¿Por qué Sonnet 5.5 incluye los cálculos en la respuesta?
Por debajo de xhigh, Sonnet 5.5 no siempre usa un bloque de thinking. Cuando lo omite, razona directamente en la respuesta. Un bloque de thinking es una parte independiente de la respuesta que contiene el razonamiento del modelo. Su texto está vacío de forma predeterminada y la respuesta aparece después en un bloque text.
De las 234 respuestas de Sonnet 5.5, las 166 que incluían un bloque de thinking contenían únicamente el resultado. Las 68 restantes, sin ese bloque, mostraban primero los cálculos. Por ejemplo, “09:47 + 3:46 = 13:33 … + 1:39 = 15:40”, seguido de “15:40”. El resultado final siempre era correcto, pero el formato no respetaba el prompt.
| Respuestas con solo el resultado | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Configuración predeterminada de la API | 22 / 39 | 38 / 39 | 38 / 39 |
low | 12 / 39 | 37 / 39 | 38 / 39 |
medium | 24 / 39 | 37 / 39 | 39 / 39 |
high | 30 / 39 | 38 / 39 | 39 / 39 |
xhigh | 39 / 39 | 35 / 38 | 39 / 39 |
max | 39 / 39 | 37 / 39 | 39 / 39 |
El comportamiento depende de la tarea: donde ocurrió, Sonnet 5.5 mostró los cálculos en las tres repeticiones, salvo en una tarea con la configuración predeterminada, donde lo hizo dos veces. Ocurrió en 9 de las 13 tareas con low, 6 con la configuración predeterminada, 5 con medium y 3 con high (todas cuentas aritméticas cortas). Contadas por tarea, con solo 13 tareas, ninguna de estas diferencias supera una corrección de Holm, así que los recuentos deben leerse como lo observado, no como una tasa con la que planificar. Los fallos de Sonnet 5 son distintos: muestra una respuesta correcta en negrita y después añade una explicación breve. La fila xhigh tiene 38 llamadas porque una terminó con un error del servidor.
Añadir un system prompt que pidiera “solo el resultado final” y que cualquier cálculo se hiciera en silencio no ayudó. Sonnet 5.5 devolvió únicamente el resultado en 8 de 24 tareas cortas con low y en 9 de 24 con medium, frente a 6 y 9 sin esa instrucción. xhigh sí lo corrigió: siempre produjo un bloque de thinking y una respuesta con solo el resultado, a un coste aproximado un 40% mayor que entre low y high. Para código que analiza la salida del modelo:
- Usa
xhighcuando la respuesta deba ocupar una sola línea. - Otra opción es leer el resultado de la última línea no vacía, que fue correcto en los 68 casos.
- Las salidas estructuradas de Anthropic también permiten restringir la respuesta a un schema, pero no probamos esta opción.
import anthropic

client = anthropic.Anthropic()
prompt = "Compute 7 raised to the power 222, modulo 1000. Reply with a single integer, nothing else."
resp = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    output_config={"effort": "xhigh"},  # low, medium, high (API default), xhigh, max
    messages=[{"role": "user", "content": prompt}],
)
text = "".join(block.text for block in resp.content if block.type == "text")
lines = text.strip().splitlines()
answer = lines[-1] if lines else None  # below xhigh, working can precede the answer
print(answer, resp.usage.output_tokens)  # output_tokens includes the reasoning
¿Qué ocurre en un bucle de herramientas?
Con la configuración predeterminada, low y medium, Sonnet 5.5 completó todas las ejecuciones de un bucle de lectura de código con cuatro preguntas por unos $0.011, un tercio del coste de Opus 5.5. En max hizo tres veces más llamadas a herramientas y costó más que Opus 5.5. Cada modelo dispone de tres herramientas, listar archivos, leer un archivo y buscar, sobre una base de código sintética y pequeña. Cada respuesta requiere entre 3 y 6 consultas repartidas entre varios archivos.
| Bucle de herramientas, 12 ejecuciones por ajuste | Resueltas | Mediana de turnos | Llamadas a herramientas por ejecución | Coste por ejecución | Mediana de tiempo total |
|---|---|---|---|---|---|
| Sonnet 5.5, configuración predeterminada | 12 / 12 | 3 | 4.8 | $0.0112 | 6.7 s |
Sonnet 5.5, low | 12 / 12 | 3 | 4.9 | $0.0112 | 7.4 s |
Sonnet 5.5, medium | 12 / 12 | 3 | 5.1 | $0.0113 | 6.8 s |
Sonnet 5.5, max | 12 / 12 | 4 | 14.7 | $0.0422 | 20.1 s |
| Opus 5.5, configuración predeterminada | 12 / 12 | 4 | 5.3 | $0.0332 | 25.3 s |
| Sonnet 5, configuración predeterminada | 11 / 12 | 3.5 | 4.2 | $0.0122 | 15.8 s |
Los testimonios de clientes publicados por VentureBeat indican que Sonnet 5.5 hace menos llamadas a herramientas que Sonnet 5, un tercio menos en Lovable. Este bucle es demasiado corto para reflejarlo: Sonnet 5.5 hizo 4.8 llamadas por ejecución frente a 4.2 de Sonnet 5, aunque costó un 8% menos y terminó en menos de la mitad de tiempo.
¿Sonnet 5.5 es más rápido?
Terminó antes principalmente porque generó menos texto. Con la configuración predeterminada, la mediana del tiempo total, desde que se envía la petición hasta que se recibe la respuesta completa, fue de 3.9 segundos por tarea de un solo turno para Sonnet 5.5, 8.1 segundos para Sonnet 5 y 5.5 segundos para Opus 5.5. Los dos modelos Sonnet generaron casi los mismos tokens de salida por segundo de tiempo total, 88 frente a 91. La espera se redujo a la mitad porque Sonnet 5.5 generó una quinta parte de los tokens, no porque los produjera más rápido. En las tareas difíciles, la diferencia es de 5.8 segundos frente a 21.0.
¿Sirven los presupuestos de tokens de Sonnet 5?
Los presupuestos de contexto y los límites de max_tokens definidos para Sonnet 5 deberían seguir sirviendo. Según la guía de migración de Anthropic, Sonnet 5.5 usa el mismo tokenizer, y los cuatro textos fijos que probamos (prosa en inglés, código Python, argumentos de herramientas en JSON, prosa en chino) dieron el mismo número de tokens en ambos modelos y en Opus 5.5, por ejemplo 1,270 tokens para el inglés y 493 para el chino; Sonnet 5.5 y Opus 5.5 añaden 2 tokens fijos por solicitud. Las solicitudes con herramientas salen algo más baratas en la entrada: la página de precios de Anthropic indica que el prompt de sistema oculto para el uso de herramientas ocupa 286 tokens en Sonnet 5.5 frente a 354 en Sonnet 5.
¿Cuál deberías usar?
Conviene migrar la mayoría de las cargas de Sonnet 5. Solo queda elegir el nivel de esfuerzo.
| Carga de trabajo | Riesgo | Recomendación | Cifras |
|---|---|---|---|
| Salida procesada por código: extracción, clasificación, valores únicos | Cálculos incluidos en la respuesta por debajo de xhigh | Sonnet 5.5 en xhigh, o medium analizando la última línea | solo resultado en 39 / 39 con xhigh y 24 / 39 con medium; xhigh cuesta cerca de un 40% más |
| Chat y texto para usuarios | Latencia y coste | Sonnet 5.5 en medium | $0.0040 por tarea, mediana de 3.9 s |
| Bucles de agentes con herramientas | max multiplica las llamadas a herramientas | Sonnet 5.5 con la configuración predeterminada o medium; pasa a Opus 5.5 antes de usar Sonnet 5.5 en max | $0.011 por ejecución con la configuración predeterminada, $0.042 con max y $0.033 en Opus 5.5 |
| Código para Sonnet 5 que desactiva thinking o fuerza una herramienta | HTTP 400 después de cambiar el modelo | between_tools (con high o inferior) y tool_choice: auto | Guía de migración de Anthropic |
Uses el nivel de esfuerzo que uses, añade dos comprobaciones al código: que la respuesta tenga el formato esperado por el parser y que exista un límite de tokens de salida por petición. En prompts individuales, max multiplicó el coste por tarea por 3.5x, y en el bucle triplicó las llamadas a herramientas.
FAQ
¿Sonnet 5.5 cuesta menos que Opus 5.5?
Con sus configuraciones predeterminadas, Sonnet 5.5 costó un 41% menos que Opus 5.5 por tarea de un solo turno y un tercio por ejecución del bucle de herramientas. En max se invierte el orden: Sonnet 5.5 costó el doble que Opus 5.5 con su configuración predeterminada en las tareas de un solo turno y un 27% más por ejecución del bucle.
¿Qué nivel de esfuerzo debería usar con Sonnet 5.5?
Sonnet 5.5 costó casi lo mismo con low, medium y high en nuestras tareas, entre $0.0040 y $0.0043, así que medium es un punto de partida seguro para chat y bucles de herramientas. Usa xhigh cuando el código espere un valor sin texto adicional. max costó 3.5x más que la configuración predeterminada.
¿Puedo seguir desactivando thinking en Sonnet 5.5?
Sonnet 5.5 rechaza thinking: {"type": "disabled"} con HTTP 400. Envía thinking: {"type": "between_tools"}, que se admite con esfuerzo low, medium o high.
Mediciones relacionadas: Claude Opus 5.5 frente a Opus 5, el tokenizer de Claude Sonnet 5 y los controles de thinking de distintos proveedores.
Medido el 2026-09-29, un día después del lanzamiento, mediante un gateway conectado a la Anthropic Messages API. Fueron 702 llamadas evaluadas de un solo turno, con 13 tareas cuyas respuestas se verificaron por fuerza bruta, 3 repeticiones, 6 niveles de esfuerzo y 3 modelos; 48 llamadas para probar una instrucción de sistema sobre el formato de salida; 72 ejecuciones del bucle de herramientas, con 4 preguntas que exigían varias consultas, 3 repeticiones y 6 ajustes; y recuentos de tokens para cuatro textos fijos por modelo. Los prompts incluían valores aleatorios únicos y los costes se calcularon con los precios de lista de Anthropic.