
Claude Opus 5.5 vs Opus 5: mismas respuestas, mitad de tokens
Contenido
- ¿Qué cambió realmente en Claude Opus 5.5?
- ¿Qué dicen los benchmarks del lanzamiento?
- ¿Se mantiene el ahorro en tareas de una sola llamada?
- ¿Qué ocurre en un loop de herramientas, donde se acumula el coste de los agentes?
- ¿Cuánto ahorro procede únicamente de la bajada de precio?
- ¿Compensa alguna vez usar un nivel de esfuerzo mayor?
- ¿Qué deja de funcionar al cambiar el ID del modelo?
- ¿Se mantienen los presupuestos de los prompts?
- ¿Cuándo conviene cambiar?
- FAQ
La tarifa de Claude Opus 5.5 es un 20% inferior a la de Claude Opus 5: $4 por millón de tokens de entrada y $20 por millón de tokens de salida, frente a $5 y $25. Ese 20% se aplica independientemente de lo que haga el modelo. La cuestión es cuánto ahorro queda después de descontarlo. En 13 tareas de una sola llamada con la configuración predeterminada de cada modelo, Opus 5.5 costó un 65% menos. Con las mismas tarifas, todavía resulta un 56% más barato. En un loop de herramientas con varios pasos, la diferencia se reduce: un 37% menos en la factura y un 22% con precios iguales.
TL;DR
- En 468 llamadas evaluadas, Opus 5.5 costó $0.0072 por tarea frente a $0.0204 para Opus 5. Ambos resolvieron correctamente todas las tareas.
- Con las mismas tarifas, Opus 5.5 siguió siendo un 56% más barato en esas tareas: generó una media de 341 tokens de salida, frente a 799.
- En un loop de herramientas con cuatro preguntas, la diferencia con precios iguales baja al 22%, porque predominan los tokens de entrada y ambos modelos leen los mismos archivos.
- Con esfuerzo
max, Opus 5.5 costó 3.3x más que con su configuración predeterminada en ese loop y no resolvió nada adicional. tool_choicecon el valoranyo una herramienta concreta ahora devuelve HTTP 400. Opus 5 admite ambas opciones.
Anthropic lanzó Opus 5.5 el 2026-09-22 y afirmó que, en cargas de trabajo habituales, “cuesta un 40% menos de ejecutar que Opus 5”. Solo la segunda parte de esa afirmación, usar menos tokens por tarea, depende del comportamiento del modelo. Eso es lo que merece la pena medir.
¿Qué cambió realmente en Claude Opus 5.5?
La bajada de precio es el cambio menor. El más importante es que ya no se puede desactivar thinking. Con adaptive thinking, el modelo decide cuánto razonar antes de responder. Esos tokens de razonamiento se facturan como salida, aunque la API no los muestre. En Opus 5.5 este modo está siempre activo. El único control disponible es effort, un parámetro de la petición con cinco niveles, desde low hasta max, que limita cuánto razonamiento puede emplear el modelo.
Opus 5 aceptaba thinking: {"type": "disabled"}. En nuestras mediciones de Opus 5, esa era la única configuración que igualaba su coste al de Opus 4.8. Esa opción ya no existe.
| Opus 5 | Opus 5.5 | |
|---|---|---|
| Precio de tarifa (entrada / salida por MTok) | $5 / $25 | $4 / $20 |
| Thinking | adaptativo, puede desactivarse con esfuerzo high o inferior | adaptativo, siempre activo |
| Esfuerzo predeterminado | high | medium |
| Uso forzado de herramientas | aceptado | error 400 (medido) |
| Ventana de contexto / salida máxima | 1M / 128K | 1M / 128K |
| Fecha límite de conocimiento | mayo de 2026 | junio de 2026 |
| Lanzamiento | 2026-07-24 | 2026-09-22 |
| Texto entre llamadas a herramientas | bloques text | bloques thinking, vacíos con la configuración de visualización predeterminada |
| Categorías de protección | ciberseguridad | ciberseguridad y biología, más un rechazo a extraer el razonamiento |
Hay dos filas que requieren más contexto. El esfuerzo predeterminado bajó de high a medium. Por tanto, una petición sin el campo de esfuerzo no usa la misma profundidad que en Opus 5. El cambio en las actualizaciones de progreso tampoco genera ningún aviso: las notas breves que antes escribía el modelo entre llamadas a herramientas ahora llegan como bloques de thinking. Su texto está vacío salvo que se solicite expresamente. Una interfaz que muestre esas notas por streaming dejará de hacerlo sin recibir ningún error que pueda detectar.
¿Qué dicen los benchmarks del lanzamiento?
En la tabla publicada por Anthropic, Opus 5.5 supera a Fable 5.1 en todos los benchmarks de programación y trabajo del conocimiento. También supera a GPT-6 Astra en la mayoría. Los siguientes resultados proceden de Anthropic y se obtuvieron con adaptive thinking, esfuerzo máximo y xhigh en las filas de Terminal-Bench.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 (programación con agentes) | 66.4% | 55.8% | 52.3% | 57.9% |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | no publicado |
| GDPval-AA v2.1 (trabajo del conocimiento, Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench (flujos de trabajo empresariales) | 40.0% | 31.4% | 26.9% | 41.4% |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% |
| OSWorld 2.0 (uso de ordenadores) | 81.8% | 80.7% | 74.0% | no publicado |
Anthropic incluye una salvedad poco habitual en su propia tabla: a este nivel, “los márgenes de los benchmarks son una referencia menos fiable de las diferencias en casos reales”. En la práctica, la distancia respecto a Fable 5.1 es menor de lo que sugieren las puntuaciones. Antes de citar estos números hay que tener en cuenta dos notas. Zapier ejecutó AutomationBench sin modelos de respaldo, así que cada intervención de las protecciones se contabilizó como un fallo. Además, toda la tabla se ejecutó con las protecciones de producción activadas. Cuando intervenía un clasificador, las tareas de ciberseguridad se enviaban a Opus 4.8 y las de biología a Opus 5.
Nada de esto indica cuánto cuesta una tarea, así que lo medimos.
¿Se mantiene el ahorro en tareas de una sola llamada?
Sí, y la mayor parte procede de una eficiencia real, no de la tarifa. Una tarea de una sola llamada consta de una petición y una respuesta, sin herramientas. Usamos problemas de aritmética y conteo, como una regla iterativa de 200 pasos o el cálculo de rutas en una cuadrícula con celdas bloqueadas. Ejecutamos 13 tareas, con 3 repeticiones cada una, en los cinco niveles de esfuerzo y con la configuración predeterminada, tanto en Opus 5.5 como en Opus 5. En total fueron 468 llamadas evaluadas. Antes de la ejecución calculamos por fuerza bruta en Python todas las respuestas correctas. También añadimos una cadena aleatoria única a cada prompt para impedir que cualquier capa intermedia respondiera a partir de un duplicado en caché. El coste por tarea se calcula aplicando las tarifas de Anthropic a los tokens facturados por cada llamada, incluido thinking, en lugar de tomarlo de la respuesta.
| Esfuerzo | Mediana de salida de Opus 5.5 | Opus 5.5 $/tarea | Mediana de salida de Opus 5 | Opus 5 $/tarea |
|---|---|---|---|---|
| predeterminado | 193 | 0.0072 | 448 | 0.0204 |
| low | 185 | 0.0060 | 439 | 0.0201 |
| medium | 218 | 0.0085 | 538 | 0.0200 |
| high | 223 | 0.0094 | 542 | 0.0206 |
| xhigh | 233 | 0.0111 | 525 | 0.0197 |
| max | 762 | 0.0240 | 532 | 0.0220 |
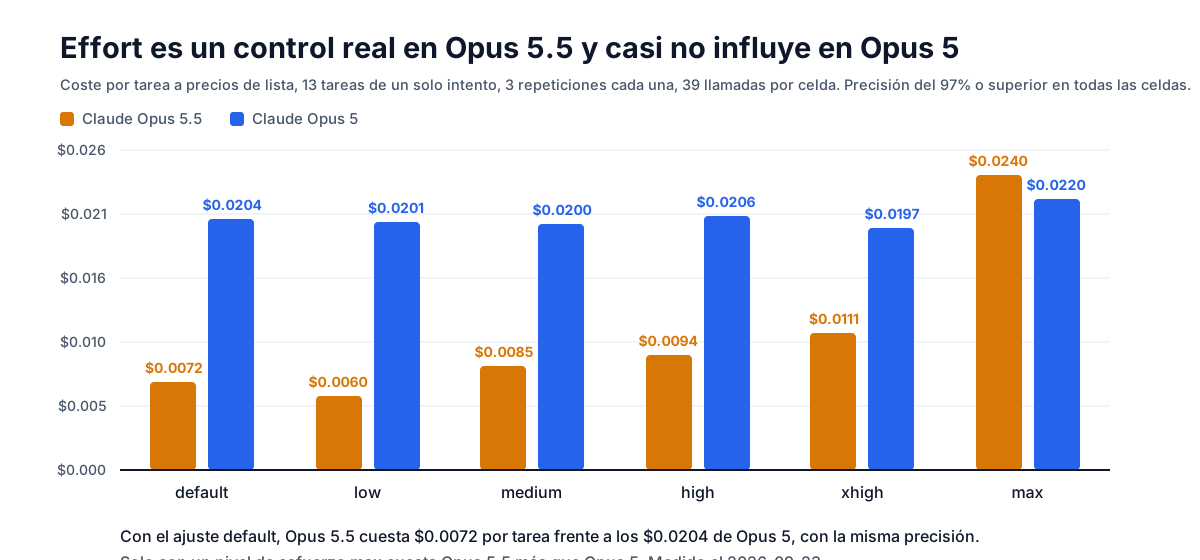
La precisión fue del 100% para ambos modelos con la configuración predeterminada y de al menos el 97% en todos los demás niveles. Los tres fallos aparecieron en tareas y niveles distintos, no concentrados en el extremo inferior de la escala. En este conjunto de tareas no hay una caída brusca de precisión. Toda la diferencia está en el coste.
La escala se comporta de forma distinta en cada modelo. El coste de Opus 5 se mantiene estable entre $0.0197 y $0.0220 desde low hasta max, una variación del 12%. En Opus 5.5 abarca un rango de 4x, desde $0.0060 hasta $0.0240. En Opus 5.5, el esfuerzo sí cambia el comportamiento. En Opus 5 apenas tiene efecto. Una migración que copie la configuración sin ajustarla puede acabar en un punto muy distinto del original.
La diferencia aumenta en las cinco tareas más difíciles. Con la configuración predeterminada, Opus 5.5 costó $0.0113 por tarea, frente a $0.0375 para Opus 5. La mediana de tokens de salida fue de 585 frente a 1,145.
¿Qué ocurre en un loop de herramientas, donde se acumula el coste de los agentes?
El ahorro se mantiene en un loop, aunque la diferencia se reduce. Un loop de herramientas es la prueba más representativa para comparar Opus 5.5 con Opus 5. Cada turno corresponde a una petición: el modelo solicita una herramienta, el código la ejecuta y se vuelve a enviar la transcripción completa. Una conversación de cinco turnos paga cinco veces por una transcripción cada vez mayor. La factura depende del número de turnos, no del precio por token. Dimos a ambos modelos tres herramientas para listar archivos, leer archivos y buscar en un pequeño servicio sintético. También planteamos cuatro preguntas cuyas respuestas exigían seguir una cadena de llamadas a través de tres o cuatro archivos. Después ejecutamos 12 pruebas por variante con la misma interfaz, herramientas y prompt.
| Variante | Resueltas | Mediana de turnos | Mediana de llamadas a herramientas | Mediana de tokens de salida | $/ejecución |
|---|---|---|---|---|---|
| Opus 5.5, predeterminado | 12/12 | 4 | 5 | 427 | 0.0326 |
Opus 5.5, low | 12/12 | 4.5 | 5 | 430 | 0.0330 |
Opus 5.5, max | 12/12 | 5 | 12 | 3,124 | 0.1087 |
| Opus 5, predeterminado | 11/12 | 5 | 7 | 666 | 0.0519 |
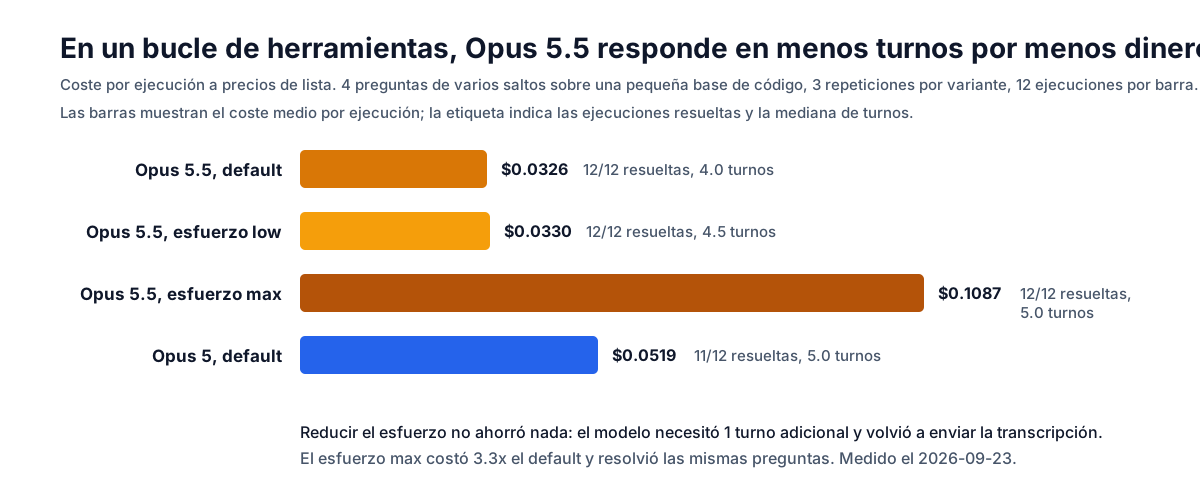
Con la configuración predeterminada, Opus 5.5 costó un 37% menos por ejecución que Opus 5. Usó un 12% menos de turnos y un 30% menos de tokens de salida. La diferencia por pregunta resuelta es mayor, un 43%, porque Opus 5 falló en una ejecución. El resultado se aproxima al “40% menos de coste” anunciado por el proveedor y es la cifra que aparecerá en la factura.
En esta carga de trabajo, la mayor parte del ahorro procede de la tarifa. El motivo es sencillo: el loop vuelve a enviar la transcripción en cada turno, ambos modelos leen los mismos archivos y el total de tokens solo bajó un 19%, aunque los tokens de salida disminuyeron un 30%. Generar menos texto ayuda menos justo en el tipo de carga que más consume. La siguiente sección cuantifica esta diferencia.
Bajar Opus 5.5 a low no produjo ningún ahorro en el loop. De media, el modelo pidió un turno adicional, y el coste de volver a enviar la transcripción consumió el ahorro en tokens. El ajuste de esfuerzo que funciona bien en tareas de una sola llamada deja de ahorrar en un loop, porque la factura depende de los turnos, no de la profundidad.
¿Cuánto ahorro procede únicamente de la bajada de precio?
Entre una séptima parte y dos quintas partes, según el tipo de trabajo. La columna central vuelve a calcular el coste de los tokens medidos de Opus 5.5 aplicando las tarifas de Opus 5. Así muestra cuánto ahorra Opus 5.5 al generar menos texto, manteniendo las mismas tarifas que Opus 5.
| Carga de trabajo | Diferencia facturada | Con precios iguales | Tokens de salida |
|---|---|---|---|
| 13 tareas de una sola llamada, predeterminado | -65% | -56% | -57% |
| las cinco más difíciles | -70% | -62% | -63% |
| loop de herramientas con varios pasos, predeterminado | -37% | -22% | -30% |
Las filas de una sola llamada muestran una mejora real de eficiencia: la bajada de precio solo aporta el 14% del ahorro, y el resto se debe a que el modelo genera menos texto. La fila del loop de herramientas es la referencia más útil para planificar, porque coincide con la forma habitual del tráfico de agentes. En ese caso, la bajada de precio aporta el 41% del ahorro anunciado.
¿Compensa alguna vez usar un nivel de esfuerzo mayor?
No en esta carga de trabajo, y la penalización es considerable. En el loop de herramientas, Opus 5.5 con max costó $0.1087 por ejecución, 3.3x más que con su configuración predeterminada, y resolvió exactamente las mismas 12 preguntas. El presupuesto adicional se consumió en llamadas a herramientas: una mediana de 12 frente a 5 con la configuración predeterminada, además de 3,124 tokens de salida frente a 427. En las tareas de una sola llamada, max fue el único nivel en el que costó más que Opus 5: $0.0240 frente a $0.0220.
Ese presupuesto se destina al razonamiento. Thinking representó el 98.4% de los tokens de salida de Opus 5.5 con la configuración predeterminada y el 99.6% con max en estas tareas de respuesta única. Todos esos tokens se facturan a la tarifa de salida, aunque no se muestren con la configuración de visualización predeterminada. La propia documentación de Anthropic recomienda reservar max para problemas de frontera. Los datos lo concretan: si el modelo ya resuelve una tarea, cada nivel adicional solo aumenta el coste.
¿Qué deja de funcionar al cambiar el ID del modelo?
Dos formatos de petición que funcionan en Opus 5 devuelven un error 400 en Opus 5.5. Ambos son habituales en código existente.
El uso forzado de herramientas se rechaza. Cualquier cliente que fuerce una llamada a una herramienta, una técnica habitual para obtener JSON estructurado de un modelo de chat, recibe este error:
tool_choice: type "tool" and "any" are not supported for this model.El mismo error aparece a través de un cliente compatible con OpenAI, donde la petición se expresa como tool_choice: "required" o mediante una función concreta. auto y none siguen funcionando. Para migrar, hay que indicar en el prompt cuándo debe usarse la herramienta y emplear esquemas de herramientas estrictos o salidas estructuradas cuando se necesite JSON válido según un esquema.
Thinking no se puede desactivar. Tanto thinking: {"type": "disabled"} como un valor manual de budget_tokens fallan. En una interfaz compatible con OpenAI también se rechaza el equivalente, reasoning_effort: "none". El parámetro de esfuerzo los sustituye:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "Summarize this incident report in five bullets."}],
    output_config={"effort": "low"},   # low | medium | high | xhigh | max; medium is the default
)

# Thinking is billed as output whether or not you can read it.
print(response.usage.input_tokens, response.usage.output_tokens)
low es la opción más parecida al antiguo modo sin thinking. En nuestro conjunto de tareas de una sola llamada fue el nivel más barato y mantuvo la precisión. Thinking sigue activo y se factura como salida, por lo que no tiene coste cero.
¿Se mantienen los presupuestos de los prompts?
Los presupuestos de tokens se mantienen exactamente. Los mismos cuatro inputs produjeron los mismos recuentos en ambos modelos: 1,277 tokens frente a 1,275 para un texto en inglés, 583 frente a 581 para Python, 482 frente a 480 para un bloque JSON con argumentos de herramienta y 500 frente a 498 para texto en chino. La diferencia constante de dos tokens procede del framing de la petición, no del texto. No hace falta recalibrar en Opus 5.5 un presupuesto de contexto o un umbral de fragmentación ajustado para Opus 5.
¿Cuándo conviene cambiar?
Por coste, conviene migrar a Opus 5.5 en cuanto se corrijan los dos formatos de petición anteriores. Incluso sin contar la bajada de precio, obtener la misma precisión con un coste un 56% menor en tareas de una sola llamada y un 22% menor en un loop de herramientas no es una diferencia marginal. Además, la comparación entre configuraciones predeterminadas es la que experimentará la mayoría de los despliegues.
El nivel de esfuerzo debe volver a ajustarse, no copiarse sin más. La configuración predeterminada bajó de high a medium, el rango del ajuste es cuatro veces mayor que en Opus 5 y el nivel óptimo depende del tipo de carga. low fue la opción más barata y precisa en tareas de una sola llamada. En el loop de herramientas, la configuración predeterminada superó tanto a low como a max.
FAQ
¿Claude Opus 5.5 es realmente un 40% más barato que Opus 5? En la factura, se aproxima: Opus 5.5 costó un 37% menos por ejecución que Opus 5 en nuestro loop de herramientas y un 65% menos por tarea de una sola llamada. Veinte puntos porcentuales proceden de la tarifa más baja y se aplican independientemente del comportamiento del modelo. Al descontarlos, la mejora de eficiencia es del 22% en el loop y del 56% en tareas de una sola llamada.
¿Puedo seguir desactivando thinking en Opus 5.5?
No. thinking: {"type": "disabled"} y los presupuestos manuales de tokens devuelven un error 400 en Opus 5.5. Hay que usar output_config.effort, donde low es la configuración más barata. Los tokens de thinking se facturan como salida en todos los niveles.
¿Qué sustituye al uso forzado de herramientas?
Mantén tool_choice: {"type": "auto"}, indica explícitamente en el prompt cuándo debe activarse la herramienta y usa esquemas de herramientas estrictos o salidas estructuradas si necesitas JSON válido según un esquema. En Opus 5.5, las opciones any y de herramienta concreta se rechazan con un error 400 en lugar de degradarse de forma silenciosa. El resultado es una petición fallida, no una respuesta incorrecta.
¿Tengo que volver a medir el tamaño de mis prompts? No. El mismo texto produjo los mismos recuentos de tokens en Opus 5 y Opus 5.5 para prosa, código, JSON y chino. Los presupuestos de contexto se mantienen sin cambios.
¿Opus 5.5 sustituye a Fable 5.1? En la tabla de benchmarks de Anthropic, Opus 5.5 supera a Fable 5.1 en todos los benchmarks publicados, con un precio por token equivalente al 40% del de Fable 5.1. Anthropic sigue posicionando Fable 5.1 para razonamientos exigentes y trabajo con agentes de horizonte largo. También afirma que la diferencia real es menor de lo que sugieren las puntuaciones. La respuesta fiable es volver a ejecutar tus propias evaluaciones, no limitarse a leer la tabla.
Mediciones relacionadas: Claude Opus 5 vs Opus 4.8, la escala de esfuerzo de GPT-6 Astra y los controles de thinking de distintos proveedores.
Medido el 2026-09-23, un día después del lanzamiento, mediante un gateway a la API de Claude y una interfaz compatible con OpenAI. Se evaluaron 468 llamadas de una sola petición (13 tareas con respuestas correctas calculadas localmente por fuerza bruta, 3 repeticiones, 6 configuraciones de esfuerzo y 2 modelos), además de 48 ejecuciones de loops de herramientas (4 preguntas con varios pasos, 3 repeticiones y 4 variantes). Se añadió una cadena aleatoria a los prompts; cada modelo se ejecutó a través de la interfaz que admitía su parámetro de esfuerzo; los costes se calcularon con las tarifas de Anthropic, no a partir de las respuestas.