
Coste de GLM 5.3: siempre razona, 2.5x menos que 5.2
Contenido
- ¿Qué es GLM 5.3 y cuánto cuesta?
- ¿Se puede seguir desactivando el razonamiento?
- ¿Qué nivel de esfuerzo acierta las respuestas?
- ¿Inventa respuestas cuando una pregunta no tiene solución?
- ¿Respeta GLM 5.3 un esquema JSON?
- ¿Cuánto cuesta una imagen en GLM 5.3 Flash?
- ¿Qué más ha cambiado desde GLM 5.2?
- Cómo lo gestiona Synthorai
- Preguntas frecuentes
GLM 5.3 cuesta lo mismo que GLM 5.2: $1.40 por millón de tokens de entrada y $4.40 por millón de salida. Ya no permite desactivar el razonamiento. Cualquier intento devuelve un error 400 y el nivel de esfuerzo predeterminado es max. Ejecutamos tres veces cada una de las 11 tareas con respuesta verificable. max fue el único ajuste que acertó las 33, con un coste de $0.00468 por respuesta correcta. Es 2.5x menos que GLM 5.2 con max, porque GLM 5.3 usa aproximadamente la mitad de razonamiento. low cuesta un 63% menos por respuesta correcta, pero falla 5 de 33. GLM 5.3 Flash acertó 31 de 33 por una décima parte del precio. reasoning_effort, el parámetro que determina cuánto razona el modelo antes de responder, ahora afecta tanto a la precisión como al coste. Medimos ambas versiones frente a GLM 5.2 y DeepSeek V4.1 Flash en una misma tanda.
TL;DR
- GLM 5.3 y GLM 5.3 Flash rechazan
thinking: disabled,reasoning_effort: noneymediumcon el error 1210. Solo funcionanlow,highymax, que es el valor predeterminado. - Con
max, GLM 5.3 acertó 33 de 33 a $0.00468 por respuesta correcta. GLM 5.2 conmaxcostó $0.01173. - Con
low, GLM 5.3 acertó 28 de 33 y GLM 5.3 Flash, 24 de 33. - Ambas versiones de GLM 5.3 ignoran un
json_schemaestricto.json_objectdevolvió los valores correctos en 8 de 8 ejecuciones.
¿Qué es GLM 5.3 y cuánto cuesta?
Es una versión reentrenada de GLM 5.2 al mismo precio, acompañada de un modelo más pequeño que cuesta una décima parte. Según la guía de Z.ai, GLM 5.3 “usa el mismo modelo base que GLM-5.2 y todas las mejoras proceden del post-training”. Solo admite texto. GLM 5.3 Flash tiene “320B parámetros totales, con 18B activados”. Solo 18B trabajan con cada token, de ahí su bajo coste. Admite imágenes, vídeo y archivos. Ambos ofrecen un contexto de 1M tokens y una salida de 128K. Estos son los precios por millón de tokens publicados en la página de precios de Z.ai:
| Modelo | Entrada | Entrada en caché | Salida |
|---|---|---|---|
| GLM 5.3 | $1.40 | $0.26 | $4.40 |
| GLM 5.3 Flash | $0.15 | $0.03 | $0.50 |
| GLM 5.2 | $1.40 | $0.26 | $4.40 |
| DeepSeek V4.1 Flash | $0.30 en hora punta | $0.006 en hora punta | $1.20 en hora punta |
La ficha del modelo y la guía de Flash de Z.ai sitúan las mejoras en tareas de agentes y programación:
| Benchmark | Qué evalúa | GLM 5.2 | GLM 5.3 | GLM 5.3 Flash |
|---|---|---|---|---|
| Terminal Bench 3.0 | tareas de agentes en un terminal | 4.6 | 28.3 | sin datos |
| DeepSWE v1.1 | corrección de repositorios reales | 46.2 | 66.9 | 63.4 |
| AutomationBench | automatización de flujos de trabajo | 26.2 | 48.2 | 48.8 |
| CyberGym | tareas sobre vulnerabilidades de seguridad | 77.2 | 84.5 | sin datos |
| HLE with tools | preguntas difíciles con herramientas permitidas | 54.7 | 62.5 | sin datos |
A continuación presentamos lo que pudimos comprobar directamente: tareas con una única respuesta verificable, no benchmarks de agentes.
¿Se puede seguir desactivando el razonamiento?
No. GLM 5.2 aceptaba thinking: {"type": "disabled"}. GLM 5.3 y GLM 5.3 Flash devuelven HTTP 400 con el código de error 1210 (“este modelo siempre razona; no se puede desactivar el razonamiento; usa low, high o max”) al enviar thinking: disabled, enable_thinking: false o reasoning_effort con los valores none, minimal, medium o xhigh. Si omites reasoning_effort, se aplica max. thinking_budget, un límite de tokens de razonamiento que algunos proveedores respetan, se acepta pero se ignora en GLM 5.3. Todos los valores entre 0 y 1,024 generaron unos 101 tokens de razonamiento para la misma pregunta.
resp = client.chat.completions.create(
    model="glm-5.3",
    messages=[{"role": "user", "content": prompt}],
    reasoning_effort="high",   # "low" | "high" | "max"; omitted means "max"
    max_tokens=8192,           # GLM 5.3 Flash rejects anything above 131,072
)
reasoning_tokens = resp.usage.completion_tokens_details.reasoning_tokens  # billed as output
thinking_text = resp.choices[0].message.reasoning_content                # the thinking itself, as text
La opción barata anterior tampoco daba buenos resultados. Con el razonamiento desactivado, GLM 5.2 respondió correctamente a 10 de nuestras 33 tareas y DeepSeek V4.1 Flash, a 22.
¿Qué nivel de esfuerzo acierta las respuestas?
En GLM 5.3, solo max. En GLM 5.3 Flash, ninguno. Ejecutamos tres veces 11 tareas cuya respuesta es un único número verificable: sumas de números primos, recuentos de dígitos, caminos en una cuadrícula, combinaciones de monedas, una regla aplicada 40 veces, el resto de dividir 7 elevado a 222 entre 1000, una conversión de base, un problema de mochila y el recuento de números de cuatro cifras sujetos a tres restricciones. Los tokens de razonamiento corresponden al razonamiento oculto generado antes de la respuesta y se facturan como salida. El coste por respuesta correcta es el gasto total dividido entre el número de aciertos, según el precio de lista:
| Modelo | Esfuerzo | Aciertos | Tokens de razonamiento, mediana (máximo) | Coste por respuesta correcta |
|---|---|---|---|---|
| GLM 5.3 | low | 28/33 | 143 (1,826) | $0.00173 |
| GLM 5.3 | high | 29/33 | 226 (1,950) | $0.00197 |
| GLM 5.3 | max (predeterminado) | 33/33 | 538 (7,733) | $0.00468 |
| GLM 5.3 Flash | low | 24/33 | 120 (467) | $0.00012 |
| GLM 5.3 Flash | high | 29/33 | 196 (1,582) | $0.00021 |
| GLM 5.3 Flash | max (predeterminado) | 31/33 | 419 (5,024) | $0.00040 |
| GLM 5.2 | max | 33/33 | 1,129 (21,917) | $0.01173 |
| DeepSeek V4.1 Flash | low | 33/33 | 337 (6,797) | $0.00102 |
| DeepSeek V4.1 Flash | max | 33/33 | 386 (10,769) | $0.00138 |
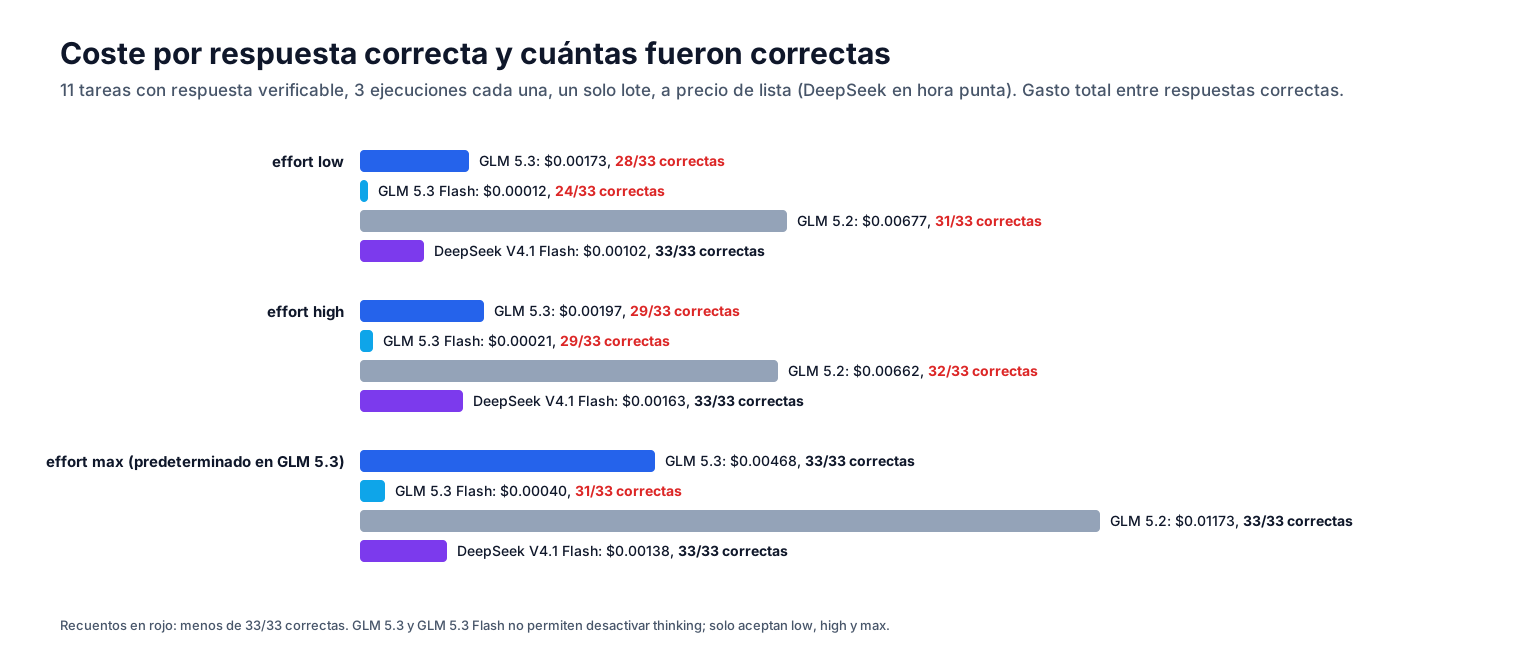
La diferencia de 2.5x respecto a GLM 5.2 se debe al volumen de razonamiento: una mediana de 538 tokens frente a 1,129 y una ejecución máxima de 7,733 frente a 21,917. Los niveles inferiores ahorran dinero porque omiten comprobaciones. Con low, GLM 5.3 respondió dos veces que el número de caminos en la cuadrícula era 216, aunque una celda bloqueada lo reduce a 132. También falló una vez las combinaciones de monedas, el problema de mochila y la conversión de base. GLM 5.3 Flash con low falló siempre la regla de 40 pasos y el recuento sujeto a restricciones. DeepSeek V4.1 Flash, en cambio, acertó 33 de 33 con todos los ajustes.
En GLM 5.3, mantén el valor predeterminado para cualquier tarea con operaciones aritméticas o varios pasos. Usa low solo cuando sea barato detectar una respuesta incorrecta. Con max, GLM 5.3 cuesta 3.4x más por respuesta correcta que DeepSeek V4.1 Flash. GLM 5.3 Flash cuesta menos de un tercio, pero falla 2 de 33.
¿Inventa respuestas cuando una pregunta no tiene solución?
No, ni siquiera con el razonamiento siempre activado. Hicimos cinco preguntas sobre entidades inventadas, por lo que la única respuesta correcta era “no lo sé”: la cotización de Verantis Dynamics, el punto de fusión de Oridium-7 y el ganador del 1987 Pan-Continental Robotics Prize. Usamos el nivel de esfuerzo predeterminado y un límite de 16,384 tokens:
| Modelo | Rechazó responder | Inventó una respuesta | Alcanzó el límite sin responder | Tokens de razonamiento | Coste por pregunta |
|---|---|---|---|---|---|
| GLM 5.3 | 5/5 | 0/5 | 0/5 | 230 a 542 | $0.0022 |
| GLM 5.3 Flash | 5/5 | 0/5 | 0/5 | 238 a 625 | $0.0003 |
| GLM 5.2 | 5/5 | 0/5 | 0/5 | 134 a 1,559 | $0.0035 |
| DeepSeek V4.1 Flash | 1/5 | 3/5 | 1/5 | 7,021 a 16,384 | $0.0139 |
Ambas versiones de GLM 5.3 indicaron que no disponían de información tras unos cientos de tokens de razonamiento. DeepSeek V4.1 Flash razonó durante 7,000 a 16,000 tokens y después solía inventar algo (Andrew Martin, the robot protagonist of Isaac Asimov's The Bicentennial Man, won). En nuestro estudio anterior, publicado un día antes, más ejecuciones alcanzaron el límite, pero el modelo rara vez se negó a responder. Esta fue la mayor diferencia que medimos entre los dos modelos de gama Flash para consultas que pueden no devolver ningún resultado.
¿Respeta GLM 5.3 un esquema JSON?
No si es estricto. Usa json_object. Al configurar response_format con un json_schema estricto para extraer datos de una factura, GLM 5.3 y GLM 5.3 Flash devolvieron HTTP 200 e ignoraron el esquema en 16 de 16 ejecuciones. El JSON aparecía dentro de un bloque de código Markdown e incluía claves no solicitadas por el esquema (invoice_date, reference), por lo que ninguna respuesta se pudo interpretar como el objeto pedido. La referencia de la API de Z.ai solo enumera text y json_object. El problema es que el esquema se acepta sin avisar.
Con {"type": "json_object"} y los campos indicados en el prompt, ambas versiones devolvieron todos los valores correctos en 8 de 8 ejecuciones. GLM 5.2 y DeepSeek V4.1 Flash obtuvieron el mismo resultado. Como el razonamiento sigue activo, la extracción consume una mediana de 240 tokens de salida en GLM 5.3 y 140 en Flash, frente a 25 en V4.1 Flash con el razonamiento desactivado. Valida tú mismo el resultado contra tu esquema.
¿Cuánto cuesta una imagen en GLM 5.3 Flash?
El consumo aumenta con el área en píxeles y no se limita a 2048x2048. Por eso, las imágenes grandes cuestan más que en DeepSeek V4.1 Flash a pesar de la tarifa inferior. Enviamos archivos PNG generados a GLM 5.3 Flash (GLM 5.3 solo admite texto) y restamos el coste del prompt sin imagen:
| Imagen | Tokens de GLM 5.3 Flash | Coste a $0.15/M | Tokens de DeepSeek V4.1 Flash | Coste a $0.30/M |
|---|---|---|---|---|
| 512x512 | 363 | $0.000054 | 184 | $0.000055 |
| 1024x1024 | 1,371 | $0.000206 | 652 | $0.000196 |
| 2048x2048 | 5,478 | $0.000822 | 994 | $0.000298 |
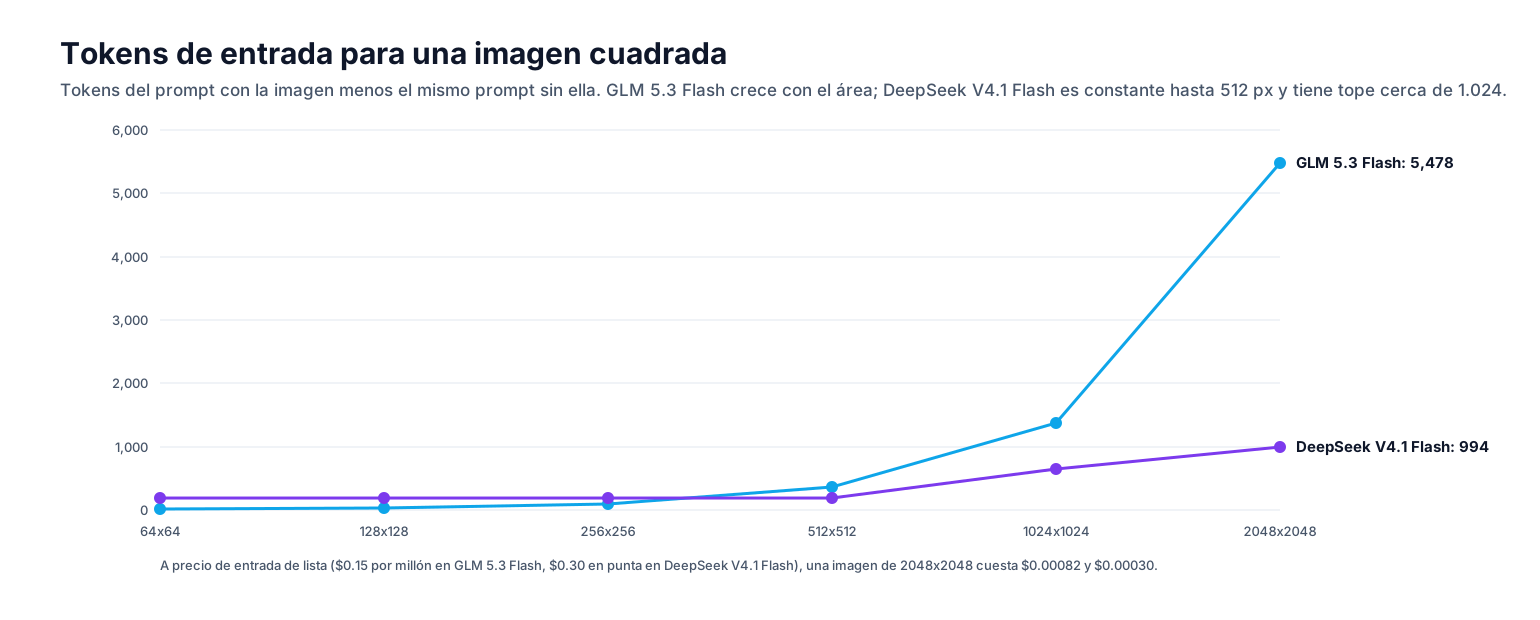
Por encima de 512 píxeles, GLM 5.3 Flash consume aproximadamente un token por cada 766 píxeles. detail, el contenido de la imagen y el formato del archivo no modificaron el recuento. Las cifras de DeepSeek V4.1 Flash proceden de su estudio del día anterior. Reduce la resolución de las capturas de pantalla y las páginas de documentos antes de enviarlas. A 2048x2048, cada imagen cuesta 2.8x más en GLM 5.3 Flash.
¿Qué más ha cambiado desde GLM 5.2?
La velocidad, pero poco más en la integración. Al usar streaming en la misma franja horaria y con low, GLM 5.3 generó entre 59 y 64 tokens de salida por segundo; GLM 5.3 Flash, entre 70 y 82; GLM 5.2, entre 51 y 55; y DeepSeek V4.1 Flash, entre 124 y 161. En un bucle de function calling de dos turnos, todos los modelos hicieron una llamada por turno. Las tres versiones de GLM cuentan la misma cantidad de tokens en textos en inglés, chino y Python (737, 484 y 488), por lo que se pueden mantener los mismos presupuestos de tokens.
La parte inicial repetida de un prompt se factura a la tarifa de caché y se contabiliza en bloques de 64 tokens. En un prompt de 1,153 tokens, 1,024 se leyeron desde la caché. Ambas versiones aceptan prompts cercanos al límite de 1M tokens, aunque la ficha del modelo Flash menciona 300,000 tokens. Un prompt de 990,000 tokens con un valor oculto cerca del principio devolvió ese valor (no probamos la recuperación de contenido cerca del final). Otro de aproximadamente 1.07M tokens recibió un error 400, Prompt exceeds max length, en lugar de truncarse. Hay una incompatibilidad al actualizar: GLM 5.3 Flash rechaza valores de max_tokens superiores a 131,072.
Cómo lo gestiona Synthorai
GLM 5.3, GLM 5.3 Flash y GLM 5.2 están disponibles en el gateway como glm-5.3, glm-5.3-flash y glm-5.2, con los precios de lista de Z.ai, tanto en /v1/chat/completions como en /v1/responses. El error 1210 se transmite sin cambios. Si un cliente sigue enviando la opción de GLM 5.2 para desactivar el razonamiento, falla de forma explícita en lugar de razonar silenciosamente con max. El texto de razonamiento se devuelve en reasoning_content. Las imágenes se envían a GLM 5.3 Flash como partes de contenido image_url.
Preguntas frecuentes
¿Se puede desactivar el razonamiento en GLM 5.3?
No. GLM 5.3 y GLM 5.3 Flash devuelven un error 400 con el código 1210 para cualquier opción que intente desactivarlo. Solo aceptan low, high y max, y max es el valor predeterminado. En nuestras pruebas, low costó un 63% menos por respuesta correcta, pero acertó 28 de 33 en lugar de 33.
¿Es GLM 5.3 más barato que GLM 5.2?
Por token, no. Ambos cuestan $1.40 por la entrada y $4.40 por la salida. Por respuesta correcta, sí. Con max, GLM 5.3 costó $0.00468 frente a los $0.01173 de GLM 5.2, porque utiliza aproximadamente la mitad de razonamiento.
¿Puede GLM 5.3 Flash sustituir a GLM 5.3?
Sí, si el sistema posterior detecta algún resultado numérico incorrecto ocasional. Cuesta una décima parte: GLM 5.3 Flash con max acertó 31 de 33 a $0.00040 por respuesta correcta, frente a 33 de 33 a $0.00468 con GLM 5.3. Evita Flash con low para operaciones aritméticas de varios pasos, donde solo acertó 24 de 33.
Relacionado: nivel de esfuerzo de razonamiento de GLM 5.2, llamadas a herramientas de GLM 5.2, coste de DeepSeek V4.1 Flash, controles de razonamiento en LLM, salidas estructuradas en LLM.