
GPT-6 Luna vs GPT-5.6 Luna: halber Preis, halb so viel Text
Inhalt
- Wie schneiden GPT-6 Luna und GPT-5.6 Luna in Benchmarks ab?
- Was hat sich außer dem Preis geändert?
- Wie haben wir getestet?
- Schreibt GPT-6 Luna weniger als GPT-5.6 Luna?
- Lässt GPT-6 Luna Inhalte weg?
- Wie kommen Länge und Details zurück?
- Wie viel spart GPT-6 Luna gegenüber GPT-5.6 Luna?
- Passen unsere Ergebnisse zu anderen veröffentlichten Tests?
- Was haben wir beobachtet, und welches Modell solltest du nutzen?
- FAQ
GPT-6 Luna liegt in öffentlichen Benchmarks gleichauf mit GPT-5.6 Luna (38 zu 37 im Artificial Analysis Intelligence Index) und kostet pro Aufgabe etwa halb so viel. Der Unterschied liegt im geschriebenen Text: Wenn ein Prompt nur ein Ziel vorgibt (“Schreibe den Quartalsbericht für Q3”), schrieb GPT-6 Luna über 80 Geschäftsdokumente hinweg 0.55x so viele Wörter. Explizit verlangte Bestandteile ließ es nicht aus. Waren die erforderlichen Bestandteile benannt, waren beide Modelle ähnlich vollständig. Das einzige Detail, das GPT-6 Luna bei reinen Zielvorgaben häufiger wegließ, war die Dauer eines Vorfalls.
TL;DR
- Artificial Analysis bewertet GPT-6 Luna mit 38 und GPT-5.6 Luna mit 37 bei
maxEffort. Die Kosten pro Aufgabe liegen bei $0.07 zu $0.18. - Bei Prompts mit bloßer Zielvorgabe schrieb GPT-6 Luna 384 Wörter pro Dokument, GPT-5.6 Luna 703.
- GPT-6 Luna ließ die Vorfallsdauer in 9 von 20 Postmortems mit bloßer Zielvorgabe weg, GPT-5.6 Luna in 2.
- Waren die erforderlichen Bestandteile benannt, waren 74 von 80 Dokumenten von GPT-6 Luna vollständig, gegenüber 69 bei GPT-5.6 Luna. Die Kosten lagen bei $0.81 zu $1.61 pro 1.000.
Wie schneiden GPT-6 Luna und GPT-5.6 Luna in Benchmarks ab?
GPT-6 Luna liegt in allgemeinen Benchmarks gleichauf mit GPT-5.6 Luna, bei 48% bis 61% geringeren Kosten pro Aufgabe. Unterschiede zeigen sich nur bei Dokumenten, die anhand eines Bewertungsrasters beurteilt werden. Die Werte gelten jeweils für einen bestimmten Reasoning-Effort, also die API-Einstellung dafür, wie viel das Modell vor der Antwort nachdenkt (none bis max, Standard medium). Die Zahlen stammen von den Seiten der jeweiligen Anbieter, abgerufen am 2026-10-02.
| GPT-6 Luna | GPT-5.6 Luna | |
|---|---|---|
| Veröffentlicht | 2026-09-22 | 2026-07-09 |
| Listenpreis, Input / Output pro 1M Token | $0.10 / $0.50 | $0.20 / $1.20 |
| Artificial Analysis Intelligence Index v4.3.2 bei max (10 Tests: Wissen, Reasoning, Coding, agentische Aufgaben und Geschäftsdokumente) | 38 | 37 |
| Kosten pro Index-Aufgabe | $0.07 | $0.18 |
| Vals Index (Coding, Recht, Steuern, Finanzen und weitere Fachaufgaben) | 51.2% | 51.7% |
| Kosten pro Vals-Test | $0.43 | $0.82 |
| GDPval-AA v2.1, Elo bei max (Geschäftsdokumente, bewertet nach einem nicht offengelegten Raster; Elo basiert auf direkten Vergleichen, höher ist besser) | 1438 | 1463 |
| GDPval-AA v2.1, Elo bei medium | 1262 | 1133 |
| Ausgabegeschwindigkeit, Token pro Sekunde | 131 | 124 |
Die Kritik an GPT-6 Luna begann bei GDPval-AA. In der Analyse zum Launch sah Artificial Analysis GPT-6 Luna bei GDPval-AA etwa 75 Elo-Punkte hinter GPT-5.6 Luna und bei AA-Briefcase v1.1, einem weiteren Dokument-Benchmark, etwa 45 Punkte dahinter. Als Ursache nannten sie “geringere Qualität der Darstellung und Ergebnisse, in denen Elemente des Bewertungsrasters fehlen”; Reviewer bezeichneten das als “format tax”. Das Leaderboard zeigt inzwischen bei max einen Abstand von 25 Punkten. Bei medium liegt GPT-6 Luna 129 Punkte vorn.
Im Vergleich mit anderen Anbietern tritt GPT-6 Luna gegen das Flash-Segment an, also günstige, schnelle Modelle. Im selben Index erreicht DeepSeek V4.1 Flash bei max 39 Punkte für $0.27 pro Aufgabe und Gemini 3.8 Flash bei high 41 Punkte für $1.24. GPT-6 Luna gibt damit 1 bis 3 Punkte ab, kostet pro Aufgabe aber 4- bis 18-mal weniger. Beide anderen Modelle generieren schneller, mit 209 beziehungsweise 249 Token pro Sekunde.
Was hat sich außer dem Preis geändert?
GPT-6 Luna übernimmt die Limits und Einstellungen von GPT-5.6 Luna. Geändert haben sich nur der Cache-Preis und der Wissensstand. Beide bieten ein Kontextfenster von 1,050,000 Token und ein Output-Limit von 128,000 Token. Sobald der Prompt 272K Token überschreitet, kosten Input und Output für den gesamten Request das 2-Fache beziehungsweise 1.5-Fache. Gecachter Input kostet $0.01 statt $0.02 pro Million Token. Der Wissensstand reicht nun bis zum 18. Mai 2026 statt bis zum 16. Februar 2026. Den Effort setzt man in der Responses API über reasoning.effort (none, low, medium, high, xhigh, max). Die Reasoning-Token sind nicht sichtbar und werden als Output-Token abgerechnet.
Eine Woche nach dem Launch veröffentlichte OpenAI GPT-6.1 Sol als Nachfolger von GPT-6 Sol im Segment darüber. Unsere Messungen zu GPT-6.1 Sol zeigten, dass dessen Antworten wieder die frühere Länge hatten. Luna erhielt kein Update. Deshalb haben wir gemessen, welche Texte GPT-6 Luna kürzer schreibt, was fehlt und wodurch die Details zurückkommen.
Wie haben wir getestet?
Wir haben Dokumentaufgaben erstellt, deren Anforderungen sich im Code prüfen lassen. Ein Judge-Modell ist damit nicht beteiligt. Jede Aufgabe gibt dem Modell einen Block synthetischer Daten und verlangt daraus ein Dokument:
| Dokument | Daten | Was Leser darin erwarten |
|---|---|---|
| Quartalsbericht | Umsatz für 6 bis 12 Regionen | jede Region berücksichtigt, die Region mit dem stärksten Rückgang genannt |
| Vorfalls-Postmortem | 7 bis 10 Ereignisse mit Zeitstempeln | jedes Ereignis, die Dauer des Vorfalls |
| Anbietervergleich | 5 bis 8 Hosting-Angebote | jeder Anbieter berücksichtigt |
| Kundenantworten | 6 bis 14 Support-Tickets | eine Antwort auf jedes Ticket, mit namentlicher Anrede des Kunden |
Jede Aufgabe wurde mit denselben Daten in zwei Prompt-Varianten gestellt. Ein Prompt mit bloßer Zielvorgabe nennt nur das gewünschte Dokument, aber keine Bestandteile (“Schreibe den regionalen Quartalsbericht für Q3 für das Führungsteam”). Bewertet werden dabei nur die Punkte aus der Tabelle. Ein Prompt mit benannten Bestandteilen gibt Abschnitte, Anzahlen und Wortspannen vor; all das fließt in die Bewertung ein. Ein Dokument ist vollständig, wenn nichts Erforderliches fehlt, zu kurz ist oder nicht in der verlangten Anzahl vorkommt. Bei Anbietervergleichen mit bloßer Zielvorgabe zählt nur die Länge, weil die Wahl des richtigen Anbieters eine Ermessensentscheidung ist.
Am 2026-10-02 ließen wir die 80 Aufgaben mit bloßer Zielvorgabe von beiden Modellen bei fünf Effort-Einstellungen bearbeiten und von GPT-6 Luna zusätzlich bei einer Verbosity-Einstellung. Die 80 Aufgaben mit benannten Bestandteilen liefen auf beiden Modellen mit dem Standard-Effort: insgesamt 1,040 Aufrufe der Responses API. Jeder Prompt enthielt eine eindeutige Zufallszeichenfolge, damit keine Antwort aus einem Cache kam. Die Kosten basieren auf den Listenpreisen von OpenAI. Beide Modelle bearbeiteten dieselben Aufgaben. Für den Vergleich nutzen wir daher einen exakten McNemar-Test (einen gepaarten Test für die Fälle, in denen sich die Modelle unterscheiden) mit Holm-Korrektur. Diese verschärft den Schwellenwert, wenn mehrere Vergleiche zugleich geprüft werden. Nur Abstände, die danach bestehen bleiben, bezeichnen wir als Unterschiede.
Schreibt GPT-6 Luna weniger als GPT-5.6 Luna?
Bei Prompts mit bloßer Zielvorgabe und Standard-Effort schrieb GPT-6 Luna 0.55x so viele Wörter wie GPT-5.6 Luna: 384 statt 703 Wörter pro Dokument. Alle 80 Antworten waren kürzer. Das galt für jede Dokumentart, am stärksten bei Postmortems (441 statt 981 Wörter) und am schwächsten bei Kundenantworten (576 statt 767).
Mit benannten Bestandteilen verschwindet der Unterschied: 738 zu 724 Wörter.
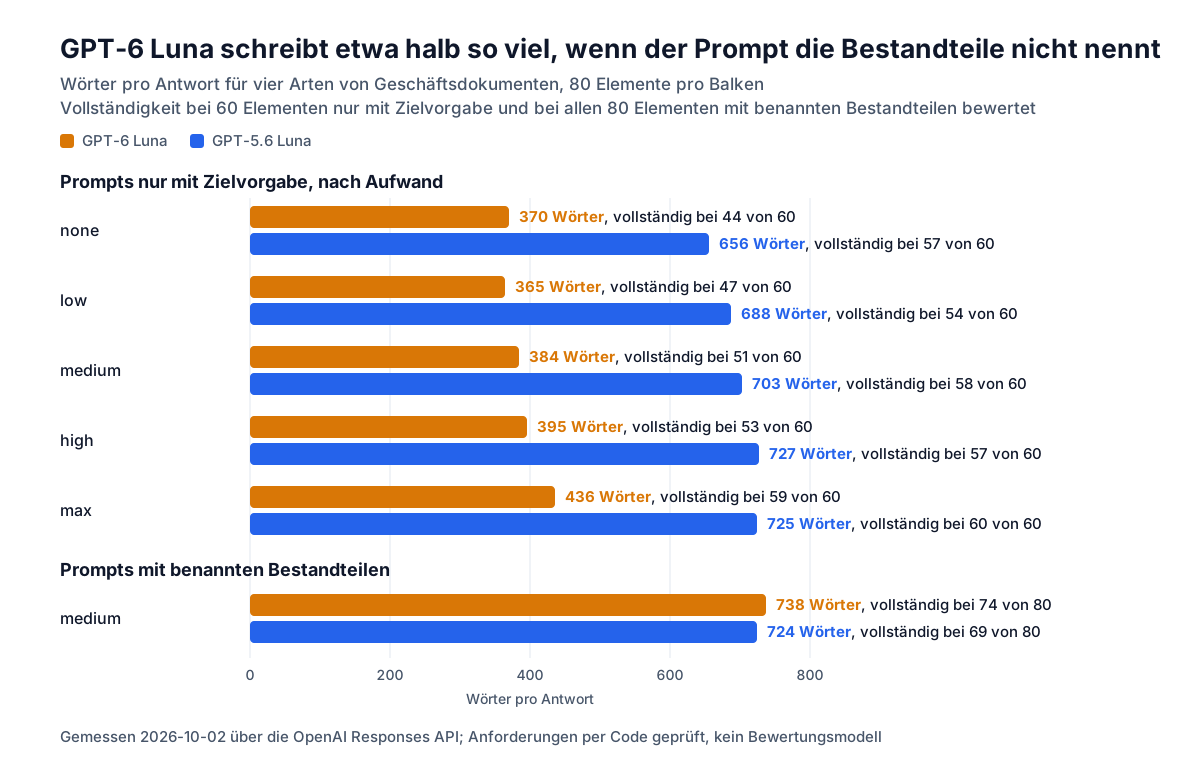
Die kürzeren Antworten sind nicht auf Luna beschränkt. Bei denselben Aufgaben schrieb GPT-6 Sol 325 Wörter, GPT-5.6 Sol dagegen 592. GPT-6.1 Sol liegt wieder bei 565.
Lässt GPT-6 Luna Inhalte weg?
Bei Prompts mit bloßer Zielvorgabe ließ GPT-6 Luna genau einen Punkt häufiger weg als GPT-5.6 Luna: die Dauer des Vorfalls im Postmortem. Meist gab es das Zeitfenster an (“Vorfallszeitraum: 18:00-18:39 UTC”) und überließ die Berechnung den Lesern. Alles andere war bei jeder Effort-Einstellung enthalten: jede Region und die mit dem stärksten Rückgang, jedes Ereignis sowie eine namentlich adressierte Antwort auf jedes Ticket. Nur bei none gab es eine einzelne Ausnahme.
| Prompts mit bloßer Zielvorgabe | GPT-6 Luna vollständig | GPT-6 Luna: Postmortems ohne Dauer | GPT-5.6 Luna vollständig | GPT-5.6 Luna: Postmortems ohne Dauer |
|---|---|---|---|---|
none | 44 / 60 | 15 / 20 | 57 / 60 | 3 / 20 |
low | 47 / 60 | 13 / 20 | 54 / 60 | 6 / 20 |
medium | 51 / 60 | 9 / 20 | 58 / 60 | 2 / 20 |
high | 53 / 60 | 7 / 20 | 57 / 60 | 3 / 20 |
max | 59 / 60 | 1 / 20 | 60 / 60 | 0 / 20 |
Der Abstand bei none (44 zu 57) bleibt nach der Korrektur bestehen. Bei medium (51 zu 58) ist er nur vor der Korrektur signifikant. Das zeigt eine Tendenz, keinen gesicherten Unterschied. Bei max liegen beide gleichauf. Der gesamte Abstand stammt aus einer einzigen Dokumentart. Er zeigt, dass GPT-6 Luna in Postmortems eine zu berechnende Zahl auslässt, aber keine allgemeine Neigung hat, Inhalte wegzulassen.
Mit benannten Bestandteilen waren 74 von 80 Dokumenten von GPT-6 Luna vollständig und 69 von GPT-5.6 Luna. Das ist statistisch ein Gleichstand. Bei beiden Modellen betrafen sämtliche Fehler Memos oder Absätze zur Auswirkung, die unter der verlangten Wortspanne blieben: 6 bei GPT-6 Luna und 11 bei GPT-5.6 Luna.
Wie kommen Länge und Details zurück?
Indem man die Bestandteile im Prompt benennt, nicht über die beiden Request-Parameter. Bei gleichem Effort stieg GPT-6 Luna von 384 auf 738 Wörter und nannte die Dauer in jedem Postmortem, sobald der Prompt sie verlangte. Ein Request wie dieser reicht:
Write the postmortem with these sections: Timeline (a table with every event),
Impact (120-200 words, state the total duration in minutes), Root Cause,
Action Items (5, each ending "Owner: <team>"), Lessons Learned (at least 3 bullets).
text.verbosity ist ein Parameter der Responses API (low, medium, high), der Länge und Detailgrad der sichtbaren Antwort steuert. Auf high gesetzt, machte er die Dokumente von GPT-6 Luna bei bloßer Zielvorgabe 7% länger (410 Wörter). Die Vollständigkeit blieb praktisch gleich: 52 von 60 statt 51.
Ein höherer Wert für reasoning.effort verändert stärker, wie viel das Modell nachdenkt, als wie viel es schreibt. Von none bis max wuchsen die Dokumente von GPT-6 Luna von 370 auf 436 Wörter, während die Reasoning-Token pro Antwort von 0 auf 4,192 stiegen. Bei max fehlte die Dauer nur noch in 1 von 20 Fällen, allerdings zu 4.5-mal so hohen Kosten wie bei medium.
Beide Parameter mit dem OpenAI Python SDK:
from openai import OpenAI

client = OpenAI()
prompt = "Write the postmortem with these sections: ..."  # data and required parts
resp = client.responses.create(
    model="gpt-6-luna",
    reasoning={"effort": "medium"},   # none, low, medium (default), high, xhigh, max
    text={"verbosity": "high"},       # 7% longer in our runs; did not change completeness
    input=prompt,
)
print(resp.output_text)
usage = resp.usage
print(usage.output_tokens, usage.output_tokens_details.reasoning_tokens)
output_tokens enthält auch die Reasoning-Token. Die Token-Zahl der sichtbaren Antwort ist also die Differenz der beiden Werte.
Wie viel spart GPT-6 Luna gegenüber GPT-5.6 Luna?
Für dasselbe Dokument kostete GPT-6 Luna 49% weniger als GPT-5.6 Luna: $0.81 statt $1.61 pro 1.000 Dokumente mit benannten Bestandteilen. Allein die Preissenkung hätte mehr Einsparung gebracht. Rechnet man die Token von GPT-5.6 Luna zu den Preisen von GPT-6 Luna ab, ergeben sich $0.68, also 58% weniger. Die Antworten von GPT-6 Luna kosteten 20% mehr als dieser Wert, weil das Modell doppelt so viel Reasoning nutzte (537 statt 271 Reasoning-Token pro Antwort) und der gesamte Output von 1,284 auf 1,558 Token stieg.
Bei Prompts mit bloßer Zielvorgabe sieht die Rechnung besser aus: $0.54 statt $1.66 pro 1.000 Dokumente (68% weniger). Der Großteil der zusätzlichen Ersparnis entsteht aber dadurch, dass GPT-6 Luna nur halb so viel schreibt. Das spart nur dann sinnvoll Geld, wenn die andere Hälfte nicht gebraucht wurde.
Die Geschwindigkeit ist ungefähr gleich. GPT-6 Luna erzeugte über die gesamte Request-Dauer gerechnet 115 Output-Token pro Sekunde, GPT-5.6 Luna 125. Ein Dokument mit bloßer Zielvorgabe dauerte im Median 8.1 statt 11.1 Sekunden, weil weniger zu schreiben war.
Passen unsere Ergebnisse zu anderen veröffentlichten Tests?
Wo sich unsere Messungen mit öffentlichen Benchmarks überschneiden, stimmen sie überein. Zusätzlich zeigen sie, was kürzer ist, was fehlt und wie es sich beheben lässt.
| Frage | Anderswo veröffentlicht | Unsere Messung | Fazit |
|---|---|---|---|
| Allgemeine Leistungsfähigkeit, GPT-6 Luna gegenüber GPT-5.6 Luna | Artificial Analysis 38 zu 37; Vals 51.2% zu 51.7% | mit benannten Bestandteilen 74 zu 69 von 80 vollständig, Gleichstand | Stimmt überein: gleichauf |
| Dokumentqualität | GDPval-AA v2.1 Elo: bei max 25 niedriger, bei medium 129 höher | bei medium 0.55x so viele Wörter bei bloßer Zielvorgabe; Vorfallsdauer fehlt in 9 von 20 Postmortems statt in 2 | Gemischt: Keiner der Tests zeigt bei Standard-Effort einen klaren Qualitätsverlust; unsere Messung zeigt die kürzeren Antworten und den einen dadurch fehlenden Punkt |
| Output-Token | 51K zu 41K pro Index-Aufgabe bei max, 24% mehr | 1,558 zu 1,284 pro Dokument bei medium, 21% mehr | Stimmt überein |
| Kosten | 61% weniger pro Index-Aufgabe; 48% weniger pro Vals-Test | 49% weniger mit benannten Bestandteilen, 68% weniger bei bloßer Zielvorgabe | Stimmt überein |
Was haben wir beobachtet, und welches Modell solltest du nutzen?
Nutze GPT-6 Luna, wenn du den Prompt steuern kannst, und benenne die benötigten Bestandteile. Behalte GPT-5.6 Luna nur dort bei, wo sich Prompts nicht ändern lassen und Leser lange Dokumente erwarten. Dafür sprechen drei Beobachtungen:
- GPT-6 Luna richtet den Text nach dem Prompt aus. Eine bloße Zielvorgabe führt zu einem kurzen Dokument. Eine Liste der Bestandteile führt zu einem vollständigen Dokument mit ähnlicher Länge wie bei GPT-5.6 Luna.
- Die Auslassung ist eng begrenzt. Über vier Dokumentarten hinweg fehlte nur ein erwarteter Punkt häufiger: die Dauer des Vorfalls.
- Die Ersparnis kommt von der Preissenkung. Für dasselbe Dokument nutzt es 21% mehr Output-Token. Deshalb liegt die Ersparnis von 49% unter den 58%, die allein aus den Listenpreisen folgen würden.
| Workload | Empfehlung | Zahlen |
|---|---|---|
| Maschinell gelesener Output: Klassifikation, Extraktion, Routing | GPT-6 Luna mit dem niedrigsten Effort, der deine Genauigkeitsanforderungen erfüllt | Listenpreise 50% (Input) und 58% (Output) niedriger; die Antwortlänge spielt keine Rolle, wenn ein Programm sie liest |
| Dokumente aus einem Template oder einem Prompt, den du selbst schreibst | GPT-6 Luna mit Abschnitten, Anzahlen und Längen im Prompt | 74 von 80 vollständig statt 69; $0.81 statt $1.61 pro 1.000 |
| Dokumente aus nicht editierbaren Prompts von Endnutzern | GPT-6 Luna, wenn du die erwarteten Bestandteile im Request ergänzen kannst; sonst GPT-5.6 Luna | bloße Zielvorgabe: 384 statt 703 Wörter; Dauer fehlt in 9 von 20 Postmortems statt in 2 |
| Ergebnisse, die anhand eines Bewertungsrasters beurteilt werden | Nimm das Bewertungsraster in den Prompt auf; verlass dich nicht auf text.verbosity | Verbosity high: 52 statt 51 von 60, 7% mehr Wörter |
Prüfe bei Dokumenten für Kunden die erforderlichen Bestandteile vor dem Versand im Code, unabhängig davon, welches Modell sie geschrieben hat.
FAQ
Ist GPT-6 Luna schlechter als GPT-5.6 Luna? Wenn der Prompt die erforderlichen Bestandteile nannte, war GPT-6 Luna genauso vollständig wie GPT-5.6 Luna (74 zu 69 von 80 Dokumenten, statistisch ein Gleichstand), bei halben Kosten. Bei bloßer Zielvorgabe schreibt es etwa halb so viel. In solchen Postmortems ließ es die Vorfallsdauer häufiger weg.
Schreibt GPT-6 Luna mit text.verbosity: "high" genauso viel wie GPT-5.6 Luna?
text.verbosity: "high" brachte GPT-6 Luna in unseren Tests 7% mehr Wörter. Damit erreichte es etwa 58% der Länge von GPT-5.6 Luna; die Vollständigkeit änderte sich nicht. Erst benannte Bestandteile im Prompt brachten die Antworten auf dieselbe Länge.
Hat GPT-6.1 die kurzen Antworten von GPT-6 Luna behoben? Das 6.1-Update von OpenAI betrifft nur das Sol-Segment: GPT-6.1 Sol schreibt wieder ungefähr so viel wie GPT-5.6 Sol. GPT-6 Luna ist seit seiner Veröffentlichung am 2026-09-22 unverändert.
Weitere Messungen: GPT-6.1 Sol vs Claude Sonnet 5.5, Vergleich der Flash-LLMs und Kostenhebel bei GPT-5.6.