
Jev vs. Flash-LLMs: Workflows 7x günstiger, Labels gleich teuer
Inhalt
Ob TypeSafe Jev günstiger ist als ein Flash-LLM, hängt vom Aufbau der Aufgabe ab. Bei 12 Fragen pro Support-Transkript kostete Jev 7-mal weniger als GPT-5.6 Luna ohne Thinking und benötigte nach Abzug der Netzwerklatenz 0.12 Sekunden statt 1.66. Bei der Auswahl eines Labels aus 77 Kategorien kostete Jev genauso viel wie Qwen3.8 Flash und GLM 5.3 Flash. Jev ist ein Entscheidungsmodell: Es generiert keinen Text, sondern liefert für jede definierte Frage eine Auswahl, einen Score oder eine Wahrscheinlichkeit. Wir haben Jev in vier Tests auf Basis öffentlicher Datensätze mit fünf Chat-Modellen der Flash-Klasse verglichen, jeweils mit der günstigsten und der standardmäßigen Thinking-Einstellung. Jev war in jedem Test das schnellste Modell, aber nie das genaueste.
TL;DR
- Bei 12 Fragen pro Fall kosteten Flash-LLMs 4.8- bis 37-mal mehr als Jev und brauchten 11- bis 27-mal länger, bei vergleichbarer Genauigkeit.
- Bei einem Label pro Nachricht kostete Jev genauso viel wie Qwen3.8 Flash und GLM 5.3 Flash ohne Thinking.
- Mit den standardmäßigen Thinking-Einstellungen kostete ein Label bei Flash-Modellen 1.5- bis 26-mal mehr als bei Jev.
- GPT-5.6 Luna war in jedem Test genauer als Jev, mit Ausnahme der Prompt-Injection-Erkennung.
- Jevs Antworten mit einer Wahrscheinlichkeit von mindestens 0.99 waren zu 98% korrekt.
Was ist Jev, und wie unterscheidet es sich von einem LLM?
Jev ist das „System One“-Modell von TypeSafe. Es liest Text oder JSON, den sogenannten State, und beantwortet dazu typisierte Fragen. Generierter Text, der anschließend geparst werden müsste, entfällt. Es gibt drei Fragetypen:
| Fragetyp | Eingabe | Rückgabe |
|---|---|---|
| Noul (TypeSafes Bezeichnung für Ja/Nein) | eine Ja/Nein-Frage | eine Wahrscheinlichkeit von 0 bis 1 |
| Choice | Auswahl aus bis zu 255 selbst definierten Optionen | die gewählte Option, die Wahrscheinlichkeit jeder Option und eine Konfidenz |
| Score | Bewertung auf 2 bis 10 selbst definierten, geordneten Stufen | ein wahrscheinlichkeitsgewichteter Score und eine Konfidenz |
Eine Anfrage benennt die Fragen und liefert pro Name genau eine Antwort zurück. Dieses Beispiel im dokumentierten TypeSafe-Format (API-Referenz) stellt drei Ja/Nein-Fragen zu einem kurzen Support-Chat:
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": {"transcript": "Customer: My card was declined twice today.\nAgent: One moment.\nCustomer: Also, how do I change my PIN?"},
    "questions": {
      "declined_card": {"type": "noul", "instructions": "In `transcript`, does the customer report a declined card payment?"},
      "change_pin":    {"type": "noul", "instructions": "In `transcript`, does the customer want to change a PIN?"},
      "lost_card":     {"type": "noul", "instructions": "In `transcript`, does the customer report a lost or stolen card?"}
    }
  }'
Bei unserem Aufruf kam Folgendes zurück:
{
  "model": "jev-1.13.0",
  "answers": {
    "declined_card": {"type": "noul", "noul": 0.99},
    "change_pin":    {"type": "noul", "noul": 0.98},
    "lost_card":     {"type": "noul", "noul": 0.02}
  },
  "usage": {"input_tokens": 359, "output_tokens": 56}
}
Der Anwendungscode liest answers.<question>.noul und vergleicht den Wert wie jede andere Zahl mit einem Schwellwert. Das Feld model nennt die Version, die geantwortet hat. jev-latest verweist nach jedem neuen Release von TypeSafe auf die aktuelle Version. Wer Schwellwerte für eine bestimmte Version abstimmt, sollte daher jev-1.13.0 fest vorgeben.
TypeSafe wertet die Fragen parallel aus. Jev 1.13 kostet $0.042 pro Million Input-Token, der Output ist kostenlos (Modelle). Pro Input-Token ist Jev damit 3.6-mal günstiger als Qwen3.8 Flash, 4.8-mal günstiger als GPT-5.6 Luna und 18-mal günstiger als Gemini 3.8 Flash. Zum Input zählen auch TypeSafes eigenes Template mit ungefähr 300 Token pro Aufruf sowie alle definierten Fragen und Optionen. Der obige Aufruf rechnete 359 Input-Token ab, also $0.000015. Die 56 Output-Token waren kostenlos. In den Hinweisen zu Jevs Schwächen nennt TypeSafe Zählen, Rechnen, Datumsvergleiche, mehrstufige Fragen und lange States mit viel irrelevantem Text.
Wie haben wir getestet?
Vier Tests, die wir jeweils einmal am 2026-09-21 und am 2026-09-22 mit Jev und fünf Flash-Chat-Modellen durchgeführt haben: GPT-5.6 Luna, Qwen3.8 Flash, GLM 5.3 Flash, DeepSeek V4.1 Flash und Gemini 3.8 Flash. Jedes Chat-Modell lief mit der günstigsten funktionierenden Thinking-Einstellung, also deaktiviert oder auf „low“, wenn sich Thinking nicht abschalten ließ. Bei den drei Klassifikationstests testeten wir zusätzlich die Standardeinstellung des Anbieters.
- 12 Fragen pro Fall: 150 Kundenservice-Transkripte, jeweils aus einer bis sechs Nachrichten des Banking77-Datensatzes zusammengesetzt (PolyAI, CC BY 4.0), sodass die korrekten Antworten bekannt sind. Jedes Modell beantwortet pro Transkript 12 Ja/Nein-Fragen wie „Meldet der Kunde eine verlorene oder gestohlene Karte?“ und gibt für jede Frage eine Wahrscheinlichkeit aus. Jev erhält 12 Noul-Fragen in einem Aufruf, die Chat-Modelle liefern ein einzelnes JSON-Objekt. 60 Fälle haben wir erneut ausgeführt und dem Transkript ein Referenzdokument mit 3,000 beziehungsweise 12,000 Token vorangestellt, jeweils Wikipedia-Artikel über Bankthemen.
- Ein Label: 308 Banking77-Nachrichten, jeweils 4 aus jeder der 77 Intent-Kategorien. Jev erhält eine Choice-Frage mit 77 Optionen. Die Chat-Modelle erhalten dieselbe Liste und antworten mit dem Intent.
- 28 Labels: 200 Kommentare aus GoEmotions (Google, Apache 2.0), jeweils mit 28 möglichen Emotionen.
- Prompt Injection: der deepset-Testdatensatz für Prompt Injections mit 116 Zeilen (Apache 2.0), jeweils mit einer Ja/Nein-Frage.
Die Kosten berechnen sich aus den Listenpreisen der Anbieter und den abgerechneten Token. Für die Latenz haben wir separat 40 Aufrufe pro Modell über eine offen gehaltene Verbindung gemessen und die Netzwerk-Roundtrip-Zeit abgezogen. Der Abschnitt zur Geschwindigkeit beschreibt das Verfahren im Detail. Außerdem liefen GPT-5.6 Terra und Seed 2.0 Mini durch die drei Klassifikationstests. Sie erscheinen in den Tabellen, aber nicht im Diagramm.
Wann ist Jev günstiger als ein Flash-LLM?
Wenn derselbe Text mit vielen Fragen geprüft wird, wenn der Text lang ist oder wenn das Chat-Modell sonst Thinking verwenden würde. Bei einem einzelnen Label für einen kurzen Text kostet Jev genauso viel wie ein günstiges Modell ohne Thinking.
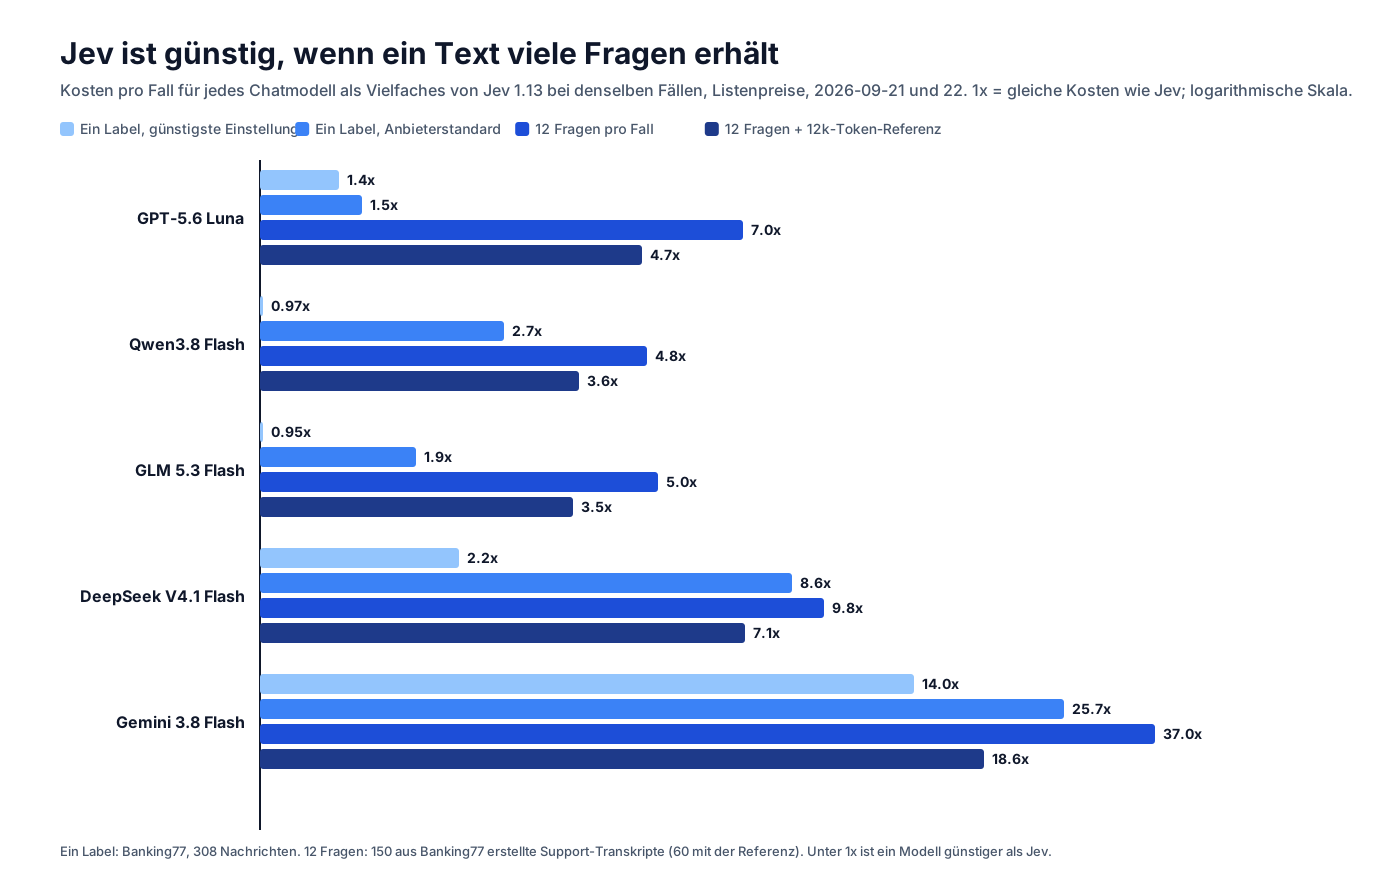
Drei Faktoren bestimmen das Verhältnis. Erstens die Anzahl der Fragen: Ein Chat-Modell muss für jede Frage eine Antwort schreiben, und Output ist dort teuer. GPT-5.6 Luna verlangt $1.20 pro Million Output-Token, gegenüber $0.20 für Input. Bei Jev sind Antworten kostenlos, und jede zusätzliche Frage erhöht den Input um ungefähr 17 Token. Zweitens Thinking: Mit den Standardeinstellungen der Anbieter erzeugten die Chat-Modelle pro Label im Median bis zu 161 Output-Token. Ohne Thinking waren es 3 bis 8. Entsprechend stieg auch der Kostenfaktor gegenüber Jev. Drittens die Input-Länge: Bei einer Referenz mit 12,000 Token fallen das feste Template und die Antworten kaum noch ins Gewicht. Das Kostenverhältnis nähert sich dann dem Verhältnis der Input-Preise an, von 3.5-mal bei GLM 5.3 Flash bis 18.6-mal bei Gemini 3.8 Flash. DeepSeek V4.1 Flash liegt bei 7.1-mal.
Beim Test mit einem Label spart Jev gegenüber den günstigsten Modellen nichts. Die 77 Optionen erhöhen jeden Aufruf um ungefähr 1,400 Token. Für eine einzeilige Nachricht rechnet Jev deshalb ungefähr 1,690 Input-Token ab, Qwen3.8 Flash dagegen 440.
| Test, Kosten pro 1,000 Fälle | Jev | Luna | Qwen3.8 Flash | GLM 5.3 Flash | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| 12 Fragen pro Fall | $0.027 | $0.19 | $0.13 | $0.14 | $0.27 | $1.02 |
| 12 Fragen, Referenz mit 12,000 Token | $0.43 | $2.02 | $1.57 | $1.53 | $3.06 | $8.06 |
| Ein Label, günstigste Einstellung | $0.071 | $0.098 | $0.069 | $0.068 | $0.16 | $0.99 |
| Ein Label, Anbieterstandard | $0.071 | $0.11 | $0.19 | $0.13 | $0.61 | $1.83 |
Wie viel schneller ist Jev?
Nach Abzug der Netzwerkzeit war Jev ungefähr 7- bis 28-mal schneller. Der Median lag bei 0.11 bis 0.12 Sekunden, während die Chat-Modelle 0.79 bis 3.25 Sekunden benötigten.
Wir haben 40 Aufrufe pro Modell und Aufgabe nacheinander über eine offen gehaltene Verbindung gemessen und die Laufzeit abgezogen, die eine Anfrage ohne Modellberechnung auf derselben Verbindung braucht. Übrig bleibt die Zeit des Modells selbst plus der Weg von unserem Proxy zum jeweiligen Anbieter, der für alle Modelle gleich ist.
| Sekunden nach Abzug des Netzwerks, Median (95. Perzentil) | Jev | GPT-5.6 Luna | Qwen3.8 Flash | GLM 5.3 Flash | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Ein Label, günstigste Einstellung | 0.11 (0.21) | 1.33 (1.80) | 0.96 (1.68) | 1.22 (3.06) | 0.79 (1.35) | 1.95 (3.76) |
| Ein Label, Anbieterstandard | 0.11 (0.21) | 1.45 (5.29) | 3.25 (21.5) | 2.97 (7.32) | 1.19 (10.4) | 2.18 (8.22) |
| 12 Fragen pro Fall | 0.12 (0.20) | 1.66 (2.56) | 3.21 (5.21) | 3.13 (6.20) | 1.33 (1.70) | 2.14 (2.89) |
Am 95. Perzentil zeigt sich der Einfluss von Thinking besonders deutlich: Mit der Standardeinstellung brauchte einer von zwanzig Qwen3.8-Flash-Aufrufen mehr als 21 Sekunden für ein einzelnes Label. Die langsamsten Jev-Aufrufe blieben bei ungefähr 0.2 Sekunden.
Mehr Fragen machten Jev nicht langsamer: Von 1 auf 60 Ja/Nein-Fragen zu einem Support-Ticket verschob sich der Median um weniger als 0.1 Sekunden, und der Aufruf mit 60 Fragen rechnete 1,371 Input-Token ab, $0.000058. Bei den Aufrufen mit 20 Fragen war in allen fünf Durchläufen jede Antwort richtig.
Wie passen diese Ergebnisse zu den Aussagen von TypeSafe?
Die Richtung stimmt überein, die gemessenen Unterschiede sind bei uns aber kleiner, weil andere Vergleiche zugrunde liegen. Im Launch-Beitrag nennt TypeSafe Einsparungen von bis zu 444.6-mal und eine bis zu 193.6-mal höhere Geschwindigkeit. Gemessen wurde dabei gegen Frontier-Modelle mit Reasoning in mehrstufigen Workflows. TypeSafe bezeichnet diese Werte als „the higher end of real world gains“ (Launch-Beitrag).
Die veröffentlichten Workflow-Evaluierungen enthalten auch GPT-5.6 Luna: Jev erreicht 67.8% Genauigkeit bei $0.0004 und 0.4 Sekunden pro Fall, Luna 66.8% bei $0.0033 und 12.9 Sekunden. Jev ist damit ungefähr 8-mal günstiger und 32-mal schneller. In unserem Test mit 12 Fragen lagen Lunas Kosten ohne Thinking beim 7-Fachen von Jev, die Dauer nach Abzug des Netzwerks beim 14-Fachen. Die Größenordnung ist vergleichbar. Bei einem einzelnen Label verschwindet der Kostenvorteil gegenüber den günstigsten Flash-Modellen vollständig.
Ist Jev so genau wie ein Flash-LLM?
Beim Workflow-Test lag Jev nah an den anderen Modellen, bei den Klassifikationstests dahinter und in keinem Test an erster Stelle. Bei 12 Fragen pro Fall lag Jevs Micro-F1 innerhalb der Spanne der Chat-Modelle. Dabei werden alle Ja- und Nein-Antworten über sämtliche Fragen hinweg bewertet, 1.0 ist perfekt. Auch beim Ranking korrekter und falscher Antworten anhand der Wahrscheinlichkeiten lag Jev ungefähr auf dem Niveau der besten Modelle.
| 12 Fragen pro Fall (150 Transkripte) | Micro-F1 bei 0.5 | Alle 12 Antworten korrekt | AUC |
|---|---|---|---|
| Jev 1.13 | 0.909 | 61.3% | 0.990 |
| GPT-5.6 Luna, Thinking deaktiviert | 0.933 | 71.3% | 0.973 |
| GPT-5.6 Luna, Standard | 0.931 | 71.3% | 0.992 |
| Gemini 3.8 Flash, low | 0.919 | 66.7% | 0.974 |
| Qwen3.8 Flash, Thinking deaktiviert | 0.913 | 62.7% | 0.975 |
| GLM 5.3 Flash, low | 0.906 | 64.7% | 0.975 |
| DeepSeek V4.1 Flash, Thinking deaktiviert | 0.896 | 60.0% | 0.958 |
Die AUC misst, wie gut die Wahrscheinlichkeiten die Antworten sortieren. Ein Wert von 1.0 bedeutet, dass jedes echte „Ja“ eine höhere Wahrscheinlichkeit erhielt als jedes „Nein“. Mit der Referenz von 12,000 Token vor dem eigentlichen Text blieb Jevs Genauigkeit stabil. Der F1-Wert lag bei 0.914, gegenüber 0.922 für dieselben 60 Transkripte ohne Referenz.
Bei den Klassifikationstests lagen die Chat-Modelle vorn, besonders mit den standardmäßigen Thinking-Einstellungen:
| Modell und Einstellung | Ein Label (Banking77) | 28 Labels (GoEmotions Micro-F1) | Prompt Injection |
|---|---|---|---|
| Jev 1.13 | 80.2% | 0.228 | 74.1% |
| GPT-5.6 Luna, Thinking deaktiviert / Standard | 85.1% / 87.3% | 0.301 / 0.342 | 69.6% / 72.2% |
| GPT-5.6 Terra, Thinking deaktiviert / Standard | 83.4% / 85.4% | 0.273 / 0.324 | 80.9% / 79.1% |
| Gemini 3.8 Flash, low / Standard | 84.4% / 83.8% | 0.373 / 0.372 | 81.9% / 82.8% |
| Qwen3.8 Flash, deaktiviert / Standard | 77.6% / 81.5% | 0.286 / 0.338 | 81.9% / 80.2% |
| GLM 5.3 Flash, low / Standard | 77.9% / 79.9% | 0.255 / 0.310 | 81.9% / 81.9% |
| DeepSeek V4.1 Flash, deaktiviert / Standard | 77.3% / 81.8% | 0.289 / 0.365 | 82.8% / 86.2% |
| Seed 2.0 Mini, Thinking deaktiviert | 70.8% | 0.245 | 66.4% |
GPT-5.6 Luna und Terra beantworteten 115 der 116 Injection-Texte und 199 der 200 Kommentare. Jeweils eine Anfrage endete mit einem Fehler, die Genauigkeit bezieht sich daher auf die zurückgegebenen Antworten. Eine Antwort, die weder Ja noch Nein war, wurde als falsch gewertet. Bei den Emotionen antwortete Jev zu häufig mit Ja: Eine Emotion, der Jev eine Wahrscheinlichkeit zwischen 0.80 und 0.95 zuwies, war nur in 15% der Fälle im menschlichen Label enthalten. Die Emotions-Labels sind dünn besetzt, da die Annotatoren pro Kommentar nur eine oder zwei Emotionen auswählten. Das senkt die Werte aller Modelle, aber alle erhielten dieselbe Anweisung. Bei Prompt Injection war Jevs Standardschwellwert von 0.5 ungeeignet. Der nächste Abschnitt geht darauf ein.
Wie verlässlich ist Jevs Konfidenz?
Die Wahrscheinlichkeiten trennen korrekte und falsche Antworten gut, sind im üblichen Sinn aber nicht kalibriert. Deshalb braucht jede Aufgabe einen eigenen Schwellwert. Kalibriert würde bedeuten, dass ein Wert von 0.8 in 80% der Fälle korrekt ist. Bei Banking77 waren Jevs Antworten ab 0.99 zu 98% korrekt, unter 0.8 dagegen nur ungefähr zur Hälfte.
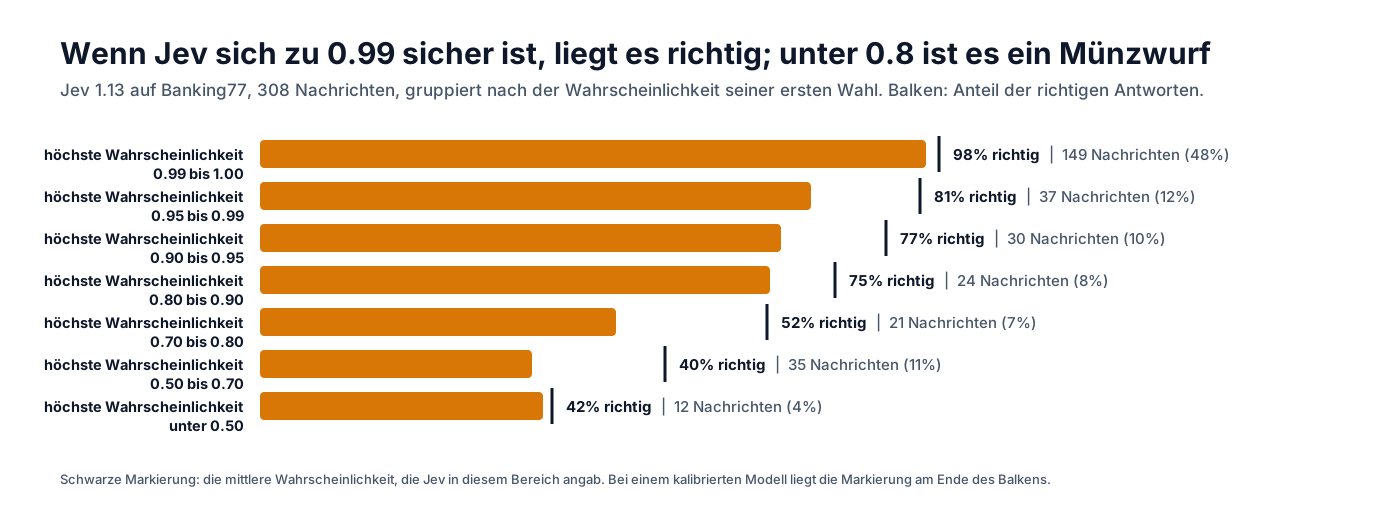
Fast die Hälfte der Banking77-Nachrichten (48%) erhielt eine höchste Wahrscheinlichkeit von mindestens 0.99. Eine Pipeline kann diese Ergebnisse direkt übernehmen und den Rest an ein größeres Modell weiterleiten. Für diesen Anteil des Traffics erreicht sie dann 98% Genauigkeit. Prompt Injection zeigt die andere Seite. Beim Standardschwellwert von 0.5 erkannte Jev nur die Hälfte der Angriffe. Die übrige Hälfte erhielt Wahrscheinlichkeiten zwischen 0.03 und 0.5. Absolut sind diese Werte niedrig, lagen aber meist über denen harmloser Texte, deren Median 0.02 betrug. Nach Wahrscheinlichkeit sortiert trennte Jev Angriffe und harmlose Texte mit einer AUC von 0.984.
| Schwellwert für den Injection-Datensatz | Jev-Genauigkeit | Erkannte Angriffe | Fehlalarme (von 56 harmlosen Texten) |
|---|---|---|---|
| 0.5 (Standard) | 74.1% | 50.0% | 0 |
| 0.1 | 88.8% | 80.0% | 1 |
| 0.05 | 93.1% | 91.7% | 3 |
Diese Schwellwerte wurden anhand derselben 116 Texte gewählt und sind deshalb als Obergrenze zu verstehen. Auch ein Chat-Modell kann Wahrscheinlichkeiten liefern, wenn seine API Token-Log-Wahrscheinlichkeiten zurückgibt, also die modellinterne Wahrscheinlichkeit für jedes ausgegebene Token. Von den hier getesteten Chat-Modellen lieferten Qwen3.8 Flash und Seed 2.0 Mini diese Werte. Die Wahrscheinlichkeit von Qwen3.8 Flash für „Ja“ sortierte die Injection-Texte mit einer AUC von 0.977.
Jev oder Flash-LLM?
| Aufgabe | Empfehlung | Begründung aus den Tests |
|---|---|---|
| viele Ja/Nein- oder Auswahlfragen zum selben Text | Jev | 4.8- bis 37-mal günstiger, nach Abzug des Netzwerks 11- bis 27-mal schneller, vergleichbare Genauigkeit |
| eine Entscheidung innerhalb einer Schleife, die in weniger als einer Sekunde vorliegen muss | Jev | 0.11 bis 0.12 s nach Abzug des Netzwerks |
| lange Dokumente mit wenigen Bewertungen pro Dokument | Jev | die Kosten nähern sich dem Verhältnis der Input-Preise an und liegen 3.5- bis 18.6-mal niedriger |
| ein Label pro kurzer Nachricht bei minimalen Kosten | Jev, Qwen3.8 Flash oder GLM 5.3 Flash ohne Thinking | gleiche Kosten; die LLMs liefern keine Wahrscheinlichkeit, sofern nicht die Log-Wahrscheinlichkeiten ausgewertet werden |
| möglichst genaue Label-Auswahl | GPT-5.6 Luna mit Standardeinstellung | 87.3% auf Banking77 bei $0.11 pro 1,000 Fälle |
| Zahlen, Datumswerte, Zählen oder generierter Text | ein Chat-Modell | TypeSafe nennt diese Aufgaben als Schwächen von Jev |
In unseren Tests funktionierte dieses Muster am besten: Die Entscheidung wird in viele eng gefasste Fragen zum selben Text zerlegt. Antworten oberhalb eines anhand eigener gelabelter Daten abgestimmten Schwellwerts werden direkt verarbeitet, der Rest geht an ein Chat-Modell.
FAQ
Was ist TypeSafe Jev?
Jev ist ein Entscheidungsmodell von TypeSafe. Es beantwortet typisierte Fragen zu einem Text, etwa Ja/Nein, Auswahl aus Optionen oder Bewertung auf einer Skala, und liefert Wahrscheinlichkeiten statt generiertem Text. Jev 1.13 ist die aktuelle Version und wird unter dem Alias jev-latest bereitgestellt. Sie kostet $0.042 pro Million Input-Token, der Output ist kostenlos.
Ist Jev günstiger als ein LLM? Das hängt von der Aufgabe ab. Bei 12 Fragen pro Support-Transkript kostete GPT-5.6 Luna ohne Thinking 7-mal mehr als Jev, Gemini 3.8 Flash 37-mal mehr. Bei der Auswahl eines Labels aus 77 Kategorien kosteten Qwen3.8 Flash und GLM 5.3 Flash ohne Thinking genauso viel wie Jev.
Ist Jev genauer als GPT-5.6 Luna? Nicht in unseren Tests. GPT-5.6 Luna ohne Thinking erreichte bei 12 Fragen pro Fall einen Micro-F1 von 0.933, Jev 0.909. Auf Banking77 waren es 85.1% gegenüber 80.2%. Mit dem Standardschwellwert erkannte Jev mehr Prompt Injections als Luna ohne Thinking.
Warum sagt TypeSafe, Jev sei 444-mal günstiger? Dieser Wert vergleicht Jev mit Frontier-Modellen, die bei mehrstufigen Workflows Reasoning verwenden. TypeSafe bezeichnet ihn als oberen Bereich. Gegen Flash-Modelle war Jev in unserem Workflow mit 12 Fragen 4.8- bis 37-mal günstiger. Bei einem einzelnen Label waren die Kosten ungefähr gleich.
Sind Jevs Wahrscheinlichkeiten kalibriert? Nicht im üblichen Sinn. Auf Banking77 waren Antworten mit einer Wahrscheinlichkeit von mindestens 0.99 zu 98% korrekt, unter 0.8 dagegen nur ungefähr zur Hälfte. Bei Prompt Injections wies Jev der Hälfte der Angriffe eine Wahrscheinlichkeit unter 0.5 zu. Für jede Aufgabe sollte daher anhand eigener gelabelter Daten ein passender Schwellwert bestimmt werden.
Weitere Artikel: die beste Flash-LLM-API 2026, Structured Outputs von LLMs im Vergleich, Thinking-Steuerung bei LLMs, das beste LLM nach Anwendungsfall.