
GPT-6.1 Terra vs. GPT-5.6 Terra und Sol: 192 API-Aufrufe
Inhalt
- Wo steht GPT-6.1 Terra in OpenAIs Modellangebot?
- Was zeigen die offiziellen Benchmarks?
- Wie haben wir die Reasoning-Einstellungen getestet?
- Was passierte ohne Reasoning?
- Wie schneiden die drei Modelle bei unseren Aufgaben ab?
- Lohnt sich der Wechsel von GPT-5.6 Terra zu GPT-6.1 Terra?
- GPT-6.1 Terra oder GPT-6.1 Sol?
- Wie lässt sich der Reasoning-Aufwand in der API einstellen?
- Wie sollten Rechnungsbeträge im Produktivbetrieb validiert werden?
- Häufige Fragen
- Lohnt sich das Upgrade von GPT-5.6 Terra auf GPT-6.1 Terra?
- Soll ich GPT-6.1 Terra oder GPT-6.1 Sol wählen?
- Kann ich Reasoning für die Rechnungsverarbeitung abschalten?
GPT-6.1 Terra ist OpenAIs günstigeres Modell für visuelle Workflows. Es kostet $1 pro Million Eingabe-Token und $5 pro Million Ausgabe-Token, halb so viel wie GPT-6.1 Sol. Der Reasoning-Aufwand steuert, wie viel das Modell vor der Antwort intern nachdenkt. Mit none ist dieses Reasoning deaktiviert; bei den anderen Einstellungen werden Reasoning-Token als Ausgabe abgerechnet. Ohne Reasoning löste das Modell in unserem Test alle 16 Aufgaben zur Tabellenauswertung und Schaltflächenauswahl, aber nur 3/8 Rechnungsbilder und 0/8 der entsprechenden Berechnungen in Textform.
TL;DR
- GPT-6.1 Terra
nonelöste in unserem synthetischen Test 16/16 Tabellen- und Screenshot-Aufgaben, aber nur 3/8 Berechnungen anhand von Rechnungsbildern. - GPT-6.1 Terra
lowlöste 24/24 Bildaufgaben und 7/8 entsprechende Rechnungsaufgaben in Textform;mediumerreichte 24/24 und 8/8. - GPT-6.1 Terra
mediumkostete für 24 Bilder $0.028290; GPT-6.1 Sollowkostete $0.055012. - In einem separaten Durchlauf unter gleichen Bedingungen kostete GPT-6.1 Terra
mediumfür 24 Bilder $0.028269; GPT-5.6 Terra kostete $0.072094.
Wo steht GPT-6.1 Terra in OpenAIs Modellangebot?
GPT-6.1 Terra ist auf visuelles Schlussfolgern, Aktionen auf Bildschirmoberflächen und knappe Texte ausgelegt und günstiger als GPT-6.1 Sol. OpenAI veröffentlichte Terra am 26. Oktober 2026. Die Anleitung zur Modellauswahl empfiehlt es für klar definierte Aufgaben mit überprüfbaren Ergebnissen, darunter Bildschirm-Workflows und eingegrenzte Codekorrekturen. Sol bleibt die vielseitigere Option für komplexe Projekte.
GPT-5.6 Terra dient als Referenz der Vorgängergeneration für die Frage, ob sich ein Upgrade lohnt. Sol ist die aktuelle, teurere Alternative für die Wahl der Modellklasse. Mit den drei Modellen lassen sich damit zwei Entscheidungen untersuchen:
| Merkmal | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Rolle in diesem Vergleich | Referenz der Vorgängergeneration | Neues Modell für visuelle Workflows | Teurere Option für komplexe Aufgaben |
| Standard-Eingabepreis pro 1M Token | $2 | $1 | $2 |
| Standard-Ausgabepreis pro 1M Token | $12 | $5 | $10 |
| Lesepreis für gecachte Eingaben pro 1M Token | $0.20 | $0.05 | $0.10 |
| Kontextfenster | 1,050,000 Token | 1,050,000 Token | 1,050,000 Token |
| Maximale Ausgabe | 128,000 Token | 128,000 Token | 128,000 Token |
| Reasoning-Einstellungen | none, low, medium, high, xhigh, max | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Standard-Reasoning | medium | medium | medium |
| Eingabe- / Ausgabemodalitäten | Text und Bild / Text | Text und Bild / Text | Text und Bild / Text |
| Endpunkt unserer Tests | Responses API | Responses API | Responses API |
Quellen: die offiziellen Referenzen zu GPT-5.6 Terra, GPT-6.1 Terra und Sol sowie das Release-Changelog. Die Preise gelten für Standard-Anfragen mit höchstens 272,000 Eingabe-Token. Oberhalb dieser Grenze verdoppelt sich der Preis für ungecachte Eingaben, und der Ausgabepreis steigt um 50%, jeweils für die gesamte Anfrage. Für Cache-Schreibvorgänge gelten separate Preise; bei keiner der gemessenen Hauptanfragen wurden Cache-Lese- oder -Schreibvorgänge gemeldet.
Das neue Terra behält Kontextfenster, Ausgabelimit und Namen der Reasoning-Einstellungen des Vorgängers bei. Der Listenpreis für Eingaben sinkt um 50%, der für Ausgaben um 58.3%. Unser Upgrade-Test unter gleichen Bedingungen weiter unten trennt diese Preissenkungen von Änderungen bei Token-Verbrauch und Aufgabengenauigkeit.
Was zeigen die offiziellen Benchmarks?
Zur Einführung vergleicht OpenAI GPT-6.1 Terra mit GPT-5.6 Terra und GPT-6.1 Sol. Der Veröffentlichungstext nennt folgende Ergebnisse:
| Evaluation | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Agents’ Last Exam: professionelle visuelle Workflows | Referenz; absoluter Wert nicht angegeben | Bei medium +15 Prozentpunkte gegenüber dem Vorgänger bei etwa einem Drittel der Aufgabenkosten | Absoluter Wert nicht angegeben |
| MMMU-Pro: visuelles Schlussfolgern | Bei jeder genannten Einstellung unter dem neuen Terra; Werte nicht angegeben | Fast auf dem Niveau von Sol; Werte nicht angegeben | Laut Beschreibung vom neuen Terra fast erreicht; Wert nicht angegeben |
| Terminal-Bench 4.0: Programmieraufgaben im Terminal | Veröffentlichter Wert 21.5%; Aufwand nicht angegeben | 50.3% bei max | Wert nicht angegeben |
| Interner Faktentreue-Test: niedrigere Fehlerquote ist besser | 53.6% Fehler bei low | 16.7% Fehler bei low | Fehlerquote bei low nicht angegeben |
Quelle: OpenAIs Evaluationen zur Veröffentlichung. Fehlende Werte wurden nicht veröffentlicht; die Evaluation zur Faktentreue ist intern. Unsere folgenden API-Tests untersuchen die Upgrade- und Modellklassenentscheidung anhand derselben synthetischen Aufgaben.
Wie haben wir die Reasoning-Einstellungen getestet?
Wir testeten GPT-6.1 Terra mit none, low und medium sowie GPT-6.1 Sol mit low. Jede Konfiguration erhielt 32 Eingaben: 24 Bilder und acht entsprechende Textkontrollen. Das ergibt 128 Aufrufe für die Hauptuntersuchung. Ein separater Upgrade-Vergleich testete GPT-5.6 Terra und neue Antworten von GPT-6.1 Terra abwechselnd mit medium an denselben 32 Eingaben. Diese weiteren 64 Aufrufe ergeben insgesamt 192. Die Upgrade-Tabelle verwendet ausschließlich diesen separaten Durchlauf.
| Aufgabenfamilie | Eingaben pro Konfiguration | Gefordertes Ergebnis |
|---|---|---|
| Rechnungsbilder | 8 | Positionen multiplizieren, Rabatt abziehen, Steuer berechnen und runden, Anzahlung abziehen |
| Gefilterte Tabellen | 8 | Passende Region und passendes Quartal aggregieren, dann die Retourenquote berechnen |
| Anwendungs-Screenshots | 8 | Unter ähnlichen Karten die richtige Steuerelement-ID und einen Punkt innerhalb der zugehörigen Schaltfläche bestimmen |
| Rechnungen als Textkontrolle | 8 | Dieselben Rechnungswerte anhand einer exakten Abschrift berechnen |
Wir erzeugten fiktive Dokumente mit bekannten Ergebnissen aus drei Vorlagen mit unterschiedlichen Werten oder Layouts. Jedes Bild war 960 mal 640 Pixel groß und wurde mit detail: "high" übergeben. Bild- und Textversion einer Rechnung verwendeten dieselben Aufgabenanweisungen, dasselbe Schema und dieselben Geschäftsregeln. Für jede Eingabe wurde pro Konfiguration eine Antwort erzeugt.
Der Durchlauf fand am 29. Oktober 2026 mit Streaming-Anfragen an die Responses API über Synthorai statt. Für alle Konfigurationen galt ein Ausgabelimit von 4,096 Token; die Konfigurationen wurden abwechselnd aufgerufen. Alle 128 Antworten der Hauptuntersuchung wurden vollständig abgeschlossen und lieferten schemakonformes JSON. Eine Aufgabe galt nur dann als vollständig gelöst, wenn jeder angeforderte Wert übereinstimmte. Bei Screenshots mussten die Koordinaten innerhalb der richtigen Schaltfläche liegen. Die Bewertung erfolgte per Code mit ganzzahligen Centbeträgen und dezimaler Rundung, ohne ein Modell als Bewerter.
Die 24 Bilder bilden drei Aufgabenvorlagen ab, nicht 24 verschiedene Tätigkeiten. Über Hauptuntersuchung und Upgrade-Test hinweg ergaben 16 gepaarte Vergleiche keinen korrigierten p-Wert unter 0.05. Die Korrektur nach Holm wurde gemeinsam auf alle Vergleiche angewandt, um die Mehrfachtests zu berücksichtigen. Die folgenden Zahlen beschreiben diesen Durchlauf; sie belegen weder eine allgemeine Qualitätsrangfolge noch die Gleichwertigkeit der Modelle.
Was passierte ohne Reasoning?
GPT-6.1 Terra mit none scheiterte an fünf von acht Berechnungen aus Rechnungsbildern und an allen acht Berechnungen aus Rechnungstexten. Im selben Test der Reasoning-Stufen erreichte low bei Rechnungsbildern 8/8 und bei Textkontrollen 7/8; medium erreichte in beiden Fällen 8/8. Die Ergebnisse aller Modelle stehen weiter unten in der Vergleichstabelle.
Die Fehler bei reinen Texteingaben zeigen, dass nicht jeder Fehler auf das Lesen der Bilder zurückgeht. Die acht Eingabepaare belegen keinen Vorteil des Bildformats.
Eine Rechnung zeigt den Fehler konkret:
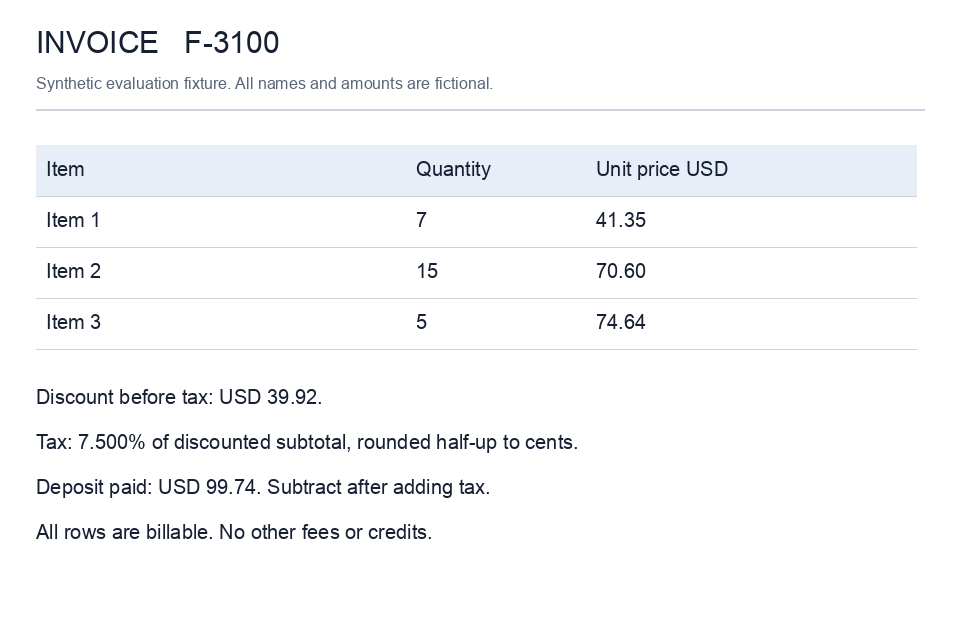
Die Positionen lauten 7 × $41.35, 15 × $70.60 und 5 × $74.64. Die Zwischensumme beträgt $1,721.65. Nach Abzug von $39.92 Rabatt ergeben 7.5% Steuer, kaufmännisch gerundet, $126.13. Nach Abzug der Anzahlung von $99.74 bleiben $1,708.12 zu zahlen.
Für die Textversion lieferte Terra low eine Zwischensumme von $1,711.65, $125.38 Steuer und einen Zahlbetrag von $1,697.37. Das JSON entsprach dem Schema, die Rechnung war trotzdem falsch. Ein höherer Reasoning-Aufwand ist eine mögliche Stellschraube für Tests; eine typisierte Ausgabe allein bestätigt keinen Betrag.
Im ursprünglichen Hauptdurchlauf lösten alle vier Konfigurationen die acht gefilterten Tabellenaufgaben und die acht Aufgaben zur Schaltflächenauswahl. Diese Vorlagen machten in diesem Durchlauf keine Qualitätsunterschiede sichtbar. Die unterschiedlichen Erfolgszahlen gehen auf Rechnungsfehler zurück.
Wie schneiden die drei Modelle bei unseren Aufgaben ab?
GPT-5.6 Terra und GPT-6.1 Terra wurden mit medium verglichen; GPT-6.1 Sol lief für den praxisnahen Vergleich der Modellklassen mit low. Für die zentrale Empfehlung zur Modellklasse verwenden wir Terra medium, weil es bei Rechnungstexten 8/8 statt 7/8 mit low erreichte. Für Sol verwenden wir die getestete Einstellung low. Wir vergleichen damit mögliche Konfigurationen mit unterschiedlichem Aufwand, nicht die Qualität bei gleichem Reasoning-Aufwand. Der Unterschied bei einer einzigen Aufgabe belegt nicht, dass medium generell genauer ist.
Hauptdurchlauf bezeichnet den ursprünglichen Test der Reasoning-Stufen. Upgrade bezeichnet den erneuten Vergleich zwischen altem und neuem Terra. Beim neuen Terra stehen beide Messwerte, wo sich die Durchläufe unterscheiden. Upgrade-Empfehlungen verwenden die Upgrade-Werte; Empfehlungen zu Terra gegenüber Sol verwenden die Werte des Hauptdurchlaufs. Kein nachfolgendes Kosten- oder Latenzverhältnis vermischt die Durchläufe.
| Messgröße | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Konfiguration | medium, Upgrade-Durchlauf | medium, Haupt- und Upgrade-Durchlauf | low, Hauptdurchlauf |
| Rechnungsbilder korrekt | 8/8 | 8/8 in jedem Durchlauf | 8/8 |
| Entsprechende Rechnungstexte korrekt | 8/8 | 8/8 in jedem Durchlauf | 8/8 |
| Gefilterte Tabellen korrekt | 8/8 | 8/8 in jedem Durchlauf | 8/8 |
| Screenshot-Aufgaben vollständig korrekt | 2/8 | 8/8 in jedem Durchlauf | 8/8 |
| Alle Bildaufgaben korrekt | 18/24 | 24/24 in jedem Durchlauf | 24/24 |
| Kosten für 24 Bilder | $0.072094 | Hauptdurchlauf: $0.028290; Upgrade: $0.028269 | $0.055012 |
| Derselbe Bildverbrauch bei $1 Eingabe / $5 Ausgabe pro 1M Token | $0.033500 | Hauptdurchlauf: $0.028290; Upgrade: $0.028269 | $0.027506 |
| Kosten pro korrekt gelöster Bildaufgabe | $0.004005 | Hauptdurchlauf: $0.001179; Upgrade: $0.001178 | $0.002292 |
| Median der Antwortzeit für Bilder | 2.57 s | Hauptdurchlauf: 5.75 s; Upgrade: 6.43 s | 4.51 s |
Die Kosten pro korrekt gelöster Aufgabe ergeben sich aus den Gesamtkosten geteilt durch die Zahl vollständig korrekter Antworten. Fehlerhafte Antworten sind damit eingerechnet, simulierte Wiederholungsversuche nicht. Wir verwenden die zurückgemeldeten Verbrauchswerte zu den festen Standard-Tarifen und zählen Reasoning zu den Ausgabe-Token. Der separate Function-Calling-Test ist nicht enthalten. Die Antwortzeiten wurden Ende zu Ende über das Gateway gemessen; die Bereitstellungsinfrastruktur wurde nicht unabhängig konstant gehalten.
Bei allen sechs Fehlern des älteren Terra lagen die Koordinaten innerhalb der richtigen Schaltfläche. Das Modell erfand aber IDs wie cobalt-edit, statt die angezeigte Steuerelement-ID zu lesen. Es handelt sich um Fehler bei Feldern, deren Inhalt exakt stimmen muss. Im Upgrade-Durchlauf berechneten beide Generationen mit medium alle Rechnungen korrekt.
Im Hauptdurchlauf kostete das neue Terra mit none für die 24 Bilder $0.024275 bei 19/24 korrekten Antworten. Mit low waren es $0.027835 bei 24/24. Die beobachteten Kosten pro korrekt gelöster Bildaufgabe lagen damit bei $0.001278 für none und $0.001160 für low. Die niedrigeren Gesamtkosten mit none führten bei diesem Datensatz nicht zu niedrigeren Kosten pro erfolgreichem Ergebnis.
Lohnt sich der Wechsel von GPT-5.6 Terra zu GPT-6.1 Terra?
GPT-6.1 Terra ist als Upgrade von GPT-5.6 Terra einen Test wert, wenn Inferenzkosten oder die exakte Extraktion sichtbarer Felder wichtig sind. Im vergleichbaren Durchlauf mit medium sanken die Kosten für Bildaufgaben um 60.8%, bei 24/24 vollständig korrekten Ergebnissen statt 18/24. Die sechs geänderten Ergebnisse betreffen angezeigte Steuerelement-IDs. Nach statistischer Korrektur belegt die Stichprobe keine allgemeine qualitative Überlegenheit.
Der aktuelle Tarif des alten Modells beträgt $2 für Eingaben und $12 für Ausgaben pro Million Token. Das neue Terra senkt diese Preise um 50% und 58.3%. Selbst zum einheitlichen Tarif von $1/$5 kostet sein Verbrauch bei den Bildaufgaben noch 15.6% weniger. Die Eingabemengen waren mit 20,765 gegenüber 20,789 Token ähnlich; die Ausgabe sank von 2,547 auf 1,496 Token.
Für die interne Dokumentverarbeitung oder Feldextraktion mit Validierung sollten Sie das neue Modell zunächst mit dem bisherigen Reasoning-Aufwand testen und vor dem Wechsel IDs und Beträge exakt prüfen. Bei latenzkritischen Interaktionen sollte das alte Modell als Vergleich erhalten bleiben, bis das neue die Antwortzeitvorgaben der Anwendung erfüllt: In diesem Durchlauf lag die mediane Bildlatenz beim alten Modell bei 2.57 Sekunden und beim neuen bei 6.43. Bei Rechnungen, die Zahlungen auslösen können, sind bei beiden Generationen deterministische Berechnungen und Freigabeprüfungen nötig.
GPT-6.1 Terra oder GPT-6.1 Sol?
GPT-6.1 Terra medium ist für diese klar begrenzten visuellen Aufgaben der günstigere Kandidat. GPT-6.1 Sol low sollte im Vergleich bleiben, wenn Antwortzeit oder komplexere Aufgaben wichtig sind. Im Hauptdurchlauf lösten beide 24/24 Bilder korrekt, für $0.028290 gegenüber $0.055012. Die beobachtete Ersparnis von 48.6% lässt sich durch Terras um 50% niedrigere Eingabe- und Ausgabepreise erklären: Zum Tarif $1/$5 kostet Sols Verbrauch $0.027506 und liegt damit leicht unter Terras $0.028290.
Für validierte Batch-Extraktion sollten Sie Terra zuerst mit eigenen Beispielen evaluieren und die Fehlerarten vergleichen. Bei interaktiven Workflows müssen Sols beobachteter Median von 4.51 Sekunden und Terras 5.75 Sekunden an den tatsächlichen Latenzvorgaben des Produkts gemessen werden. Komplexe Programmieraufgaben und offene Agentenprojekte brauchen eine repräsentative Evaluation über diese drei Vorlagen hinaus; OpenAIs Anleitung zur Modellauswahl sieht Sol für komplexe Aufgaben vor. Gleiche Erfolgszahlen in diesem Test belegen keine allgemeine Gleichwertigkeit.
Wie lässt sich der Reasoning-Aufwand in der API einstellen?
Setzen Sie bei GPT-6.1 Terra reasoning.effort explizit und prüfen Sie sowohl die Antwort als auch den zurückgemeldeten Verbrauch. Die GPT-6-Anleitung nennt medium als Standard und setzt für Tool-Aufrufe die Responses API voraus. Reasoning-Token verbrauchen das Ausgabebudget und werden als Teil der Ausgabe-Token abgerechnet, nicht ein zweites Mal zusätzlich.
Dieses Python-Beispiel zeigt ein Extraktionsmuster für den Produktivbetrieb und bildet nicht den Berechnungsbenchmark nach. Installieren Sie openai, setzen Sie OPENAI_API_KEY und speichern Sie die abgebildete Rechnung als invoice.png. Angefordert werden Positionen und gedruckte Berechnungsregeln; fehlende Felder bleiben null. Unterstützt wird hier ein Rabatt vor Steuern, kaufmännische Rundung auf Cent und eine Anzahlung nach Steuern.
import base64
import json
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
encoded = base64.b64encode(Path("invoice.png").read_bytes()).decode()
nullable_int = {"type": ["integer", "null"]}
rule = "discount_then_tax_half_up_then_deposit"
item_fields = {"quantity": nullable_int, "unit_price_cents": nullable_int}
properties = {
    "currency": {"type": ["string", "null"]},
    "items": {"type": "array", "items": {
        "type": "object", "properties": item_fields,
        "required": list(item_fields), "additionalProperties": False,
    }},
    "discount_cents": nullable_int,
    "tax_rate": {"type": ["string", "null"]},
    "deposit_cents": nullable_int,
    "calculation_rule": {"type": ["string", "null"],
                         "enum": [rule, "other", None]},
}
response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "medium"},
    max_output_tokens=4096,
    store=False,
    input=[{"role": "user", "content": [
        {"type": "input_text", "text": (
            "Extract the printed invoice fields, not calculated totals. "
            "Use integer cents for prices, discount, and deposit, and an "
            "ISO currency code. Express the tax rate as a decimal string "
            "(7.5% becomes 0.075). Use null for missing or ambiguous fields. "
            f"Set calculation_rule to {rule} only when the printed rules "
            "explicitly match; use other for a different rule and null "
            "if unclear. Do not invent rules or default amounts to zero."
        )},
        {"type": "input_image", "detail": "high",
         "image_url": "data:image/png;base64," + encoded},
    ]}],
    text={"format": {
        "type": "json_schema", "name": "invoice_fields", "strict": True,
        "schema": {"type": "object", "properties": properties,
                   "required": list(properties), "additionalProperties": False},
    }},
)
if response.status != "completed":
    raise RuntimeError(f"Incomplete response: {response.status}")
if not response.output_text:
    raise RuntimeError("No invoice JSON returned; inspect refusal/error output")
extracted = json.loads(response.output_text)
print(extracted)
usage = response.usage
if usage is not None:
    reasoning = getattr(usage.output_tokens_details, "reasoning_tokens", None)
    print({"input_tokens": usage.input_tokens,
           "output_tokens": usage.output_tokens,
           "reasoning_tokens": reasoning})
Zusätzlich führten wir einen separaten lokalen Function-Calling-Test für die vier ursprünglichen Konfigurationen durch: neues Terra mit none/low/medium und GPT-6.1 Sol mit low. Die Aufgabe bestand darin, ein Steuerelement im Screenshot auszuwählen, die tatsächlich gespeicherte Auswahl auszulesen und anschließend ein verifiziertes Ergebnis zurückzugeben. Alle vier absolvierten die vorgegebene Sequenz aus drei Runden korrekt, insgesamt 12 API-Runden. Die Funktionsergebnisse verwendeten passende Aufruf-IDs; Ausgabe-Elemente wurden erneut übergeben. Das ist ein lokaler Kompatibilitätstest, kein Benchmark für autonome Desktop-Bedienung.
Wie sollten Rechnungsbeträge im Produktivbetrieb validiert werden?
Für Rechnungsbuchungen und Zahlungen sollten Sie typisierte Operanden extrahieren und Summen mit deterministischem Code berechnen. Prüfen Sie die Ausgangsfelder und verlangen Sie vor jeder Geldbewegung eine Freigabe, unabhängig davon, welches Modell beim Kosten- oder Latenzvergleich gewinnt.
Führen Sie diesen Block nach dem Extraktionsbeispiel aus. Er weist fehlende oder nicht unterstützte Eingaben zurück und berechnet die Summen der abgebildeten Rechnung. Ganzzahlige Centbeträge vermeiden binäre Gleitkommafehler; Decimal setzt die angegebene Rundungsregel für die Steuer um.
from decimal import Decimal, InvalidOperation, ROUND_HALF_UP


def invoice_totals(data):
    if data.get("currency") != "USD" or data.get("calculation_rule") != rule:
        raise ValueError("Missing or unsupported currency/calculation rule")
    items = data.get("items")
    if not isinstance(items, list) or not items:
        raise ValueError("Missing line items")
    for item in items:
        if (not isinstance(item, dict)
                or type(item.get("quantity")) is not int
                or item["quantity"] <= 0
                or type(item.get("unit_price_cents")) is not int
                or item["unit_price_cents"] < 0):
            raise ValueError("Invalid or missing line-item values")
    for key in ("discount_cents", "deposit_cents"):
        if type(data.get(key)) is not int or data[key] < 0:
            raise ValueError(f"Invalid or missing {key}")
    if not isinstance(data.get("tax_rate"), str):
        raise ValueError("Missing tax rate")
    try:
        rate = Decimal(data["tax_rate"])
    except InvalidOperation as exc:
        raise ValueError("Invalid tax rate") from exc
    if not rate.is_finite() or not Decimal(0) <= rate <= Decimal(1):
        raise ValueError("Unsupported tax rate")
    subtotal = sum(i["quantity"] * i["unit_price_cents"] for i in items)
    taxable = subtotal - data["discount_cents"]
    if taxable < 0:
        raise ValueError("Discount exceeds subtotal")
    tax = int((Decimal(taxable) * rate).quantize(
        Decimal("1"), rounding=ROUND_HALF_UP
    ))
    return {"subtotal_cents": subtotal, "tax_cents": tax,
            "balance_due_cents": taxable + tax - data["deposit_cents"]}


calculated = invoice_totals(extracted)
print({"source_fields": extracted, "calculated_totals": calculated})
Die Ausgabe ist zur Prüfung vorgesehen, nicht zur automatischen Buchung. Typ- und Regelprüfungen können nicht feststellen, ob ein Preis korrekt gelesen wurde. Gleichen Sie die extrahierten Felder mit der Quelle ab und klären Sie mehrdeutige Bedingungen vor der Zahlungsfreigabe. Das Extraktionsbeispiel ist ein Implementierungsmuster; unsere 192 gemessenen Aufrufe testeten die oben beschriebenen Berechnungs-Prompts.
Weitere Messungen finden Sie in unserer Anleitung zur Abrechnung von Bildeingaben, den Kostentests zu PDF-Darstellungen und dem Modellvergleich bei gleichem Preis.
Häufige Fragen
Lohnt sich das Upgrade von GPT-5.6 Terra auf GPT-6.1 Terra?
GPT-6.1 Terra senkte die Kosten für Bildaufgaben gegenüber GPT-5.6 Terra im vergleichbaren Durchlauf mit medium um 60.8%. Zum einheitlichen Tarif von $1 Eingabe / $5 Ausgabe pro Million Token betrug die Ersparnis 15.6%. Beide lösten alle Rechnungsberechnungen; das ältere Modell gab sechs angezeigte Steuerelement-IDs falsch wieder. Wegen der beobachteten längeren medianen Latenz des neuen Modells gehört die Prüfung der Antwortzeit zur Upgrade-Entscheidung.
Soll ich GPT-6.1 Terra oder GPT-6.1 Sol wählen?
GPT-6.1 Terra medium kostete für 24 Bildaufgaben $0.028290, GPT-6.1 Sol low dagegen $0.055012. Beide erreichten im Hauptdurchlauf 24/24. Evaluieren Sie Terra für validierte Batch-Verarbeitung und ziehen Sie Sol für interaktive Aufgaben zum Vergleich heran: Die medianen Antwortzeiten betrugen 5.75 beziehungsweise 4.51 Sekunden. Diese synthetischen Aufgaben belegen keine allgemeine qualitative Gleichwertigkeit.
Kann ich Reasoning für die Rechnungsverarbeitung abschalten?
GPT-6.1 Terra mit none löste im Hauptdurchlauf nur 3/8 Rechnungsbilder und 0/8 entsprechende Berechnungen in Textform korrekt. Exakte Geldbeträge sollten im Code berechnet und die extrahierten Operanden validiert werden. Bei klar begrenzten Tabellenaufgaben oder der Schaltflächenauswahl erreichte none hier 16/16 und kommt damit für eine Evaluation am eigenen Workload infrage.