
PDF-Token: 4 Anbieter, 4 Regeln, 15 bis 2,100 pro Seite
Inhalt
- Wie sendet man ein Dokument an ein Modell?
- Wie prüft man, ob ein Modell die Datei wirklich gelesen hat?
- Wie zählen die Anbieter eine als Datei gesendete PDF?
- Wann reicht extrahierter Text nicht aus?
- Wie senkt man die Kosten für Dokumente?
- Was macht man mit einer Word-Datei?
- So haben wir gemessen
- FAQ
- Wie viele Token hat eine PDF-Seite?
- Ist eine PDF oder ihr extrahierter Text günstiger?
- Kann ein LLM eine gescannte PDF lesen?
- Welche Modelle akzeptieren PDF-Dateien direkt?
- Wie senke ich die Kosten einer langen PDF?
- Weiterführende Artikel
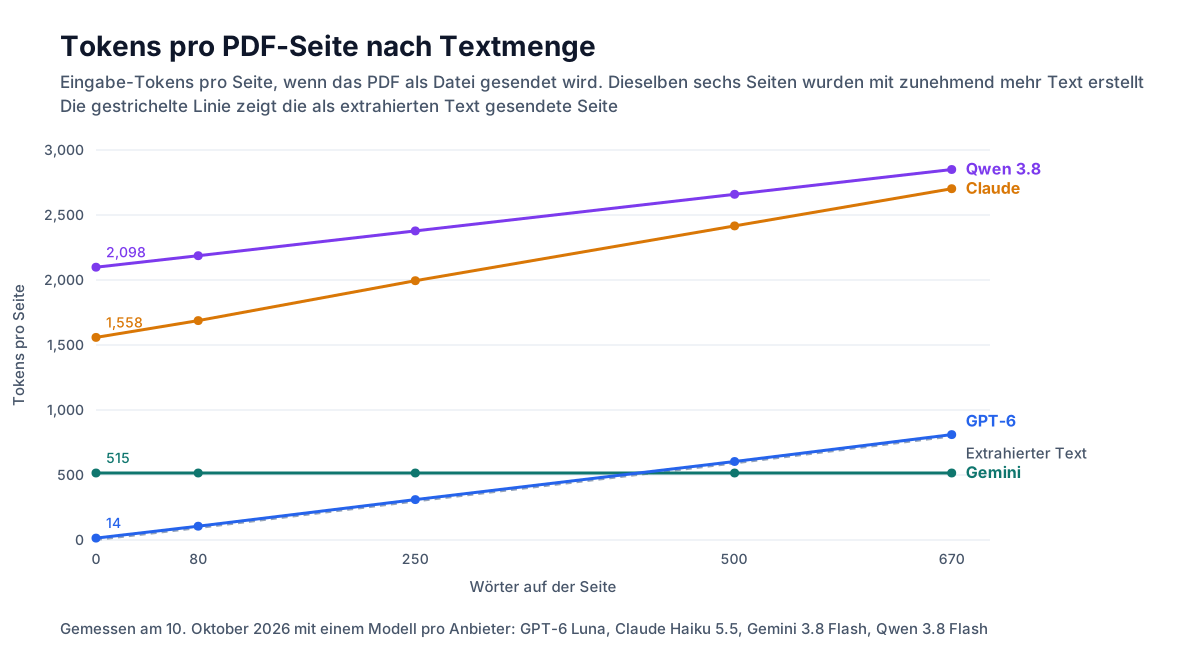
Wer eine PDF-Datei an ein Modell sendet, wird bei jedem Anbieter nach einer anderen Regel abgerechnet. GPT-6 zählt die Token des Seitentexts und etwa 15 weitere pro Seite. Claude zählt den Text und addiert 1,558 Token pro Seite. Gemini berechnet 515 Token pro Seite, der Text kostet nichts. Qwen 3.8 addiert zum Text 2,098 Token pro Seite. Wir haben diese Regeln gemessen, indem wir dieselben Seiten mit immer mehr Text verschickt haben. Anschließend haben wir zehn Dokumente an fünfzehn Modelle gesendet, um für jeden Dokumenttyp den günstigsten Übertragungsweg zu finden, bei dem die Antworten noch stimmen.
TL;DR
- Wird eine PDF als Datei gesendet, addiert GPT-6 pro Seite 15 Token zum Text, Claude 1,558 und Qwen 3.8 2,098. Gemini berechnet pauschal 515, der Text ist kostenlos.
- Mit extrahiertem Text wurden 0 von 150 Fragen zu Diagrammen und 0 von 105 Fragen zu einem gescannten Dokument richtig beantwortet.
- Die seitenweise Wahl des Übertragungswegs senkte den Verbrauch eines gemischten Dokuments auf Claude Sonnet 5.5 von 17,228 auf 6,543 Token. Alle 12 Antworten waren richtig.
- Durch die Auswahl von 4 Seiten aus einer 120-seitigen PDF sank der Input für Claude Sonnet 5.5 von 253,822 auf 8,758 Token.
Wie sendet man ein Dokument an ein Modell?
Es gibt drei Wege: als Datei, als Bilder der einzelnen Seiten oder als zuvor extrahierten Text.
import base64
import pymupdf  # pip install pymupdf

doc = pymupdf.open("report.pdf")
b64 = lambda data: base64.b64encode(data).decode()   # binary written as text, so it fits in JSON

# 1. As a file. The vendor decides how to read it.
as_file = [{"type": "file", "file": {"filename": "report.pdf",                # OpenAI-compatible chat
            "file_data": "data:application/pdf;base64," + b64(open("report.pdf", "rb").read())}}]
as_document = [{"type": "document", "source": {"type": "base64",              # Anthropic Messages API
                "media_type": "application/pdf", "data": b64(open("report.pdf", "rb").read())}}]

# 2. As page images. You render each page; any model that accepts images takes these.
as_images = [{"type": "image_url", "image_url": {"url": "data:image/jpeg;base64," +
              b64(page.get_pixmap(dpi=72).tobytes("jpeg"))}} for page in doc]

# 3. As text. The text layer is the selectable text stored in a PDF. A scan has none.
as_text = "\n\n".join(page.get_text() for page in doc)
Diese Eingaben akzeptierten die fünfzehn Modelle am Chat-Endpunkt:
| Modell | PDF als Datei | Seitenbilder | Text |
|---|---|---|---|
| GPT-6.1 Sol, GPT-6 Luna | ja | ja, bis zu 50 pro Request | ja |
| Claude Opus 5.5, Sonnet 5.5, Haiku 5.5 | ja | ja | ja |
| Gemini 3.1 Pro, Gemini 3.8 Flash | ja | ja | ja |
| Qwen 3.8 Max, Qwen 3.8 Flash | ja | ja | ja |
| Qwen 3.6 35B (offene Modellgewichte), DeepSeek V4.1 Flash, GLM 5.3 Flash, Kimi K3 | nein | ja | ja |
| GLM 5.3, DeepSeek V4 Pro | nein | nein | ja |
Seitenbilder akzeptieren alle bildfähigen Modelle. Dazu gehören auch die vier Modelle mit veröffentlichten Gewichten, die keine Dateien annehmen. Am verwendeten Endpunkt akzeptierten die Gemini-Modelle die PDF als Data-URL in einem Bildteil; Googles eigene API nimmt sie als Inline-Daten entgegen.
Wie prüft man, ob ein Modell die Datei wirklich gelesen hat?
Fragt nach etwas, das nur in der Datei steht, und prüft die Zahl der Input-Token. Nicht unterstützte Eingaben führen manchmal zu einem 400-Fehler. Manchmal werden sie aber auch verworfen, und das Modell antwortet trotzdem. In unserem Test ignorierten die beiden Modelle ohne Bildverarbeitung einen Bildteil und meldeten für ein zweiseitiges Dokument 27 beziehungsweise 98 Input-Token. Ein Modell, das statt der Datei eine URL erhielt, antwortete mit erfundenen Inhalten.
r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": as_file + [question]}])
read_it = "MF-OPS-2291" in r.choices[0].message.content   # a string found only in the document
plausible = r.usage.prompt_tokens > 200 * len(doc)        # a dropped file leaves a few dozen tokens
Um den Seitentyp zu erkennen, braucht man kein Modell. Die weiter unten beschriebene Wahl des Übertragungswegs baut darauf auf:
def kind(page) -> str:
    if len(page.get_text().strip()) < 40:
        return "scan"        # no text layer: needs OCR or an image
    if page.get_images() or len(page.get_drawings()) > 60:
        return "visual"      # a picture or a chart drawn on the page
    return "text"
Wie zählen die Anbieter eine als Datei gesendete PDF?
Es gelten vier unterschiedliche Regeln. Wir erstellten jeweils eine sechsseitige PDF mit 0, 80, 250, 500 und etwa 670 Wörtern pro Seite. Dieselben Varianten erstellten wir noch einmal mit einem Diagramm auf jeder Seite. Jede PDF wurde als Datei und als extrahierter Text gesendet.
| Anbieter | Token für eine als Datei gesendete PDF |
|---|---|
| GPT-6 | Text-Token plus 14.5 pro Seite. Ein Bild auf der Seite addiert etwa 650 bis 1,700 |
| Claude | Text-Token plus exakt 1,558 pro Seite. Ein Diagramm auf der Seite kostet nichts zusätzlich |
| Gemini | 515 pro Seite, unabhängig vom Inhalt. Der Text wird nicht gezählt |
| Qwen 3.8 | Etwa 0.94 der Text-Token plus 2,098 pro Seite. Ein Diagramm addiert etwa 770 |
Token sind die Abrechnungseinheit eines Modells. Ein Token entspricht ungefähr drei Vierteln eines englischen Wortes. Modelle derselben Familie zählten bis auf wenige Token gleich.
Zwei Regeln weichen von den veröffentlichten Angaben der Anbieter ab, zumindest über den von uns gemessenen API-Zugang. Laut Googles Dokumentation kostet eine Seite 258 Token, und der Text der PDF wird nicht berechnet. Wir haben 515 pro Seite gemessen; der Text war wie angegeben kostenlos. Laut OpenAI erhält das Modell eine PDF als extrahierten Text und als Seitenbilder. Eine reine Textseite verursachte hier keine Bildkosten. Anthropic gibt an, dass jede Seite als Text und Bild verarbeitet wird, typischerweise mit 1,500 bis 3,000 Token. Das passt zu unseren Messungen.
Daraus folgt:
- Seiten mit wenig Inhalt sind bei Claude und Qwen teuer. Eine Seite mit einer einzigen Zeile kostet als Datei 1,558 oder 2,098 Token, als Text etwa ein Dutzend.
- Seiten mit viel Text sind bei Gemini günstig. Eine Seite mit etwa 670 Wörtern kostet dieselben 515 Token wie eine leere Seite. Der Text allein umfasst dagegen etwa 800 Token.
- Bei GPT-6 kostet die Datei so viel wie der Text, solange kein Bild auf der Seite ist. Für eine gescannte Seite, die vollständig aus einem Bild besteht, haben wir 2,868 Token gemessen.
Ein 12-seitiger Bericht mit reinem Text und etwa 250 Wörtern pro Seite kam als Datei auf 6,028 Token bei GPT-6.1 Sol, 6,441 bei Gemini 3.8 Flash, 27,297 bei Claude Sonnet 5.5 und 30,934 bei Qwen 3.8 Flash. Der extrahierte Text lag über alle fünfzehn Modelle hinweg bei 5,924 bis 8,716 Token.
Wann reicht extrahierter Text nicht aus?
Sobald die benötigten Informationen nicht in der Textebene stehen. Jede Frage wurde nach den dafür benötigten Informationen kategorisiert. Die Ergebnisse der fünfzehn Modelle sind hier zusammengefasst:
| Übertragungsweg | Fließtext | Tabellenzelle | Diagramm | Gescannte Seite |
|---|---|---|---|---|
| Extrahierter Text | 297 von 300 | 168 von 170 | 0 von 150 | 0 von 105 |
| OCR, dann Text | 104 von 105 | |||
| PDF als Datei | 186 von 186 | 103 von 103 | 90 von 90 | 62 von 63 |
| Seitenbilder, 110 dpi | 258 von 260 | 148 von 148 | 130 von 130 | 89 von 91 |
| Seitenbilder, 72 dpi | 257 von 260 | 142 von 148 | 130 von 130 | 88 von 91 |
Dots per inch (dpi) gibt die Auflösung an, mit der eine Seite gerendert wird. Bei 72 dpi hat eine US-Letter-Seite 612 mal 792 Pixel. OCR steht für optische Zeichenerkennung, also Software, die Text aus Bildern liest. Wir haben das quelloffene Tesseract lokal ausgeführt.
Bei Diagrammen und beim Scan lieferte extrahierter Text auf jedem Modell null richtige Antworten, weil die Zahlen nicht im Text stehen. OCR machte den gescannten Bericht zum Textpreis lesbar, nicht aber die Diagramme: Die OCR-Ausgabe einer Präsentation mit 15 Diagrammfolien erreichte bei beiden getesteten Modellen 0 von 7. Unsere Tabellen überstanden die Textextraktion, weil sie einfache Raster sind. Verbundene Zellen und Spalten mit Zeilenumbrüchen sind schwieriger. Testet deshalb eure eigenen Tabellen.
Wie senkt man die Kosten für Dokumente?
Mit sieben Methoden, sechs davon haben wir gemessen.
1. Den Übertragungsweg nach der Zählregel wählen. Reine Textseiten als Text senden. Für andere Seiten bei Gemini die Datei verwenden, bei den übrigen Anbietern Seitenbilder mit 72 dpi. Ein Seitenbild kostet gleich viel, unabhängig davon, wie viel darauf steht. Ein dicht gefülltes, 6-seitiges IRS-Formular benötigt auf Claude Sonnet 5.5 13,635 Token als Text, 22,871 als Datei und 4,015 als Bilder mit 72 dpi. Alle drei Fragen wurden auf jedem Weg richtig beantwortet.
2. Den Übertragungsweg pro Seite wählen. Reale Dokumente enthalten verschiedene Seitentypen. Die Funktion kind oben unterscheidet sie: Textseiten werden als Text gesendet, Seiten mit Bildern als Bilder mit 72 dpi und gescannte Seiten durchlaufen OCR. Für ein neunseitiges Dokument mit vier Textseiten, drei Diagrammseiten und zwei gescannten Seiten sowie 12 Fragen ergab sich:
| Modell | Als Datei | Übertragungsweg pro Seite gewählt | Alle Seiten als Bilder mit 72 dpi |
|---|---|---|---|
| GPT-6 Luna | 15,106, 12 richtig | 5,140, 12 richtig | 5,750, 9 richtig |
| Claude Sonnet 5.5 | 17,228, 12 richtig | 6,543, 12 richtig | 6,257, 12 richtig |
| Qwen 3.8 Flash | 25,036, 12 richtig | 5,313, 12 richtig | 4,710, 12 richtig |
| Gemini 3.8 Flash | 5,043, 12 richtig | 7,110, 12 richtig | 10,278, 12 richtig |
Bei drei Anbietern sank der Input gegenüber der Datei um 62% bis 79%, ohne eine richtige Antwort zu verlieren. Bei Gemini ist die Datei bereits die günstigste Variante.
3. Die Bildauflösung senken, aber nicht bei Textseiten. Die Tokenzahl eines Seitenbilds sinkt mit der Pixelzahl. Die Ausnahme ist Gemini, das bei jeder Größe dieselbe Zahl berechnete. Diagrammfolien mit großen Beschriftungen blieben bei 36 dpi lesbar: Alle sechs getesteten Modelle beantworteten mindestens 6 von 7 Fragen richtig. Die 15 Folien kosteten auf Claude Haiku 5.5 2,874 Token statt 23,949 als Datei. Fließtext brauchte 72 dpi: Bei 50 dpi beantworteten Claude Haiku 5.5 und Gemini noch 7 von 7 Fragen richtig, GLM 5.3 Flash fiel auf 2 von 7 zurück. GPT-6 Luna verlor bei Seitenbildern unter 96 dpi in jeder getesteten Auflösung richtige Antworten. Sendet diesem Modell deshalb die Datei oder den Text.
4. Bei OpenAI für Bildseiten detail auf low setzen. Die Responses API akzeptiert bei PDF-Dateien ein Feld detail. Mit low las GPT-6 Luna die Präsentation mit 15 Folien für 9,985 Token statt 22,155 mit der Standardeinstellung. Der gescannte Bericht benötigte 11,387 statt 34,396 Token. Alle Antworten waren richtig. Bei reinen Textseiten änderte sich nichts.
5. Nur die benötigten Seiten senden. Bei einem 120-seitigen Handbuch las GPT-6 Luna zunächst den extrahierten Text mit 46,420 Token und nannte für jede der vier Fragen die benötigte Seite. Claude Sonnet 5.5 beantwortete anschließend alle vier Fragen aus einer 4-seitigen PDF mit 8,758 Token. Die vollständige Datei umfasst bei Claude 253,822 Token. Einschließlich des ersten Durchlaufs sanken die Input-Kosten damit von $0.508 auf $0.022.
6. Ein günstiges Modell transkribieren und ein großes Modell schlussfolgern lassen. Ein günstiges bildfähiges Modell wandelte die 15 Diagrammfolien für $0.002 bis $0.011 in Markdown-Tabellen um. Claude Opus 5.5 beantwortete anschließend alle sieben Fragen anhand einer Transkription mit etwa 2,000 Token für $0.010. Die Datei umfasst dagegen 23,949 Token und kostet $0.096 an Input. Die Transkription lässt sich speichern und für weitere Fragen wiederverwenden.
7. Das Dokument cachen und zeitunkritische Anfragen als Batch verarbeiten. Mit einem Cache-Breakpoint an der PDF, dem Marker cache_control in Anthropics API, kosteten sechs Fragen an Claude Sonnet 5.5 $0.117 statt $0.461. Die erste Anfrage schrieb 38,364 Token in den Cache, die nächsten fünf lasen sie für jeweils etwa $0.004. Batch-Verarbeitung ist die einzige Methode, die wir nicht gemessen haben. OpenAI, Anthropic und Google bieten ihre Batch API jeweils zum halben Preis an, mit Ergebnissen innerhalb von 24 Stunden. Laut Anthropic lässt sich der Rabatt mit Caching kombinieren.
Eine Preisgrenze sollte man im Blick behalten: Eine 120-seitige PDF umfasst bei Claude über 250,000 Token. Bei Claude Haiku 5.5 wird ein Prompt mit mehr als 100,000 Token zum fünffachen Preis abgerechnet. Der extrahierte Text desselben Handbuchs umfasst 68,382 Token.
Was macht man mit einer Word-Datei?
Konvertieren. Von sechs getesteten Modellen akzeptierten nur GPT-6.1 Sol und GPT-6 Luna eine .docx als Datei. Sie lasen ausschließlich den Text, so wie OpenAI es für Dateien dokumentiert, die keine PDFs sind. Für Text und Tabellen reicht die Konvertierung nach Markdown mit pandoc: Ein neunseitiger Vertrag kam auf 3,144 Token, und jedes Modell beantwortete 7 von 7 Fragen richtig. Ein Memo mit eingebettetem Diagramm erreichte auf diesem Weg 2 von 5. Nach der Konvertierung in PDF mit LibreOffice waren es 5 von 5, bei 1,217 Token auf Gemini 3.8 Flash und 3,827 auf Claude Sonnet 5.5.
So haben wir gemessen
Zehn Dokumente: sieben selbst erzeugte Dokumente (ein 12-seitiger Bericht, 8 Seiten Finanztabellen, eine Präsentation mit 15 Diagrammfolien, der Bericht als Scan, ein 120-seitiges Handbuch, ein Word-Vertrag und ein Word-Memo) sowie drei öffentliche Dokumente (das Paper „Attention Is All You Need“, das IRS-Formular W-9 und das AI Risk Management Framework von NIST). Zu jedem gab es drei bis sieben Fragen mit jeweils einer überprüfbaren Antwort.
Im Hauptdurchlauf wurde jedes Dokument auf jedem Übertragungsweg in jeweils einem Request an jedes Modell gesendet: 568 Requests am 10. Oktober 2026, davon 566 erfolgreich. GPT-6 Luna lehnte zweimal 120 Seitenbilder ab. Für die Zählregeln und Kostenmessungen kamen am selben Tag weitere 176 Requests hinzu, jeweils auf einem günstigen Modell pro Anbieter. Alles lief über den OpenAI-kompatiblen Chat-Endpunkt des Synthorai-Gateways, außer dem Caching-Test mit der Messages API und dem detail-Test mit der Responses API. Die Dollarbeträge basieren auf Listenpreisen.
Die Tokenzahlen entsprechen den Angaben des Endpunkts über diesen API-Zugang. Ein anderer Anbieter desselben Modells kann Dateien anders vorverarbeiten. Führt deshalb den Sechs-Seiten-Test über euren eigenen Zugang aus, bevor ihr euch auf eine Regel verlasst. Bei drei bis sieben Fragen pro Dokument zeigt ein vollständig richtiges Ergebnis, dass das Dokument auf diesem Weg lesbar ist. Es beweist nicht, dass die Verarbeitung verlustfrei ist.
FAQ
Wie viele Token hat eine PDF-Seite?
Das hängt vom Anbieter ab. Als Datei gesendet kostet eine Seite bei GPT-6 ihren Text plus etwa 15 Token, bei Claude den Text plus 1,558, bei Gemini pauschal 515 ohne Textkosten und bei Qwen 3.8 etwa 2,098 plus den Text. Für eine gescannte Seite haben wir 2,868 Token auf GPT-6.1 Sol und 1,579 auf Claude Sonnet 5.5 gemessen.
Ist eine PDF oder ihr extrahierter Text günstiger?
Bei reinen Textseiten ist extrahierter Text überall günstiger oder gleich teuer, außer bei Gemini. Dort benötigt eine dicht gefüllte Seite als Datei weniger Token, weil der Text nicht gezählt wird. Bei GPT-6.1 Sol kostet die Datei fast genauso viel wie der Text. Extrahierter Text kann keine Fragen zu Diagrammen oder gescannten Seiten beantworten.
Kann ein LLM eine gescannte PDF lesen?
Ja, wenn es die Seiten als Datei oder als Bilder erhält. Bei einem Scan ist der extrahierte Text leer und erreichte in unserem Test 0 von 105. Lokale OCR mit anschließender Übertragung des Ergebnisses erreichte 104 von 105 zum Textpreis. Das war der günstigste Weg für einen Scan von gedrucktem Text.
Welche Modelle akzeptieren PDF-Dateien direkt?
In unserem Test waren es GPT-6.1 Sol, GPT-6 Luna, die drei Claude-5.5-Modelle, Gemini 3.1 Pro, Gemini 3.8 Flash, Qwen 3.8 Max und Qwen 3.8 Flash. DeepSeek V4.1 Flash, GLM 5.3 Flash, Kimi K3 und Qwen 3.6 35B akzeptierten Seitenbilder, aber keine Datei.
Wie senke ich die Kosten einer langen PDF?
Weniger Seiten senden, für jede Seite den günstigsten Übertragungsweg wählen und gesendete Inhalte wiederverwenden. Ein günstiges Modell zur Auswahl der relevanten Seiten senkte einen 120-seitigen Request auf Claude Sonnet 5.5 von 253,822 auf 8,758 Input-Token. Die Wahl des Übertragungswegs nach Seitentyp reduzierte den Input eines gemischten Dokuments um 62% bis 79%. Caching senkte die Kosten für sechs Fragen zu einem Dokument von $0.461 auf $0.117.
Weiterführende Artikel
- Wie viele Token hat ein Bild?: die Regeln zur Bildabrechnung, die auch für Seitenbilder gelten.
- Preise für Claude Haiku 5.5: die Grenze von 100,000 Token, die eine lange PDF überschreitet.
- Schreibkosten im Prompt Cache: die Kosten der ersten Anfrage mit einem gecachten Dokument.